
{count, plural, one {Kurs} other {Kurs}}
Large Language Models (LLMs) Kavramları
{hours} sa
112.3K
Şimdi, bilgi grafiklerinin LLM’leri geliştirmek için nasıl kullanılabileceğine bakalım.
LLM’ler iyi yazılmış metinler üretebilir, ancak olgusal doğruluğunu değerlendiremezler. Çoğu durumda, orijinal eğitim veri setinde pratik bir göreve (belirli bir aracı nasıl kullanacağına dair kullanıcı sorularını yanıtlamak gibi) ilişkin ilgili bilgi (belirli bir kullanıcı kılavuzu gibi) bulunmaz.
Bağlamsal ve alan-özgü bilgiye erişimi olan bir LLM, bu bilgiyi anlamlı ve doğru yanıtlar formüle etmek için kullanabilir. KG’ler, LLM’lerin ilgili ve olgusal bilgilere programatik olarak erişmesini sağlar ve böylece kullanıcı sorularına daha iyi yanıt vermelerine yardımcı olur.
Bilgi grafikleri bilgiyi anlamsal olarak düzenleme, depolama ve geri getirme konusunda iyidir. Ancak yalnızca SPARQL gibi uzmanlaşmış sorgu dilleri (RDF formatında saklanan verileri yönetmek ve getirmek için kullanılan bir veritabanı sorgu dili) aracılığıyla erişilebilirler.
KG’lerin çıktısı da kod biçimindedir ve kullanıcıların bunu yorumlamak için özel eğitime ihtiyacı vardır. LLM’ler, düz dildeki kullanıcı taleplerini sorgu diline dönüştürerek ve KG çıktısından insan tarafından okunabilir metin üreterek bu boşluğu kapatır. Böylece teknik olmayan kullanıcıların KG’lerle arayüz kurmasına olanak tanırlar.
LLM’lerin ürettiği metin, genellikle model üretime alındığında güncelliğini yitirmiş olan eğitim veri setine bağlıdır. LLM’leri sürekli olarak güncel bilgilerle yeniden eğitmek kaynak yoğun olduğundan pratik değildir.
Buna karşın, KG’ler diğer veritabanları gibi gerçek zamanlı olarak kolayca güncellenebilir. Yeni bilgiye göre düğümler arasındaki bağlantıları güncellemenin yalnızca küçük bir hesaplama maliyeti vardır. Dolayısıyla KG’lerle entegre edilen LLM’ler, gerçek zamanlı güncellenen bilgilere erişebilir ve güncel yanıtlar sağlayabilir.
Aşağıdaki adımlar, KG ve LLM’leri birlikte kullanarak kullanıcı sorgularına güncel yanıtlar veren örnek bir iş akışının temel adımlarını özetler.
Aşağıdaki şekil bu adımların şematik bir taslağını göstermektedir:
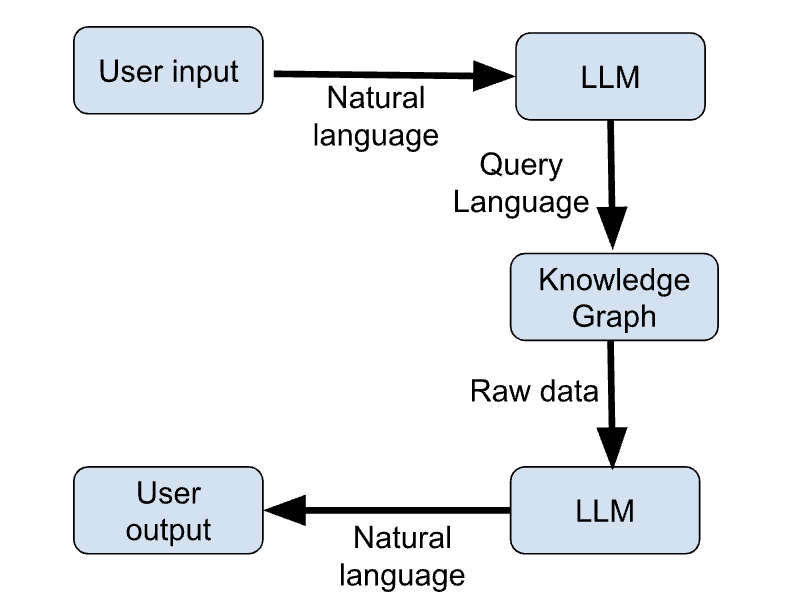
Şekil 1: LLM + KG iş akışı (görsel: yazar)
KG ve GenAI entegrasyonunun mümkün kıldığı birçok kullanım alanı vardır. En ilgi çekici olanları gözden geçirelim.
KG’ler, bir sohbet robotunun programatik olarak erişip güncel bilgi alabileceği ve kullanıcı sorgularına daha ilgili yanıtlar verebileceği yapılandırılmış ve güncel bir bilgi deposu sağlar.
KG, sohbet robotunun eğitim veri setine dayanan varsayılan bilgisini tamamlar. Sohbet robotu, eğitildiği veri setine dayanarak cümle kurmayı öğrenir ve uygulamaya özgü bilgiyi KG’den edinir. Böylece KG kullanmak, aynı sohbet robotu mimarisinin yeniden eğitime gerek kalmadan farklı uygulamalar için kullanılmasına da olanak tanır.
LLM’ler öneri motoru olarak kullanılmıştır.
Örneğin bir LLM, bir makalenin içeriğini analiz edip ilgili makaleleri önerebilir. LLM’ler, kullanıcının öneri motoruyla “konuşabildiği” etkileşimli sistemler oluşturmak için de kullanılır.
KG’ler, kullanıcı davranışı, ilgi alanları, etkileşimler vb. hakkında bilgiyi düzenleyip depolayabilir. LLM’ler bu bilgiyi analiz edip kişiye özel yanıtlar üretmek için kullanabilir. Böylece kullanıcılar, bireysel tercihlerine dayanan kişiselleştirilmiş önerilerin faydasını görür.
Tıp, finans ve hukuk gibi bilgiye dayalı alanlarda, LLM’lerin KG’lerle birlikte kullanılması bilgiye erişim kolaylığını artırır.
Tıpta, hasta semptomları ve geçmişine dayalı olası tanılar önerirler. Finansta, finansal raporlardan ilgili bilgilere erişimi kolaylaştırarak analistlerin çabalarını tamamlarlar. Hukukta, ilgili geçmiş dava ve kararların getirilmesine yardımcı olur ve hacimli hukuki belgelerin özetlerini sağlarlar.
Bilgi Büyük Dil Modelleri ile Bilgi Grafikleri’nin birleştirilmesi, haber toplama ve borsa analizi gibi gerçek zamanlı uygulamalarda kritik öneme sahiptir.
Geleneksel LLM’ler, eğitim sırasında gerçekleşmemiş olayları bilmez. Bu nedenle güncel konulara dayalı sorulara anlamlı yanıtlar veremezler.
KG’ler, yeni bilgiyi gerçek zamanlı olarak işleme ve düzenlemede etkilidir. Bu sayede, LLM’lerin güncel olaylara (haber toplama) ve hızla değişen ortamlara (ör. borsa) dayalı uygulamaları işlemesi için bilişim arka ucunu sağlarlar.
Önceki bölümler LLM ve KG’lerin temel ilkelerini tartıştı. Bu bölümde, KG ve LLM’leri entegre etmek için kullanılan araç ve kütüphaneleri tanıtıyoruz.
KG’ler en yaygın olarak şu grafik veritabanları kullanılarak uygulanır:
Grafiklere özel bir veritabanı (yalnızca grafiklerle çalışır). Neo4j Cypher adlı bildirime dayalı bir grafik sorgu dilini bilgi eklemek ve almak için kullanır. Cypher, geliştiricilerin öğrenmesini kolaylaştıran tarzıyla SQL’e benzer.
Neo4j, altta yatan veri depolama motoru grafik veritabanı kullanım senaryolarına uygun olacak şekilde sıfırdan inşa edildiğinden, karmaşık ve birbirine bağlı verileri verimli biçimde yönetir. Apache Kafka gibi harici veri kaynaklarına bağlanabilmesi ve yatayda kolay ölçeklenebilmesi nedeniyle grafik veritabanları için popüler bir seçimdir.
ArangoDB, çok modelli bir grafik veritabanıdır. Grafiklerin yanı sıra JSON dokümanlarını ve anahtar-değer depolarını da destekler. Bu, kullanıcıların grafikleri, graf biçimine kolayca dönüştürülemeyebilecek diğer bilgilerle zenginleştirmesine olanak tanır.
Bu esneklik nedeniyle, çeşitli veri türleriyle uğraşan kurumsal uygulamalarda sıklıkla tercih edilir. Tüm veri türlerinde çalışmak için Arango Sorgu Dili (AQL) kullanır. Kaputun altında ArangoDB, veri depolama motoru olarak RocksDB kullanır.
Amazon’un Neptune’u özellik grafikleri ve RDF (Resource Description Framework) modellerini destekler. SPARQL ve Gremlin sorgu dillerini kullanır. AWS altyapısına sorunsuz bir şekilde entegre olarak tamamen yönetilen bir grafik veritabanı olarak çalışır; bu da onu kurumsal uygulamalarda mevcut altyapıyla entegrasyon için yaygın bir seçim haline getirir.
LLM’ler ve grafik veritabanları birbirini tamamlar ancak genellikle doğrudan arayüz kuramaz. Aşağıdaki paragraflarda, KG’lerden LLM’lere ve tersi yönde veri aktarmak için kullanılan entegrasyon kütüphane ve çerçevelerini tartışıyoruz.
RDFlib, RDF verileriyle çalışmaya yönelik açık kaynaklı bir Python paketidir. RDF grafikleriyle çalışmak için manipülasyon ve sorgulama işlevlerine sahiptir. Bu, bilgi grafikleriyle entegrasyonu kolaylaştırır. RDF verilerini bellekte, diskte veya SPARQL uç noktaları kullanarak uzaktan depolamaya olanak tanır. Bir SPARQL uç noktası, bir API uç noktasına benzer şekilde, uzaktan SPARQL sorgularını alıp işleyebilir.
RDFlib, özne-yüklem-nesne üçlülerinden oluşan grafik tabanlı veri yapılarıyla çalışır. Üçlünün her bileşeni bir URI veya literal değerdir. Üçlüleri, XML’i ve JSON-LD gibi diğer veri türlerini ayrıştırmak ve serileştirmek için işlevlere sahiptir.
PyTorch Geometric (PyG), Grafik Sinir Ağları (GNN’ler) oluşturup eğitmek için tasarlanmış PyTorch tabanlı bir kütüphanedir. GNN, grafikler üzerinde çalışan ve girdi olarak grafik veri yapıları kabul edebilen bir sinir ağı mimarisidir. PyG, grafiklere derin öğrenme teknikleri uygulamak için işlevler sunar.
PyG, doğrudan uygulanabilen veya ileti iletim API’si aracılığıyla daha da genişletilebilen çok sayıda önceden oluşturulmuş GNN mimarisiyle birlikte gelir.
PyG’nin, farklı türlerde düğümler ve kenarlar arasında milyonlarca düğüm içeren büyük ölçekli uygulamalar için uygun olduğu iddia edilir. Bu alt alan geometrik derin öğrenme olarak da bilinir.
Geleneksel sinir ağları doğrusal ilişkileri kodlamada iyidir, ancak gerçek dünya verileri genellikle karmaşık ve çok boyutludur. Grafikler, bir grafikteki herhangi bir düğümün diğer herhangi bir düğümle ilişkilendirilebildiği daha yüksek boyutlu bağlantıları temsil etmede daha iyidir. Bu, grafiklerin karmaşık gerçek dünya ilişkilerini depolamak için daha uygun olmasını sağlar.
LangChain, 2022’de bir dil modeli entegrasyon çerçevesi olarak piyasaya sürüldü. LLM’leri API sarmalayıcıları, kabuk betikleri, web kazıyıcıları, PDF okuyucular, Google Dokümanlar, ilişkisel veritabanları, vektör veritabanları ve grafik veritabanları (KG’ler dahil) gibi diğer ilgili araçlarla zincirleyerek kullanıcı uygulamaları oluşturmayı kolaylaştırır. Bu nedenle LLM’leri içeren uygulamalar oluşturmak için yaygın olarak kullanılır.
OpenAI API’leri, PyG gibi araçlar kullanarak bir veri hattı kurma zahmetini ortadan kaldırır. OpenAI API, kullanıcının doğal dildeki sorgusunu alır, anlar ve bir programlama dilinde (ör. SPARQL) yapılandırılmış bir sorgu döndürür. Bu sorgu KG’ye verilir ve KG ilgili veriyi döndürür. Bu veri, orijinal sorgunun bağlamıyla birlikte OpenAI API’ye geri gönderilir. OpenAI LLM’i, KG’den getirilen verilere dayanarak doğal dilde bir yanıt üretir.
OpenAI API’leri, göreve ve bütçeye bağlı olarak çeşitli LLM’ler arasından seçim yapmanıza olanak tanır. Böylece, LLM’leri veya KG ile arayüz kuran veri hatlarını dağıtmanız gerekmez.
Bu bölümde, sözde kod kullanarak bir entegrasyon hattının üst düzey bir gösterimini sunuyoruz.
RAG tabanlı bir sohbet robotu oluşturma adımlarını göstermek için Neo4j, LangChain ve OpenAI API’yi kullanıyoruz. LLM, yanıtını KG’de depolanan bilgiye dayanarak üretir.
## Import relevant packages

# Handling chat prompts
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.prompts.prompt import PromptTemplate
from langchain_openai import ChatOpenAI

# Implementing the Runnable protocol for chaining components
from langchain_core.runnables import (
    RunnableBranch,
    RunnableLambda,
    RunnableParallel,
    RunnablePassthrough,

# Processing text inputs in the chat
from langchain_core.messages import AIMessage, HumanMessage
from langchain_core.output_parsers import StrOutputParser

# Working with Neo4j graphs
from neo4j import GraphDatabase
from langchain_community.graphs import Neo4jGraph
from langchain_experimental.graph_transformers import LLMGraphTransformer

# Vector embeddings for the LLM
from langchain_openai import OpenAIEmbeddings
from langchain_community.vectorstores import Neo4jVector

# Load data from a source like Wiki, PDF documents, etc.
from langchain.document_loaders import WikipediaLoader

# Create a Neo4jGraph to store the KG
graph = Neo4jGraph()

# Load the document(s) based on which to build the KG. In this snippet, we use Wiki. In practice, this is a business-specific document
raw_documents = WikipediaLoader(...).load()

# Split the document into tokens
documents = create_tokens(raw_documents)

# Instantiate the LLM
llm = ChatOpenAI(model_name="...", …)
llm_transformer = LLMGraphTransformer(llm=llm)

# Use the LLM to convert the tokenized documents into graph entities
graph_docs = llm_transformer.convert_to_graph_documents(documents)

# Add the graph entities to the Neo4j graph
graph.add_graph_documents(graph_docs, …)

# Create a retriever to run on the graph
graph.query(
    "CREATE FULLTEXT INDEX entity IF NOT EXISTS FOR (e:__Entity__) ON EACH [e.id]")

# Create a class to extract entities from the text corresponding to nodes from the graph
class Entities(BaseModel):
    names: List[str] = Field(
        ...,
        description="All the person, organization, or business entities that appear in the text",
    )

# Create a prompt template
prompt = ChatPromptTemplate.from_messages(
    [
        (
            "system",
            "You are extracting organization and person entities from the text.",
        ),
        (
            "human",
            "Use the given format to extract information from the following "
            "input: {question}",
        ),
    ]
)

# Create a chain by piping the prompt to the LLM with the Entities class.
# This chain identifies entities in a given prompt string
entity_chain = prompt | llm.with_structured_output(Entities)


# Create a structured retriever to extract the entities in the query. Given a text query, it retrieves all the relevant nodes in the neighborhood of the entities in that query.

def structured_retriever(question: str) -> str:
    result = ""
    entities = entity_chain.invoke({"question": question})
    for entity in entities.names:
        response = graph.query(
        # CYPHER QUERY TEMPLATE,
        {"query": generate_full_text_query(entity)})
        result += el['output'] for el in response
    return result

# Chain together the different components
chain = (
    RunnableParallel(
        {
            "context": _search_query | retriever,
            "question": RunnablePassthrough(),
        }
    )
    | prompt
    | llm
    | StrOutputParser()
)

# Invoke the chain
chain.invoke({"question": "The user’s question goes here"})KG’ler, LLM’lerin yeteneklerini artırır ve onları pratik kullanım senaryolarına uygun hale getirir. En iyi performansa ulaşmak için aşağıdaki en iyi uygulamaları öneririm.
KG, LLM’in yanıtlarını formüle ettiği bilgi deposunu içerir. Bu nedenle grafik veritabanını sürekli olarak en son bilgilerle güncellemek gerekir. Güncel olmayan bir KG, LLM’in güncel olmayan yanıtlar vermesine yol açar.
LLM ve KG’ler, yüksek hesaplama gereksinimlerine sahip karmaşık yazılımlardır. Önceki bölümde gösterildiği gibi, LLM ve KG’leri zincirlemek; kullanıcının sorgusunu belirteçlere ayırmadan ilgili grafik sorgusunu üretmeye, KG’den bilgiyi getirmekten ondan metin üretmeye kadar birçok adım içerir.
Bu, sorgu ile yanıt arasında verimsizliklere ve gecikmelere yol açabilir. Aşağıda açıklanan optimizasyon yöntemleri, gecikmeyi en aza indirmeye yardımcı olur.
LLM’ler bellek açısından ağır modellerdir ve çoğu zaman çalıştırmak için pahalı donanım gerektirir. LLM Distillation ve Quantization gibi tekniklerle yapay zeka modellerinin boyutunu küçültmek faydalıdır:
Seçtiğiniz dil modelinin, beklenen türdeki sorgularda iyi performans gösterdiğinden emin olmalısınız.
MLFlow gibi araçlar, LLM performansını değerlendirmeye yardımcı olur. Kullanıcıların ihtiyaçları nasıl değişip evriliyorsa, bilgi grafiğinde saklanan bilgiler de zamanla değişir. Bu nedenle, dağıtımdan sonra LLM’in performansını periyodik olarak yeniden değerlendirmek esastır. Modeli güncellenmiş bir veri seti üzerinde ince ayar yapmak, modelin güncel bir sürümünü kullanmak veya hatta yeni bir model dağıtmak gerekebilir.
LLM, bilgisini KG’den; dil ve akıl yürütme yeteneklerini ise eğitim veri setinden alır.
Taban model LLM’ler, genellikle internetin dört bir yanından toplanmış metinlerden oluşan geniş, genel veri setleri üzerinde eğitilir. LLM’i alan-özgü bir veri seti üzerinde ince ayarlamak, o alandaki akıl yürütme yetilerini güçlendirir ve doğru yapı ve jargonu kullanarak cümle kurmasını sağlar. Örneğin, bir LLM’i tıbbi bir KG kullanarak tıbbi soruları yanıtlamak için kullanmak istiyorsanız, taban LLM’i tıbbi metinlerden oluşan bir veri seti üzerinde ince ayar yapmanızı şiddetle öneririm.
Bu yazıda, Büyük Dil Modelleri (LLM’ler) ve Bilgi Grafikleri (KG’ler)in temel ilkelerini ve birbirlerini nasıl tamamladıklarını tartıştık. Ayrıca, kullanıcıya dönük uygulamalar oluşturmak için LLM ve KG’leri birlikte kullanmada yaygın olarak kullanılan bazı araçları tanıttık. Son olarak, Neo4j ve OpenAI’nin LangChain kullanılarak birlikte nasıl kullanılabileceğine dair üst düzey bir gösterim sunduk.
Bu temel kavramları anladıktan sonra, bu araçları pratikte uygulayabilirsiniz:
LLM’ler hakkında daha fazla bilgi için bu kurslara göz atın!
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {Kurs} other {Kurs}}
{count, plural, one {blog} other {blog}}
Abid Ali Awan
14 dk.
{count, plural, one {blog} other {blog}}
Dario Radečić
15 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Kurtis Pykes
8 dk.
{count, plural, one {Eğitim} other {Eğitim}}
Adel Nehme



