Corso
Concetti sui Large Language Models (LLM)
2 ore
113.6K
Pratica and corso your progress.
Continua Con GoogleVediamo ora come i knowledge graph possono essere utilizzati per potenziare gli LLM.
Gli LLM sono in grado di generare testo ben scritto, ma non possono valutarne l’accuratezza fattuale. Nella maggior parte dei casi, il dataset di addestramento originale non conteneva informazioni (come un manuale utente specifico) rilevanti per un’attività pratica (come rispondere a domande su come usare uno strumento specifico).
Un LLM con accesso a informazioni contestuali e specifiche del dominio può usare tali conoscenze per formulare risposte significative e corrette. I KG consentono agli LLM di accedere in modo programmatico a informazioni pertinenti e fattuali, rispondendo così meglio alle richieste degli utenti.
I knowledge graph sono ideali per organizzare, archiviare e recuperare informazioni in modo semantico. Tuttavia, vi si può accedere solo tramite linguaggi di interrogazione specializzati come SPARQL (un linguaggio di query per manipolare e recuperare dati archiviati in formato RDF).
L’output dei KG è anch’esso in forma di codice e gli utenti necessitano di una formazione specifica per interpretarlo. Gli LLM colmano questo divario convertendo le richieste in linguaggio naturale in linguaggi di query e generando testo leggibile dalle persone a partire dall’output del KG. In questo modo permettono anche agli utenti non tecnici di interfacciarsi con i KG.
Il testo generato dagli LLM dipende dal dataset di addestramento, che spesso risulta obsoleto al momento della messa in produzione del modello. Riaddestrare continuamente gli LLM su informazioni aggiornate è dispendioso in termini di risorse e quindi poco pratico.
I KG, invece, come qualsiasi altro database, possono essere facilmente aggiornati in tempo reale. C’è solo un lieve sovraccarico computazionale per aggiornare le connessioni tra i nodi sulla base delle nuove informazioni. Integrandosi con i KG, gli LLM possono quindi accedere a informazioni aggiornate in tempo reale e fornire risposte al passo coi tempi.
I passaggi seguenti delineano le fasi chiave di un flusso di lavoro esemplificativo che usa insieme KG e LLM per fornire risposte aggiornate alle query degli utenti.
La figura seguente mostra uno schema di questi passaggi:
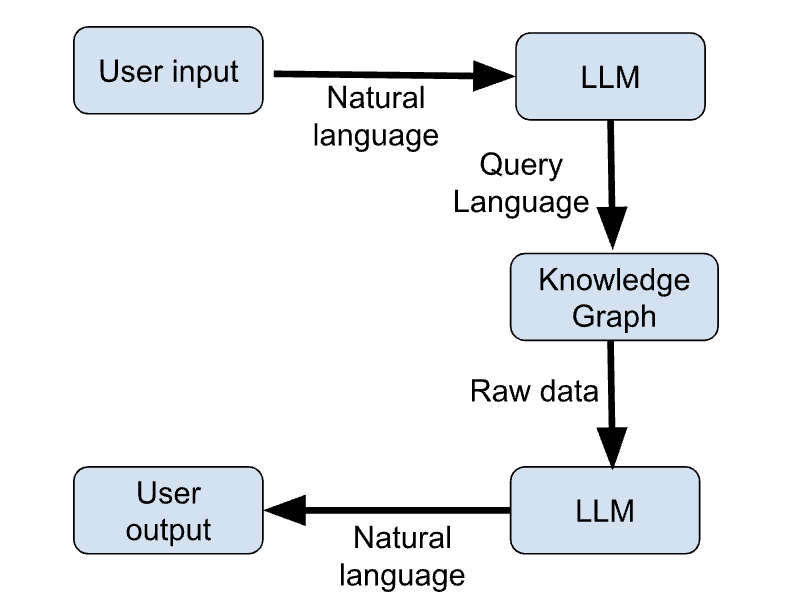
Figura 1: Workflow LLM + KG (immagine dell’autore)
L’integrazione di KG e GenAI abilita numerosi casi d’uso. Esaminiamo i più interessanti.
I KG forniscono un archivio di conoscenza strutturato e aggiornato a cui un chatbot può accedere in modo programmatico per ottenere informazioni correnti e fornire risposte più pertinenti alle domande degli utenti.
Il KG integra la conoscenza predefinita del chatbot, basata sul dataset di addestramento. Il chatbot impara a costruire frasi grazie al dataset di addestramento e acquisisce informazioni specifiche per l’applicazione dal KG. L’uso dei KG consente quindi di impiegare la stessa architettura di chatbot per applicazioni diverse senza riaddestramento.
Gli LLM sono stati utilizzati come motori di raccomandazione.
Per esempio, un LLM può analizzare il contenuto di un articolo e consigliarne di pertinenti. Gli LLM vengono anche usati per creare sistemi interattivi, in cui l’utente può “parlare” con il motore di raccomandazione.
I KG possono organizzare e memorizzare informazioni su comportamento degli utenti, interessi, interazioni e così via. Gli LLM possono analizzare queste informazioni e usarle per generare risposte su misura. In questo modo, gli utenti ottengono il beneficio di raccomandazioni personalizzate in base alle proprie preferenze.
In domini basati sulla conoscenza come medicina, finanza e diritto, LLM combinati con KG migliorano l’accessibilità alle informazioni.
In medicina, suggeriscono possibili diagnosi sulla base di sintomi e anamnesi. In finanza, supportano il lavoro degli analisti facilitando l’accesso a informazioni rilevanti dai report finanziari. Nel diritto, aiutano gli avvocati a recuperare casi e sentenze pertinenti e a riassumere ampi documenti legali.
Combinare i Large Language Model con i Knowledge Graph è fondamentale nelle applicazioni in tempo reale come l’aggregazione di notizie e l’analisi dei mercati azionari.
Gli LLM tradizionali non conoscono eventi non avvenuti durante l’addestramento. Pertanto, non possono dare risposte significative a domande basate sull’attualità.
I KG sono efficienti nell’elaborare e organizzare nuove informazioni in tempo reale. Forniscono quindi il back-end informativo per consentire agli LLM di gestire applicazioni basate sull’attualità (aggregazione di notizie) e su ambienti in rapido cambiamento (ad es. il mercato azionario).
Le sezioni precedenti hanno trattato i principi di base di LLM e KG. In questa sezione presentiamo gli strumenti e le librerie usati per integrare KG e LLM.
I KG sono più comunemente implementati utilizzando database a grafo come:
Un database a grafo specializzato (funziona solo con grafi). Neo4j utilizza Cypher, un linguaggio di query a grafo dichiarativo, per inserire e recuperare informazioni. Cypher è stilisticamente simile a SQL, il che ne facilita l’apprendimento per gli sviluppatori.
Neo4j gestisce in modo efficiente dati complessi e interconnessi perché il suo motore di archiviazione dati è costruito da zero per adattarsi ai casi d’uso dei database a grafo. È una scelta popolare perché si connette a sorgenti esterne come Apache Kafka ed è facile da scalare orizzontalmente.
ArangoDB è un database a grafo multi-modello. Oltre ai grafi, supporta anche documenti JSON e key-value store. Ciò consente di arricchire i grafi con altre informazioni che potrebbero non essere facilmente convertibili in formato grafo.
Grazie a questa flessibilità, è spesso preferito per applicazioni enterprise che trattano vari tipi di dati. Utilizza l’Arango Query Language (AQL) per lavorare su tutti i tipi di dati. Sotto il cofano, ArangoDB usa RocksDB come motore di archiviazione dati.
Neptune di Amazon supporta i modelli a grafo di proprietà e RDF (Resource Description Framework). Utilizza i linguaggi di query SPARQL e Gremlin. Si integra perfettamente nell’infrastruttura AWS per funzionare come database a grafo fully managed, risultando una scelta comune per l’integrazione con infrastrutture esistenti in applicazioni enterprise.
Gli LLM e i database a grafo si completano a vicenda ma in genere non possono interfacciarsi direttamente. Nei paragrafi seguenti, discutiamo librerie e framework di integrazione usati per convogliare i dati dai KG agli LLM e viceversa.
RDFlib è un pacchetto Python open-source per lavorare con i dati RDF. Dispone di funzioni per manipolare e interrogare grafi RDF. Ciò facilita l’integrazione con i knowledge graph. Consente di archiviare dati RDF in memoria, su disco o in remoto tramite endpoint SPARQL. Un endpoint SPARQL, analogo a un endpoint API, può ricevere ed elaborare query SPARQL remote.
RDFlib lavora con strutture dati a grafo costituite da triple soggetto–predicato–oggetto. Ciascun componente della tripla è un URI o un valore letterale. Include funzioni per effettuare il parsing e la serializzazione di triple, XML e altri tipi di dati come JSON-LD.
PyTorch Geometric (PyG) è una libreria basata su PyTorch progettata per creare e addestrare Graph Neural Network (GNN). Una GNN è un’architettura di rete neurale che opera su grafi e può accettare strutture dati a grafo in input. PyG include funzioni per applicare il deep learning ai grafi.
PyG offre molte architetture GNN predefinite che possono essere implementate direttamente o ulteriormente estese tramite le API di message passing.
Si ritiene che PyG sia adatto ad applicazioni su larga scala con milioni di nodi su diversi tipi di nodi e archi. Questo sottocampo è noto anche come geometric deep learning.
Le reti neurali tradizionali sono efficaci nel codificare relazioni lineari, ma i dati del mondo reale tendono a essere complessi e multidimensionali. I grafi sono più adatti a rappresentare interconnessioni di dimensione superiore, in cui qualsiasi nodo può essere collegato a qualunque altro. Ciò rende i grafi più appropriati per memorizzare relazioni complesse del mondo reale.
LangChain è stato lanciato nel 2022 come framework di integrazione per modelli linguistici. Facilita la creazione di applicazioni utente concatenando LLM con altri strumenti rilevanti, come wrapper API, script shell, web scraper, lettori di PDF, Google Docs, database relazionali, database vettoriali e database a grafo (inclusi KG). Perciò è comunemente usato per creare applicazioni che coinvolgono LLM.
Le API di OpenAI eliminano la complessità di costruire una pipeline usando strumenti come PyG. L’API di OpenAI può ricevere la query in linguaggio naturale di un utente, comprenderla e restituire una query strutturata in un linguaggio di programmazione (ad es. SPARQL). Questa query viene inviata al KG, che restituisce i dati pertinenti. Questi dati vengono rinviati all’API di OpenAI insieme al contesto della query originale. L’LLM di OpenAI genera una risposta in linguaggio naturale basata sui dati recuperati dal KG.
Le API di OpenAI ti consentono di scegliere tra vari LLM diversi, a seconda del compito e del budget. Così non devi distribuire LLM o pipeline dati per interfacciarti con il KG.
In questa sezione forniamo un’illustrazione ad alto livello di una pipeline di integrazione usando pseudo-codice.
Usiamo Neo4j, LangChain e l’API di OpenAI per mostrare i passaggi necessari a creare un chatbot basato su RAG. L’LLM genera la risposta in base alle informazioni archiviate nel KG.
## Import relevant packages

# Handling chat prompts
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.prompts.prompt import PromptTemplate
from langchain_openai import ChatOpenAI

# Implementing the Runnable protocol for chaining components
from langchain_core.runnables import (
    RunnableBranch,
    RunnableLambda,
    RunnableParallel,
    RunnablePassthrough,

# Processing text inputs in the chat
from langchain_core.messages import AIMessage, HumanMessage
from langchain_core.output_parsers import StrOutputParser

# Working with Neo4j graphs
from neo4j import GraphDatabase
from langchain_community.graphs import Neo4jGraph
from langchain_experimental.graph_transformers import LLMGraphTransformer

# Vector embeddings for the LLM
from langchain_openai import OpenAIEmbeddings
from langchain_community.vectorstores import Neo4jVector

# Load data from a source like Wiki, PDF documents, etc.
from langchain.document_loaders import WikipediaLoader

# Create a Neo4jGraph to store the KG
graph = Neo4jGraph()

# Load the document(s) based on which to build the KG. In this snippet, we use Wiki. In practice, this is a business-specific document
raw_documents = WikipediaLoader(...).load()

# Split the document into tokens
documents = create_tokens(raw_documents)

# Instantiate the LLM
llm = ChatOpenAI(model_name="...", …)
llm_transformer = LLMGraphTransformer(llm=llm)

# Use the LLM to convert the tokenized documents into graph entities
graph_docs = llm_transformer.convert_to_graph_documents(documents)

# Add the graph entities to the Neo4j graph
graph.add_graph_documents(graph_docs, …)

# Create a retriever to run on the graph
graph.query(
    "CREATE FULLTEXT INDEX entity IF NOT EXISTS FOR (e:__Entity__) ON EACH [e.id]")

# Create a class to extract entities from the text corresponding to nodes from the graph
class Entities(BaseModel):
    names: List[str] = Field(
        ...,
        description="All the person, organization, or business entities that appear in the text",
    )

# Create a prompt template
prompt = ChatPromptTemplate.from_messages(
    [
        (
            "system",
            "You are extracting organization and person entities from the text.",
        ),
        (
            "human",
            "Use the given format to extract information from the following "
            "input: {question}",
        ),
    ]
)

# Create a chain by piping the prompt to the LLM with the Entities class.
# This chain identifies entities in a given prompt string
entity_chain = prompt | llm.with_structured_output(Entities)


# Create a structured retriever to extract the entities in the query. Given a text query, it retrieves all the relevant nodes in the neighborhood of the entities in that query.

def structured_retriever(question: str) -> str:
    result = ""
    entities = entity_chain.invoke({"question": question})
    for entity in entities.names:
        response = graph.query(
        # CYPHER QUERY TEMPLATE,
        {"query": generate_full_text_query(entity)})
        result += el['output'] for el in response
    return result

# Chain together the different components
chain = (
    RunnableParallel(
        {
            "context": _search_query | retriever,
            "question": RunnablePassthrough(),
        }
    )
    | prompt
    | llm
    | StrOutputParser()
)

# Invoke the chain
chain.invoke({"question": "The user’s question goes here"})I KG ampliano le capacità degli LLM e li rendono pertinenti a casi d’uso pratici. Per ottenere le migliori prestazioni, consiglio le seguenti best practice.
Il KG contiene l’archivio di informazioni su cui l’LLM formula le sue risposte. È quindi necessario aggiornare continuamente il database a grafo con le informazioni più recenti. Un KG obsoleto porta l’LLM a fornire risposte superate.
LLM e KG sono software complessi con requisiti computazionali elevati. Come mostrato nella sezione precedente, concatenare LLM e KG comporta molti passaggi, dalla tokenizzazione della richiesta dell’utente e generazione della query a grafo pertinente, al recupero delle informazioni dal KG e alla generazione del testo.
Questo può portare a inefficienze e ritardi tra query e risposta. I metodi di ottimizzazione, spiegati di seguito, aiutano a minimizzare la latenza.
Gli LLM sono modelli che richiedono molta memoria e spesso necessitano di hardware costoso per l’esecuzione. È utile ridurre la dimensione dei modelli di IA con tecniche come distillazione e quantizzazione degli LLM:
Assicurati che il modello linguistico scelto offra buone prestazioni con il tipo di query che dovrà gestire.
Strumenti come MLFlow aiutano a valutare le prestazioni degli LLM su varie attività. Così come le esigenze degli utenti cambiano e si evolvono, anche le informazioni memorizzate nel knowledge graph cambiano nel tempo. È quindi essenziale rivalutare periodicamente le prestazioni dell’LLM dopo la distribuzione. Potrebbe rendersi necessario effettuare un fine-tuning del modello su un dataset aggiornato, usare una versione aggiornata del modello o addirittura distribuirne uno nuovo.
L’LLM ottiene informazioni dal KG e le sue capacità linguistiche e di ragionamento dal dataset di addestramento.
I modelli LLM di base sono addestrati su vasti dataset generici, tipicamente usando testi da tutto il web. Il fine-tuning dell’LLM su un dataset specifico di dominio ne migliora le capacità di ragionamento in quel dominio e gli consente di costruire frasi utilizzando la giusta struttura e il gergo appropriato. Per esempio, per usare un LLM per rispondere a domande mediche utilizzando un KG medico, raccomando vivamente di eseguire il fine-tuning del modello base su un dataset di testi medici.
In questo articolo abbiamo discusso i principi fondamentali dei Large Language Model (LLM) e dei Knowledge Graph (KG) e come si completano a vicenda. Abbiamo anche presentato alcuni degli strumenti comunemente usati per impiegare LLM e KG insieme nella creazione di applicazioni per gli utenti finali. Infine, abbiamo fornito un’illustrazione ad alto livello di come utilizzare insieme Neo4j e OpenAI tramite LangChain.
Dopo aver compreso questi concetti di base, puoi implementare questi strumenti nella pratica:
Approfondisci gli LLM con questi corsi!
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



