Kursus
Konsep Large Language Models (LLM)
2 jam
113.3K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleSekarang, mari lihat bagaimana knowledge graph dapat digunakan untuk meningkatkan LLM.
LLM mampu menghasilkan teks yang ditulis dengan baik, tetapi tidak dapat menilai akurasi faktualnya. Dalam banyak kasus, himpunan data pelatihan asli tidak memiliki informasi (seperti manual pengguna tertentu) yang relevan dengan tugas praktis (seperti menjawab pertanyaan pengguna tentang cara menggunakan alat tertentu).
LLM yang memiliki akses ke informasi kontekstual dan spesifik domain dapat menggunakan pengetahuan tersebut untuk merumuskan respons yang bermakna dan benar. KG memungkinkan LLM mengakses informasi yang relevan dan faktual secara terprogram, sehingga lebih baik dalam merespons pertanyaan pengguna.
Knowledge graph unggul dalam mengorganisasi, menyimpan, dan mengambil informasi secara semantik. Namun, aksesnya hanya melalui bahasa kueri khusus seperti SPARQL (bahasa kueri database untuk memanipulasi dan mengambil data yang disimpan dalam format RDF).
Keluaran KG juga berupa kode dan pengguna memerlukan pelatihan khusus untuk menafsirkannya. LLM menjembatani celah ini dengan mengubah permintaan pengguna berbahasa alami menjadi bahasa kueri dan menghasilkan teks yang dapat dibaca manusia dari keluaran KG. Dengan demikian, LLM memungkinkan pengguna nonteknis berinteraksi dengan KG.
Teks yang dihasilkan LLM bergantung pada himpunan data pelatihan, yang sering kali sudah kedaluwarsa saat LLM digunakan di produksi. Melatih ulang LLM secara berkelanjutan dengan informasi terkini membutuhkan banyak sumber daya dan karenanya tidak praktis.
Namun, KG, seperti database lainnya, dapat diperbarui dengan mudah secara waktu nyata. Hanya ada sedikit beban komputasi untuk memperbarui koneksi antar-node berdasarkan informasi baru. Dengan demikian, dengan berintegrasi dengan KG, LLM dapat mengakses informasi yang diperbarui secara waktu nyata dan memberikan respons yang mutakhir.
Langkah-langkah di bawah ini menguraikan tahapan kunci dari alur kerja contoh yang menggunakan KG dan LLM bersama-sama untuk memberikan respons terkini atas pertanyaan pengguna.
Gambar di bawah ini menunjukkan sketsa skematis dari langkah-langkah tersebut:
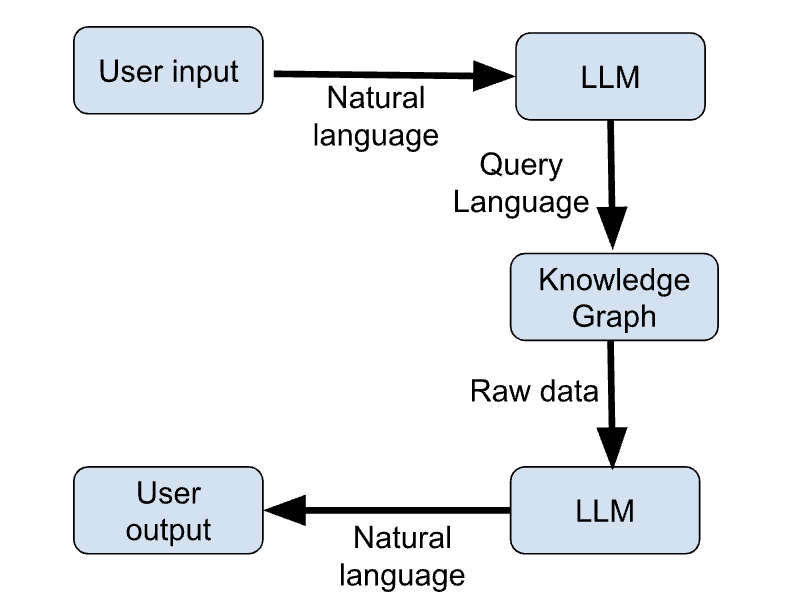
Gambar 1: Alur kerja LLM + KG (gambar oleh penulis)
Ada banyak use case yang dimungkinkan oleh integrasi KG dan GenAI. Mari ulas yang paling menarik.
KG menyediakan repositori pengetahuan yang terstruktur dan mutakhir yang dapat diakses chatbot secara terprogram untuk mendapatkan informasi terkini dan memberikan respons yang lebih relevan terhadap pertanyaan pengguna.
KG melengkapi pengetahuan bawaan chatbot, yang didasarkan pada himpunan data pelatihan. Chatbot mempelajari cara menyusun kalimat berdasarkan himpunan data pelatihan dan memperoleh informasi spesifik aplikasi dari KG. Dengan demikian, penggunaan KG juga memungkinkan arsitektur chatbot yang sama digunakan untuk berbagai aplikasi tanpa pelatihan ulang.
LLM telah digunakan sebagai mesin rekomendasi.
Sebagai contoh, LLM dapat menganalisis konten sebuah artikel dan merekomendasikan artikel terkait. LLM juga digunakan untuk membuat sistem interaktif, di mana pengguna dapat “berbicara dengan” mesin rekomendasi.
KG dapat mengorganisasi dan menyimpan informasi tentang perilaku pengguna, minat, interaksi, dan sebagainya. LLM dapat menganalisis informasi ini dan menggunakannya untuk menghasilkan respons yang disesuaikan. Dengan demikian, pengguna memperoleh manfaat rekomendasi yang dipersonalisasi berdasarkan preferensi individu mereka.
Dalam domain berbasis pengetahuan seperti kedokteran, keuangan, dan hukum, LLM yang dipadukan dengan KG meningkatkan kemudahan akses informasi.
Di bidang kedokteran, LLM menyarankan kemungkinan diagnosis berdasarkan gejala dan riwayat pasien. Di bidang keuangan, LLM melengkapi upaya analis dengan memudahkan akses informasi relevan dari laporan keuangan. Di bidang hukum, LLM membantu pengacara dengan mengambil perkara dan putusan terdahulu yang relevan serta menyediakan ringkasan dokumen hukum yang besar.
Menggabungkan Large Language Models dengan Knowledge Graph sangat penting dalam aplikasi waktu nyata seperti agregasi berita dan analisis pasar saham.
LLM tradisional tidak mengetahui peristiwa yang belum terjadi saat pelatihan. Karena itu, LLM tidak dapat memberikan respons bermakna untuk pertanyaan yang berbasis pada isu terkini.
KG efisien dalam memproses dan mengorganisasi informasi baru secara waktu nyata. Dengan demikian, KG menyediakan backend informatika bagi LLM untuk menangani aplikasi yang berbasis isu terkini (agregasi berita) dan lingkungan yang berubah cepat (misalnya, pasar saham).
Bagian sebelumnya membahas prinsip dasar LLM dan KG. Pada bagian ini, kami memperkenalkan alat dan pustaka yang digunakan untuk mengintegrasikan KG dan LLM.
KG paling umum diimplementasikan menggunakan database graf seperti:
Database graf khusus (hanya bekerja dengan graf). Neo4j menggunakan Cypher, bahasa kueri graf deklaratif, untuk memasukkan dan mengambil informasi. Cypher secara gaya mirip dengan SQL, sehingga lebih mudah dipelajari pengembang.
Neo4j mengelola data yang saling terhubung kompleks secara efisien karena mesin penyimpanan data dasarnya dibangun dari nol untuk memenuhi use case database graf. Neo4j populer sebagai database graf karena dapat terhubung ke sumber data eksternal seperti Apache Kafka dan mudah diskalakan secara horizontal.
ArangoDB adalah database graf multi-model. Selain graf, ArangoDB juga mendukung dokumen JSON dan penyimpanan key-value. Ini memungkinkan pengguna memperkaya graf dengan informasi lain yang mungkin tidak mudah diubah ke format graf.
Karena fleksibilitas ini, ArangoDB sering dipilih untuk aplikasi perusahaan yang menangani berbagai jenis data. ArangoDB menggunakan Arango Query Language (AQL) untuk bekerja lintas semua tipe data. Di balik layar, ArangoDB menggunakan RocksDB sebagai mesin penyimpanan data.
Neptune dari Amazon mendukung model property graph dan RDF (Resource Description Framework). Neptune menggunakan bahasa kueri SPARQL dan Gremlin. Layanan ini terintegrasi mulus ke infrastruktur AWS untuk berjalan sebagai database graf terkelola penuh, sehingga umum dipilih untuk integrasi dengan infrastruktur yang sudah ada pada aplikasi perusahaan.
LLM dan database graf saling melengkapi namun umumnya tidak dapat berinteraksi langsung. Pada paragraf berikut, kami membahas pustaka dan kerangka kerja integrasi yang digunakan untuk menyalurkan data dari KG ke LLM dan sebaliknya.
RDFlib adalah paket Python sumber terbuka untuk bekerja dengan data RDF. RDFlib memiliki fungsi untuk memanipulasi dan men-query graf RDF. Ini mempermudah integrasi dengan knowledge graph. RDFlib memungkinkan penyimpanan data RDF di memori, di disk, atau jarak jauh menggunakan SPARQL endpoint. SPARQL endpoint, analog dengan API endpoint, dapat menerima dan memproses kueri SPARQL jarak jauh.
RDFlib bekerja dengan struktur data berbasis graf yang terdiri dari triple subjek-predikat-objek. Setiap komponen triple adalah URI atau nilai literal. RDFlib memiliki fungsi untuk mengurai dan menserialisasi triple, XML, dan tipe data lain seperti JSON-LD.
PyTorch Geometric (PyG) adalah pustaka berbasis PyTorch yang dirancang untuk membuat dan melatih Graph Neural Networks (GNN). GNN adalah arsitektur jaringan saraf yang beroperasi pada graf dan dapat menerima struktur data graf sebagai masukan. PyG memiliki fungsi untuk menerapkan teknik deep learning pada graf.
PyG hadir dengan banyak arsitektur GNN siap pakai yang dapat langsung diimplementasikan atau dikembangkan lebih lanjut melalui API message passing.
PyG diklaim cocok untuk aplikasi skala besar dengan jutaan node di berbagai jenis node dan edge. Subbidang ini juga dikenal sebagai geometric deep learning.
Jaringan saraf tradisional unggul dalam mengodekan hubungan linear, tetapi data dunia nyata cenderung kompleks dan multidimensi. Graf lebih baik dalam merepresentasikan keterkaitan berdimensi lebih tinggi di mana setiap node dalam graf dapat berhubungan dengan node lainnya. Ini membuat graf lebih cocok untuk menyimpan hubungan dunia nyata yang kompleks.
LangChain diluncurkan pada 2022 sebagai kerangka integrasi model bahasa. LangChain memfasilitasi pembangunan aplikasi pengguna dengan merangkai LLM dengan alat relevan lainnya, seperti pembungkus API, skrip shell, web scraper, pembaca PDF, Google Docs, database relasional, database vektor, dan database graf (termasuk KG). Karena itu, LangChain umum digunakan untuk membuat aplikasi yang melibatkan LLM.
OpenAI API menghilangkan kerepotan membangun pipeline menggunakan alat seperti PyG. OpenAI API dapat menerima kueri bahasa alami pengguna, memahaminya, dan mengembalikan kueri terstruktur dalam bahasa pemrograman (misalnya, SPARQL). Kueri ini dimasukkan ke KG, yang kemudian mengembalikan data relevan. Data ini dikirim kembali ke OpenAI API, bersama konteks kueri asli. LLM OpenAI menghasilkan respons bahasa alami berdasarkan data yang diambil dari KG.
OpenAI API memungkinkan Anda memilih dari berbagai LLM, bergantung pada tugas dan anggaran. Dengan demikian, Anda tidak perlu menerapkan LLM atau pipeline data untuk berinteraksi dengan KG.
Pada bagian ini, kami memberikan ilustrasi tingkat tinggi tentang pipeline integrasi menggunakan pseudo-code.
Kami menggunakan Neo4j, LangChain, dan OpenAI API untuk menunjukkan langkah-langkah membuat chatbot berbasis RAG. LLM menghasilkan responsnya berdasarkan informasi yang disimpan di KG.
## Import relevant packages

# Handling chat prompts
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.prompts.prompt import PromptTemplate
from langchain_openai import ChatOpenAI

# Implementing the Runnable protocol for chaining components
from langchain_core.runnables import (
    RunnableBranch,
    RunnableLambda,
    RunnableParallel,
    RunnablePassthrough,

# Processing text inputs in the chat
from langchain_core.messages import AIMessage, HumanMessage
from langchain_core.output_parsers import StrOutputParser

# Working with Neo4j graphs
from neo4j import GraphDatabase
from langchain_community.graphs import Neo4jGraph
from langchain_experimental.graph_transformers import LLMGraphTransformer

# Vector embeddings for the LLM
from langchain_openai import OpenAIEmbeddings
from langchain_community.vectorstores import Neo4jVector

# Load data from a source like Wiki, PDF documents, etc.
from langchain.document_loaders import WikipediaLoader

# Create a Neo4jGraph to store the KG
graph = Neo4jGraph()

# Load the document(s) based on which to build the KG. In this snippet, we use Wiki. In practice, this is a business-specific document
raw_documents = WikipediaLoader(...).load()

# Split the document into tokens
documents = create_tokens(raw_documents)

# Instantiate the LLM
llm = ChatOpenAI(model_name="...", …)
llm_transformer = LLMGraphTransformer(llm=llm)

# Use the LLM to convert the tokenized documents into graph entities
graph_docs = llm_transformer.convert_to_graph_documents(documents)

# Add the graph entities to the Neo4j graph
graph.add_graph_documents(graph_docs, …)

# Create a retriever to run on the graph
graph.query(
    "CREATE FULLTEXT INDEX entity IF NOT EXISTS FOR (e:__Entity__) ON EACH [e.id]")

# Create a class to extract entities from the text corresponding to nodes from the graph
class Entities(BaseModel):
    names: List[str] = Field(
        ...,
        description="All the person, organization, or business entities that appear in the text",
    )

# Create a prompt template
prompt = ChatPromptTemplate.from_messages(
    [
        (
            "system",
            "You are extracting organization and person entities from the text.",
        ),
        (
            "human",
            "Use the given format to extract information from the following "
            "input: {question}",
        ),
    ]
)

# Create a chain by piping the prompt to the LLM with the Entities class.
# This chain identifies entities in a given prompt string
entity_chain = prompt | llm.with_structured_output(Entities)


# Create a structured retriever to extract the entities in the query. Given a text query, it retrieves all the relevant nodes in the neighborhood of the entities in that query.

def structured_retriever(question: str) -> str:
    result = ""
    entities = entity_chain.invoke({"question": question})
    for entity in entities.names:
        response = graph.query(
        # CYPHER QUERY TEMPLATE,
        {"query": generate_full_text_query(entity)})
        result += el['output'] for el in response
    return result

# Chain together the different components
chain = (
    RunnableParallel(
        {
            "context": _search_query | retriever,
            "question": RunnablePassthrough(),
        }
    )
    | prompt
    | llm
    | StrOutputParser()
)

# Invoke the chain
chain.invoke({"question": "The user’s question goes here"})KG memperluas kemampuan LLM dan membuatnya relevan untuk use case praktis. Untuk mencapai kinerja terbaik, saya merekomendasikan praktik terbaik berikut.
KG berisi repositori informasi yang menjadi dasar LLM merumuskan responsnya. Oleh karena itu, perlu untuk terus memperbarui database graf dengan informasi terbaru. KG yang kedaluwarsa akan menghasilkan jawaban LLM yang ketinggalan zaman.
LLM dan KG adalah perangkat lunak yang kompleks dengan kebutuhan komputasi besar. Seperti ditunjukkan pada bagian sebelumnya, merangkai LLM dan KG melibatkan banyak langkah, mulai dari tokenisasi pertanyaan pengguna dan menghasilkan kueri graf yang relevan hingga mengambil informasi dari KG dan menghasilkan teks darinya.
Ini dapat menyebabkan inefisiensi dan jeda waktu antara kueri dan respons. Metode optimasi, seperti dijelaskan di bawah, membantu meminimalkan latensi.
LLM adalah model yang boros memori dan sering membutuhkan perangkat keras mahal untuk dijalankan. Ada baiknya mengurangi ukuran model AI menggunakan teknik seperti Distillation dan Kuantisasi LLM:
Anda harus memastikan bahwa model bahasa yang dipilih berkinerja baik dengan jenis kueri yang diharapkan untuk ditangani.
Alat seperti MLFlow membantu mengevaluasi kinerja LLM pada berbagai tugas. Sama seperti kebutuhan pengguna yang berubah dan berkembang, informasi yang disimpan dalam knowledge graph juga berubah seiring waktu. Karena itu, penting untuk secara berkala mengevaluasi ulang kinerja LLM setelah penerapan. Mungkin perlu untuk fine-tuning model pada himpunan data yang diperbarui, menggunakan versi model yang diperbarui, atau bahkan menerapkan model baru.
LLM memperoleh informasi dari KG dan kemampuan bahasa serta penalarannya dari himpunan data pelatihan.
Model dasar LLM dilatih pada himpunan data generik yang sangat besar, biasanya menggunakan teks dari seluruh internet. Fine-tuning LLM pada himpunan data spesifik domain meningkatkan kemampuan penalarannya dalam domain tersebut dan memungkinkannya menyusun kalimat dengan struktur dan jargon yang tepat. Misalnya, untuk menggunakan LLM menjawab pertanyaan medis menggunakan KG medis, saya sangat menyarankan melakukan fine-tuning LLM dasar pada himpunan data teks medis.
Dalam artikel ini, kami membahas prinsip dasar Large Language Models (LLM) dan Knowledge Graph (KG) serta bagaimana keduanya saling melengkapi. Kami juga memperkenalkan beberapa alat yang umum digunakan untuk memanfaatkan LLM dan KG bersama-sama guna membangun aplikasi yang berhadapan dengan pengguna. Terakhir, kami memberikan ilustrasi tingkat tinggi tentang bagaimana Neo4j dan OpenAI dapat digunakan bersama menggunakan LangChain.
Setelah memahami konsep dasar ini, Anda dapat mengimplementasikan alat-alat tersebut dalam praktik:
Pelajari lebih lanjut tentang LLM melalui kursus-kursus ini!
Kursus
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt




