
什么是 VLM?
视觉语言模型的核心在于计算机视觉与自然语言处理的融合。
计算机视觉致力于让机器解读和分析图像、视频等视觉数据,识别物体、模式以及其他视觉要素。
另一方面,自然语言处理关注理解与生成自然语言,使机器能够理解、分析并生成文本。
VLM 通过构建可同时处理并理解视觉与文本输入的模型来弥合两者之间的鸿沟。这得益于先进的深度学习架构,尤其是变换器模型,它们在大型语言模型(如GPT-4o、Llama、Gemini与Gemma)的成功中发挥了关键作用。
这些基于变换器的架构已被改造以处理多模态输入,使 VLM 能捕捉视觉与语言数据之间的复杂关系。
VLM 如何工作?
最初为 NLP 任务提出的变换器模型,因其处理长距离依赖与捕捉上下文关系的能力,已成为众多先进AI系统的骨干。
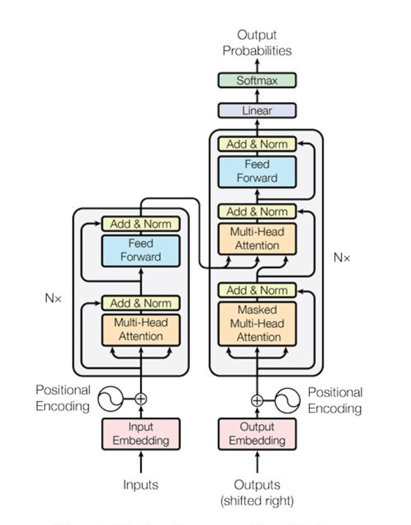
在 VLM 语境下,变换器被改造为可同时处理图像与文本,实现两种模态的无缝融合。
典型的 VLM 架构包含两大组件:图像编码器与文本解码器:
- 图像编码器:负责处理视觉数据,提取特征(物体、颜色、纹理等),并将其转换为模型可理解的表示。
- 文本解码器:处理文本数据,并基于已编码的视觉特征生成输出。
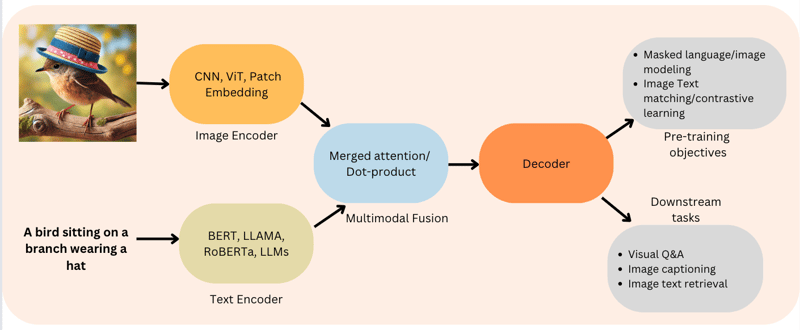
图2:编码器—解码器功能(来源:Viso.ai)
通过结合这两部分,VLM 能做许多出色的事情,例如详细描述图像、回答所见内容的问题,甚至依据文本描述生成新图像!VLM 的处理流程大致如下:
- 图像分析:图像编码器检查图像并生成表示其关键视觉特征的编码。
- 信息融合:文本解码器接收该编码,与任何文本输入(如问题)结合,并一并处理。
- 生成输出:文本解码器据此生成响应,如描述图像的字幕或问题的答案。
多数 VLM 使用视觉变换器(ViT)作为图像编码器,先在大规模图像数据集上预训练,以有效捕捉多模态任务所需的视觉特征。
文本解码器基于语言模型,并经过微调以应对在视觉语境下的语言生成复杂性。视觉与语言处理能力的结合造就了高度通用而强大的 VLM。
开发 VLM 的一大挑战在于需要大量多样、同时包含视觉与文本信息的数据集。此类数据集对于训练模型理解并生成多模态内容至关重要。
训练 VLM 的过程包括向模型提供图像与对应文本描述的配对数据,使其学习视觉元素与语言表达之间的复杂关联。
为处理这些数据,VLM 往往使用嵌入层,将视觉与文本输入一并映射到高维空间,便于比较与组合。
该嵌入过程使模型能够理解两种模态之间的联系,并生成连贯、上下文相关的输出。
开源视觉语言模型概览
视觉语言模型(VLM)的生态十分广阔,Hugging Face Hub上有众多开源模型。它们在规模、能力与许可方面各不相同,为不同应用场景提供多样选择。下表概览部分最具代表性的开源 VLM,并突出其关键特性:
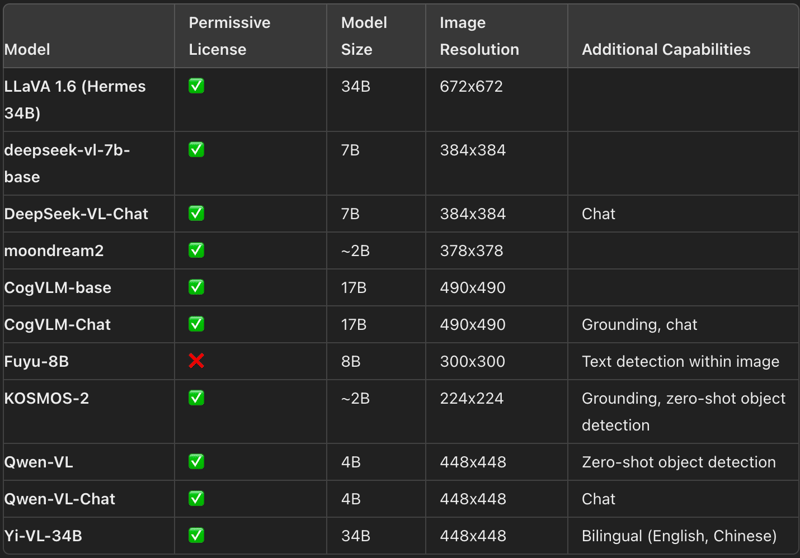
最新 VLM 及其关键特性(来源:HuggingFace)
面对众多选项,为您的特定用例选择最合适的 VLM 可能颇具挑战。以下工具与资源可助您甄选:
- Vision Arena:基于匿名投票结果的动态排行榜。用户输入图像与提示词,系统匿名抽取两个不同模型的输出,用户据此选择更优输出。该榜单完全依据人类偏好构建,提供不带偏见的模型排序。
- Open VLM Leaderboard:按多项指标与平均得分对各类 VLM 排名,并可按模型规模、许可与不同指标表现进行筛选。
- VLMEvalKit:用于在 VLM 上运行基准测试的工具包,为 Open VLM Leaderboard 提供支持。另一套评测工具LMMS-Eval提供命令行界面,使用 Hub 上的数据集评估 Hugging Face 模型。
尽管 Vision Arena 与 Open VLM Leaderboard 提供了有价值的洞见,但它们仅涵盖已提交的模型,并需定期更新以纳入新模型。
评估 VLM 的基准
评估 VLM 性能常用的基准测试包括:
- MMMU:大规模多学科多模态理解与推理基准,覆盖1.15万道多模态挑战题,需具备艺术、工程等学科的大学水平知识。
- MMBench:包含3,000道单选题,覆盖20种能力(含OCR与目标定位)。采用 CircularEval 策略:随机打乱选项,模型需稳定选出正确答案。
- 领域特定基准:如 MathVista(视觉数学推理)、AI2D(图表理解)、ScienceQA(科学问答)、OCRBench(文档理解)等,提供更专业的评估。
技术细节:VLM 的预训练
预训练 VLM 涉及统一图像与文本表示,将其输入文本解码器进行生成。结构通常包含图像编码器、用于对齐图像与文本表示的嵌入投影器,以及文本解码器。不过,不同模型采用的预训练策略各不相同。
在很多情况下,如能针对特定用例微调现有模型,则甚至无需从零预训练 VLM。诸如Transformers与SFTTrainer等工具可简化特定任务的微调流程,即便资源有限也能上手。
实现开源 VLM
以下为 HuggingFace 提供的示例,展示如何在 Colab 或本地机器上,使用 Transformers 库免费运行开源 VLM LlavaNext 模型。
from transformers import LlavaNextProcessor, LlavaNextForConditionalGeneration
import torch
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
processor = LlavaNextProcessor.from_pretrained(
"llava-hf/llava-v1.6-mistral-7b-hf"
)
model = LlavaNextForConditionalGeneration.from_pretrained(
"llava-hf/llava-v1.6-mistral-7b-hf",
torch_dtype=torch.float16,
low_cpu_mem_usage=True
)
model.to(device)VLM 的应用
视觉语言模型的能力远不止图像描述。VLM 通过打通视觉与文本信息,开启了诸多应用场景。下面探索其在不同行业中影响力最大的应用。
视觉问答
视觉问答(VQA)是一项围绕图像内容进行答问的任务。
此应用要求模型既理解图像中的视觉元素,也掌握问题的语言语境。例如,给定一幅繁华城市景观的图像,VLM 可回答“最高建筑是什么颜色?”或“图中能看到多少人?”之类的问题。
VQA 在以视觉数据为关键的行业中有广泛应用。在医疗领域,可用于分析医学影像并回答有助于诊断与治疗规划的问题。在零售领域,VQA 能让顾客以更自然直观的方式与产品图像交互,提升购物体验。
文生图(文本到图像生成)
VLM 最令人兴奋的能力之一是文生图。该任务基于文本描述生成场景或物体的视觉呈现。例如,模型可据提示“群山之上宁静的日落,河流穿过山谷”生成相应图像。
文生图在设计与广告等创意领域潜力巨大。设计师与广告人可用此技术依据文本提示快速产出视觉创意,从而加速生成与特定营销信息相匹配的视觉内容。
图像检索
图像检索是根据文本查询查找相关图像的过程。VLM 借助同时理解图像视觉内容与查询语言语境的能力,在该任务中表现出色。
这使搜索引擎更强大且精准,用户能更轻松地找到所需的确切图像。
图像检索适用于电商到医学影像分析等多种领域。在电商中,可帮助顾客依据视觉与文本描述找到契合偏好的商品。在医疗中,图像检索可协助专业人士查找相关医学影像用于研究或诊断。
视频理解
尽管上述示例聚焦图像,VLM 也可扩展以理解并为视频生成字幕。视频理解涉及分析视频的视觉内容,并生成能够抓住场景要义的描述性文本。
视频理解可用于视频搜索、摘要与内容审核。在视频搜索中,VLM 可根据文本查询帮助用户定位特定片段;在摘要任务中,VLM 能为长视频生成简明摘要,便于快速把握内容;在内容审核中,VLM 能帮助识别视频中的不当或有害内容,保障平台安全与友好。
挑战与考量
下面来看 VLM 面临的挑战,以及其伦理问题。
算力需求
训练与部署 VLM 需要大量计算资源,尤其是对 PaliGemma 这类大模型而言。对于缺乏高性能计算基础设施的组织,这是道门槛。
为应对这一挑战,研究者正在探索提升 VLM 效率的方法,例如采用模型压缩技术、优化模型架构,以及借助 GPU、TPU 等硬件加速器。
伦理考量与偏见缓解
VLM 的发展引发多项伦理关注,尤其是模型输出可能存在偏见。基于大规模真实世界图文数据训练的 VLM,可能反映训练材料中嵌入的社会文化偏见。这些偏见可能在输出中显现,导致有害或冒犯性内容。
为此,研究者采用多种偏见缓解技术,例如使用更均衡的训练数据集、引入公平感知的学习算法,并对模型输出进行严格评估,以发现并纠正潜在偏见。
此外,Google 等组织还实施内容安全过滤,确保用于 PaliGemma 等模型的训练数据干净且不含有害内容。
隐私与数据安全
VLM 开发中的另一重要考量是隐私与数据安全。VLM 往往需要访问大量数据,可能涉及敏感信息。确保数据安全处理并遵循隐私法规,对维护用户与相关方的信任至关重要。
为缓解隐私风险,研究者正探索诸如联邦学习等技术,使模型在分布式数据上训练而无需将敏感信息集中传输到服务器。
此外,Google 等组织也在落实数据责任措施,如从训练数据集中过滤个人信息与敏感数据,以保护个人隐私。
结语
视觉语言模型代表着人工智能的重要进展,凭借其同时处理视觉与文本数据的能力,有望提升多种应用。
随着研究不断深入,我们有望看到更为复杂的 VLM 能胜任更复杂的任务并提供更有价值的洞见。
视觉与文本理解的融合带来新的创新空间,使 VLM 成为一个极具前景的研究与开发方向。

自然语言处理(NLP)与计算机视觉(CV)近年显著进步,使机器能够理解文本与图像。二者的融合催生了视觉语言模型(VLM),能够同时处理并理解视觉与文本数据。
VLM 是新兴的一类AI模型,可执行涉及图像与文本的任务,如图像描述、视觉问答以及文生图。这些任务过去需要分离的专用系统,而VLM提供了统一的方法。让我们进一步了解视觉语言模型。