
Chỉ số quan trọng để đánh giá LLM
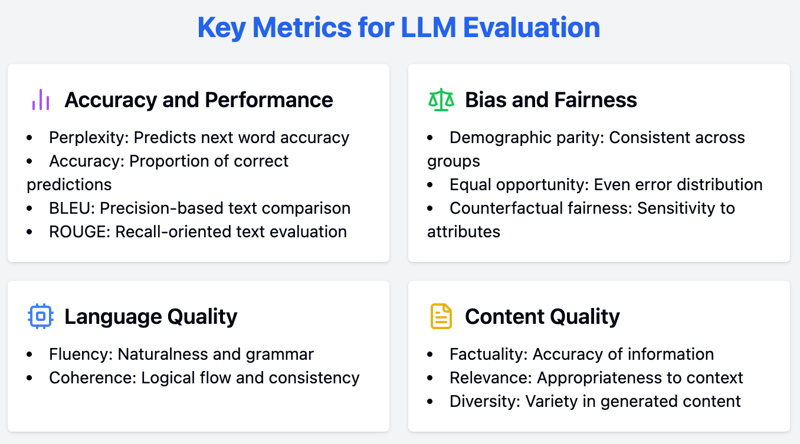
Đánh giá LLM đòi hỏi một cách tiếp cận toàn diện, sử dụng nhiều thước đo để xem xét các khía cạnh khác nhau của hiệu năng. Trong phần này, chúng ta khám phá các tiêu chí đánh giá chính cho LLM, gồm độ chính xác và hiệu năng, thiên lệch và công bằng, cũng như các chỉ số quan trọng khác.
Chỉ số về độ chính xác và hiệu năng
Đo lường chính xác hiệu năng là bước quan trọng để hiểu năng lực của một LLM. Phần này đi sâu vào các chỉ số chủ đạo dùng để đánh giá độ chính xác và hiệu năng.
Perplexity
Perplexity là một chỉ số nền tảng để đánh giá và đo lường khả năng của LLM trong việc dự đoán từ tiếp theo trong chuỗi. Cách tính như sau:
- Xác suất: Trước hết, mô hình tính xác suất của mỗi từ có thể xuất hiện tiếp theo trong câu.
- Nghịch đảo xác suất: Ta lấy giá trị nghịch đảo của xác suất này. Ví dụ, nếu một từ có xác suất cao (nghĩa là mô hình cho là khả dĩ), thì nghịch đảo xác suất sẽ thấp hơn.
- Chuẩn hóa: Sau đó, ta lấy trung bình nghịch đảo xác suất này trên tất cả các từ trong bộ kiểm thử (đoạn văn bản dùng để kiểm tra mô hình).
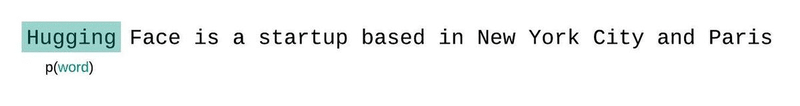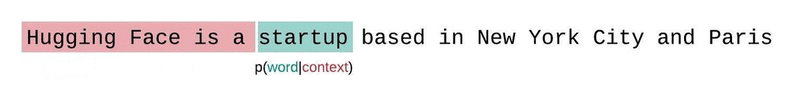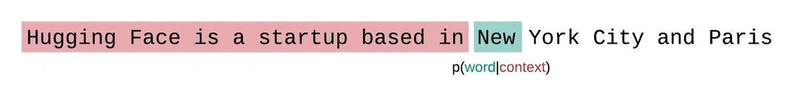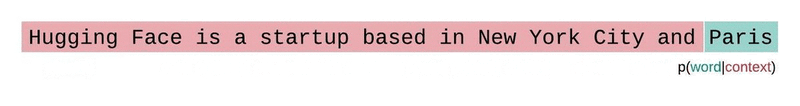
Minh họa LLM dự đoán xác suất của từ tiếp theo dựa trên ngữ cảnh. Nguồn
Điểm perplexity thấp hơn cho thấy mô hình dự đoán từ tiếp theo chính xác hơn, phản ánh hiệu năng tốt hơn. Về bản chất, nó định lượng mức độ mà một phân phối xác suất hoặc mô hình dự đoán phù hợp với mẫu dữ liệu.
Với LLM, perplexity thấp hơn nghĩa là mô hình tự tin hơn trong dự đoán từ, giúp văn bản sinh ra mạch lạc và phù hợp ngữ cảnh hơn.
Accuracy
Accuracy là chỉ số được dùng rộng rãi cho nhiệm vụ phân loại, biểu thị tỷ lệ dự đoán đúng của mô hình. Dù trực quan, trong bối cảnh các nhiệm vụ sinh văn bản mở, nó thường dễ gây hiểu nhầm.
Chẳng hạn, khi tạo văn bản sáng tạo hoặc mang sắc thái ngữ cảnh, việc xác định "đúng" không đơn giản như với các nhiệm vụ như phân tích cảm xúc hoặc phân loại chủ đề. Do đó, dù accuracy hữu ích cho những nhiệm vụ cụ thể, nó nên được bổ sung bằng các chỉ số khác khi đánh giá LLM.
Điểm BLEU/ROUGE
BLEU (Bilingual Evaluation Understudy) và ROUGE (Recall-Oriented Understudy for Gisting Evaluation) được dùng để đánh giá chất lượng văn bản sinh ra bằng cách so sánh với văn bản tham chiếu.
BLEU nhấn mạnh độ chính xác: nếu bản dịch máy dùng đúng các từ như bản dịch người, điểm BLEU sẽ cao. Ví dụ, nếu tham chiếu là "The cat is on the mat," và đầu ra máy là "The cat sits on the mat," điểm BLEU sẽ cao vì nhiều từ trùng khớp.
ROUGE tập trung vào độ bao phủ: kiểm tra liệu văn bản do máy sinh có nắm bắt đủ ý chính từ tham chiếu của con người hay không. Giả sử tóm tắt do người viết là "The study found that people who exercise regularly tend to have lower blood pressure." Nếu tóm tắt do AI tạo là "Exercise linked to lower blood pressure," ROUGE sẽ cho điểm cao vì nắm bắt được ý chính dù cách diễn đạt khác.
Các chỉ số này hữu ích cho những nhiệm vụ như dịch máy, tóm tắt và sinh văn bản, cung cấp đánh giá định lượng về mức độ đầu ra của mô hình khớp với văn bản tham chiếu do con người tạo.
Chỉ số về thiên lệch và công bằng
Đảm bảo công bằng và giảm thiên lệch trong LLM là điều thiết yếu để có các ứng dụng công bằng. Phần này đề cập những chỉ số chủ chốt để đánh giá thiên lệch và công bằng trong LLM.
Bình đẳng theo nhân khẩu học
Bình đẳng theo nhân khẩu học cho biết liệu hiệu năng của mô hình có nhất quán giữa các nhóm nhân khẩu học khác nhau hay không. Nó đánh giá tỷ lệ kết quả tích cực giữa các nhóm được xác định bởi thuộc tính như chủng tộc, giới, hoặc độ tuổi.
Đạt được bình đẳng theo nhân khẩu học nghĩa là dự đoán của mô hình không thiên vị nhóm cụ thể nào, đảm bảo tính công bằng và bình đẳng trong ứng dụng.
Cơ hội bình đẳng
Cơ hội bình đẳng tập trung vào việc lỗi của mô hình có được phân bố đều giữa các nhóm nhân khẩu học khác nhau hay không. Nó đánh giá tỷ lệ âm giả của từng nhóm, xác nhận rằng mô hình không thất bại một cách bất cân xứng với một số nhóm nhất định.
Chỉ số này đặc biệt quan trọng với các ứng dụng nơi công bằng và cơ hội tiếp cận ngang nhau là cốt lõi, như thuật toán tuyển dụng hoặc quy trình phê duyệt khoản vay.
Công bằng phản sự kiện
Công bằng phản sự kiện đánh giá liệu dự đoán của mô hình có thay đổi nếu một số thuộc tính nhạy cảm khác đi hay không. Điều này liên quan đến việc tạo các ví dụ phản sự kiện trong đó thuộc tính nhạy cảm (ví dụ: giới hoặc chủng tộc) được thay đổi trong khi giữ nguyên các đặc trưng khác.
Nếu dự đoán của mô hình thay đổi dựa trên điều chỉnh này, điều đó cho thấy tồn tại thiên lệch liên quan đến thuộc tính nhạy cảm. Công bằng phản sự kiện rất quan trọng để nhận diện và giảm thiểu những thiên lệch có thể không lộ rõ qua các chỉ số khác.
Chỉ số khác
Ngoài hiệu năng và công bằng, các tiêu chí bổ sung cũng hữu ích cho đánh giá toàn diện LLM. Phần này nêu bật các khía cạnh đó.
Độ trôi chảy
Độ trôi chảy đánh giá tính tự nhiên và đúng ngữ pháp của văn bản sinh ra. Một LLM trôi chảy tạo ra đầu ra dễ đọc, dễ hiểu, mô phỏng dòng chảy ngôn ngữ tự nhiên của con người.
Có thể đánh giá bằng công cụ tự động hoặc nhận định của con người, tập trung vào ngữ pháp, cú pháp và khả năng đọc tổng thể.
Tính mạch lạc
Tính mạch lạc giúp phân tích dòng chảy logic và tính nhất quán của văn bản sinh ra. Một văn bản mạch lạc duy trì cấu trúc rõ ràng và sự phát triển ý tưởng hợp lý, giúp người đọc dễ theo dõi. Tính mạch lạc đặc biệt quan trọng với văn bản dài, như bài luận hoặc bài viết, nơi việc giữ mạch truyện nhất quán là then chốt.
Tính xác thực
Tính xác thực đánh giá độ chính xác của thông tin do LLM cung cấp, đặc biệt trong các nhiệm vụ tìm kiếm thông tin. Chỉ số này xác nhận rằng mô hình tạo ra văn bản không chỉ có vẻ hợp lý mà còn đúng sự thật.
Tính xác thực là không thể thiếu cho các ứng dụng như tạo tin tức, nội dung giáo dục và hỗ trợ khách hàng, nơi mục tiêu chính là cung cấp thông tin chính xác.
Phương pháp luận đánh giá
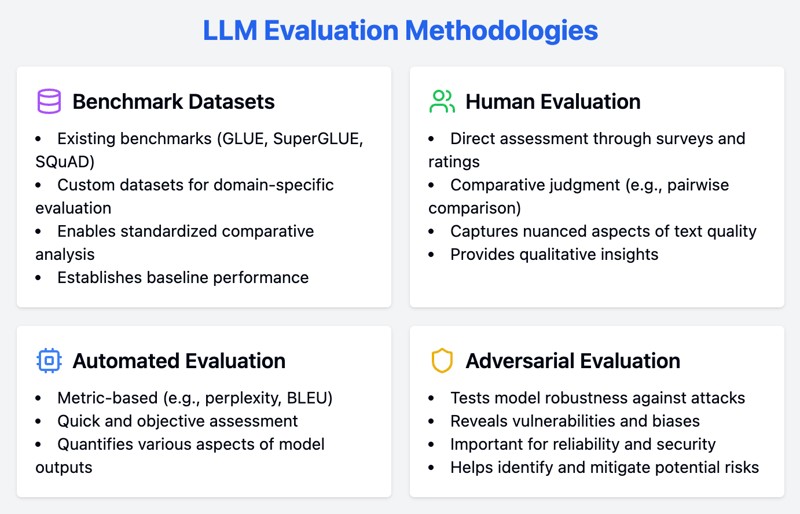
Đánh giá LLM vững chắc đòi hỏi kết hợp cả định lượng và định tính. Phần này trình bày nhiều phương pháp, như bộ dữ liệu chuẩn, kỹ thuật đánh giá của con người và phương pháp đánh giá tự động, để thẩm định toàn diện hiệu năng LLM.
Bộ dữ liệu chuẩn (benchmark)
Bộ dữ liệu benchmark là công cụ giá trị để đánh giá LLM, cung cấp các nhiệm vụ chuẩn hóa cho phép so sánh giữa các mô hình. Chúng giúp thiết lập đường cơ sở hiệu năng và tạo điều kiện cho việc đối sánh.
Benchmark hiện có
Các bộ dữ liệu benchmark là công cụ quan trọng để đánh giá LLM, cung cấp các nhiệm vụ chuẩn hóa cho phép phân tích so sánh giữa các mô hình khác nhau. Một số bộ dữ liệu phổ biến nhất cho các nhiệm vụ xử lý ngôn ngữ tự nhiên (NLP) gồm:
- GLUE (General Language Understanding Evaluation): Tập hợp nhiều nhiệm vụ đa dạng nhằm đánh giá năng lực ngôn ngữ tổng quát của LLM, gồm phân tích cảm xúc, suy diễn văn bản và hỏi đáp.
- SuperGLUE: Phiên bản nâng cao của GLUE, gồm các nhiệm vụ thách thức hơn để kiểm tra độ vững và hiểu biết tinh tế của LLM.
- SQuAD (Stanford Question Answering Dataset): Bộ dữ liệu tập trung vào đọc hiểu, nơi mô hình được chấm điểm dựa trên khả năng trả lời câu hỏi rút ra từ các bài viết Wikipedia.
Bộ dữ liệu tùy chỉnh
Dù các benchmark hiện có là vô giá, việc tạo bộ dữ liệu tùy chỉnh rất quan trọng cho đánh giá theo miền. Bộ dữ liệu tùy chỉnh cho phép điều chỉnh quy trình đánh giá theo yêu cầu và thách thức riêng của ứng dụng hoặc ngành cụ thể.
Ví dụ, một tổ chức chăm sóc sức khỏe có thể tạo bộ dữ liệu hồ sơ y tế và ghi chú lâm sàng để đánh giá khả năng của LLM trong xử lý thuật ngữ và ngữ cảnh y khoa. Bộ dữ liệu tùy chỉnh đảm bảo hiệu năng mô hình phù hợp với trường hợp sử dụng thực tế, cung cấp thông tin chi tiết phù hợp và hữu ích hơn.
Đánh giá bởi con người
Phương pháp đánh giá của con người là không thể thiếu để thẩm định những khía cạnh tinh tế của đầu ra LLM mà các chỉ số tự động có thể bỏ lỡ. Các kỹ thuật này dựa trên phản hồi trực tiếp từ giám khảo, mang lại hiểu biết định tính về hiệu năng mô hình.
Đánh giá trực tiếp
Đánh giá của con người vẫn là tiêu chuẩn vàng để thẩm định chất lượng đầu ra LLM. Phương pháp đánh giá trực tiếp bao gồm thu thập phản hồi từ giám khảo thông qua khảo sát và thang điểm.
Các phương pháp này có thể nắm bắt những sắc thái về chất lượng văn bản như độ trôi chảy, tính mạch lạc và mức độ liên quan mà chỉ số tự động có thể bỏ qua. Giám khảo cũng có thể đưa ra phản hồi định tính về điểm mạnh và điểm yếu cụ thể, giúp xác định các khu vực cần cải thiện.
Đánh giá so sánh
Đánh giá so sánh sử dụng kỹ thuật như so cặp, nơi người đánh giá trực tiếp so sánh đầu ra của các mô hình khác nhau. Cách này có thể đáng tin cậy hơn so với chấm điểm tuyệt đối vì giảm tính chủ quan của từng người chấm.
Người đánh giá được yêu cầu chọn đầu ra tốt hơn từ các cặp văn bản sinh ra, cung cấp xếp hạng tương đối về hiệu năng mô hình. Đánh giá so sánh đặc biệt hữu ích để tinh chỉnh mô hình và chọn biến thể đạt hiệu năng cao nhất.
Đánh giá tự động
Phương pháp đánh giá tự động cung cấp cách nhanh và khách quan để thẩm định hiệu năng LLM. Các phương pháp này sử dụng nhiều chỉ số để định lượng các khía cạnh khác nhau của đầu ra mô hình, đảm bảo đánh giá toàn diện.
Dựa trên chỉ số
Các chỉ số tự động cho phép đánh giá LLM nhanh và khách quan. Những chỉ số như perplexity và BLEU được dùng rộng rãi để thẩm định nhiều khía cạnh của sinh văn bản.
Như đã đề cập, perplexity đo lường khả năng dự đoán của mô hình, điểm thấp hơn cho thấy hiệu năng tốt hơn. Trong khi đó, BLEU đánh giá chất lượng văn bản sinh ra bằng cách so với văn bản tham chiếu, tập trung vào độ chính xác của n-gram.
Đánh giá đối kháng
Đánh giá đối kháng liên quan đến việc đưa LLM vào các cuộc tấn công đối kháng để kiểm tra độ vững. Các tấn công này được thiết kế để khai thác điểm yếu và thiên lệch của mô hình, bộc lộ lỗ hổng có thể không hiện rõ qua phương pháp đánh giá tiêu chuẩn.
Một cuộc tấn công đối kháng có thể bao gồm việc đưa vào dữ liệu được chỉnh sửa nhẹ hoặc gây hiểu lầm để phân tích phản ứng của mô hình. Cách tiếp cận này hữu ích cho các ứng dụng coi trọng độ tin cậy và an toàn, vì giúp nhận diện và giảm thiểu rủi ro tiềm ẩn.
Thực tiễn tốt nhất khi đánh giá LLM
Để đánh giá hiệu quả năng lực của LLM, nên tuân theo một cách tiếp cận có chiến lược. Áp dụng thực tiễn tốt nhất giúp quy trình đánh giá của bạn toàn diện, minh bạch và phù hợp với yêu cầu riêng. Dưới đây là các thực tiễn nên theo.
|
Thực tiễn tốt nhất |
Mô tả |
Tình huống ví dụ |
Chỉ số liên quan |
|
Xác định mục tiêu rõ ràng |
Xác định các nhiệm vụ và mục tiêu LLM cần đạt trước khi bắt đầu quy trình đánh giá. |
Cải thiện hiệu năng dịch máy của một LLM |
Điểm BLEU/ROUGE |
|
Xem xét đối tượng người dùng |
Điều chỉnh đánh giá theo người dùng mục tiêu của LLM, cân nhắc kỳ vọng và nhu cầu của họ. |
LLM dùng để sinh văn bản |
Perplexity, Độ trôi chảy, Tính mạch lạc |
|
Minh bạch và tái lập |
Đảm bảo quy trình đánh giá được ghi chép đầy đủ và có thể được người khác lặp lại để xác minh và cải tiến. |
Công bố công khai bộ dữ liệu và mã dùng để đánh giá năng lực của LLM |
Bất kỳ chỉ số liên quan nào, tùy theo nhiệm vụ và mục tiêu đánh giá cụ thể |
Kết luận
Hướng dẫn này đã cung cấp cái nhìn tổng quan toàn diện về các chỉ số và phương pháp luận thiết yếu để đánh giá LLM, từ perplexity và accuracy đến các thước đo thiên lệch và công bằng.
Bằng cách kết hợp cả kỹ thuật đánh giá định lượng và định tính, đồng thời tuân thủ các thực tiễn tốt nhất, chúng ta có thể đảm bảo việc thẩm định các mô hình này một cách toàn diện và đáng tin cậy.
Với kiến thức này, chúng ta có thể lựa chọn và triển khai các LLM phù hợp nhất với nhu cầu, đảm bảo hiệu năng và độ tin cậy tối ưu trong những ứng dụng đã chọn.

Thạc sĩ mới tốt nghiệp, chuyên về Trí tuệ nhân tạo


Các mô hình ngôn ngữ lớn (LLM) đang nhanh chóng trở thành một phần không thể thiếu của nhiều ứng dụng, từ chatbot đến tạo nội dung.
Tuy nhiên, việc đánh giá những mô hình mạnh mẽ này đặt ra thách thức. Làm sao đo lường chính xác hiệu năng và độ tin cậy của chúng, xét đến năng lực và cách triển khai đa dạng?
Hướng dẫn này cung cấp cái nhìn tổng quan toàn diện về đánh giá LLM, bao quát các chỉ số, phương pháp luận và thực tiễn tốt nhất cốt lõi để giúp bạn đưa ra quyết định sáng suốt về mô hình phù hợp nhất với nhu cầu.