
कोर्स
AI Security और Risk Management
2 घंटा
11.8K
अभ्यास और ट्रैक अपनी प्रगति को।
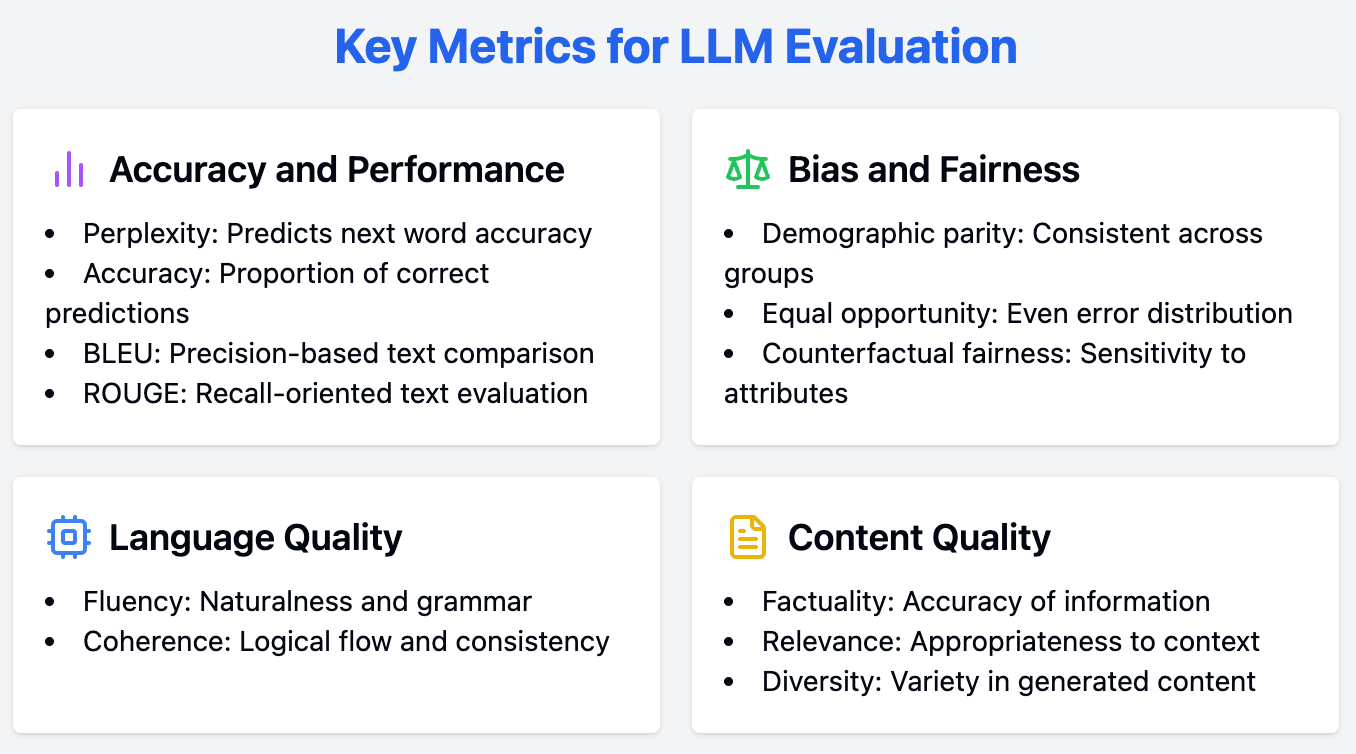
Google के साथ जारी रखेंLLMs का मूल्यांकन करने के लिए एक व्यापक दृष्टिकोण की आवश्यकता होती है, जो उनके प्रदर्शन के विभिन्न पहलुओं को आँकने के लिए कई उपायों का उपयोग करता है। इस चर्चा में, हम LLMs के प्रमुख मूल्यांकन मानदंडों का अन्वेषण करते हैं, जिनमें शुद्धता और प्रदर्शन, पक्षपात और निष्पक्षता, तथा अन्य महत्वपूर्ण मीट्रिक्स शामिल हैं।
प्रदर्शन को सटीक रूप से मापना किसी LLM की क्षमताओं को समझने की दिशा में एक महत्वपूर्ण कदम है। यह अनुभाग शुद्धता और प्रदर्शन का मूल्यांकन करने के लिए उपयोग किए जाने वाले प्राथमिक मीट्रिक्स पर प्रकाश डालता है।
Perplexity किसी LLM की किसी क्रम में अगले शब्द की भविष्यवाणी करने की क्षमता का मूल्यांकन व मापन करने के लिए एक बुनियादी मीट्रिक है। इसे हम इस प्रकार गणना कर सकते हैं:
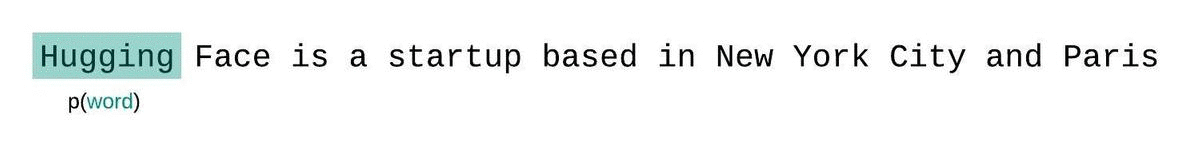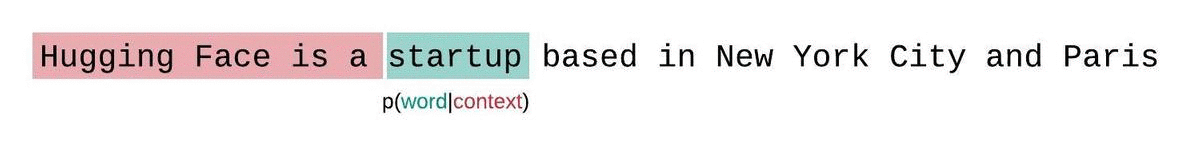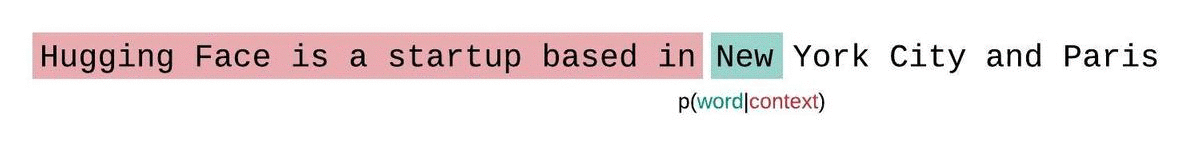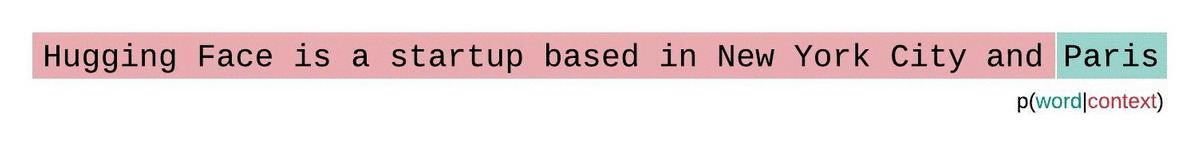
कम perplexity स्कोर दर्शाते हैं कि मॉडल अगला शब्द अधिक सटीकता से भविष्यवाणी करता है, जो बेहतर प्रदर्शन को परिलक्षित करता है। मूलतः, यह मापता है कि कोई प्रायिकता वितरण या भविष्यवाणी मॉडल किसी नमूने की कितनी अच्छी भविष्यवाणी करता है।
LLMs के लिए, कम perplexity का अर्थ है कि मॉडल अपने शब्द-पूर्वानुमानों को लेकर अधिक आत्मविश्वासी है, जिसके परिणामस्वरूप अधिक सुसंगत और संदर्भानुकूल पाठ-सृजन होता है।
Accuracy वर्गीकरण कार्यों के लिए व्यापक रूप से प्रयुक्त मीट्रिक है, जो मॉडल द्वारा की गई सही भविष्यवाणियों के अनुपात का प्रतिनिधित्व करता है। यद्यपि यह एक सहज मीट्रिक है, फिर भी खुले-अंत वाले जनरेशन कार्यों के संदर्भ में यह अक्सर भ्रामक हो सकता है।
उदाहरण के लिए, जब रचनात्मक या संदर्भ-संवेदी पाठ उत्पन्न किया जाता है, तो आउटपुट की "सही होने" की परिभाषा उतनी सरल नहीं होती जितनी भाव विश्लेषण या विषय-वर्गीकरण जैसे कार्यों में होती है। इसलिए, जबकि सटीकता विशिष्ट कार्यों के लिए उपयोगी है, LLMs का मूल्यांकन करते समय इसे अन्य मीट्रिक्स के साथ पूरक करना चाहिए।
BLEU (Bilingual Evaluation Understudy) और ROUGE (Recall-Oriented Understudy for Gisting Evaluation) स्कोर संदर्भ पाठों से तुलना करके जनरेटेड टेक्स्ट की गुणवत्ता का मूल्यांकन करने के लिए उपयोग किए जाते हैं।
BLEU पूरी तरह प्रिसिजन पर केंद्रित है: यदि मशीन अनुवाद मानव अनुवाद के बिल्कुल वही शब्द उपयोग करता है, तो उसे उच्च BLEU स्कोर मिलता है। उदाहरण के लिए, यदि मानव संदर्भ है "The cat is on the mat," और मशीन आउटपुट है "The cat sits on the mat," तो कई शब्दों के ओवरलैप के कारण BLEU स्कोर उच्च होगा।
ROUGE रिकॉल पर केंद्रित है: यह जाँचता है कि मशीन-जनित पाठ मानव संदर्भ से सभी महत्वपूर्ण विचारों को समेटता है या नहीं। मान लीजिए, मानव-संक्षेप है "The study found that people who exercise regularly tend to have lower blood pressure." यदि AI-जनित संक्षेप है "Exercise linked to lower blood pressure," तो अलग शब्दावली होने पर भी मुख्य बिंदु समाहित करने के कारण ROUGE उच्च स्कोर देगा।
ये मीट्रिक्स मशीन अनुवाद, संक्षेपण, और पाठ-सृजन जैसे कार्यों के लिए उपयोगी हैं, जो यह मात्रात्मक आकलन प्रदान करते हैं कि मॉडल का आउटपुट मानव-जनित संदर्भ पाठों से कितना मेल खाता है।
LLMs में निष्पक्षता सुनिश्चित करना और पक्षपात कम करना समानतापूर्ण अनुप्रयोगों के लिए आवश्यक है। यहाँ हम LLMs में पक्षपात और निष्पक्षता का मूल्यांकन करने के प्रमुख मीट्रिक्स को कवर करते हैं।
Demographic parity यह दर्शाता है कि क्या मॉडल का प्रदर्शन विभिन्न जनसांख्यिकीय समूहों में सुसंगत है। यह नस्ल, लिंग, या आयु जैसे गुणों द्वारा परिभाषित समूहों में सकारात्मक परिणामों के अनुपात का आकलन करता है।
Demographic parity हासिल करने का अर्थ है कि मॉडल की भविष्यवाणियाँ किसी विशेष समूह के पक्ष में पक्षपाती नहीं हैं, जिससे इसकी अनुप्रयोगों में निष्पक्षता और समानता सुनिश्चित होती है।
Equal opportunity इस बात पर केंद्रित है कि क्या मॉडल की त्रुटियाँ विभिन्न जनसांख्यिकीय समूहों में समान रूप से वितरित हैं। यह प्रत्येक समूह के लिए फ़ॉल्स-नेगेटिव दरों का आकलन करता है, यह सत्यापित करते हुए कि मॉडल कुछ समूहों के लिए असंगत रूप से विफल न हो।
यह मीट्रिक उन अनुप्रयोगों के लिए महत्वपूर्ण है जहाँ निष्पक्षता और समान अवसर आवश्यक हैं, जैसे भर्ती एल्गोरिद्म या ऋण स्वीकृति प्रक्रियाएँ।
Counterfactual fairness यह मूल्यांकन करता है कि यदि कुछ संवेदनशील गुण भिन्न होते, तो क्या मॉडल की भविष्यवाणियाँ बदल जातीं। इसमें ऐसे प्रतितथ्य उदाहरण उत्पन्न करना शामिल है जहाँ संवेदनशील गुण (जैसे, लिंग या नस्ल) को बदला जाता है जबकि अन्य विशेषताएँ स्थिर रखी जाती हैं।
यदि इस परिवर्तन के आधार पर मॉडल की भविष्यवाणी बदलती है, तो यह संवेदनशील गुण से संबंधित पक्षपात को दर्शाता है। Counterfactual fairness उन पक्षपातों की पहचान और शमन के लिए महत्वपूर्ण है जो अन्य मीट्रिक्स से स्पष्ट नहीं होते।
प्रदर्शन और निष्पक्षता से परे, LLMs के व्यापक मूल्यांकन के लिए अतिरिक्त मानदंड उपयोगी होते हैं। यह अनुभाग इन पहलुओं को उजागर करता है।
Fluency जनरेटेड टेक्स्ट की स्वाभाविकता और व्याकरणिक शुद्धता का आकलन करता है। एक प्रवहमान LLM ऐसे आउटपुट देता है जो पढ़ने और समझने में आसान हों, और मानव भाषा के प्रवाह की नकल करता हो।
इसे स्वचालित उपकरणों या मानवीय निर्णय के माध्यम से मूल्यांकित किया जा सकता है, जिसमें व्याकरण, वाक्य-विन्यास, और समग्र पठनीयता जैसे पहलुओं पर ध्यान केंद्रित होता है।
Coherence जनरेटेड टेक्स्ट के तार्किक प्रवाह और सुसंगति का विश्लेषण करने में सहायक होता है। एक सुसंगत पाठ एक स्पष्ट संरचना और विचारों की तार्किक प्रगति बनाए रखता है, जिससे पाठकों के लिए उसका अनुसरण करना आसान होता है। लंबे टेक्स्ट जैसे निबंध या लेखों के लिए, जहाँ एक स्थिर कथ्य बनाए रखना अहम है, सामंजस्य विशेष रूप से महत्वपूर्ण है।
Factuality LLM द्वारा प्रदान की गई जानकारी की सटीकता का मूल्यांकन करता है, खासकर सूचना-खोजी कार्यों में। यह मीट्रिक पुष्ट करता है कि मॉडल न केवल युक्तिसंगत बल्कि तथ्यात्मक रूप से सही पाठ भी उत्पन्न करता है।
समाचार-लेखन, शैक्षणिक सामग्री, और ग्राहक सहायता जैसे अनुप्रयोगों के लिए तथ्यात्मकता अपरिहार्य है, जहाँ सटीक जानकारी प्रदान करना मुख्य उद्देश्य है।
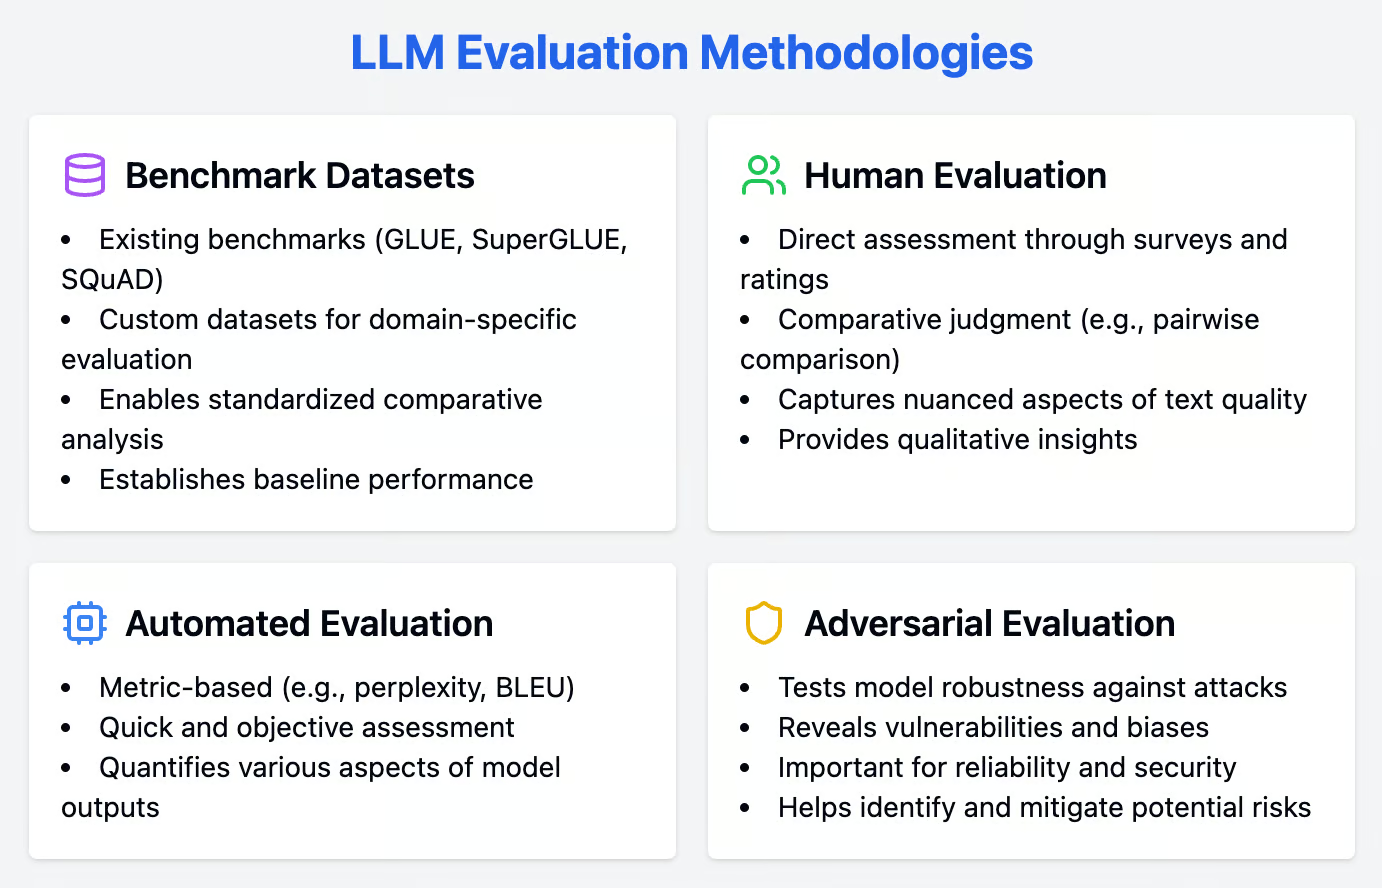
LLMs के सुदृढ़ मूल्यांकन में मात्रात्मक और गुणात्मक दोनों दृष्टिकोणों का एकीकरण शामिल होता है। यह अनुभाग बेंचमार्क डेटासेट, मानवीय मूल्यांकन तकनीकों, और स्वचालित मूल्यांकन विधियों जैसी विभिन्न कार्य-पद्धतियों का विवरण देता है ताकि LLM प्रदर्शन का समग्र आकलन किया जा सके।
बेंचमार्क डेटासेट LLMs का मूल्यांकन करने के लिए मूल्यवान उपकरण हैं, जो मानकीकृत कार्य प्रदान करते हैं और विभिन्न मॉडलों के बीच तुलनात्मक विश्लेषण सक्षम करते हैं। ये डेटासेट मॉडल प्रदर्शन के लिए एक आधार-रेखा स्थापित करने और बेंचमार्किंग में सहायक होते हैं।
बेंचमार्क डेटासेट LLMs का मूल्यांकन करने के लिए महत्वपूर्ण उपकरण हैं, जो मानकीकृत कार्य प्रदान करते हैं और विभिन्न मॉडलों के बीच तुलनात्मक विश्लेषण सक्षम करते हैं। विभिन्न प्राकृतिक भाषा प्रसंस्करण (NLP) कार्यों के लिए कुछ सबसे लोकप्रिय बेंचमार्क डेटासेट में शामिल हैं:
जहाँ मौजूदा बेंचमार्क अमूल्य हैं, वहीं डोमेन-विशिष्ट मूल्यांकन के लिए कस्टम डेटासेट बनाना अत्यंत महत्वपूर्ण है। कस्टम डेटासेट हमें मूल्यांकन प्रक्रिया को किसी विशिष्ट अनुप्रयोग या उद्योग की अनूठी आवश्यकताओं और चुनौतियों के अनुरूप ढालने की अनुमति देते हैं।
उदाहरण के लिए, कोई हेल्थकेयर संगठन चिकित्सकीय अभिलेखों और नैदानिक नोट्स का डेटासेट बना सकता है ताकि किसी LLM की चिकित्सा शब्दावली और संदर्भ सँभालने की क्षमता का मूल्यांकन किया जा सके। कस्टम डेटासेट यह सुनिश्चित करते हैं कि मॉडल का प्रदर्शन वास्तविक उपयोग मामलों के अनुरूप हो, और अधिक प्रासंगिक व क्रियाशील अंतर्दृष्टि प्रदान हो।
मानवीय मूल्यांकन विधियाँ LLM आउटपुट के उन सूक्ष्म पहलुओं का आकलन करने के लिए अनिवार्य हैं जिन्हें स्वचालित मीट्रिक्स चूक सकते हैं। ये तकनीकें मानव निर्णायकों से सीधे फीडबैक शामिल करती हैं, जो मॉडल प्रदर्शन पर गुणात्मक अंतर्दृष्टि प्रदान करती हैं।
LLM आउटपुट की गुणवत्ता का आकलन करने के लिए मानवीय मूल्यांकन स्वर्ण-मानक बना हुआ है। प्रत्यक्ष आकलन विधियाँ सर्वेक्षणों और रेटिंग स्केल्स का उपयोग कर मानव निर्णायकों से फीडबैक संकलित करती हैं।
इन विधियों से टेक्स्ट गुणवत्ता के सूक्ष्म पहलू—जैसे प्रवाह, सामंजस्य, और प्रासंगिकता—पकड़े जा सकते हैं, जिन्हें स्वचालित मीट्रिक्स नज़रअंदाज कर सकते हैं। मानव निर्णायक विशिष्ट ताकतों और कमियों पर गुणात्मक फीडबैक दे सकते हैं, जिससे सुधार के ठोस क्षेत्रों की पहचान में मदद मिलती है।
तुलनात्मक निर्णय में पेयरवाइज़ तुलना जैसी तकनीकें शामिल हैं, जहाँ मानव मूल्यांकनकर्ता विभिन्न मॉडलों के आउटपुट की सीधे तुलना करते हैं। यह विधि निरपेक्ष रेटिंग स्केल्स की तुलना में अधिक भरोसेमंद हो सकती है, क्योंकि यह व्यक्तिगत रेटिंग्स से जुड़े व्यक्तिपरकता को कम करती है।
मूल्यांकनकर्ताओं से जनरेटेड टेक्स्ट की जोड़ियों में बेहतर आउटपुट चुनने के लिए कहा जाता है, जो मॉडल प्रदर्शन की सापेक्ष रैंकिंग प्रदान करता है। तुलनात्मक निर्णय विशेष रूप से मॉडल्स का फाइन-ट्यूनिंग और सर्वोत्तम-प्रदर्शन करने वाले रूपांतरों का चयन में उपयोगी है।
स्वचालित मूल्यांकन विधियाँ LLM प्रदर्शन का त्वरित और वस्तुनिष्ठ आकलन प्रदान करती हैं। ये विधियाँ मॉडल आउटपुट के विभिन्न पहलुओं को मात्राबद्ध करने के लिए विविध मीट्रिक्स का उपयोग करती हैं, जिससे व्यापक मूल्यांकन सुनिश्चित होता है।
स्वचालित मीट्रिक्स LLM प्रदर्शन का मूल्यांकन करने का तेज़ और वस्तुनिष्ठ तरीका प्रदान करते हैं। Perplexity और BLEU जैसी मीट्रिक्स पाठ-सृजन के विभिन्न पहलुओं का आकलन करने के लिए व्यापक रूप से प्रयुक्त होती हैं।
जैसा कि पहले चर्चा की गई, perplexity मॉडल की भविष्यवाणी क्षमता को मापता है, जहाँ कम स्कोर बेहतर प्रदर्शन का संकेत हैं। दूसरी ओर, BLEU संदर्भ पाठों से तुलना करके जनरेटेड टेक्स्ट की गुणवत्ता का मूल्यांकन करता है और n-grams की प्रिसिजन पर केंद्रित रहता है।
Adversarial मूल्यांकन में LLMs को प्रतिकूल हमलों के अधीन करना शामिल होता है ताकि उनकी मजबूती की जाँच की जा सके। ये हमले मॉडल में मौजूद कमज़ोरियों और पक्षपातों का लाभ उठाने के लिए बनाए जाते हैं, और ऐसी कमजोरियों का पता लगाते हैं जो मानक मूल्यांकन विधियों से स्पष्ट न हों।
किसी प्रतिकूल हमले में थोड़ा बदला हुआ या भ्रामक डेटा इनपुट करना शामिल हो सकता है ताकि यह विश्लेषण किया जा सके कि मॉडल कैसे प्रतिक्रिया देता है। यह दृष्टिकोण उन अनुप्रयोगों के लिए उपयोगी है जहाँ विश्वसनीयता और सुरक्षा को उच्च प्राथमिकता दी जाती है, क्योंकि यह संभावित जोखिमों की पहचान और शमन में मदद करता है।
LLMs की क्षमताओं का प्रभावी रूप से आकलन करने के लिए एक रणनीतिक दृष्टिकोण अपनाया जाना चाहिए। सर्वोत्तम प्रथाएँ अपनाने से आपका मूल्यांकन प्रक्रिया विस्तृत, पारदर्शी, और आपकी विशिष्ट आवश्यकताओं के अनुसार अनुरूपित रहती है। यहाँ हम अनुसरण करने योग्य सर्वोत्तम प्रथाएँ कवर करते हैं।
|
सर्वोत्तम अभ्यास |
विवरण |
उदाहरण मामला |
प्रासंगिक मीट्रिक(स्) |
|
स्पष्ट उद्देश्यों को परिभाषित करें |
मूल्यांकन शुरू करने से पहले उन कार्यों और लक्ष्यों की पहचान करें जिन्हें LLM को हासिल करना चाहिए। |
किसी LLM के मशीन अनुवाद प्रदर्शन में सुधार करना |
BLEU/ROUGE स्कोर |
|
अपने दर्शकों पर विचार करें |
LLM के इच्छित उपयोगकर्ताओं के अनुरूप मूल्यांकन को ढालें, उनकी अपेक्षाओं और आवश्यकताओं को ध्यान में रखते हुए। |
टेक्स्ट जनरेट करने के लिए LLM |
Perplexity, Fluency, Coherence |
|
पारदर्शिता और पुनरुत्पादकता |
सुनिश्चित करें कि मूल्यांकन प्रक्रिया अच्छी तरह से प्रलेखित हो और सत्यापन व सुधार हेतु अन्य लोग उसे दोहरा सकें। |
LLM की क्षमताओं का आकलन करने के लिए उपयोग किए गए मूल्यांकन डेटासेट और कोड को सार्वजनिक रूप से जारी करना |
किसी भी प्रासंगिक मीट्रिक, जो मूल्यांकन के विशिष्ट कार्य और लक्ष्यों पर निर्भर हो |
इस मार्गदर्शिका ने LLMs के आकलन के लिए आवश्यक मीट्रिक्स और कार्य-पद्धतियों का व्यापक अवलोकन प्रदान किया है—perplexity और accuracy से लेकर पक्षपात और निष्पक्षता के उपायों तक।
मात्रात्मक और गुणात्मक दोनों मूल्यांकन तकनीकों का उपयोग करके और सर्वोत्तम प्रथाओं का पालन करते हुए, हम इन मॉडलों का विस्तृत और विश्वसनीय आकलन सुनिश्चित कर सकते हैं।
इस ज्ञान के साथ, हम अपनी आवश्यकताओं के अनुरूप LLMs का चयन और कार्यान्वयन बेहतर ढंग से कर सकते हैं, और अपने चुने हुए अनुप्रयोगों में उनके इष्टतम प्रदर्शन और विश्वसनीयता को सुनिश्चित कर सकते हैं।
शीर्ष AI पाठ्यक्रम
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें