
Metriche chiave per la valutazione degli LLM
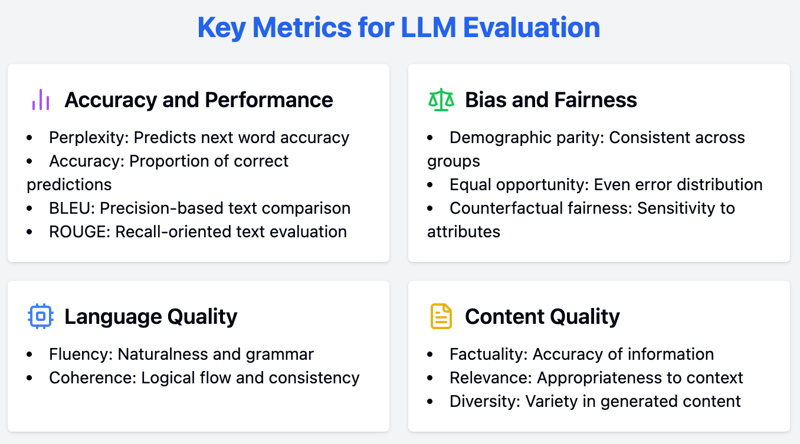
Valutare gli LLM richiede un approccio completo, che utilizzi una gamma di misure per analizzare vari aspetti delle loro prestazioni. In questa sezione esploriamo i criteri fondamentali di valutazione per gli LLM, tra cui accuratezza e performance, bias ed equità, oltre ad altre metriche importanti.
Metriche di accuratezza e performance
Misurare con precisione le performance è fondamentale per comprendere le capacità di un LLM. Questa sezione approfondisce le principali metriche utilizzate per valutare accuratezza e performance.
Perplessità
La perplessità è una metrica fondamentale per valutare e misurare la capacità di un LLM di prevedere la parola successiva in una sequenza. Ecco come si può calcolare:
- Probabilità: per prima cosa, il modello calcola la probabilità di ciascuna parola che potrebbe venire dopo in una frase.
- Probabilità inversa: si prende l'opposto di questa probabilità. Ad esempio, se una parola ha un'alta probabilità (cioè il modello la ritiene probabile), la sua probabilità inversa sarà più bassa.
- Normalizzazione: quindi si fa la media di questa probabilità inversa su tutte le parole nel set di test (il testo su cui stiamo testando il modello).
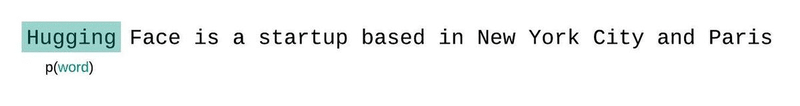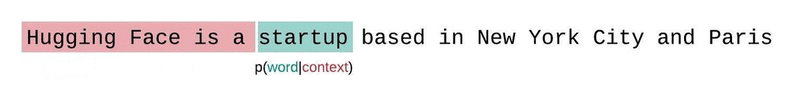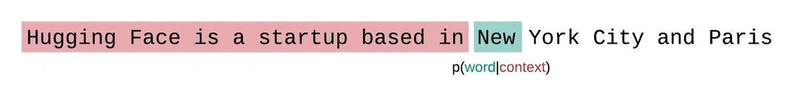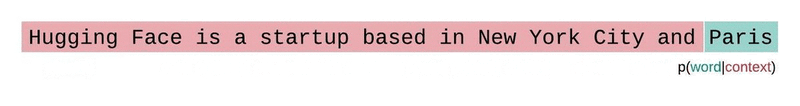
Illustrazione di un LLM che predice la probabilità della parola successiva dato il contesto. Fonte
Punteggi di perplessità più bassi indicano che il modello predice la parola successiva con maggiore precisione, riflettendo performance migliori. In sostanza, quantifica quanto bene una distribuzione di probabilità o un modello predittivo prevede un campione.
Per gli LLM, una perplessità più bassa significa che il modello è più sicuro nelle sue previsioni, portando a generazioni di testo più coerenti e adeguate al contesto.
Accuratezza
L'accuratezza è una metrica ampiamente utilizzata per i compiti di classificazione e indica la quota di previsioni corrette fatte dal modello. Sebbene sia una metrica intuitiva, nel contesto di compiti di generazione aperta può risultare spesso fuorviante.
Per esempio, quando si genera testo creativo o ricco di sfumature contestuali, la "correttezza" dell'output non è così semplice da definire come nei compiti di analisi del sentiment o classificazione di argomenti. Quindi, pur essendo utile per compiti specifici, l'accuratezza andrebbe affiancata ad altre metriche quando si valutano gli LLM.
Punteggi BLEU/ROUGE
I punteggi BLEU (Bilingual Evaluation Understudy) e ROUGE (Recall-Oriented Understudy for Gisting Evaluation) vengono usati per valutare la qualità del testo generato confrontandolo con testi di riferimento.
BLEU riguarda soprattutto la precisione: se una traduzione automatica usa le stesse parole di una traduzione umana, ottiene un punteggio BLEU alto. Per esempio, se il riferimento umano è "The cat is on the mat" e l'output della macchina è "The cat sits on the mat", il punteggio BLEU sarà alto perché molte parole coincidono.
ROUGE si concentra sul richiamo: verifica se il testo generato dalla macchina cattura tutte le idee importanti del riferimento umano. Mettiamo che un riassunto scritto da una persona sia "The study found that people who exercise regularly tend to have lower blood pressure." Se il riassunto generato dall'AI è "Exercise linked to lower blood pressure", ROUGE gli attribuirebbe un punteggio alto perché coglie il punto principale anche con parole diverse.
Queste metriche sono utili per compiti come la traduzione automatica, il riassunto e la generazione di testo, offrendo una valutazione quantitativa di quanto l'output del modello sia vicino ai testi di riferimento generati da esseri umani.
Metriche di bias ed equità
Garantire equità e ridurre i bias negli LLM è essenziale per applicazioni eque. Qui trattiamo le metriche chiave per valutare bias ed equità negli LLM.
Parità demografica
La parità demografica indica se le performance di un modello sono coerenti tra diversi gruppi demografici. Valuta la quota di esiti positivi tra gruppi definiti da attributi come razza, genere o età.
Raggiungere la parità demografica significa che le previsioni del modello non sono sbilanciate verso alcun gruppo, garantendo equità nelle sue applicazioni.
Pari opportunità
Le pari opportunità si concentrano sul fatto che gli errori del modello siano distribuiti in modo uniforme tra i diversi gruppi demografici. Valutano i tassi di falsi negativi per ciascun gruppo, verificando che il modello non fallisca in modo sproporzionato per alcune demografie.
Questa metrica è cruciale in applicazioni in cui equità e pari accesso sono fondamentali, come gli algoritmi di selezione del personale o i processi di approvazione dei prestiti.
Equità controfattuale
L'equità controfattuale valuta se le previsioni di un modello cambierebbero se alcuni attributi sensibili fossero diversi. Ciò comporta la generazione di esempi controfattuali in cui l'attributo sensibile (ad esempio, genere o razza) viene modificato mantenendo costanti le altre caratteristiche.
Se la previsione del modello cambia in base a questa modifica, indica un bias legato all'attributo sensibile. L'equità controfattuale è vitale per individuare e mitigare bias che potrebbero non emergere con altre metriche.
Altre metriche
Oltre a performance ed equità, ulteriori criteri sono utili per una valutazione completa degli LLM. Questa sezione mette in evidenza questi aspetti.
Fluenza
La fluenza valuta la naturalezza e la correttezza grammaticale del testo generato. Un LLM fluente produce output facili da leggere e comprendere, che imitano il flusso del linguaggio umano.
Può essere valutata tramite strumenti automatici o giudizi umani, concentrandosi su aspetti come grammatica, sintassi e leggibilità complessiva.
Coerenza
La coerenza analizza il flusso logico e la consistenza del testo generato. Un testo coerente mantiene una struttura chiara e una progressione logica delle idee, rendendo la lettura lineare. La coerenza è particolarmente importante per testi lunghi, come saggi o articoli, in cui mantenere una narrazione consistente è fondamentale.
Fattualità
La fattualità valuta l'accuratezza delle informazioni fornite dall'LLM, soprattutto nei compiti di ricerca informativa. Questa metrica conferma che il modello genera testo non solo plausibile ma anche fattualmente corretto.
La fattualità è indispensabile per applicazioni come la generazione di notizie, i contenuti educativi e l'assistenza clienti, dove fornire informazioni accurate è l'obiettivo principale.
Metodologie di valutazione
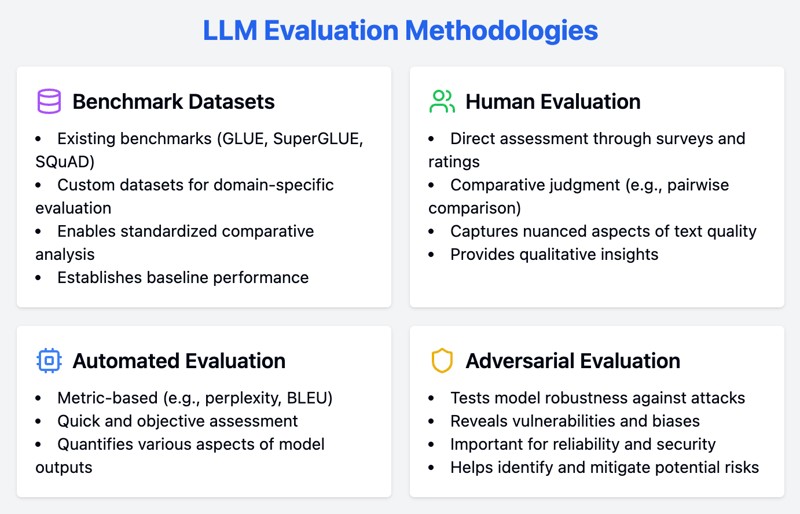
Una valutazione solida degli LLM integra approcci quantitativi e qualitativi. Questa sezione illustra una serie di metodologie, come dataset di benchmark, tecniche di valutazione umana e metodi di valutazione automatica, per analizzare a fondo le performance degli LLM.
Dataset di benchmark
I dataset di benchmark sono strumenti preziosi per valutare gli LLM, offrendo compiti standardizzati che consentono analisi comparative tra modelli diversi. Questi dataset aiutano a stabilire una baseline e a facilitare il benchmarking.
Benchmark esistenti
I dataset di benchmark sono strumenti importanti per valutare gli LLM, fornendo compiti standardizzati che permettono analisi comparative tra modelli. Alcuni dei dataset di benchmark più popolari per vari compiti di elaborazione del linguaggio naturale (NLP) includono:
- GLUE (General Language Understanding Evaluation): una raccolta di compiti eterogenei pensati per valutare le capacità linguistiche generali degli LLM, tra cui analisi del sentiment, implicazione testuale e question answering.
- SuperGLUE: una versione avanzata di GLUE, composta da compiti più sfidanti per testare la robustezza e la comprensione sfumata degli LLM.
- SQuAD (Stanford Question Answering Dataset): un dataset incentrato sulla comprensione del testo, in cui i modelli sono valutati in base alla loro capacità di rispondere a domande tratte da articoli di Wikipedia.
Dataset personalizzati
Sebbene i benchmark esistenti siano preziosi, creare dataset personalizzati è vitale per la valutazione specifica di dominio. I dataset personalizzati permettono di adattare il processo di valutazione ai requisiti e alle sfide uniche dell'applicazione o del settore.
Per esempio, un'organizzazione nel settore sanitario potrebbe creare un dataset di cartelle cliniche e note mediche per valutare la capacità di un LLM di gestire terminologia e contesto medici. I dataset personalizzati assicurano che le performance del modello siano allineate ai casi d'uso reali, offrendo insight più pertinenti e azionabili.
Valutazione umana
I metodi di valutazione umana sono indispensabili per analizzare gli aspetti più sfumati degli output degli LLM che le metriche automatiche potrebbero non cogliere. Queste tecniche prevedono feedback diretto da parte di valutatori umani, offrendo insight qualitativi sulle performance del modello.
Valutazione diretta
La valutazione umana resta il gold standard per misurare la qualità degli output degli LLM. I metodi di valutazione diretta prevedono la raccolta di feedback da giudici umani tramite sondaggi e scale di valutazione.
Questi metodi possono cogliere aspetti sfumati della qualità del testo, come fluenza, coerenza e pertinenza, che le metriche automatiche potrebbero trascurare. I valutatori umani possono fornire feedback qualitativo su punti di forza e debolezze specifici, aiutando a individuare aree di miglioramento.
Giudizio comparativo
Il giudizio comparativo include tecniche come il confronto a coppie, in cui i valutatori umani confrontano direttamente gli output di modelli diversi. Questo metodo può essere più affidabile delle scale di valutazione assolute, poiché riduce la soggettività legata ai punteggi individuali.
Ai valutatori viene chiesto di scegliere il miglior output tra coppie di testi generati, fornendo un ordinamento relativo delle performance. Il giudizio comparativo è particolarmente utile per affinare i modelli e selezionare le varianti con le performance migliori.
Valutazione automatica
I metodi di valutazione automatica offrono un modo rapido e oggettivo per analizzare le performance degli LLM. Questi metodi impiegano diverse metriche per quantificare vari aspetti degli output del modello, garantendo una valutazione completa.
Basata su metriche
Le metriche automatiche forniscono un modo rapido e oggettivo per valutare le performance degli LLM. Metriche come perplessità e BLEU sono ampiamente usate per analizzare diversi aspetti della generazione di testo.
Come discusso prima, la perplessità misura la capacità predittiva del modello: punteggi più bassi indicano performance migliori. BLEU, invece, valuta la qualità del testo generato confrontandolo con testi di riferimento, concentrandosi sulla precisione degli n-grammi.
Valutazione avversaria
La valutazione avversaria consiste nel sottoporre gli LLM ad attacchi avversari per testarne la robustezza. Questi attacchi sono progettati per sfruttare debolezze e bias del modello, rivelando vulnerabilità che potrebbero non emergere con metodi di valutazione standard.
Un attacco avversario può consistere nell'inserire dati leggermente alterati o fuorvianti per analizzare come risponde il modello. Questo approccio è utile nelle applicazioni in cui affidabilità e sicurezza sono prioritarie, poiché aiuta a individuare e mitigare rischi potenziali.
Buone pratiche per la valutazione degli LLM
Per valutare efficacemente le capacità degli LLM, è opportuno seguire un approccio strategico. Adottare buone pratiche garantisce che il processo di valutazione sia approfondito, trasparente e calibrato sulle tue esigenze. Qui presentiamo le buone pratiche da seguire.
|
Buona pratica |
Descrizione |
Caso d'esempio |
Metriche rilevanti |
|
Definisci obiettivi chiari |
Identifica i compiti e gli obiettivi che l'LLM dovrebbe raggiungere prima di avviare la valutazione. |
Migliorare le performance di traduzione automatica di un LLM |
Punteggi BLEU/ROUGE |
|
Considera il tuo pubblico |
Adatta la valutazione agli utenti finali dell'LLM, considerando aspettative ed esigenze. |
LLM per la generazione di testo |
Perplessità, fluenza, coerenza |
|
Trasparenza e riproducibilità |
Assicurati che il processo di valutazione sia ben documentato e riproducibile da altri per verifica e miglioramento. |
Rilascio pubblico del dataset di valutazione e del codice utilizzato per analizzare le capacità dell'LLM |
Qualsiasi metrica rilevante, a seconda del compito e degli obiettivi specifici della valutazione |
Conclusione
Questa guida ha fornito una panoramica completa delle metriche e delle metodologie essenziali per valutare gli LLM, dalla perplessità e accuratezza fino alle misure di bias ed equità.
Adottando tecniche di valutazione quantitative e qualitative e seguendo le buone pratiche, possiamo garantire un'analisi accurata e affidabile di questi modelli.
Con queste conoscenze, siamo più attrezzati per selezionare e implementare gli LLM che meglio rispondono alle nostre esigenze, assicurandone performance e affidabilità ottimali nelle applicazioni scelte.

Neolaureato magistrale specializzato in Intelligenza Artificiale





I large language model (LLM) stanno diventando rapidamente parte integrante di numerose applicazioni, dai chatbot alla creazione di contenuti.
Tuttavia, valutare questi potenti modelli è una sfida. Come possiamo misurarne con precisione prestazioni e affidabilità, dato il ventaglio di capacità e implementazioni?
Questa guida offre una panoramica completa della valutazione degli LLM, coprendo metriche essenziali, metodologie e buone pratiche per aiutarti a prendere decisioni informate su quali modelli si adattino meglio alle tue esigenze.