
Métriques clés pour évaluer les LLM
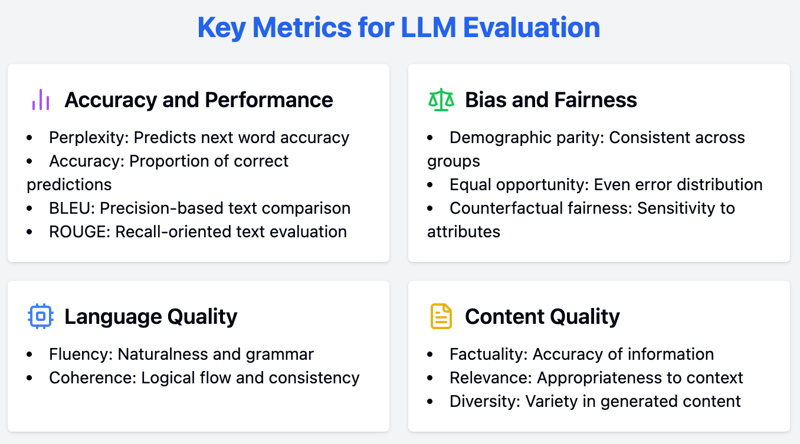
Évaluer des LLM nécessite une approche globale, en mobilisant plusieurs mesures pour apprécier différents aspects de leurs performances. Nous passons ici en revue les critères majeurs d’évaluation des LLM, dont la précision et la performance, les biais et l’équité, ainsi que d’autres métriques importantes.
Métriques de précision et de performance
Mesurer correctement la performance est une étape clé pour comprendre les capacités d’un LLM. Cette section détaille les principales métriques utilisées pour évaluer la précision et la performance.
Perplexité
La perplexité est une métrique fondamentale pour évaluer et mesurer la capacité d’un LLM à prédire le mot suivant dans une séquence. Voici comment on peut la calculer :
- Probabilité : d’abord, le modèle calcule la probabilité de chaque mot susceptible d’apparaître ensuite dans la phrase.
- Probabilité inverse : on prend l’inverse de cette probabilité. Par exemple, si un mot a une forte probabilité (le modèle le juge probable), sa probabilité inverse sera plus faible.
- Normalisation : on calcule ensuite la moyenne de cette probabilité inverse sur l’ensemble des mots du jeu de test (le texte sur lequel on évalue le modèle).
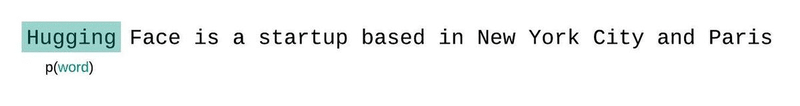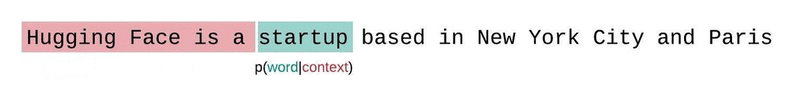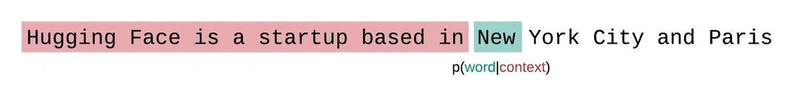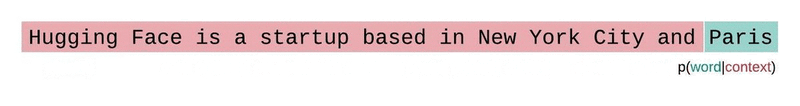
Illustration d’un LLM prédisant la probabilité du mot suivant selon le contexte. Source
Des scores de perplexité plus faibles indiquent que le modèle prédit plus justement le mot suivant, ce qui reflète de meilleures performances. En somme, la perplexité quantifie la capacité d’un modèle probabiliste à prédire un échantillon.
Pour les LLM, une perplexité basse signifie que le modèle est plus confiant dans ses prédictions, et génère donc des textes plus cohérents et mieux adaptés au contexte.
Précision
La précision est une métrique couramment utilisée pour les tâches de classification, représentant la part de prédictions correctes réalisées par le modèle. Bien qu’intuitive, elle peut être trompeuse pour des tâches de génération ouverte.
Par exemple, lorsqu’il s’agit de générer un texte créatif ou nuancé, la notion de « justesse » est moins tranchée que pour des tâches comme l’analyse de sentiment ou la classification thématique. Utile pour des cas précis, la précision doit donc être complétée par d’autres métriques pour évaluer des LLM.
Scores BLEU/ROUGE
BLEU (Bilingual Evaluation Understudy) et ROUGE (Recall-Oriented Understudy for Gisting Evaluation) permettent d’évaluer la qualité d’un texte généré en le comparant à des textes de référence.
BLEU met l’accent sur la précision : si une traduction automatique reprend les mêmes mots qu’une traduction humaine, le score BLEU est élevé. Par exemple, si la référence humaine est « The cat is on the mat » et la sortie machine « The cat sits on the mat », le score BLEU sera élevé en raison du chevauchement important de mots.
ROUGE privilégie le rappel : il vérifie si le texte généré couvre bien les idées essentielles du texte de référence. Si un résumé humain indique « The study found that people who exercise regularly tend to have lower blood pressure. » et que le résumé IA est « Exercise linked to lower blood pressure », ROUGE attribuera un score élevé car l’idée principale est bien capturée, même avec une formulation différente.
Ces métriques sont utiles pour des tâches comme la traduction automatique, le sommaire automatique et la génération de texte, en fournissant une mesure quantitative de l’alignement avec des références humaines.
Métriques de biais et d’équité
Garantir l’équité et réduire les biais dans les LLM est essentiel pour des usages équitables. Voici les principales métriques pour évaluer biais et équité.
Parité démographique
La parité démographique examine si les performances du modèle sont cohérentes entre différents groupes démographiques. Elle évalue la proportion de résultats positifs selon des attributs comme l’origine, le genre ou l’âge.
Atteindre la parité démographique signifie que les prédictions du modèle ne favorisent ni ne défavorisent aucun groupe, garantissant équité et justice dans ses applications.
Égalité des chances
L’égalité des chances s’intéresse à la répartition des erreurs du modèle entre groupes démographiques. Elle évalue notamment les taux de faux négatifs pour vérifier que le modèle n’échoue pas de manière disproportionnée pour certains groupes.
Cette métrique est cruciale pour des applications où l’équité et l’accès égal sont fondamentaux, comme les algorithmes de recrutement ou l’octroi de prêts.
Équité contrefactuelle
L’équité contrefactuelle évalue si les prédictions du modèle changeraient si certains attributs sensibles étaient différents. Elle consiste à générer des exemples contrefactuels où l’attribut sensible (p. ex. : genre ou origine) est modifié, les autres caractéristiques restant constantes.
Si la prédiction varie suite à cette modification, cela révèle un biais lié à l’attribut sensible. L’équité contrefactuelle est essentielle pour détecter et atténuer des biais qui ne ressortent pas toujours avec d’autres métriques.
Autres métriques
Au-delà de la performance et de l’équité, d’autres critères contribuent à une évaluation globale des LLM. Cette section met en lumière ces aspects.
Fluidité
La fluidité mesure la naturalité et la correction grammaticale du texte généré. Un LLM fluide produit des sorties faciles à lire et à comprendre, qui reproduisent le rythme du langage humain.
Elle peut être évaluée via des outils automatiques ou par jugement humain, en se concentrant sur la grammaire, la syntaxe et la lisibilité globale.
Cohérence
La cohérence analyse la logique d’enchaînement et la constance du texte généré. Un texte cohérent conserve une structure claire et une progression logique des idées, facilitant la lecture. Elle est particulièrement importante pour les textes longs, comme des essais ou des articles, où la continuité du fil narratif est clé.
Factualité
La factualité évalue l’exactitude des informations fournies par le LLM, en particulier pour des tâches de recherche d’information. Elle vérifie que le texte généré est non seulement plausible, mais aussi factuellement correct.
Indispensable pour des usages comme la génération d’actualités, de contenus pédagogiques ou le support client, où l’exactitude prime.
Méthodologies d’évaluation
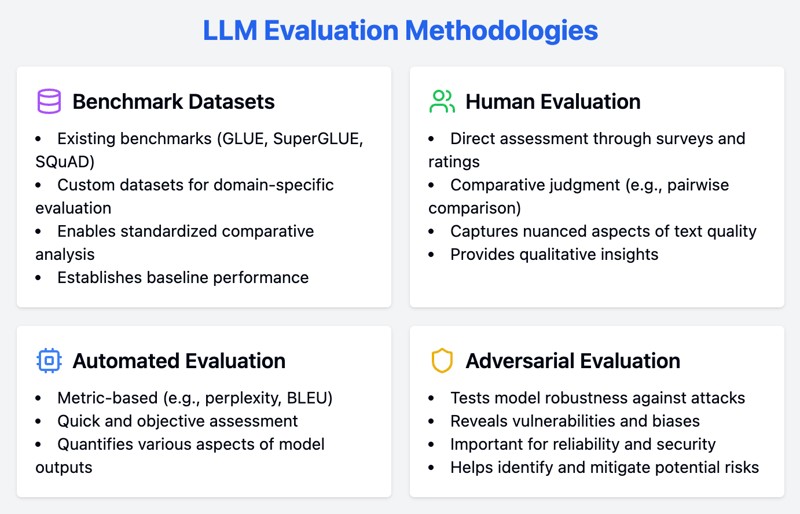
Une évaluation solide des LLM combine approches quantitatives et qualitatives. Cette section détaille plusieurs méthodes, comme les jeux de données de référence, l’évaluation humaine et les évaluations automatisées, pour apprécier rigoureusement les performances.
Jeux de données de référence
Les jeux de données de référence offrent des tâches standardisées permettant de comparer différents modèles. Ils établissent une base commune et facilitent le benchmarking.
Benchmarks existants
Parmi les jeux de données de référence les plus populaires pour diverses tâches de traitement du langage naturel (NLP) :
- GLUE (General Language Understanding Evaluation) : un ensemble de tâches diverses pour évaluer les capacités linguistiques générales des LLM, dont l’analyse de sentiment, l’entaillement textuel et le question-réponse.
- SuperGLUE : une version plus avancée de GLUE, avec des tâches plus difficiles pour tester la robustesse et la compréhension fine des LLM.
- SQuAD (Stanford Question Answering Dataset) : un jeu de données de compréhension de lecture où les modèles sont notés sur leur capacité à répondre à des questions issues d’articles Wikipédia.
Jeux de données sur mesure
S’ils sont précieux, les benchmarks existants doivent souvent être complétés par des jeux de données sur mesure pour une évaluation sectorielle. Ils permettent d’adapter l’évaluation aux exigences et contraintes propres à une application ou à un secteur.
Par exemple, une organisation de santé peut constituer un corpus de dossiers médicaux et de notes cliniques pour évaluer la maîtrise de la terminologie et du contexte médicaux par un LLM. Ces jeux de données garantissent une évaluation en phase avec les cas d’usage réels et des enseignements plus actionnables.
Évaluation humaine
Les méthodes d’évaluation humaine sont indispensables pour apprécier les nuances que les métriques automatiques peuvent manquer. Elles reposent sur des retours directs d’évaluateurs, offrant des insights qualitatifs sur la performance.
Évaluation directe
L’évaluation humaine demeure la référence pour juger la qualité des sorties d’un LLM. Les approches directes collectent des avis via enquêtes et échelles de notation.
Elles capturent des dimensions fines comme la fluidité, la cohérence et la pertinence, souvent négligées par les métriques automatiques. Les évaluateurs peuvent aussi pointer forces et faiblesses concrètes, pour cibler les axes d’amélioration.
Jugement comparatif
Le jugement comparatif, comme la comparaison par paires, consiste à opposer directement les sorties de différents modèles. Cette méthode est parfois plus fiable que des notes absolues, en réduisant la subjectivité individuelle.
Les évaluateurs choisissent le meilleur texte parmi des paires, ce qui fournit un classement relatif des modèles. Particulièrement utile pour le fine-tuning et la sélection de variantes plus performantes.
Évaluation automatisée
Les méthodes automatisées offrent un moyen rapide et objectif d’évaluer les performances des LLM. Elles mobilisent diverses métriques pour quantifier de multiples dimensions des sorties, assurant une évaluation complète.
Basée sur des métriques
Les métriques automatiques fournissent une évaluation rapide et objective. Des indicateurs comme la perplexité et BLEU sont largement utilisés pour apprécier différentes facettes de la génération de texte.
Comme vu précédemment, la perplexité mesure la capacité de prédiction du modèle, des scores plus faibles indiquant de meilleures performances. BLEU, lui, évalue la qualité du texte généré en le comparant à des références, en se concentrant sur la précision des n-grammes.
Évaluation adversariale
L’évaluation adversariale consiste à soumettre les LLM à des attaques adversariales pour tester leur robustesse. Ces attaques exploitent failles et biais du modèle, révélant des vulnérabilités qui échappent aux évaluations classiques.
Une attaque peut, par exemple, introduire des entrées légèrement modifiées ou trompeuses pour analyser la réaction du modèle. Cette approche est utile lorsque fiabilité et sécurité sont primordiales, car elle aide à identifier et à atténuer les risques potentiels.
Bonnes pratiques pour évaluer des LLM
Pour évaluer efficacement les capacités des LLM, il convient d’adopter une démarche structurée. Les bonnes pratiques garantissent une évaluation approfondie, transparente et adaptée à vos besoins. Voici celles à privilégier.
|
Bonne pratique |
Description |
Cas d’usage |
Métrique(s) pertinente(s) |
|
Définir des objectifs clairs |
Identifier les tâches et les résultats attendus du LLM avant de démarrer l’évaluation. |
Améliorer la performance de traduction automatique d’un LLM |
Scores BLEU/ROUGE |
|
Prendre en compte votre public |
Adapter l’évaluation aux utilisateurs visés du LLM, selon leurs attentes et leurs besoins. |
LLM de génération de texte |
Perplexité, fluidité, cohérence |
|
Transparence et reproductibilité |
Documenter le processus d’évaluation pour qu’il puisse être reproduit et audité par des tiers. |
Publication du jeu de données d’évaluation et du code utilisés pour mesurer les capacités du LLM |
Toute métrique pertinente, en fonction de la tâche et des objectifs |
Conclusion
Ce guide a présenté un panorama complet des métriques et méthodologies essentielles pour évaluer des LLM, de la perplexité et la précision aux mesures de biais et d’équité.
En combinant approches quantitatives et qualitatives, et en suivant les bonnes pratiques, vous garantissez une évaluation fiable et exhaustive de ces modèles.
Avec ces repères, vous serez mieux armé pour sélectionner et déployer les LLM les plus adaptés, afin d’assurer performance et fiabilité dans vos applications.

Récemment diplômé d'une maîtrise en sciences, spécialisé dans l'intelligence artificielle





Les grands modèles de langage (LLM) s’imposent rapidement dans de nombreuses applications, des chatbots à la création de contenus.
Cependant, l’évaluation de ces modèles puissants reste complexe. Comment mesurer précisément leurs performances et leur fiabilité, compte tenu de la diversité de leurs capacités et de leurs mises en œuvre ?
Ce guide propose une vue d’ensemble complète de l’évaluation des LLM, en couvrant les métriques essentielles, les méthodologies et les bonnes pratiques pour vous aider à choisir les modèles les plus adaptés à vos besoins.