
LLM Değerlendirmesi için Temel Metrikler
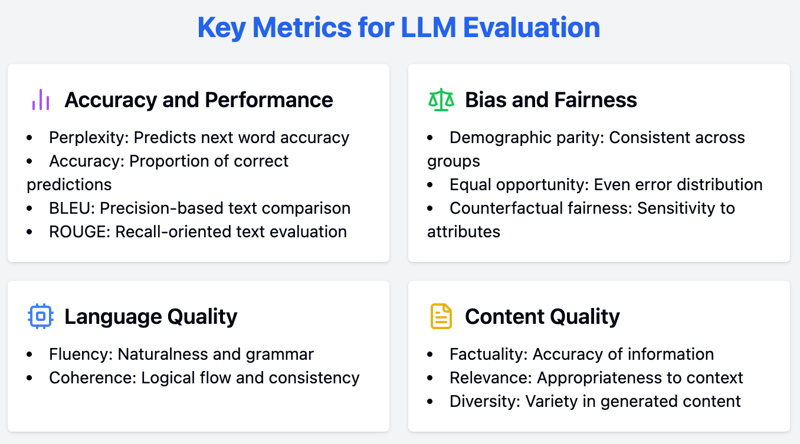
LLM'leri değerlendirmek, performanslarının çeşitli yönlerini ölçmek için bir dizi ölçüt kullanmayı gerektiren kapsamlı bir yaklaşım ister. Bu bölümde, doğruluk ve performansın yanı sıra önyargı ve adalet ile diğer önemli metrikler dâhil olmak üzere LLM'ler için temel değerlendirme ölçütlerini inceliyoruz.
Doğruluk ve performans metrikleri
Performansı doğru ölçmek, bir LLM'in yeteneklerini anlamak için önemli bir adımdır. Bu bölüm, doğruluk ve performansı değerlendirmede kullanılan başlıca metriklere odaklanır.
Perplexity
Perplexity, bir LLM'in bir dizideki bir sonraki kelimeyi tahmin etme becerisini değerlendirmek ve ölçmek için temel bir metriktir. Şu şekilde hesaplanabilir:
- Olasılık: Önce, model bir cümlede sıradaki her kelimenin olasılığını hesaplar.
- Ters olasılık: Bu olasılığın tersini alırız. Örneğin, bir kelimenin olasılığı yüksekse (model onun olası olduğunu düşünüyorsa), ters olasılığı daha düşük olur.
- Normalizasyon: Daha sonra bu ters olasılığı, test kümesindeki (modeli test ettiğimiz metin) tüm kelimeler boyunca ortalarız.
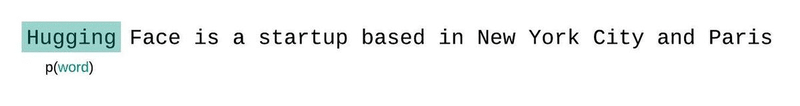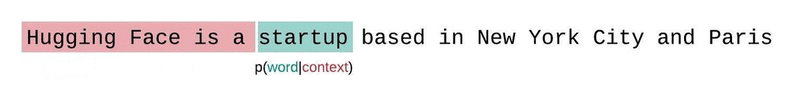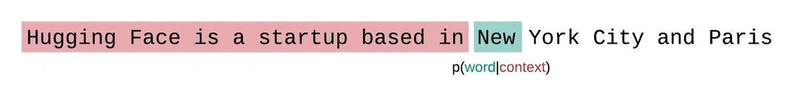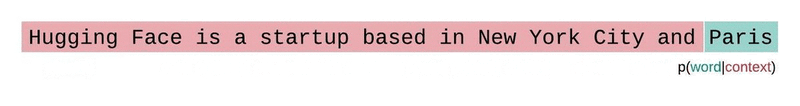
Bağlama göre bir sonraki kelimenin olasılığını tahmin eden bir LLM'in görselleştirmesi. Kaynak
Daha düşük perplexity skorları, modelin bir sonraki kelimeyi daha doğru tahmin ettiğini ve daha iyi performans gösterdiğini belirtir. Özünde, bir olasılık dağılımının veya tahmin modelinin bir örneği ne kadar iyi öngördüğünü niceler.
LLM'ler için daha düşük perplexity, modelin kelime tahminlerinde daha kendinden emin olduğu ve daha tutarlı, bağlama uygun metin ürettiği anlamına gelir.
Doğruluk
Doğruluk, modelin yaptığı doğru tahminlerin oranını temsil eden, sınıflandırma görevlerinde yaygın olarak kullanılan bir metriktir. Genellikle sezgisel olsa da, açık uçlu üretim görevleri bağlamında çoğu zaman yanıltıcı olabilir.
Örneğin, yaratıcı veya bağlamsal açıdan nüanslı metin üretirken çıktının "doğruluğunu" tanımlamak, duygu analizi veya konu sınıflandırması gibi görevlerde olduğu kadar net değildir. Bu nedenle, doğruluk belirli görevler için faydalı olsa da LLM'leri değerlendirirken diğer metriklerle tamamlanmalıdır.
BLEU/ROUGE skorları
BLEU (Bilingual Evaluation Understudy) ve ROUGE (Recall-Oriented Understudy for Gisting Evaluation) skorları, üretilen metnin kalitesini referans metinlerle karşılaştırarak değerlendirmede kullanılır.
BLEU, hassasiyetle ilgilidir: Bir makine çevirisi, insan çevirisiyle aynı kelimeleri kullanırsa yüksek BLEU skoru alır. Örneğin, insan referansı "The cat is on the mat" ve makine çıktısı "The cat sits on the mat" ise, birçok kelime örtüştüğü için BLEU skoru yüksek olur.
ROUGE ise duyarlılığa odaklanır: Makinenin oluşturduğu metnin, insan referansındaki tüm önemli fikirleri yakalayıp yakalamadığını kontrol eder. Diyelim ki insan yazımı bir özet "The study found that people who exercise regularly tend to have lower blood pressure." olsun. Yapay zekâ tarafından oluşturulan özet "Exercise linked to lower blood pressure." ise, ifade farklı olsa da ana noktayı yakaladığı için ROUGE yüksek bir skor verir.
Bu metrikler, makine çevirisi, özetleme ve metin üretimi gibi görevler için faydalıdır; model çıktısının insan yapımı referans metinlerle ne kadar yakından örtüştüğünü nicel olarak değerlendirir.
Önyargı ve adalet metrikleri
LLM'lerde adaletin sağlanması ve önyargının azaltılması, eşitlikçi uygulamalar için esastır. Burada LLM'lerde önyargı ve adaleti değerlendirmeye yönelik temel metrikleri ele alıyoruz.
Demografik denklik
Demografik denklik, bir modelin performansının farklı demografik gruplar arasında tutarlı olup olmadığını gösterir. Irk, cinsiyet veya yaş gibi özelliklerle tanımlanan gruplar arasında olumlu sonuçların oranını değerlendirir.
Demografik denklik sağlamak, modelin tahminlerinin belirli bir gruba karşı önyargılı olmadığını ve uygulamalarında adalet ile eşitliği güvence altına aldığını ifade eder.
Eşit fırsat
Eşit fırsat, model hatalarının farklı demografik gruplar arasında eşit dağılıp dağılmadığına odaklanır. Her grup için yalancı negatif oranlarını değerlendirerek modelin belirli demografilerde orantısız biçimde başarısız olmadığını doğrular.
Bu metrik, işe alım algoritmaları veya kredi onay süreçleri gibi adalet ve eşit erişimin gerekli olduğu uygulamalar için kritik öneme sahiptir.
Zıt-olgusal adalet
Zıt-olgusal adalet, belirli hassas özellikler farklı olsaydı modelin tahminlerinin değişip değişmeyeceğini değerlendirir. Bu, hassas bir özelliğin (ör. cinsiyet veya ırk) sabit kalan diğer özellikler yanında değiştirilerek zıt-olgusal örnekler üretilmesini içerir.
Modelin tahmini bu değişikliğe bağlı olarak değişiyorsa, hassas özellikle ilişkili bir önyargı olduğunu gösterir. Zıt-olgusal adalet, diğer metriklerle görünür olmayabilecek önyargıları belirlemek ve azaltmak için hayati önem taşır.
Diğer metrikler
Performans ve adaletin ötesinde, LLM'lerin kapsamlı değerlendirmesi için ek ölçütler de yararlıdır. Bu bölüm bu yönleri vurgular.
Akıcılık
Akıcılık, üretilen metnin doğallığını ve dilbilgisel doğruluğunu değerlendirir. Akıcı bir LLM, insan dilinin akışını taklit ederek okunması ve anlaşılması kolay çıktılar üretir.
Bu, dilbilgisi, sözdizimi ve genel okunabilirlik gibi unsurlara odaklanan otomatik araçlarla veya insan yargısıyla değerlendirilebilir.
Tutarlılık
Tutarlılık, üretilen metnin mantıksal akışını ve bütünlüğünü analiz etmeye yardımcı olur. Tutarlı bir metin, okuyucuların kolayca takip etmesini sağlayan net bir yapı ve mantıklı bir fikir ilerleyişi sunar. Tutarlılık özellikle, tutarlı bir anlatının korunmasının kritik olduğu denemeler veya makaleler gibi daha uzun metinler için önemlidir.
Olgu doğruluğu
Olgu doğruluğu, özellikle bilgi arama görevlerinde LLM'in sağladığı bilgilerin doğruluğunu değerlendirir. Bu metrik, modelin yalnızca makul görünen değil, aynı zamanda olgusal olarak doğru metin üretmesini teyit eder.
Olgu doğruluğu; doğru bilgi sağlamanın ana hedef olduğu haber üretimi, eğitim içerikleri ve müşteri desteği gibi uygulamalar için vazgeçilmezdir.
Değerlendirme Yöntemleri
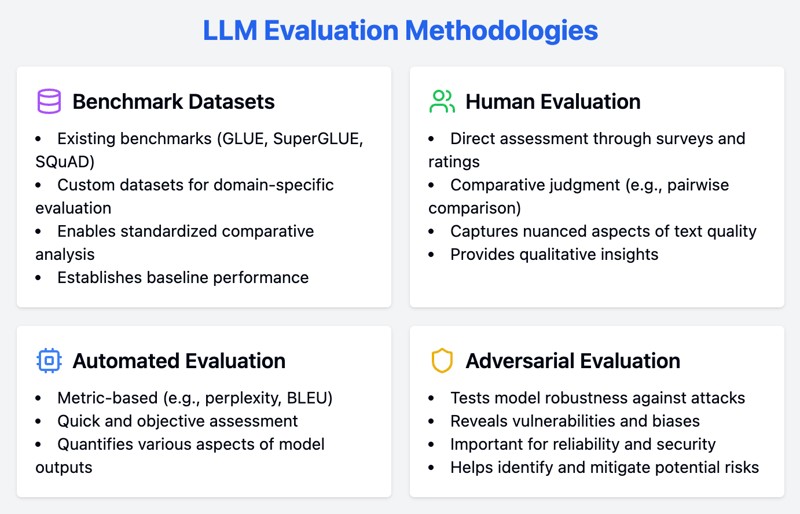
LLM'lerin sağlam bir değerlendirmesi, nicel ve nitel yaklaşımların birlikte kullanılmasını gerektirir. Bu bölüm, LLM performansını kapsamlı biçimde değerlendirmek için kıyaslama veri kümeleri, insan değerlendirme teknikleri ve otomatik değerlendirme yöntemleri gibi çeşitli metodolojileri ayrıntılandırır.
Kıyas veri kümeleri
Kıyas veri kümeleri, LLM'leri değerlendirmek için değerli araçlardır; farklı modeller arasında karşılaştırmalı analiz yapılmasını sağlayan standartlaştırılmış görevler sunar. Bu veri kümeleri, model performansı için bir temel oluşturur ve kıyaslama yapmayı kolaylaştırır.
Mevcut kıyaslar
Kıyas veri kümeleri, LLM'leri değerlendirmek için önemli araçlardır; farklı modeller arasında karşılaştırmalı analiz yapılmasını sağlayan standart görevler sunar. Çeşitli doğal dil işleme (NLP) görevleri için en popüler kıyas veri kümelerinden bazıları şunlardır:
- GLUE (General Language Understanding Evaluation): Duygu analizi, metinsel çıkarım ve soru cevaplama dâhil olmak üzere LLM'lerin genel dilsel yeteneklerini değerlendirmek için tasarlanmış çeşitli görevlerden oluşur.
- SuperGLUE: GLUE'nin gelişmiş bir sürümü olup, LLM'lerin sağlamlığını ve incelikli anlayışını sınamak için daha zorlu görevler içerir.
- SQuAD (Stanford Question Answering Dataset): Wikipedia makalelerinden türetilen soruları yanıtlama yeteneğine göre modellerin puanlandığı, okuduğunu anlama odaklı bir veri kümesi.
Özel veri kümeleri
Mevcut kıyaslar çok değerli olsa da alanına özgü değerlendirme için özel veri kümeleri oluşturmak hayati önem taşır. Özel veri kümeleri, değerlendirme sürecini belirli uygulamanın veya sektörün kendine has gereksinim ve zorluklarına göre uyarlamamıza olanak tanır.
Örneğin bir sağlık kuruluşu, bir LLM'in tıbbi terminoloji ve bağlamı ele alma becerisini değerlendirmek için tıbbi kayıtlar ve klinik notlardan oluşan bir veri kümesi oluşturabilir. Özel veri kümeleri, model performansının gerçek dünya kullanım senaryolarıyla uyumlu olmasını sağlayarak daha ilgili ve eyleme dönük içgörüler sunar.
İnsan değerlendirmesi
İnsan değerlendirme yöntemleri, otomatik metriklerin gözden kaçırabileceği LLM çıktılarının nüanslı yönlerini ölçmek için vazgeçilmezdir. Bu teknikler, model performansına ilişkin nitel içgörüler sunan insan değerlendiricilerden doğrudan geri bildirim almayı içerir.
Doğrudan değerlendirme
İnsan değerlendirmesi, LLM çıktılarının kalitesini ölçmede altın standart olmaya devam etmektedir. Doğrudan değerlendirme yöntemleri, anketler ve derecelendirme ölçekleri kullanarak insan değerlendiricilerden geri bildirim toplamayı içerir.
Bu yöntemler; akıcılık, tutarlılık ve uygunluk gibi metin kalitesinin, otomatik metriklerin gözden kaçırabileceği nüanslı yönlerini yakalayabilir. İnsan değerlendiriciler, belirli güçlü ve zayıf yönler hakkında nitel geri bildirim sağlayarak iyileştirme için somut alanların belirlenmesine yardımcı olabilir.
Karşılaştırmalı yargı
Karşılaştırmalı yargı, insan değerlendiricilerin farklı modellerin çıktısını doğrudan karşılaştırdığı ikili karşılaştırma gibi teknikleri içerir. Bu yöntem, bireysel puanlarla ilişkili öznelliği azalttığı için mutlak derecelendirme ölçeklerinden daha güvenilir olabilir.
Değerlendiricilerden, oluşturulan metin çiftleri arasından daha iyi çıktıyı seçmeleri istenir ve bu da model performansının göreli bir sıralamasını sağlar. Karşılaştırmalı yargı, modelleri ince ayarlamak ve en iyi performans gösteren varyantları seçmek için özellikle kullanışlıdır.
Otomatik değerlendirme
Otomatik değerlendirme yöntemleri, LLM performansını hızlı ve nesnel bir şekilde ölçer. Bu yöntemler, model çıktılarının farklı yönlerini nicelendirmek için çeşitli metrikler kullanarak kapsamlı bir değerlendirme sağlar.
Metrik Tabanlı
Otomatik metrikler, LLM performansını değerlendirmek için hızlı ve nesnel bir yol sunar. Perplexity ve BLEU gibi metrikler, metin üretiminin çeşitli yönlerini değerlendirmede yaygın olarak kullanılır.
Daha önce tartıştığımız gibi perplexity, modelin öngörü yeteneğini ölçer ve daha düşük skorlar daha iyi performansa işaret eder. Öte yandan BLEU, üretilen metnin kalitesini referans metinlerle karşılaştırarak n-gramlerin hassasiyetine odaklanır.
Hasmane değerlendirme
Hasmane değerlendirme, LLM'lerin hasmane saldırılara maruz bırakılmasını ve sağlamlıklarının test edilmesini içerir. Bu saldırılar, modeldeki zayıflıkları ve önyargıları sömürmek üzere tasarlanır; standart değerlendirme yöntemleriyle görünmeyebilecek açıklıkları ortaya çıkarır.
Hasmane bir saldırı, modelin nasıl tepki verdiğini analiz etmek için hafifçe değiştirilmiş veya yanıltıcı verilerin girilmesini içerebilir. Bu yaklaşım, güvenilirlik ve güvenliğin yüksek değerde olduğu uygulamalar için yararlıdır; potansiyel riskleri belirlemeye ve azaltmaya yardımcı olur.
LLM Değerlendirmesi için En İyi Uygulamalar
LLM'lerin yeteneklerini etkin bir şekilde değerlendirmek için stratejik bir yaklaşım izlenmelidir. En iyi uygulamaları benimsemek, değerlendirme sürecinizin kapsamlı, şeffaf ve özgün gereksinimlerinize göre uyarlanmış olmasını sağlar. Burada izlenmesi gereken en iyi uygulamaları ele alıyoruz.
|
En İyi Uygulama |
Açıklama |
Örnek Vaka |
İlgili Metrik(ler) |
|
Açık Hedefler Belirleyin |
Değerlendirme sürecine başlamadan önce LLM'in gerçekleştirmesi gereken görevleri ve hedefleri belirleyin. |
Bir LLM'in makine çevirisi performansını iyileştirmek |
BLEU/ROUGE skorları |
|
Kitlenizi Dikkate Alın |
Değerlendirmeyi, LLM'in hedef kullanıcılarına onların beklenti ve ihtiyaçlarını göz önünde bulundurarak uyarlayın. |
Metin üreten LLM |
Perplexity, Akıcılık, Tutarlılık |
|
Şeffaflık ve Tekrarlanabilirlik |
Değerlendirme sürecinin iyi belgelenmiş ve başkaları tarafından doğrulama ve iyileştirme amacıyla yinelenebilir olmasını sağlayın. |
LLM'in yeteneklerini değerlendirmede kullanılan veri kümesi ve kodun herkese açık olarak yayımlanması |
Değerlendirmenin özel görev ve hedeflerine bağlı olarak herhangi bir ilgili metrik |
Sonuç
Bu rehber, LLM'leri değerlendirmeye yönelik perplexity ve doğruluktan önyargı ve adalet ölçümlerine kadar temel metrikler ve yöntemlerin kapsamlı bir özetini sundu.
Nicel ve nitel değerlendirme tekniklerini kullanıp en iyi uygulamalara bağlı kalarak bu modellerin kapsamlı ve güvenilir bir değerlendirmesini sağlayabiliriz.
Bu bilgilerle, ihtiyaçlarımızı en iyi karşılayan LLM'leri seçmeye ve uygulamaya daha iyi hazırlanır, seçtiğimiz uygulamalar içinde en iyi performans ve güvenilirliği sağlamalarını temin ederiz.

Yapay Zekâ alanında uzmanlaşmış yeni mezun bir Yüksek Lisans sahibiyim



Büyük dil modelleri (LLM'ler) sohbet robotlarından chatbotlara içerik oluşturmaya kadar pek çok uygulamanın ayrılmaz bir parçası haline hızla geliyor.
Bununla birlikte, bu güçlü modelleri değerlendirmek bir zorluk teşkil eder. Farklı yetenekleri ve uygulamaları göz önüne alındığında, performanslarını ve güvenilirliklerini nasıl doğru şekilde ölçebiliriz?
Bu rehber, LLM değerlendirmesine kapsamlı bir bakış sunarak ihtiyaçlarınıza en uygun modeller hakkında bilinçli kararlar almanıza yardımcı olacak temel metrikleri, yöntemleri ve en iyi uygulamaları ele alır.