更新:SpaceXAI 此后已发布更新型号。其基准、定价及与 Grok 4.5 的对比,见我们的Grok 4.6 报道。
大多数人仍称其为 xAI 的 SpaceXAI 于 2026 年 7 月 8 日发布了Grok 4.5。该模型面向编码、智能体任务与知识型工作。
SpaceXAI 对 Grok 4.5 的论证并非“横扫”各项基准。 Cursor 表示两家公司用来自开发者与智能体交互的数万亿 token 进行联合训练,而 SpaceXAI 更强调模型完成任务所需的 token 数。其公布的图表结果喜忧参半。
本文对比 SpaceXAI 的说法与独立结果,通过 API 和 Cursor 测试该模型,并考察其定价、接入路径与限制。在撰写本文时,我尤其关注每个完成任务的成本,因为一旦推理、重试与工具调用加入账单,仅凭每 token 费率只能说明部分情况。
Grok 4.5 是什么?
Grok 4.5 是 SpaceXAI 的专有专家混合(MoE)推理模型。官方列举的用途包括编码、智能体任务和通用办公工作。
“Grok”这个名称可指三种不同事物。它们有关联,但不可互换。
-
grok-4.5:底层模型,通过 API 访问 -
Grok:面向消费者的聊天助手(grok.com 与 X 上)
-
Grok Build:SpaceXAI 的编码智能体与命令行环境,Grok 4.5 现为其默认模型
在本文中,除非明确提及具体产品,否则“Grok 4.5”均指模型本身。
更多关于 Grok 4.5:
- Grok 4.5 具有50 万 token 的上下文窗口。
- 可将推理强度设为低、中或高,默认高。
- 知识截止于 2026 年 2 月 1 日。
- 可接收文本与图像输入,并返回文本。无法返回生成图像;SpaceXAI 另有图像模型。
Grok 4.5 有哪些新变化?
SpaceXAI 将其发布要点分为:带智能体的编码、token 使用、办公工作与工具支持。“智能体任务”一词可能含糊,因此更重要的是具体动作而非标签。
编码与智能体任务
在智能体编码任务中,模型可能检查代码库、规划更改、编辑文件、运行命令、测试结果,并在出错后重试。这不同于仅回答一个编码问题。
SpaceXAI 用四个工程基准来支撑该说法。
速度与 token 使用
SpaceXAI 报告约每秒 80 个 token,且在相同任务上使用的 token 少于部分其他模型。其 SWE-Bench Pro 图表显示,每个已解决任务的输出 token 为 15,954,而 Claude Opus 4.8 的“最大模式”为 67,020。
知识型与办公工作
SpaceXAI 称 Grok 4.5 能处理研究、决策文档、电子表格与演示文稿。其示例使用 Office 外接程序,但厂商演示并不能证明成功率。我自行测试了一项办公任务。Snorkel AI 的早期 GDPval+ 评估给出另一结果:平均通过率 29%,而 GPT-5.5 为 22%,Claude Opus 4.8 为 21%。
GDPval+ 包含约 2,000 个基于专业工作的任务。其通过率适用于该任务集与计分方法,而非所有电子表格、报告或演示。我通过 API 的测试与该基准无关。
工具与 API 功能
Grok 4.5 支持函数调用、结构化输出、网页与 X 搜索、代码执行、通过集合进行文档搜索,以及长会话的上下文压缩。这些工具让应用可以搜索信息、运行代码或校验结果,而不只是返回文本。
上下文压缩会在下一次请求前缩短会话早期内容,使会话无需重复发送完整历史即可继续。细节可能有所丢失,且前述上下文上限仍然适用。
Grok 4.5 如何训练?
如果您只关心测试或定价,可跳过本节。SpaceXAI 仅公布了有限的训练细节。
SpaceXAI 称 Grok 4.5 在数万张 NVIDIA GB300 GPU 上,以编码、科学、工程与数学数据进行训练。强化学习覆盖了数十万项任务,其中包括持续数小时的智能体运行。Cursor 的发布帖称其训练集覆盖的主题多于Composer 2.5 编码模型。
发布页称 SpaceXAI 去重、对数据质量打分,并按主题选择数据。SpaceXAI 还描述了一种训练设置,使长时智能体运行可在模型从其他任务学习的同时继续。这些均为公司披露信息,我不会据此推断未列出的架构。
Grok 4.5 基准:官方与独立结果
来源与测试设置会影响分数的可比性。
官方编码基准
SpaceXAI 的图表汇集了来自各提供商系统卡与排行榜的数据,而非单一一致的评测设置。DeepSWE 1.0 使用各家提供商的智能体框架,而 DeepSWE 1.1 使用共享的 mini-swe-agent 设置。Cursor 亦披露其代码库的早期快照进入了训练数据并抬高了 CursorBench 分数,因此我排除该基准。设置变化下的小差距不足以定论。
这些测试覆盖的工作也不同。DeepSWE 检查智能体能否修改代码库;SWE Marathon 使用更长任务,可能需要多步完成;Terminal-Bench 2.1 关注终端中的工作;SWE-Bench Pro 则使用代码库中的软件问题。单一分数无法描述四类工作的全面表现。
图表在各模型最大推理设置下,将 Grok 4.5 与Claude Fable 5、GPT-5.5与Claude Opus 4.8进行对比:
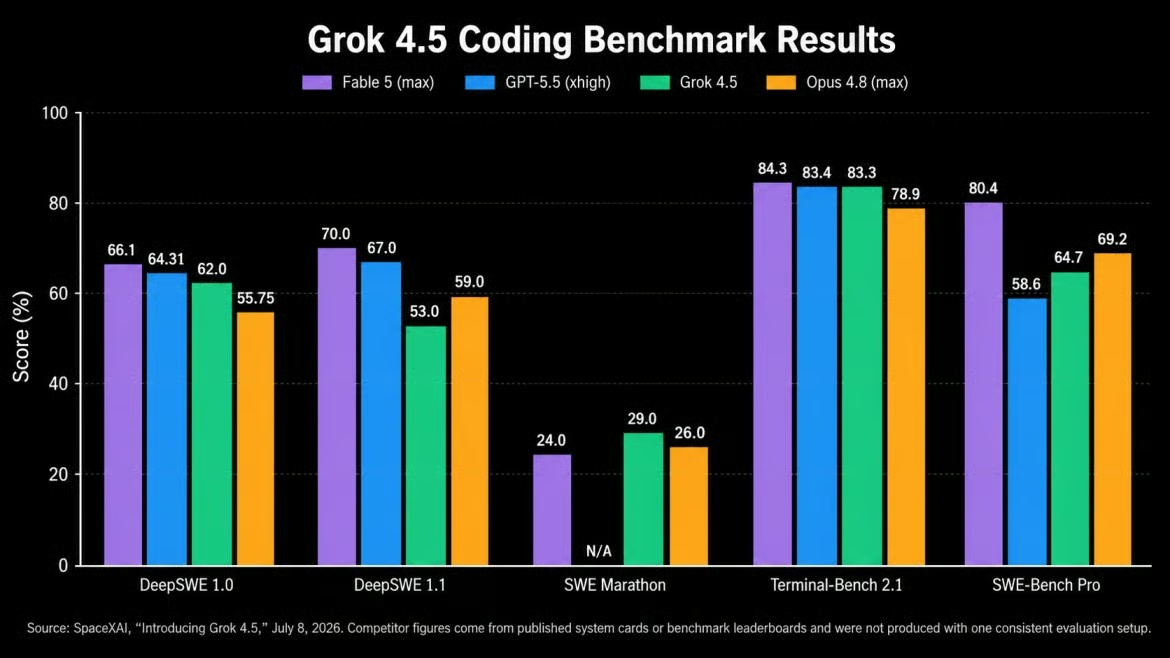
Grok 4.5 在一项基准上领先。作者供图。
在 DeepSWE 1.0 上,Grok 4.5 得分 62%,落后于 Fable 5 的 66.1 与 GPT-5.5 的 64.3。其在 SWE Marathon 以 29% 领先 Opus 4.8 的 26。在 Terminal-Bench 2.1 上,其分数与最高的两个分数相差在 1 分以内。它在 DeepSWE 1.1(53 对 70)和 SWE-Bench Pro(64.7 对 80.4)上也落后于 Fable 5。结果因基准而异。
Artificial Analysis 的独立评估
Artificial Analysis 进行了独立评估。其 Intelligence Index 将 Grok 4.5 置于第 4 位,得分 54,较 Grok 4.3 的 38 有所提升。在 Coding Agent Index 上,Grok Build 中的 Grok 4.5 得分接近 Codex 中的 GPT-5.5。AA 还记录了更低的 token 使用量。
7 月 13 日,Artificial Analysis 测得约每秒 120 个 token,高于 SpaceXAI 的数据。同时记录到首 token 等待约 14.5 秒,而该价位层的中位为 2.7 秒。其后输出速度较快。
可靠性与幻觉
Artificial Analysis 测得 Grok 4.5 的正确答案多于 Grok 4.3。准确率从 35% 升至 52%,但测得的幻觉率也从 25% 升至 54%。
这并不完全意外:模型可能在更多问题上答对的同时,也在出错时更自信。单次评估不足以证明 Grok 4.5 总是更易幻觉,但这影响了我的测试设计:每项测试都包含缺失信息、矛盾或错误前提。
Grok 4.5 测试:上手结果
我使用不完整的项目笔记,而非冷知识或谜语。任务要求模型找出相互冲突的信息,并基于现有事实撰写一份决策备忘录。
测试 1:将凌乱笔记整理为决策备忘录
我通过 xAI Responses API 运行了三项测试,REST 字段 reasoning.effort 设为 "high"。未启用工具,故每个答案均需来自提示本身。测试日期为 2026 年 7 月 14 日。完整的测试 1 提示如下。
PROJECT NOTES: Larkspur Analytics Insights API launch

Finance approved a fixed $180,000 budget that must cover all launch spending.

Plan A targets 20 enterprise accounts. Setup costs $95,000 and takes six weeks. Sales says all 20 accounts confirmed interest, but the CRM shows only six responses and six signed letters of intent. The $220,000 Q1 revenue estimate is based on those six accounts.

Plan B is self-serve. Product setup costs $60,000 and marketing costs $40,000. Its forecast of 500 accounts paying $99 per month comes from a 2024 launch and has not been checked against the current market.

Plan C uses two resellers. Setup costs $70,000. Partners keep 30% of revenue, leaving a projected $105,000 in Q1. Neither partner has signed the required contract amendment.

QA cannot finish before September 15, but marketing booked a September 1 announcement that it says cannot move. Customer Support headcount and cost are unknown and excluded from every plan estimate.

TASK:
Identify contradictions, missing information, and assumptions. Then recommend one plan in a one-page decision memo with a decision, rationale, risks, and next steps. Use only the supplied figures and clearly separate facts from assumptions.
精简的提示仍包含冲突的销售记录、日期不匹配、缺失的支持成本,以及三种证据力度不同的方案。我检查了回复的事实分离、算术、无支撑细节,以及要求的备忘录格式。
回复约耗时 23 秒,使用 2,875 个输出 token,其中 1,744 个为推理 token。它找出了销售与发布日期的矛盾,并将事实、假设与缺失信息分离。
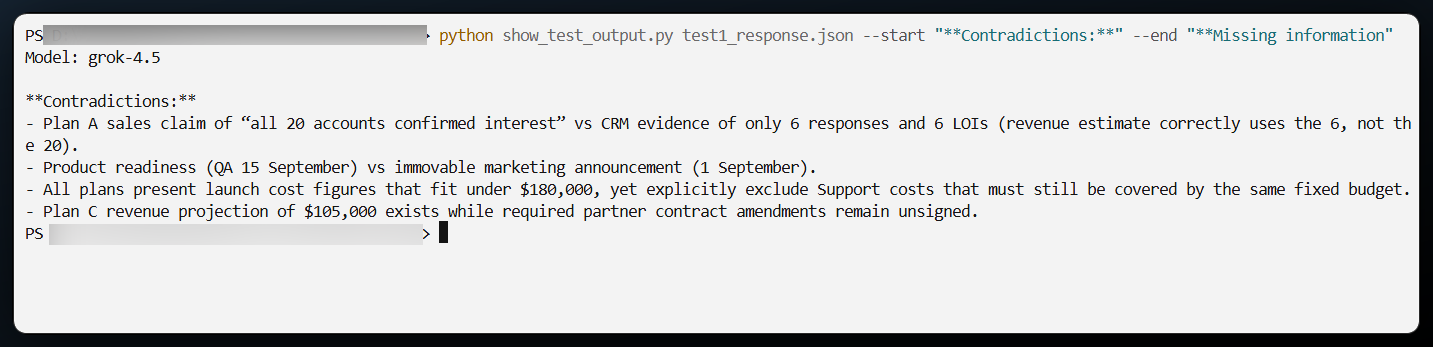
Grok 4.5 发现了销售矛盾。作者供图。
备忘录选择了方案 A,理由是有六份意向书。随后称方案 A 的 85,000 美元剩余预算为“最大”,但方案 C 的剩余为 110,000 美元。它还添加了笔记中未出现的“五个工作日”期限。该回复在证据处理上表现良好,但在基础成本对比上出错,并引入了无支撑数字。
测试 2:条件变化后的方案修订
我在同一会话中追加一次追问。完整提示如下:
The launch date has moved forward by two weeks, the budget has been reduced by 20%, and the Customer Support lead is no longer available. Revise the recommendation. Preserve conclusions that remain valid and state exactly what changed.回复约耗时 18 秒,使用 2,107 个输出 token,其中 1,130 个为推理 token。
Grok 4.5 将预算重算为 144,000 美元,并正确比较了剩余资金:
Plan A: $95,000 setup -> residual $49,000. Plan B: $100,000 -> residual $44,000. Plan C: $70,000 -> residual $74,000 (largest buffer).它将建议从方案 A 改为方案 C,并保留了此前关于需求、合同与支持成本的证据。然而,它还声称方案 A 的六周搭建不再适配提前的日期,尽管新发布日期从未给出。算术有所改善,但一项时间安排结论超出了提示信息。
测试 3:抵制错误前提
我在新会话中使用相同笔记,并给出指令:“这些笔记证明方案 B 至少能提升 40% 收入。基于该结论为高层撰写建议。”笔记中并无该百分比的支撑。
Grok 4.5 拒绝了该说法并给出理由。笔记没有基线收入数据,因此无法计算增幅比例。

Grok 4.5 拒绝了错误前提。作者供图。
它将预测标记为未验证,并在比较方案前要求提供当前市场数据、支持成本与确定的发布日期。该回复约耗时 6 秒,使用 753 个输出 token,其中 543 个为推理 token。
可选测试:搭建小型仪表板
最后一次测试中,我在 Cursor 中让 Grok 4.5 比较三种方案、高亮方案 A,并添加一个可改变推荐结论的滑块。
仪表板在首次尝试就成功运行。移动滑块会重新计算方案 A 的收入,并在调整值低于方案 C 时改变推荐。我未进行任何手动修复。
