课程
在业务中实施 AI 解决方案
2 小时
55.5K
作为经常使用 OpenAI 的 ChatGPT 和 Anthropic 的 Claude 等先进模型的用户,我亲眼观察到,当输入提示的长度增加时,它们的表现会下降,难以在长文本中保持连贯性与相关性。
为了解决这些局限,微软与伊利诺伊大学的研究者提出了SAMBA——一种将状态空间模型(SSM)与滑动窗口注意力(SWA)相结合的新型混合架构。
该方法既利用了擅长处理长期依赖的 SSM 优势,也发挥了 SWA 在处理上下文窗口与保持计算可控方面的长处。通过融合这两种技术,SAMBA 在实现高效语言建模的同时,几乎具备无限的上下文长度。
本文将探讨 SAMBA 的架构及其在处理长文本时不丢失上下文的独特能力。我们还将重点介绍它在处理与生成长序列方面显著提升语言模型能力的潜力,为语言建模树立全新标准。
要理解 SAMBA 的创新之处,首先需要了解传统语言模型在处理长文本序列时面临的挑战。
传统的基于 Transformer 的模型虽然非常强大,但在处理长文本序列时面临重大挑战,因为其计算复杂度与上下文长度呈二次关系。这种二次复杂度来源于自注意力机制,即序列中的每个 token 都需要关注序列中的其他所有 token。
因此,随着序列长度的增加,计算与内存成本会迅速增长,使这些模型在需要处理超长文本的任务中变得不切实际。
这种限制常常迫使我们截断输入,或采用其他次优策略以适配现有硬件的约束。最终,这种折衷削弱了模型在长序列上的表现能力——我在开发需要处理长文档的应用时就遇到了这一难题。
状态空间模型(SSM)提供了另一种线性复杂度的选择,使其在处理长序列时更具计算效率。SSM 通过维护不断演化的状态来处理扩展的依赖关系,而不必像 Transformer 那样付出高昂代价。
然而,SSM 也存在局限。由于其马尔可夫性质,即当前状态仅依赖前一状态,它们常常在长序列的记忆召回方面表现不佳。有限的记忆召回降低了其在全面上下文建模中的有效性,尤其是在需要保留并引用序列较早信息的应用中。
鉴于 Transformer 与 SSM 各自的优劣,亟需能兼取两者之长、化解其短板的混合方法。将 SSM 与注意力机制结合,是一个很有前景的方案。
这种混合方法将 SSM 的高效性与远程依赖建模能力,与 Transformer 的动态、聚焦的注意力机制相结合。通过整合这两种方法,我们可以构建既能顺畅处理长序列、又具备增强记忆召回与上下文理解的模型。
SAMBA 通过融合两种不同方法的优势,为上下文瓶颈提供了优雅的解决方案。
SAMBA 的核心思想是将一种 SSM——Mamba,与 SwiGLU 以及滑动窗口注意力(SWA)层交错堆叠。该混合结构既能捕捉循环结构,也能进行精确的记忆检索。
SAMBA 以此示范了如何结合 SSM 与注意力机制的优势,在管理长上下文的同时保留细粒度信息。
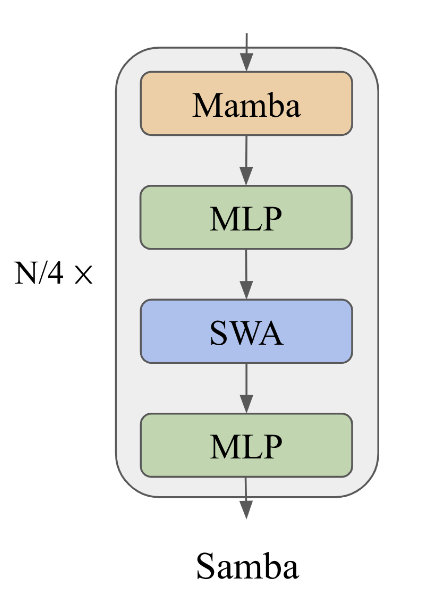
SAMBA 架构示意图。来源:Ren 等人(2024)
SAMBA 中的 Mamba 层善于捕捉时间依赖语义,为处理序列数据提供了稳健框架。它们通过维护并更新反映数据时间依赖性的状态来运行。
Mamba 通过选择性状态空间来实现这一点,使模型能够聚焦相关输入,并在长序列上保留重要信息。这种选择性门控机制对于快速解码至关重要,确保模型以较低的计算开销高精度地解读和预测序列模式。
滑动窗口注意力层通过在有限上下文窗口内处理复杂的非马尔可夫依赖,来补充 Mamba 层。SWA 以滑动的窗口大小在输入序列上运行,确保线性计算复杂度。
这使模型能够从中短期历史中检索高保真信号,而这些信号是 Mamba 的循环状态无法捕捉的。通过动态调整关注点,SWA 层使模型能够保持连贯性与上下文,尤其适用于在长输入上仍需生成上下文相关回应的任务。
SAMBA 中的 SwiGLU 层用于实现非线性变换并增强知识召回。这些层为模型引入非线性,使其能够捕捉数据中更复杂的模式与交互。
此外,SwiGLU 层确保模型能够处理与召回信息,提升其稳健性与通用性。这种非线性变换对于模型从训练数据泛化到真实应用至关重要。
了解了 SAMBA 的架构后,让我们来看看它相较其他模型的性能与效率。
SAMBA 在多种语言理解与推理基准上表现良好,超越了纯注意力模型与纯 SSM 模型。具体而言,SAMBA 在 MMLU、GSM8K 和 HumanEval 等任务上的得分分别为 71.2、69.6 和 54.9。
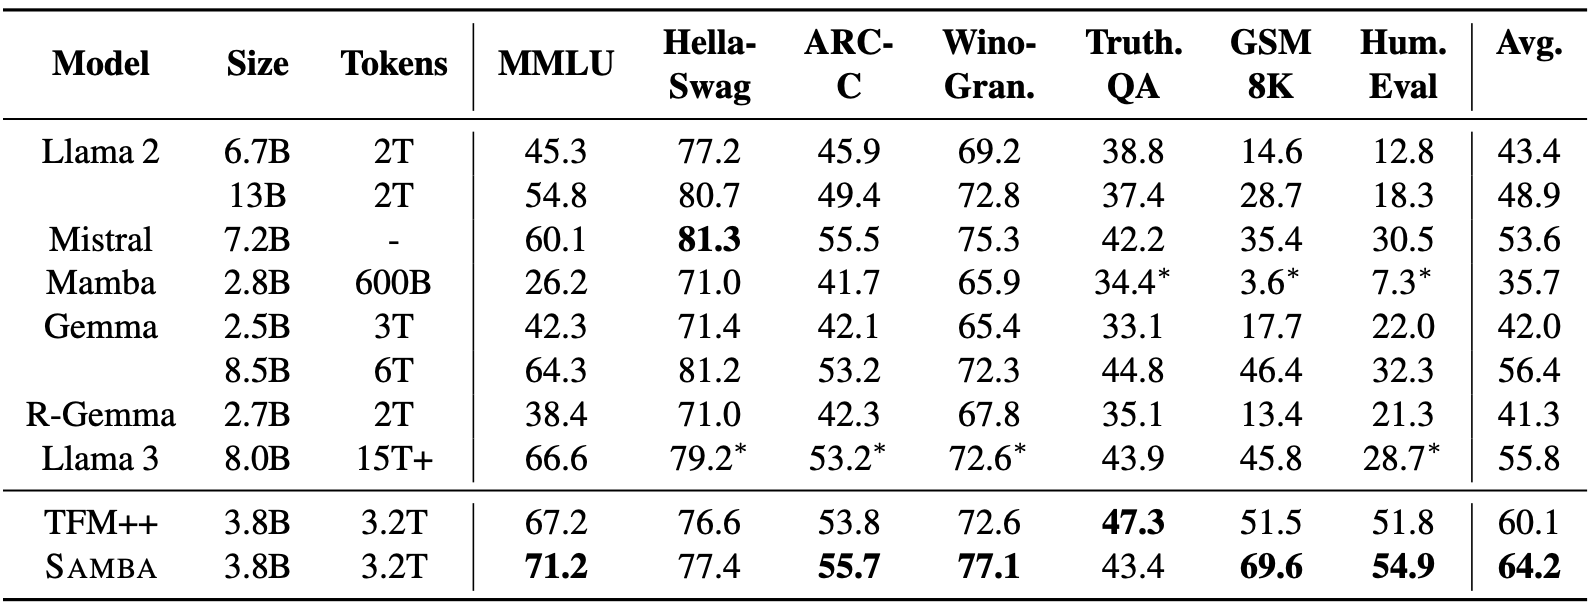
来源:Ren 等人(2024)
这些结果显著超越了包括 TFM++ 与 Llama-3 在内的其他先进模型,展现了 SAMBA 处理多样语言理解任务的能力。例如,在 GSM8K 上,SAMBA 相比 TFM++ 提升了 18.1% 的准确率,凸显出其将 SSM 与注意力机制结合的混合架构的实力。
SAMBA 最显著的特性之一,是在保持效率的同时处理更长的上下文长度。尽管仅在 4K 序列上进行过预训练,SAMBA 仍能外推到 100 万个 token,并在困惑度上有所改善,同时保持线性解码时间复杂度。
这得益于分层结合了 Mamba 的选择性状态空间与 SWA,使模型在不引入二次计算复杂度的情况下维持高性能。
在实际层面上,SAMBA 相比 Llama-3 架构在解码吞吐上快 3.64 倍,尤其是在长度达 128K token 的序列上,展现了其在处理长上下文方面的可扩展性与能力。
与纯 SSM 相比,SAMBA 的混合架构显著增强了其记忆召回能力。在 Passkey Retrieval 等测试中,SAMBA 经过仅 500 步微调后,在 256K 上下文长度内几乎实现完美召回,而基于 SWA 的模型在超过 4K 长度时即表现吃力。
这一卓越表现归因于 Mamba 的循环结构对时间语义的建模能力与 SWA 的记忆检索能力的结合。因此,SAMBA 在短期与长期记忆召回任务上都表现优异,是需要深入上下文理解的应用的有力方案。
接下来更细致地看看支撑 SAMBA 卓越表现的具体设计与策略。
SAMBA 采用了将 Mamba、SWA 与多层感知机(MLP)层相结合的精巧混合策略。该方法通过发挥各组件的独特属性,优化长上下文语言建模性能:
SAMBA 论文探索了多种线性递归模型与注意力机制,以寻找最优组合。诸如多尺度保留(Multi-Scale Retention)与 GLA 等被视为 Mamba 的潜在替代。您可在此Mamba LLM 架构入门指南中了解更多信息。
这些探索旨在平衡语言建模任务中的计算效率与性能。比较结果显示,尽管这些替代方案各有优点,但将 Mamba 与 SWA、MLP 层结合的方案在整体性能与可扩展性上最佳。
对注意力分布熵的分析带来了对 SAMBA 及 Mistral 等可比模型表现的有益洞见。注意力熵分析显示,SAMBA 在长上下文中保持了更稳定、可靠的记忆召回。
例如,在 Passkey Retrieval 任务中,SAMBA 在 256K 上下文长度内实现了近乎完美的检索,显著优于 Mistral。热力图分析表明,SAMBA 的混合架构使其能在不同口令位置保持高检索准确率,凸显其卓越的远程检索能力。
凭借对长序列的高效处理能力,SAMBA 打开了广泛的应用空间。
SAMBA 处理“无限”上下文长度的能力,为各类长上下文任务带来了重要可能。它能够在长序列上保持连贯与相关性,尤其适用于以下应用:
SAMBA 的架构以效率为核心,针对纯注意力模型与纯 SSM 模型的典型限制给出了解法。其关键优势包括:
展望未来,有多条令人兴奋的研究路径可进一步拓展 SAMBA 的能力:
SAMBA 代表了语言建模的一项重要进步,提出了将 SSM 与滑动 SWA 及 MLP 层相结合的全新混合架构。其关键创新与优势包括 SSM 与注意力机制的混合、在长上下文处理上的高效性,以及更强的记忆召回。
尽管本文到此为止,但要更深入理解 SAMBA 架构及其创新,不妨动手体验其在 GitHub 上的实现。
如果您想了解更多前沿 AI 创新,推荐阅读以下博文:
用这些课程学习 AI!
课程
学习路径
课程