Cours
Implémentation IA en entreprise
2 h
54.9K
En utilisant régulièrement des modèles avancés comme ChatGPT d’OpenAI et Claude d’Anthropic, j’ai pu constater de première main comment leurs performances se dégradent à mesure que la longueur des invites augmente, avec à la clé des difficultés à maintenir la cohérence et la pertinence sur de longs textes.
Pour répondre à ces limites, des chercheurs de Microsoft et de l’Université de l’Illinois présentent SAMBA—une architecture hybride innovante qui combine des modèles d’espace d’états (SSM) et l’attention à fenêtre coulissante (SWA).
Cette approche tire parti des forces des SSM, excellents pour gérer les dépendances à long terme, et de la SWA, qui gère les fenêtres de contexte tout en restant calculatoirement soutenable. En combinant ces techniques, SAMBA propose un modélisation du langage efficace avec une longueur de contexte pratiquement illimitée.
Dans cet article, nous allons détailler l’architecture de SAMBA et sa capacité singulière à traiter de longs passages sans perdre le fil du contexte. Nous mettrons aussi en avant son potentiel pour renforcer nettement les capacités des modèles de langage dans le traitement et la génération de séquences étendues, posant un nouveau standard en modélisation du langage.
Pour saisir ce qui rend SAMBA si innovant, il faut d’abord comprendre les difficultés auxquelles les modèles de langage traditionnels se heurtent face à de longues séquences de texte.
Les modèles basés sur Transformer, bien que très puissants, rencontrent des difficultés majeures avec de longues séquences en raison de leur complexité quadratique par rapport à la longueur du contexte. Cette complexité provient du mécanisme d’auto-attention, qui exige que chaque jeton porte attention à tous les autres jetons de la séquence.
Résultat : les coûts de calcul et de mémoire explosent avec la longueur des séquences, rendant ces modèles peu pratiques pour les tâches nécessitant le traitement de textes très longs.
Cette limite nous oblige souvent à tronquer les entrées ou à recourir à des stratégies sous-optimales pour respecter les contraintes matérielles. In fine, ce compromis nuit à la capacité du modèle à maintenir ses performances sur de longues séquences, un problème que j’ai rencontré en développant une application devant traiter des documents volumineux.
Les modèles d’espace d’états (SSM) offrent une alternative à complexité linéaire, plus efficace pour gérer de longues séquences. Les SSM maintiennent un état évolutif, leur permettant de capturer des dépendances étendues sans le coût prohibitif des transformers.
Mais ils ont aussi des limites. De par leur nature markovienne, où l’état courant ne dépend que de l’état précédent, ils peinent souvent à se souvenir d’éléments sur de longues séquences. Cette mémorisation restreinte nuit à une modélisation contextuelle complète, notamment lorsque l’on doit conserver et réutiliser des informations situées bien plus tôt dans la séquence.
Compte tenu des forces et faiblesses des Transformers et des SSM, le recours à des approches hybrides s’impose pour tirer parti des avantages de chacun tout en en corrigeant les limites. Combiner des SSM avec des mécanismes d’attention est une piste prometteuse.
Cette approche hybride allie l’efficacité et la gestion des dépendances à longue portée des SSM à l’attention dynamique et ciblée des Transformers. En intégrant ces deux méthodes, on obtient un modèle qui traite sans heurt de longues séquences tout en améliorant la mémorisation et la compréhension du contexte.
SAMBA propose une réponse élégante à ce goulot d’étranglement du contexte, en combinant les atouts de deux approches distinctes.
L’idée clé de SAMBA est d’entrelacer Mamba, un SSM, avec des couches SwiGLU et des couches d’attention à fenêtre coulissante (SWA). Cette structure hybride capte à la fois les structures récurrentes et une mémorisation précise.
SAMBA illustre cette démarche en combinant les forces des SSM et des mécanismes d’attention pour gérer de longs contextes tout en conservant des détails fins.
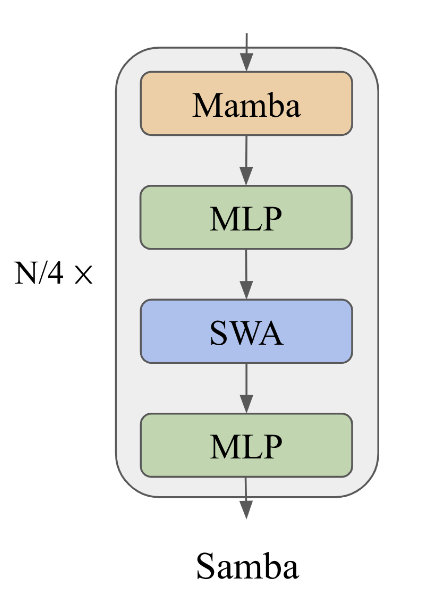
Schéma illustrant l’architecture SAMBA. Source : Ren et al. (2024)
Dans SAMBA, les couches Mamba excellent à capturer les sémantiques dépendantes du temps, offrant un cadre robuste pour traiter des données séquentielles. Elles opèrent en maintenant et en mettant à jour un état reflétant les dépendances temporelles au sein des données.
Mamba y parvient grâce à des espaces d’états sélectifs qui permettent au modèle de se concentrer sur les entrées pertinentes et de conserver les informations importantes sur de longues séquences. Ce mécanisme de filtrage sélectif est crucial pour un décodage rapide et garantit une interprétation et une prédiction précises des motifs séquentiels avec un coût de calcul minimal.
Les couches d’attention à fenêtre coulissante complètent les couches Mamba en traitant des dépendances complexes, non markoviennes, à l’intérieur d’une fenêtre de contexte limitée. La SWA opère avec une fenêtre glissante le long de la séquence d’entrée, ce qui garantit une complexité linéaire.
Ainsi, le modèle récupère des signaux à haute définition provenant de l’historique récent à intermédiaire, que les états récurrents de Mamba ne peuvent pas saisir. En ajustant dynamiquement son focus, la SWA aide le modèle à maintenir la cohérence et le contexte, tout particulièrement pour des tâches exigeant des réponses pertinentes sur de longues entrées.
Les couches SwiGLU de SAMBA apportent des transformations non linéaires et renforcent la restitution des connaissances. Elles introduisent de la non-linéarité, permettant de capturer des motifs et interactions plus complexes au sein des données.
En outre, les couches SwiGLU améliorent la capacité du modèle à traiter et à rappeler l’information, contribuant à sa robustesse et à sa polyvalence. Cette transformation non linéaire est essentielle pour la généralisation du modèle, des données d’entraînement aux usages concrets.
Après l’architecture, examinons les performances et l’efficacité de SAMBA face à d’autres modèles.
SAMBA affiche de bons résultats sur divers benchmarks de compréhension et de raisonnement, surpassant les modèles purement à base d’attention comme ceux purement SSM. Il a notamment été évalué sur MMLU, GSM8K et HumanEval, avec des scores de 71,2 sur MMLU, 69,6 sur GSM8K et 54,9 sur HumanEval.
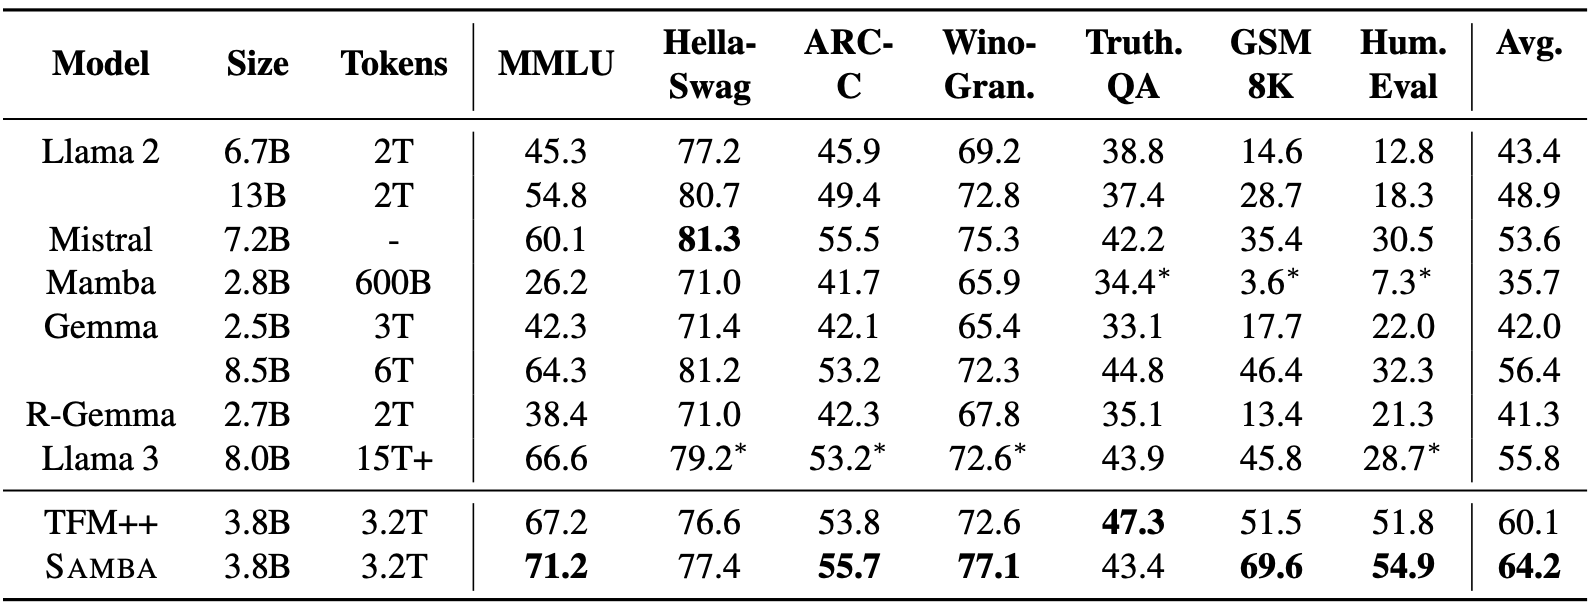
Source : Ren et al. (2024)
Ces résultats dépassent nettement ceux d’autres modèles de pointe, dont TFM++ et Llama 3, et illustrent la capacité de SAMBA à gérer des tâches variées de compréhension du langage. Par exemple, SAMBA a atteint une exactitude supérieure de 18,1 points sur GSM8K par rapport à TFM++, ce qui souligne l’efficacité de son architecture hybride combinant SSM et mécanismes d’attention.
L’une des caractéristiques les plus marquantes de SAMBA est sa capacité à gérer des contextes très longs tout en restant efficace. Bien qu’il soit prééntraîné sur des séquences de 4 K, SAMBA peut extrapoler jusqu’à 1 M de jetons avec une perplexité améliorée tout en conservant une complexité de temps de décodage linéaire.
Il y parvient grâce à la combinaison, couche par couche, des espaces d’états sélectifs de Mamba et de la SWA, ce qui lui permet de maintenir de hautes performances sans coût quadratique.
Concrètement, SAMBA atteint un débit de décodage 3,64× plus rapide que l’architecture Llama 3, en particulier pour des séquences jusqu’à 128 K jetons, ce qui démontre sa capacité à passer à l’échelle et à traiter de longs contextes.
L’architecture hybride de SAMBA renforce nettement ses capacités de mémorisation par rapport aux SSM purs. Sur des tests comme Passkey Retrieval, SAMBA a montré une mémorisation quasi parfaite jusqu’à 256 K de contexte après seulement 500 itérations de fine-tuning, alors que les modèles basés uniquement sur la SWA peinaient au-delà de 4 K.
Cette performance d’exception tient à la conjugaison des structures récurrentes de Mamba, utiles pour les sémantiques temporelles, et des capacités de rappel de la SWA. SAMBA excelle donc à la fois sur la mémoire à court et à long terme, ce qui en fait une solution robuste pour les applications exigeant une compréhension contextuelle approfondie.
Regardons de plus près les choix de conception et stratégies qui sous-tendent les performances de SAMBA.
SAMBA adopte une stratégie d’hybridation sophistiquée alliant Mamba, SWA et des couches de perceptron multicouche (MLP). Cette approche optimise la modélisation de langage en long contexte en s’appuyant sur les propriétés uniques de chaque composant :
L’article SAMBA étudie divers modèles récurrents linéaires et mécanismes d’attention pour trouver la combinaison la plus pertinente. Des alternatives comme Multi-Scale Retention et GLA ont été envisagées en remplacement potentiel de Mamba. Vous trouverez plus de détails sur l’architecture Mamba dans ce guide d’introduction à l’architecture Mamba des LLM
Ces explorations visaient à équilibrer efficacité de calcul et performance sur des tâches de modélisation du langage. La comparaison montre que, si ces alternatives apportent certains bénéfices, l’association de Mamba avec la SWA et des couches MLP offre le meilleur compromis en performance globale et en capacité de passage à l’échelle.
L’analyse de l’entropie des distributions d’attention fournit des enseignements précieux sur les performances de SAMBA et de modèles comparables comme Mistral. Elle révèle que SAMBA conserve une mémorisation plus stable et fiable sur de longs contextes.
Par exemple, sur la tâche Passkey Retrieval, SAMBA a montré un rappel quasi parfait jusqu’à 256 K de contexte, surpassant nettement Mistral. La carte thermique indique que l’architecture hybride de SAMBA lui permet de maintenir une forte précision de rappel quel que soit l’emplacement de la clé, ce qui souligne ses capacités remarquables de rappel à longue portée.
Sa capacité à traiter efficacement de longues séquences ouvre un large éventail d’usages potentiels.
La capacité de SAMBA à gérer une longueur de contexte illimitée démultiplie les possibilités pour les tâches à long contexte. Le modèle maintient cohérence et pertinence sur de longues séquences, ce qui le rend particulièrement adapté à :
L’architecture de SAMBA est conçue pour l’efficacité, en corrigeant les limites typiques des modèles purement à base d’attention ou purement SSM. Parmi les principaux bénéfices :
Pour l’avenir, plusieurs pistes prometteuses peuvent encore développer les capacités de SAMBA :
SAMBA marque une avancée majeure en modélisation du langage avec une architecture hybride innovante qui combine SSM, SWA et couches MLP. Parmi ses atouts : l’hybridation SSM + attention, l’efficacité sur les longs contextes et une mémorisation renforcée.
Pour approfondir, le meilleur moyen est encore d’expérimenter l’implémentation disponible sur GitHub.
Pour en savoir plus sur les dernières innovations en IA, nous vous recommandons ces articles :
Formez-vous à l’IA avec ces cours !
Cours
Cursus
Cours