Corso
Implementare le soluzioni di intelligenza artificiale nelle aziende
2 ore
55.7K
Da utente abituale di modelli avanzati come ChatGPT di OpenAI e Claude di Anthropic, ho osservato in prima persona come le loro prestazioni peggiorino all'aumentare della lunghezza dei prompt di input, causando difficoltà nel mantenere coerenza e pertinenza su testi estesi.
Per affrontare questi limiti, i ricercatori di Microsoft e dell'Università dell'Illinois hanno introdotto SAMBA—un'innovativa architettura ibrida che combina i modelli a spazio di stato (SSM) con l'attenzione a finestra scorrevole (SWA).
Il loro approccio sfrutta i punti di forza di entrambi: gli SSM, eccellenti nella gestione delle dipendenze di lungo periodo, e la SWA, che gestisce le finestre di contesto mantenendo la trattabilità computazionale. Unendo queste tecniche, SAMBA realizza un language modeling efficiente con una lunghezza del contesto praticamente illimitata.
In questo articolo esploreremo l'architettura di SAMBA e la sua peculiare capacità di gestire lunghi brani di testo senza perdere il contesto. Metteremo anche in evidenza il suo potenziale nel potenziare in modo significativo le capacità dei modelli linguistici nell'elaborazione e generazione di sequenze estese, fissando un nuovo standard nel language modeling.
Per capire perché SAMBA sia così innovativo, dobbiamo prima considerare le sfide che i modelli linguistici tradizionali affrontano con sequenze di testo lunghe.
I modelli basati su Transformer, per quanto potenti, incontrano notevoli difficoltà con sequenze lunghe a causa della complessità quadratica rispetto alla lunghezza del contesto. Questa complessità quadratica deriva dal meccanismo di self-attention, che richiede a ogni token di prestare attenzione a tutti gli altri token nella sequenza.
Di conseguenza, i costi computazionali e di memoria crescono rapidamente con l'aumentare della lunghezza della sequenza, rendendo questi modelli poco pratici per compiti che richiedono l'elaborazione di testi molto lunghi.
Questa limitazione spesso ci costringe a troncare gli input o a ricorrere ad altre strategie subottimali per rientrare nei vincoli dell'hardware disponibile. In ultima analisi, questo compromesso riduce la capacità del modello di mantenere le prestazioni su sequenze estese, una sfida che ho incontrato sviluppando un'applicazione che deve elaborare documenti lunghi.
I modelli a spazio di stato (SSM) offrono un'alternativa con complessità lineare, risultando più efficienti dal punto di vista computazionale nella gestione di sequenze lunghe. Gli SSM mantengono uno stato in evoluzione, permettendo di gestire dipendenze estese senza i costi proibitivi dei transformer.
Tuttavia, gli SSM presentano dei limiti. A causa della loro natura markoviana, in cui lo stato attuale dipende solo da quello precedente, spesso faticano nel richiamo della memoria su sequenze lunghe. Questo richiamo limitato riduce l'efficacia nella modellazione del contesto complessivo, in particolare nelle applicazioni che richiedono la conservazione e il riferimento a informazioni molto precedenti nella sequenza.
Dato il mix di punti di forza e debolezze di Transformer e SSM, emerge una forte esigenza di approcci ibridi che sfruttino i vantaggi di ciascuno mitigandone i limiti. Combinare SSM con meccanismi di attenzione è una soluzione promettente.
Questo approccio ibrido utilizza l'efficienza e le proprietà di dipendenza a lungo raggio degli SSM insieme al meccanismo di attenzione dinamico e mirato dei Transformer. Integrando questi due metodi, possiamo creare un modello che elabora fluidamente sequenze lunghe con miglior richiamo della memoria e comprensione contestuale.
SAMBA offre una soluzione elegante a questo collo di bottiglia del contesto, combinando i punti di forza di due approcci distinti.
L'idea di base di SAMBA è alternare Mamba, un SSM, con strati SwiGLU e di attenzione a finestra scorrevole (SWA). Questa struttura ibrida cattura sia strutture ricorrenti sia un recupero preciso della memoria.
SAMBA esemplifica questo approccio combinando i punti di forza di SSM e meccanismi di attenzione per gestire contesti lunghi mantenendo informazioni dettagliate.
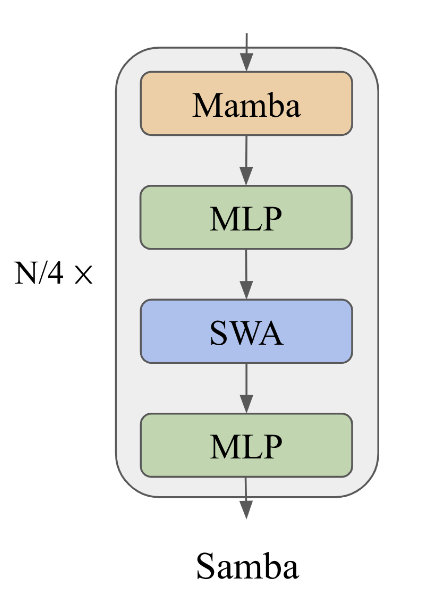
Diagramma che illustra l'architettura di SAMBA. Fonte: Ren et al. (2024)
Gli strati Mamba in SAMBA sono abili nel catturare la semantica dipendente dal tempo, offrendo un quadro solido per gestire dati sequenziali. Questi strati operano mantenendo e aggiornando uno stato che riflette le dipendenze temporali all'interno dei dati.
Mamba lo realizza utilizzando spazi di stato selettivi che consentono al modello di concentrarsi sugli input rilevanti e mantenere informazioni importanti su sequenze lunghe. Questo meccanismo di gating selettivo è cruciale per un decoding rapido e garantisce che il modello possa interpretare e prevedere schemi sequenziali con alta accuratezza e un overhead computazionale minimo.
Gli strati di attenzione a finestra scorrevole completano gli strati Mamba affrontando dipendenze complesse e non markoviane entro una finestra di contesto limitata. La SWA opera su una dimensione di finestra che scorre sulla sequenza di input, garantendo complessità computazionale lineare.
Ciò consente al modello di recuperare segnali ad alta definizione dalla storia di medio-breve termine che non possono essere catturati dagli stati ricorrenti di Mamba. Regolando dinamicamente il proprio focus, gli strati SWA permettono al modello di mantenere coerenza e contesto, soprattutto per i compiti che richiedono risposte contestualmente pertinenti su input lunghi.
Gli strati SwiGLU in SAMBA favoriscono trasformazioni non lineari e migliorano il richiamo della conoscenza. Questi strati introducono non linearità nel modello, consentendogli di cogliere pattern e interazioni più complessi all'interno dei dati.
Inoltre, gli strati SwiGLU assicurano che il modello possa elaborare e richiamare informazioni, contribuendo alla sua robustezza e versatilità. Questa trasformazione non lineare è essenziale per la capacità del modello di generalizzare dai dati di training alle applicazioni reali.
Dopo aver esplorato l'architettura di SAMBA, analizziamone ora prestazioni ed efficienza rispetto ad altri modelli.
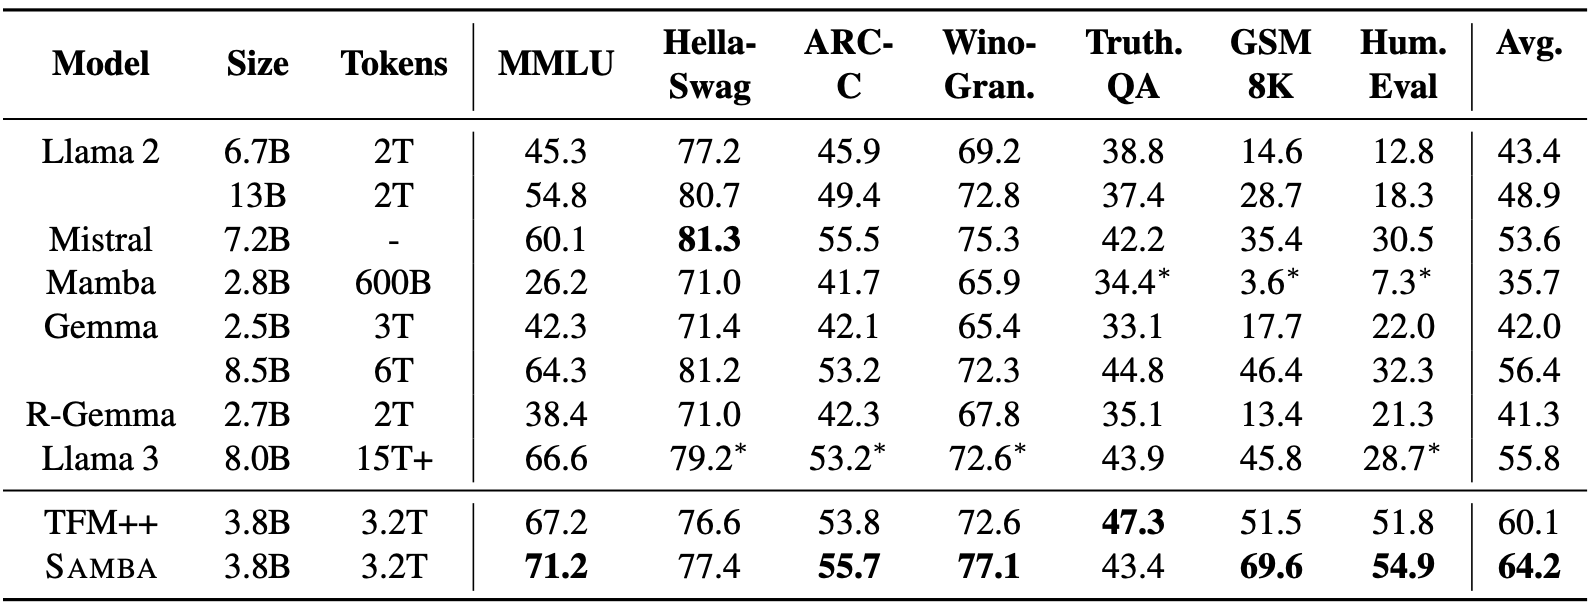
SAMBA mostra buone prestazioni su una varietà di benchmark di comprensione linguistica e ragionamento, superando sia i modelli basati unicamente su attention sia quelli basati su SSM. In particolare, SAMBA è stato valutato su compiti come MMLU, GSM8K e HumanEval, ottenendo 71,2 su MMLU, 69,6 su GSM8K e 54,9 su HumanEval.
Fonte: Ren et al. (2024)
Questi risultati superano in modo significativo altri modelli all'avanguardia, tra cui TFM++ e Llama-3, mettendo in luce la capacità di SAMBA di gestire compiti di comprensione linguistica eterogenei. Per esempio, SAMBA ha ottenuto una precisione superiore del 18,1% in GSM8K rispetto a TFM++, evidenziando l'efficacia della sua architettura ibrida che combina SSM e meccanismi di attenzione.
Una delle caratteristiche più notevoli di SAMBA è la capacità di gestire contesti significativamente più lunghi mantenendo l'efficienza. Pur essendo pre-addestrato su sequenze di lunghezza 4K, SAMBA può estrapolare fino a 1M di token con una perplexity migliorata e mantenere comunque una complessità temporale di decoding lineare.
Questo è ottenuto attraverso la combinazione per strato degli spazi di stato selettivi di Mamba con la SWA, permettendo al modello di mantenere alte prestazioni senza la complessità computazionale quadratica.
In termini pratici, SAMBA raggiunge un throughput di decoding 3,64 volte più veloce rispetto all'architettura Llama-3, in particolare per sequenze fino a 128K token, dimostrando la sua scalabilità e capacità nella gestione di contesti lunghi.
L'architettura ibrida di SAMBA amplifica in modo significativo le sue capacità di richiamo della memoria rispetto ai puri SSM. In test come il Passkey Retrieval, SAMBA ha mostrato un richiamo quasi perfetto fino a 256K di contesto dopo un fine-tuning di sole 500 iterazioni, mentre i modelli basati su SWA hanno faticato oltre i 4K.
Queste prestazioni eccezionali sono attribuite alla combinazione dei punti di forza delle strutture ricorrenti di Mamba per la semantica dipendente dal tempo e delle capacità di recupero della memoria della SWA. Di conseguenza, SAMBA eccelle nei compiti di richiamo della memoria a breve e lungo termine, risultando una soluzione robusta per applicazioni che richiedono un'estesa comprensione del contesto.
Diamo uno sguardo più da vicino alle scelte progettuali e alle strategie specifiche che contribuiscono alle prestazioni notevoli di SAMBA.
SAMBA adotta una sofisticata strategia di ibridazione che combina strati Mamba, SWA e Multi-Layer Perceptron (MLP). Questo approccio ottimizza le prestazioni per il language modeling a lungo contesto sfruttando le proprietà uniche di ciascun componente:
Il paper su SAMBA esplora vari modelli ricorrenti lineari e meccanismi di attenzione per identificare la combinazione più ottimale. Alternative come Multi-Scale Retention e GLA sono state considerate come possibili sostituti di Mamba. Puoi trovare maggiori informazioni sull'architettura Mamba in questa guida introduttiva all'architettura Mamba LLM.
Queste esplorazioni miravano a bilanciare efficienza computazionale e prestazioni nei compiti di language modeling. Il confronto ha rivelato che, sebbene queste alternative offrissero alcuni vantaggi, la combinazione di Mamba con strati SWA e MLP ha raggiunto le migliori prestazioni e scalabilità complessive.
L'analisi dell'entropia delle distribuzioni di attenzione ha fornito insight preziosi sulle prestazioni di SAMBA e di modelli comparabili come Mistral. L'analisi dell'entropia dell'attenzione ha rivelato che SAMBA mantiene un richiamo della memoria più stabile e affidabile su contesti estesi.
Ad esempio, nel compito di Passkey Retrieval, SAMBA ha mostrato un recupero quasi perfetto fino a 256K di contesto, superando nettamente Mistral. L'analisi tramite heatmap ha indicato che l'architettura ibrida di SAMBA gli consente di mantenere un'elevata accuratezza di recupero in diverse posizioni della passkey, a riprova di eccezionali capacità di recupero a lungo raggio.
Data la sua capacità di elaborare efficacemente lunghe sequenze, SAMBA apre un'ampia gamma di potenziali applicazioni.
La capacità di SAMBA di gestire una lunghezza del contesto illimitata apre possibilità significative per vari compiti a lungo contesto. Riesce a mantenere coerenza e pertinenza su sequenze estese, il che lo rende particolarmente adatto ad applicazioni come:
L'architettura di SAMBA è progettata all'insegna dell'efficienza, affrontando i tipici limiti dei modelli puramente basati su attention e su SSM. Tra i principali vantaggi:
Guardando avanti, diverse direzioni di sviluppo promettenti possono potenziare ulteriormente le capacità di SAMBA:
SAMBA rappresenta un importante progresso nel language modeling, offrendo un'architettura ibrida innovativa che combina SSM con SWA scorrevole e strati MLP. Le innovazioni e i vantaggi chiave dell'architettura SAMBA includono l'ibridazione tra SSM e meccanismi di attenzione, l'efficienza nella gestione di contesti lunghi e un richiamo della memoria potenziato.
Pur avendo concluso la nostra esplorazione dell'architettura SAMBA, un ottimo modo per approfondirne la comprensione è sperimentare con l'implementazione disponibile su GitHub.
Se vuoi saperne di più sulle ultime innovazioni nell'AI, ti consiglio questi post del blog:
Impara l'AI con questi corsi!
Corso
Programma
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



