Last chance! 50% off DataCamp Premium
Sale ends in
OpenAI के ChatGPT और Anthropic के Claude जैसे उन्नत मॉडलों का नियमित उपयोगकर्ता होने के नाते, मैंने प्रत्यक्ष रूप से देखा है कि इनपुट प्रॉम्प्ट लंबाई बढ़ने पर उनका प्रदर्शन कैसे घटता है, जिसके कारण लंबे पाठ पर सामंजस्य और प्रासंगिकता बनाए रखने में दिक्कतें आती हैं।
इन सीमाओं को दूर करने के लिए, Microsoft और University of Illinois के शोधकर्ताओं ने SAMBA—एक नया हाइब्रिड आर्किटेक्चर—पेश किया है जो स्टेट स्पेस मॉडल्स (SSMs) को स्लाइडिंग विंडो अटेंशन (SWA) के साथ संयोजित करता है।
इनका दृष्टिकोण SSMs की ताकत—जो दीर्घकालिक निर्भरताओं को अच्छी तरह संभालते हैं—और SWA की क्षमता—जो संदर्भ विंडो को संभालते हुए गणनात्मक जटिलता को नियंत्रित रखती है—दोनों का लाभ उठाता है। इन तकनीकों को जोड़कर, SAMBA व्यावहारिक रूप से असीमित संदर्भ लंबाई के साथ कुशल भाषा मॉडलिंग प्राप्त करता है।
इस लेख में, हम SAMBA के आर्किटेक्चर और लंबे पाठ खंडों को संदर्भ खोए बिना संभालने की इसकी विशिष्ट क्षमता का अन्वेषण करेंगे। हम यह भी रेखांकित करेंगे कि विस्तारित अनुक्रमों के प्रसंस्करण और निर्माण में यह भाषा मॉडलों की क्षमताओं को कैसे महत्वपूर्ण रूप से बढ़ाता है, जिससे भाषा मॉडलिंग में नया मानक स्थापित होता है।
यह समझने के लिए कि SAMBA इतना नवाचारी क्यों है, पहले यह समझना होगा कि पारंपरिक भाषा मॉडल लंबे पाठ अनुक्रमों के साथ किन चुनौतियों का सामना करते हैं।
पारंपरिक ट्रांसफॉर्मर-आधारित मॉडल बेहद शक्तिशाली होने के बावजूद, संदर्भ लंबाई के संबंध में उनकी द्विघात (quadratic) जटिलता के कारण लंबी टेक्स्ट श्रृंखलाओं से निपटने में बड़ी चुनौतियों का सामना करते हैं। यह द्विघात जटिलता सेल्फ-अटेंशन तंत्र से उत्पन्न होती है, जिसमें अनुक्रम का हर टोकन बाकी सभी टोकनों पर ध्यान देता है।
नतीजतन, अनुक्रम की लंबाई बढ़ने के साथ गणनात्मक और मेमोरी लागत बहुत तेजी से बढ़ती है, जिससे बहुत लंबे पाठों को संसाधित करने वाले कार्यों के लिए ये मॉडल अव्यावहारिक हो जाते हैं।
यह सीमा अक्सर हमें इनपुट को ट्रंकेट करने या उपलब्ध हार्डवेयर की पाबंदियों में फिट बैठाने के लिए अन्य, कम-उपयुक्त रणनीतियाँ अपनाने पर मजबूर करती है। अंततः, यह समझौता विस्तारित अनुक्रमों पर मॉडल की कार्यक्षमता बनाए रखने की क्षमता को घटाता है—एक चुनौती जिसका सामना मुझे तब करना पड़ा जब मैं लंबे दस्तावेज़ों को संसाधित करने वाले एक अनुप्रयोग का विकास कर रहा था।
स्टेट स्पेस मॉडल्स (SSMs) रैखिक (linear) जटिलता के साथ एक विकल्प प्रदान करते हैं, जिससे वे लंबे अनुक्रमों को संभालने के लिए गणनात्मक रूप से अधिक कुशल होते हैं। SSMs एक विकसित होती हुई स्टेट बनाए रखते हैं, जो उन्हें ट्रांसफॉर्मर्स की निषेधात्मक लागत के बिना विस्तृत निर्भरताएँ संभालने देता है।
हालाँकि, SSMs की भी सीमाएँ हैं। उनकी मार्कोवियन प्रकृति—जहाँ वर्तमान स्टेट केवल पिछली स्टेट पर निर्भर होती है—के कारण वे अक्सर लंबी श्रृंखलाओं में मेमोरी रिकॉल के साथ संघर्ष करते हैं। यह सीमित मेमोरी रिकॉल व्यापक संदर्भ मॉडलिंग में उनकी प्रभावशीलता घटा देता है, विशेषकर उन अनुप्रयोगों में जिन्हें अनुक्रम के बहुत पहले की जानकारी को सहेजना और संदर्भित करना होता है।
ट्रांसफॉर्मर्स और SSMs—दोनों की ताकतों और कमज़ोरियों—को देखते हुए, ऐसे हाइब्रिड दृष्टिकोणों की स्पष्ट आवश्यकता है जो दोनों के लाभों का उपयोग करें और उनकी सीमाएँ कम करें। SSMs को अटेंशन तंत्र के साथ जोड़ना एक आशाजनक समाधान प्रस्तुत करता है।
यह हाइब्रिड दृष्टिकोण SSMs की दक्षता और लंबी दूरी की निर्भरता-सम्बंधी गुणों को ट्रांसफॉर्मर्स के गतिशील और केंद्रित अटेंशन तंत्र के साथ मिलाता है। इन दोनों विधियों के एकीकरण से हम ऐसा मॉडल बना सकते हैं जो बेहतर मेमोरी रिकॉल और संदर्भात्मक समझ के साथ लंबे अनुक्रमों को सहजता से संसाधित करे।
SAMBA इस संदर्भ बॉटलनेक का सुंदर समाधान प्रस्तुत करता है, दो अलग-अलग दृष्टिकोणों की ताकतों को मिलाकर।
SAMBA के पीछे का मूल विचार Mamba—जो एक SSM है—को SwiGLU और स्लाइडिंग विंडो अटेंशन (SWA) लेयर्स के साथ इंटरलीव करना है। यह हाइब्रिड संरचना आवर्ती संरचनाएँ और सटीक मेमोरी पुनर्प्राप्ति, दोनों को कैप्चर करती है।
SAMBA इस दृष्टिकोण का उदाहरण है, जो SSMs और अटेंशन तंत्र की ताकतों को मिलाकर लंबी संदर्भित जानकारी का प्रबंधन करता है और विस्तृत जानकारी सहेजता है।
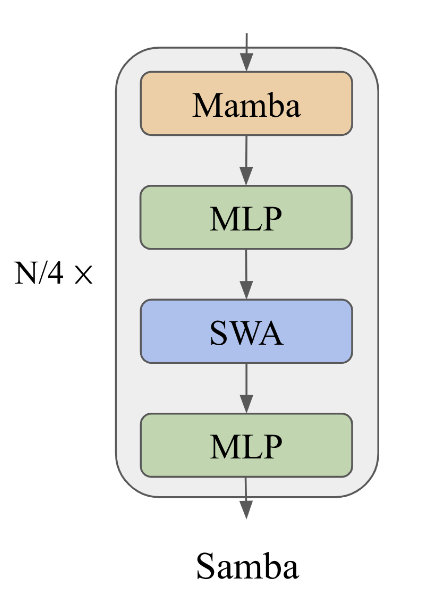
SAMBA आर्किटेक्चर दर्शाने वाला आरेख। स्रोत: Ren et. al (2024)
SAMBA में Mamba लेयर्स समय-निर्भर सैमांटिक्स को कैप्चर करने में दक्ष हैं और अनुक्रमिक डेटा संभालने के लिए एक सुदृढ़ ढांचा प्रदान करती हैं। ये लेयर्स डेटा के भीतर समयानुक्रमिक निर्भरताओं को प्रतिबिंबित करने वाली स्टेट को बनाए रखकर और अपडेट करके कार्य करती हैं।
Mamba यह कार्य चयनात्मक स्टेट स्पेस का उपयोग करके करता है, जो मॉडल को प्रासंगिक इनपुट पर ध्यान केंद्रित करने और लंबे अनुक्रमों में महत्वपूर्ण जानकारी बनाए रखने देता है। यह चयनात्मक गेटिंग तंत्र तेज डिकोडिंग के लिए महत्वपूर्ण है और सुनिश्चित करता है कि मॉडल न्यूनतम गणनात्मक ओवरहेड के साथ उच्च सटीकता से अनुक्रमिक पैटर्नों की व्याख्या और भविष्यवाणी कर सके।
स्लाइडिंग विंडो अटेंशन लेयर्स सीमित संदर्भ विंडो के भीतर जटिल, गैर-मार्कोवियन निर्भरताओं को संबोधित करके Mamba लेयर्स का पूरक बनती हैं। SWA एक ऐसी विंडो साइज पर काम करता है जो इनपुट अनुक्रम पर स्लाइड करती है, जिससे रैखिक गणनात्मक जटिलता सुनिश्चित होती है।
यह मॉडल को मध्यम से अल्पकालीन इतिहास से उच्च-परिभाषा संकेत पुनर्प्राप्त करने देता है, जिन्हें Mamba की आवर्ती स्टेट्स कैप्चर नहीं कर सकतीं। अपना फोकस गतिशील रूप से समायोजित करके, SWA लेयर्स मॉडल को सामंजस्य और संदर्भ बनाए रखने में सक्षम बनाती हैं, खासकर उन कार्यों के लिए जिनमें लंबी इनपुट पर संदर्भानुकूल प्रतिक्रियाएँ आवश्यक होती हैं।
SAMBA में SwiGLU लेयर्स गैर-रैखिक रूपांतरण को सक्षम करती हैं और ज्ञान रिकॉल को बढ़ाती हैं। ये लेयर्स मॉडल में नॉन-लिनियरिटी जोड़ती हैं, जिससे डेटा के भीतर अधिक जटिल पैटर्न और अंतःक्रियाएँ कैप्चर की जा सकें।
इसके अलावा, SwiGLU लेयर्स मॉडल की सूचना संसाधित करने और याद रखने की क्षमता सुनिश्चित करती हैं, जिससे इसकी मजबूती और बहुमुखी प्रतिभा बढ़ती है। यह गैर-रैखिक रूपांतरण प्रशिक्षण डेटा से वास्तविक दुनिया के अनुप्रयोगों तक सामान्यीकरण करने की मॉडल की क्षमता के लिए आवश्यक है।
SAMBA के आर्किटेक्चर का अन्वेषण करने के बाद, अब इसके प्रदर्शन और दक्षता की तुलना अन्य मॉडलों से करते हैं।
SAMBA विभिन्न भाषा समझ और तर्क-बुद्धि बेंचमार्क्स पर अच्छा प्रदर्शन दर्शाता है, और शुद्ध अटेंशन-आधारित तथा शुद्ध SSM-आधारित दोनों प्रकार के मॉडलों से बेहतर साबित होता है। विशेष रूप से, SAMBA का MMLU, GSM8K, और HumanEval जैसे कार्यों पर मूल्यांकन किया गया है, जहाँ इसे MMLU पर 71.2, GSM8K पर 69.6, और HumanEval पर 54.9 का स्कोर मिला।
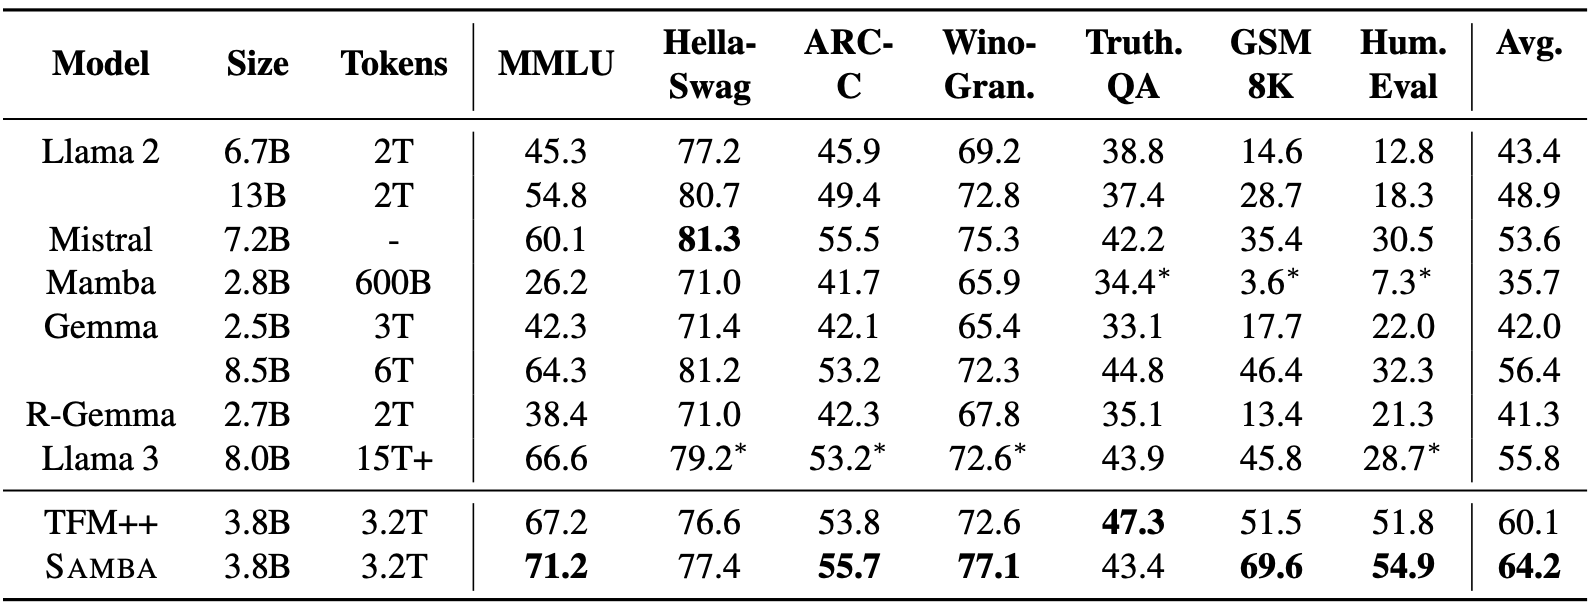
स्रोत: Ren et. al (2024)
ये परिणाम अन्य अत्याधुनिक मॉडलों—जैसे TFM++ और Llama-3—से उल्लेखनीय रूप से बेहतर हैं, जो विविध भाषा-समझ कार्यों को संभालने में SAMBA की क्षमता दर्शाते हैं। उदाहरण के लिए, GSM8K में SAMBA ने TFM++ की तुलना में 18.1% अधिक सटीकता हासिल की, जो SSM और अटेंशन तंत्र को जोड़ने वाली इसकी हाइब्रिड आर्किटेक्चर की दक्षता को रेखांकित करता है।
SAMBA की सबसे उल्लेखनीय विशेषताओं में से एक है, दक्षता बनाए रखते हुए कहीं अधिक लंबी संदर्भ लंबाइयों को संभालने की क्षमता। 4K लंबाई के अनुक्रमों पर प्री-ट्रेन होने के बावजूद, SAMBA बेहतर परप्लेक्सिटी के साथ 1M टोकनों तक एक्स्ट्रापोलेट कर सकता है और फिर भी डिकोडिंग समय जटिलता को रैखिक बनाए रखता है।
यह Mamba के चयनात्मक स्टेट स्पेस को SWA के साथ लेयर-वाइज़ संयोजन के माध्यम से संभव होता है, जिससे मॉडल द्विघात गणनात्मक जटिलता के बिना उच्च प्रदर्शन बनाए रखता है।
व्यावहारिक रूप से, SAMBA ने Llama-3 आर्किटेक्चर की तुलना में 3.64X तेज डिकोडिंग थ्रूपुट हासिल किया है, खासकर 128K टोकनों तक की श्रृंखलाओं के लिए, जो लंबे संदर्भों को संसाधित करने में इसकी स्केलेबिलिटी और क्षमता दर्शाता है।
SAMBA का हाइब्रिड आर्किटेक्चर शुद्ध SSMs की तुलना में इसकी मेमोरी रिकॉल क्षमताओं को काफी बढ़ा देता है। Passkey Retrieval जैसे परीक्षणों में, केवल 500 स्टेप्स के फाइन-ट्यूनिंग के बाद SAMBA ने 256K संदर्भ लंबाई तक लगभग पूर्ण मेमोरी रिकॉल दिखाया, जबकि केवल SWA-आधारित मॉडल 4K से आगे संघर्ष करते रहे।
यह असाधारण प्रदर्शन Mamba की समय-निर्भर सैमांटिक्स के लिए आवर्ती संरचनाओं और SWA की मेमोरी पुनर्प्राप्ति क्षमताओं की संयुक्त ताकत के कारण संभव है। नतीजतन, SAMBA अल्पकालिक और दीर्घकालिक—दोनों—मेमोरी रिकॉल कार्यों में उत्कृष्ट है, जो व्यापक संदर्भ समझ की आवश्यकता वाले अनुप्रयोगों के लिए इसे एक सुदृढ़ समाधान बनाता है।
अब उन विशिष्ट डिज़ाइन विकल्पों और रणनीतियों पर गहराई से नज़र डालते हैं जो SAMBA के प्रभावशाली प्रदर्शन में योगदान देती हैं।
SAMBA एक परिष्कृत हाइब्रिडाइज़ेशन रणनीति अपनाता है जो Mamba, SWA और मल्टी-लेयर परसेप्ट्रॉन (MLP) लेयर्स को जोड़ती है। यह दृष्टिकोण प्रत्येक घटक के विशिष्ट गुणों का लाभ उठाकर लंबा-संदर्भ भाषा मॉडलिंग के लिए प्रदर्शन का अनुकूलन करता है:
SAMBA पेपर ने सबसे उपयुक्त संयोजन की पहचान करने के लिए विभिन्न रैखिक आवर्ती मॉडलों और अटेंशन तंत्रों का अन्वेषण किया। Multi-Scale Retention और GLA जैसे विकल्पों को Mamba के संभावित प्रतिस्थापन के रूप में देखा गया। आप Mamba आर्किटेक्चर के बारे में अधिक जानकारी इस Mamba LLM आर्किटेक्चर परिचय गाइड में पा सकते हैं।
इन अन्वेषणों का उद्देश्य भाषा मॉडलिंग कार्यों में गणनात्मक दक्षता और प्रदर्शन के बीच संतुलन बनाना था। तुलना से पता चला कि यद्यपि इन विकल्पों से कुछ लाभ मिले, Mamba को SWA और MLP लेयर्स के साथ जोड़ने से समग्र प्रदर्शन और स्केलेबिलिटी सबसे बेहतर प्राप्त हुई।
अटेंशन वितरणों की एंट्रॉपी का विश्लेषण करने से SAMBA और Mistral जैसे तुलनीय मॉडलों के प्रदर्शन पर मूल्यवान अंतर्दृष्टियाँ मिलीं। अटेंशन एंट्रॉपी विश्लेषण से पता चला कि SAMBA विस्तारित संदर्भों पर अधिक स्थिर और विश्वसनीय मेमोरी रिकॉल बनाए रखता है।
उदाहरण के लिए, Passkey Retrieval कार्य में, SAMBA ने 256K संदर्भ लंबाइयों तक लगभग पूर्ण रिकॉल प्रदर्शित किया, जो Mistral से काफी बेहतर था। हीटमैप विश्लेषण से संकेत मिला कि SAMBA की हाइब्रिड आर्किटेक्चर उसे विभिन्न पास-की स्थितियों में उच्च पुनर्प्राप्ति सटीकता बनाए रखने देता है, जो इसकी असाधारण लंबी-दूरी पुनर्प्राप्ति क्षमताओं को रेखांकित करता है।
लंबे अनुक्रमों को प्रभावी ढंग से संसाधित करने की क्षमता को देखते हुए, SAMBA कई संभावित अनुप्रयोगों के द्वार खोलता है।
SAMBA की असीमित संदर्भ लंबाई संभालने की क्षमता विभिन्न लंबे-संदर्भ कार्यों के लिए बड़ी संभावनाएँ खोलती है। यह विस्तृत अनुक्रमों पर सामंजस्य और प्रासंगिकता बनाए रख सकता है, जिससे यह विशेष रूप से निम्नलिखित अनुप्रयोगों के लिए उपयुक्त बनता है:
SAMBA का आर्किटेक्चर दक्षता को ध्यान में रखकर बनाया गया है और शुद्ध अटेंशन-आधारित तथा शुद्ध SSM-आधारित मॉडलों—दोनों—की सामान्य सीमाओं को संबोधित करता है। कुछ प्रमुख लाभ हैं:
आगे देखते हुए, भविष्य के कार्य के कई रोमांचक मार्ग SAMBA की क्षमताओं को और विकसित कर सकते हैं:
SAMBA भाषा मॉडलिंग में एक महत्वपूर्ण प्रगति का प्रतिनिधित्व करता है, जो SSMs को Sliding SWA और MLP लेयर्स के साथ मिलाने वाला एक नया हाइब्रिड आर्किटेक्चर प्रस्तुत करता है। SAMBA आर्किटेक्चर के प्रमुख नवाचार और लाभों में SSM और अटेंशन तंत्र का हाइब्रिडाइज़ेशन, लंबे संदर्भों को संभालने में दक्षता, और बेहतर मेमोरी रिकॉल शामिल हैं।
यद्यपि SAMBA आर्किटेक्चर की हमारी यह पड़ताल यहीं समाप्त होती है, फिर भी इसकी बारीकियों और नवाचारों को गहराई से समझने का बेहतरीन तरीका है GitHub पर उपलब्ध इम्प्लिमेंटेशन के साथ प्रयोग करना।
यदि आप नवीनतम AI नवाचारों के बारे में और सीखना चाहते हैं, तो मैं ये ब्लॉग पोस्ट सुझाता/सुझाती हूँ:
इन कोर्सों के साथ AI सीखें!
कोर्स
लर्निंग पाथ
कोर्स