Kurs
KI-Lösungen im Unternehmen implementieren
2 Std.
54.8K
Als jemand, der regelmäßig fortgeschrittene Modelle wie OpenAI’s ChatGPT und Anthropic's Claude nutzt, habe ich aus erster Hand beobachtet, wie die Leistung mit zunehmender Promptlänge nachlässt – Kohärenz und Relevanz leiden spürbar bei sehr langen Eingaben.
Um diese Grenzen zu überwinden, stellen Forschende von Microsoft und der University of Illinois SAMBA vor – eine neuartige Hybrid-Architektur, die State-Space-Modelle (SSMs) mit Sliding Window Attention (SWA) kombiniert.
Der Ansatz nutzt die Stärken beider Welten: SSMs sind hervorragend beim Umgang mit langfristigen Abhängigkeiten, während SWA kontextbezogene Fenster effizient handhabt und die Rechenkomplexität beherrschbar hält. Durch die Verbindung beider Techniken erreicht SAMBA effizientes Language Modeling mit praktisch unbegrenzter Kontextlänge.
In diesem Beitrag schauen wir uns die Architektur von SAMBA an und warum sie lange Textspannen verarbeiten kann, ohne den roten Faden zu verlieren. Außerdem zeigen wir, wie SAMBA die Fähigkeiten von Sprachmodellen beim Verarbeiten und Generieren langer Sequenzen spürbar erweitert – ein neuer Maßstab im Language Modeling.
Um zu verstehen, warum SAMBA so innovativ ist, müssen wir zunächst die Herausforderungen klassischer Sprachmodelle bei langen Textsequenzen beleuchten.
Klassische Transformer-basierte Modelle sind zwar extrem leistungsfähig, stoßen bei langen Sequenzen jedoch an Grenzen – vor allem wegen der quadratischen Komplexität in Bezug auf die Kontextlänge. Diese entsteht durch den Self-Attention-Mechanismus, bei dem jedes Token auf alle anderen Token der Sequenz achtet.
Die Rechen- und Speicheranforderungen steigen dadurch mit der Sequenzlänge rapide an – für sehr lange Texte wird das unpraktikabel.
Oft müssen wir Eingaben kürzen oder andere suboptimale Workarounds nutzen, um Hardwaregrenzen einzuhalten. Diese Kompromisse schwächen die Leistung über lange Sequenzen – eine Herausforderung, die mir bei der Entwicklung einer Anwendung begegnete, die umfangreiche Dokumente verarbeiten muss.
State-Space-Modelle (SSMs) bieten mit linearer Komplexität eine effiziente Alternative für lange Sequenzen. Sie halten einen sich entwickelnden Zustand vor und können dadurch weite Abhängigkeiten ohne den prohibitiv hohen Aufwand von Transformern abbilden.
Allerdings haben SSMs Grenzen: Durch ihre Markov-Eigenschaft – der aktuelle Zustand hängt nur vom vorherigen ab – fällt ihnen die exakte Erinnerung über sehr lange Distanzen schwer. Das schmälert ihre Eignung für eine umfassende Kontextmodellierung, vor allem wenn Informationen aus weit zurückliegenden Teilen der Sequenz zuverlässig behalten und referenziert werden müssen.
Angesichts der Stärken und Schwächen von Transformern und SSMs liegt es nahe, Hybridansätze zu verfolgen, die die Vorteile beider vereinen und ihre Nachteile abfedern. Die Kombination von SSMs mit Aufmerksamkeitsmechanismen ist hier besonders vielversprechend.
Dieser hybride Ansatz nutzt die Effizienz und Langstreckeneigenschaften von SSMs zusammen mit der dynamischen, fokussierten Aufmerksamkeit von Transformern. So entsteht ein Modell, das lange Sequenzen reibungslos verarbeitet – mit besserer Merkfähigkeit und tieferem Kontextverständnis.
SAMBA bietet eine elegante Lösung für den Kontext-Flaschenhals, indem es die Stärken zweier Ansätze vereint.
Die Kernidee hinter SAMBA ist, Mamba, ein SSM, mit SwiGLU- und Sliding-Window-Attention-(SWA)-Schichten zu verschachteln. Diese Hybridstruktur erfasst rekurrente Muster und ermöglicht zugleich präzisen Abruf aus dem Gedächtnis.
SAMBA demonstriert diesen Ansatz, indem es die Stärken von SSMs und Attention-Mechanismen kombiniert, um lange Kontexte zu bewältigen und dennoch Detailwissen zu behalten.
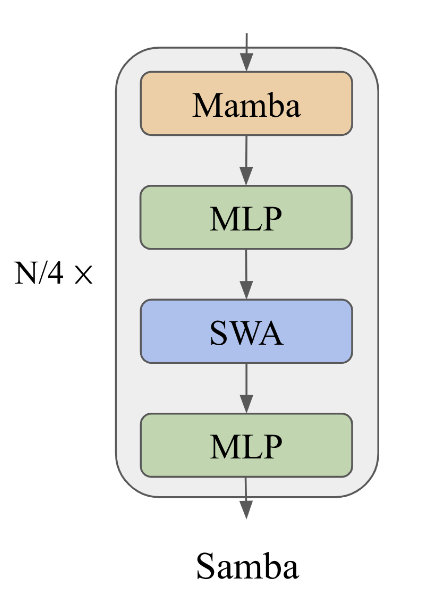
Ein Diagramm, das die SAMBA-Architektur illustriert. Quelle: Ren et al. (2024)
Mamba-Schichten in SAMBA erfassen zeitabhängige Semantik und bilden ein robustes Fundament für sequenzielle Daten. Sie halten und aktualisieren einen Zustand, der die zeitlichen Abhängigkeiten in den Daten widerspiegelt.
Mamba erreicht dies über selektive Zustandsräume, die es dem Modell erlauben, sich auf relevante Eingaben zu konzentrieren und wichtige Informationen über lange Sequenzen hinweg zu bewahren. Dieser selektive Gate-Mechanismus ist entscheidend für schnelles Decoding und sorgt dafür, dass das Modell Sequenzmuster mit hoher Genauigkeit und minimalem Rechenaufwand interpretieren und vorhersagen kann.
Sliding-Window-Attention-Schichten ergänzen die Mamba-Schichten, indem sie komplexe, nicht-markovsche Abhängigkeiten innerhalb eines begrenzten Kontextfensters adressieren. SWA arbeitet mit einem Fenster, das über die Eingabesequenz gleitet und so lineare Rechenkomplexität sicherstellt.
Dadurch kann das Modell hochauflösende Signale aus der mittleren bis kurzfristigen Historie abrufen, die rekurrente Zustände von Mamba nicht erfassen. Indem SWA seinen Fokus dynamisch anpasst, hält das Modell Kohärenz und Kontext – insbesondere bei Aufgaben, die über lange Eingaben hinweg relevante Antworten erfordern.
SwiGLU-Schichten in SAMBA sorgen für nichtlineare Transformationen und stärken den Wissensabruf. Die eingeführte Nichtlinearität ermöglicht es, komplexere Muster und Wechselwirkungen in den Daten zu erfassen.
Zugleich fördern SwiGLU-Schichten die Verarbeitung und den Abruf von Informationen und erhöhen so die Robustheit und Vielseitigkeit des Modells. Diese nichtlinearen Transformationen sind zentral, damit das Modell vom Training auf reale Anwendungen generalisieren kann.
Nachdem wir die Architektur beleuchtet haben, schauen wir auf Leistung und Effizienz im Vergleich zu anderen Modellen.
SAMBA zeigt solide Ergebnisse über verschiedene Benchmarks zu Sprachverständnis und Schlussfolgern und übertrifft sowohl reine Attention- als auch reine SSM-Modelle. Insbesondere wurde SAMBA auf Aufgaben wie MMLU, GSM8K und HumanEval evaluiert und erzielte 71,2 bei MMLU, 69,6 bei GSM8K und 54,9 bei HumanEval.
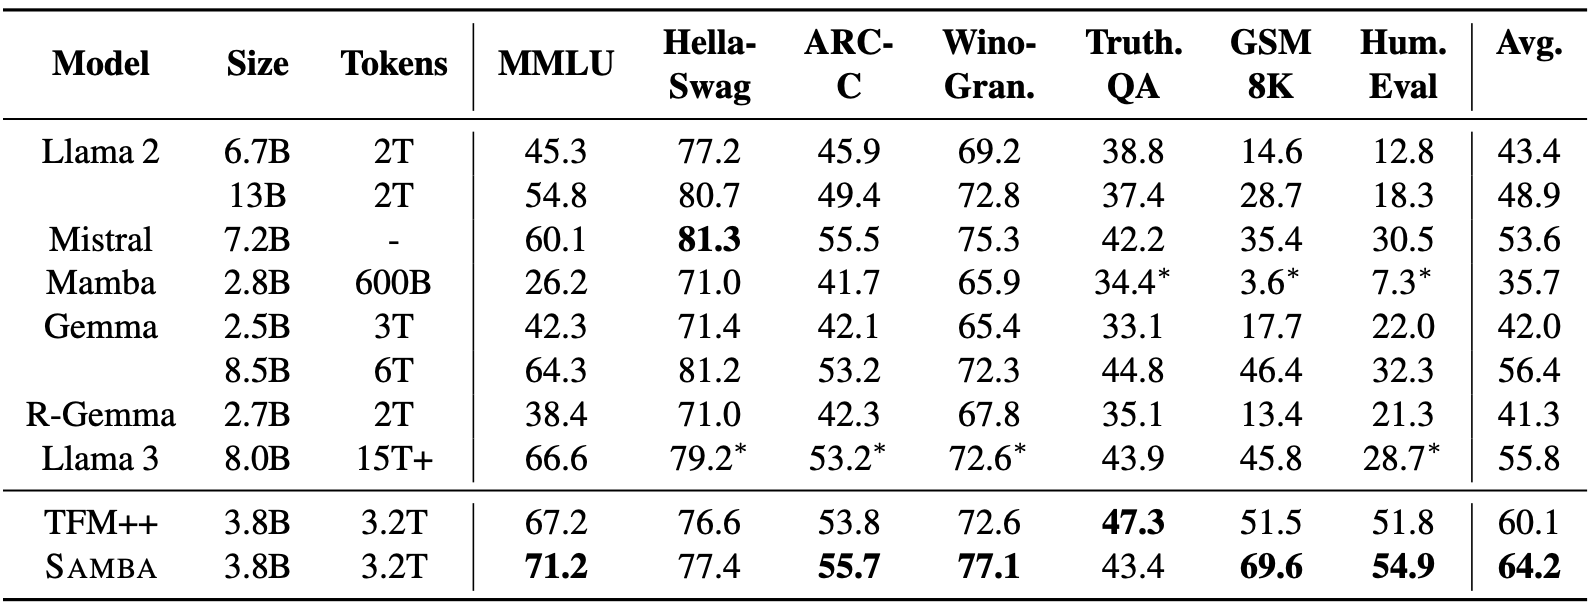
Quelle: Ren et al. (2024)
Diese Ergebnisse liegen deutlich über denen anderer Spitzenmodelle wie TFM++ und Llama-3 und belegen SAMBAs Stärke bei vielfältigen Verständnisaufgaben. So erzielte SAMBA bei GSM8K eine um 18,1 % höhere Genauigkeit als TFM++ – ein Beleg für die Leistungsfähigkeit der Hybridarchitektur aus SSM und Attention.
Eines der auffälligsten Merkmale von SAMBA ist die Fähigkeit, deutlich längere Kontexte effizient zu verarbeiten. Obwohl das Modell auf Sequenzen mit 4K Länge vortrainiert wurde, kann SAMBA bis zu 1 Mio. Tokens extrapolieren – mit verbesserter Perplexity und weiterhin linearer Decoding-Komplexität.
Ermöglicht wird dies durch die schichtweise Kombination aus Mambas selektiven Zustandsräumen und SWA, wodurch hohe Leistung ohne quadratische Rechenkomplexität erhalten bleibt.
In der Praxis erreicht SAMBA eine 3,64-fach höhere Decoding-Durchsatzrate als die Llama-3-Architektur – insbesondere bei Sequenzen bis 128K Tokens. Das unterstreicht Skalierbarkeit und Leistungsfähigkeit bei langen Kontexten.
Die Hybridarchitektur von SAMBA verstärkt die Merkfähigkeit gegenüber reinen SSMs deutlich. In Tests wie Passkey Retrieval erreichte SAMBA nach nur 500 Fine-Tuning-Schritten nahezu perfekte Abrufe bis zu 256K Kontextlänge, während SWA-basierte Modelle jenseits von 4K ins Straucheln gerieten.
Diese außergewöhnliche Leistung beruht auf der Kombination aus Mambas rekurrenten Strukturen für zeitabhängige Semantik und SWAs Abruffähigkeiten. So überzeugt SAMBA bei kurz- und langfristigen Gedächtnisaufgaben – ideal für Anwendungen mit großem Kontextbedarf.
Werfen wir einen genaueren Blick auf die Designentscheidungen und Strategien, die zu SAMBAs starker Leistung beitragen.
SAMBA setzt auf eine ausgefeilte Hybridisierung aus Mamba-, SWA- und Multi-Layer-Perceptron-(MLP)-Schichten. So wird das Language Modeling für lange Kontexte optimiert, indem die jeweiligen Stärken genutzt werden:
Das SAMBA-Paper untersucht verschiedene lineare rekurrente Modelle und Aufmerksamkeitsmechanismen, um die optimale Kombination zu finden. Als mögliche Alternativen zu Mamba wurden etwa Multi-Scale Retention und GLA betrachtet. Mehr Details zur Mamba-Architektur findest du in dieser Einführung in die Mamba-LLM-Architektur.
Ziel dieser Untersuchungen war es, Recheneffizienz und Leistung im Language Modeling auszubalancieren. Der Vergleich zeigte: Trotz gewisser Vorteile der Alternativen liefert die Kombination aus Mamba, SWA und MLP in Summe die beste Leistung und Skalierbarkeit.
Die Analyse der Entropie von Aufmerksamkeitsverteilungen liefert wichtige Einblicke in die Leistung von SAMBA und Modellen wie Mistral. Sie zeigt, dass SAMBA über lange Kontexte hinweg stabiler und zuverlässiger erinnert.
Beim Passkey-Retrieval etwa erreicht SAMBA nahezu perfekte Abrufe bis 256K Kontextlänge und übertrifft Mistral deutlich. Heatmaps verdeutlichen, dass die Hybridarchitektur hohe Abrufgenauigkeit über verschiedene Schlüsselpositionen hinweg beibehält – ein starkes Indiz für exzellente Langstrecken-Retrieval-Fähigkeiten.
Dank der effektiven Verarbeitung langer Sequenzen eröffnet SAMBA zahlreiche Einsatzmöglichkeiten.
SAMBAs Fähigkeit zu praktisch unbegrenzter Kontextlänge schafft neue Optionen für Langkontext-Aufgaben. Das Modell bleibt über große Textmengen hinweg kohärent und relevant – ideal für:
Die Architektur von SAMBA ist auf Effizienz ausgelegt und adressiert typische Limitierungen reiner Attention- oder SSM-Modelle. Zentrale Vorteile sind:
Mit Blick nach vorn bieten sich mehrere spannende Entwicklungspfade, um SAMBA weiter zu stärken:
SAMBA markiert einen wichtigen Fortschritt im Language Modeling: eine hybride Architektur, die SSMs mit Sliding SWA und MLP-Schichten verbindet. Zu den zentralen Innovationen zählen die Verknüpfung von SSM und Attention, hohe Effizienz bei langen Kontexten und verbesserter Gedächtnisabruf.
Wenn du tiefer in die Architektur und ihre Neuerungen einsteigen möchtest, probiere die Implementierung auf GitHub aus.
Wenn du mehr über aktuelle KI-Innovationen erfahren willst, empfehle ich diese Blogposts:
Lerne KI mit diesen Kursen!
Kurs
Lernpfad
Kurs