Khóa học
Triển khai Giải pháp AI trong Doanh nghiệp
2 giờ
55.7K
Với tư cách là người thường xuyên sử dụng các mô hình tiên tiến như ChatGPT của OpenAI và Claude của Anthropic, tôi đã trực tiếp quan sát thấy hiệu năng của chúng suy giảm khi độ dài prompt đầu vào tăng lên, dẫn tới khó khăn trong việc duy trì tính mạch lạc và mức độ liên quan trên các văn bản kéo dài.
Để khắc phục những hạn chế này, các nhà nghiên cứu tại Microsoft và Đại học Illinois giới thiệu SAMBA—một kiến trúc lai mới kết hợp mô hình không gian trạng thái (SSM) với chú ý cửa sổ trượt (SWA).
Cách tiếp cận của họ tận dụng điểm mạnh của cả SSM—vốn xuất sắc trong quản lý phụ thuộc dài hạn—và SWA—xử lý cửa sổ ngữ cảnh và duy trì khả năng tính toán khả thi. Bằng cách hợp nhất các kỹ thuật này, SAMBA đạt được mô hình hoá ngôn ngữ hiệu quả với độ dài ngữ cảnh gần như không giới hạn.
Trong bài viết này, chúng ta sẽ khám phá kiến trúc của SAMBA và khả năng độc đáo của nó trong việc xử lý các đoạn văn bản dài mà không đánh mất ngữ cảnh. Chúng tôi cũng nêu bật tiềm năng của SAMBA trong việc tăng cường đáng kể năng lực xử lý và tạo sinh các chuỗi mở rộng, thiết lập tiêu chuẩn mới cho mô hình hoá ngôn ngữ.
Để hiểu vì sao SAMBA mang tính đổi mới, trước tiên cần nắm được những thách thức mà các mô hình ngôn ngữ truyền thống gặp phải khi xử lý các chuỗi văn bản dài.
Các mô hình dựa trên Transformer, dù cực kỳ mạnh mẽ, gặp thách thức lớn khi xử lý chuỗi văn bản dài do độ phức tạp bậc hai theo độ dài ngữ cảnh. Độ phức tạp bậc hai này phát sinh từ cơ chế tự chú ý, vốn yêu cầu mỗi token phải chú ý tới mọi token khác trong chuỗi.
Hệ quả là chi phí tính toán và bộ nhớ tăng nhanh theo độ dài chuỗi, khiến các mô hình này kém thực tiễn cho các tác vụ đòi hỏi xử lý văn bản rất dài.
Hạn chế này thường buộc chúng ta cắt ngắn đầu vào hoặc dùng các chiến lược khác kém tối ưu để phù hợp với phần cứng sẵn có. Cuối cùng, sự đánh đổi này làm giảm khả năng duy trì hiệu năng trên các chuỗi kéo dài—một thách thức tôi từng gặp khi phát triển ứng dụng cần xử lý tài liệu dài.
Các mô hình Không gian Trạng thái (SSM) là một lựa chọn thay thế với độ phức tạp tuyến tính, giúp hiệu quả tính toán hơn khi xử lý chuỗi dài. SSM duy trì một trạng thái tiến hoá, cho phép xử lý các phụ thuộc kéo dài mà không phải chịu chi phí cao như transformer.
Tuy nhiên, SSM cũng có hạn chế. Do tính chất Markov, nơi trạng thái hiện tại chỉ phụ thuộc vào trạng thái trước đó, chúng thường gặp khó trong việc ghi nhớ trên các chuỗi dài. Khả năng ghi nhớ hạn chế này làm giảm hiệu quả trong mô hình hoá ngữ cảnh toàn diện, đặc biệt ở các ứng dụng cần lưu giữ và tham chiếu thông tin từ rất sớm trong chuỗi.
Xét các điểm mạnh và yếu của cả Transformer và SSM, nhu cầu về các cách tiếp cận lai—tận dụng ưu thế của từng bên đồng thời giảm thiểu hạn chế—là rất thuyết phục. Kết hợp SSM với cơ chế chú ý là một lời giải hứa hẹn.
Cách tiếp cận lai này tận dụng hiệu quả và khả năng mô hình hoá phụ thuộc tầm xa của SSM cùng cơ chế chú ý năng động và có trọng tâm của Transformer. Bằng cách tích hợp hai phương pháp, ta có thể tạo ra mô hình xử lý trơn tru chuỗi dài với khả năng ghi nhớ và hiểu ngữ cảnh nâng cao.
SAMBA đưa ra một lời giải thanh nhã cho nút thắt ngữ cảnh, kết hợp điểm mạnh của hai cách tiếp cận khác biệt.
Ý tưởng cốt lõi của SAMBA là xen kẽ Mamba, một SSM, với các lớp SwiGLU và chú ý cửa sổ trượt (SWA). Cấu trúc lai này vừa nắm bắt cấu trúc đệ quy vừa truy xuất bộ nhớ chính xác.
SAMBA là ví dụ điển hình cho cách tiếp cận này khi kết hợp sức mạnh của SSM và cơ chế chú ý để quản lý ngữ cảnh dài đồng thời giữ lại thông tin chi tiết.
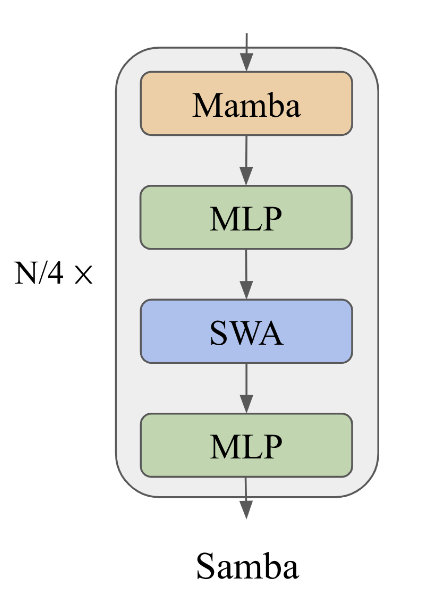
Sơ đồ minh hoạ kiến trúc SAMBA. Nguồn: Ren et. al (2024)
Các lớp Mamba trong SAMBA giỏi nắm bắt ngữ nghĩa phụ thuộc theo thời gian, cung cấp khung vững chắc để xử lý dữ liệu tuần tự. Các lớp này vận hành bằng cách duy trì và cập nhật trạng thái phản ánh các phụ thuộc theo thời gian trong dữ liệu.
Mamba đạt được điều này nhờ sử dụng các không gian trạng thái chọn lọc, cho phép mô hình tập trung vào đầu vào liên quan và duy trì thông tin quan trọng trên các chuỗi dài. Cơ chế cổng chọn lọc này rất quan trọng cho giải mã nhanh, đảm bảo mô hình có thể diễn giải và dự đoán các mẫu tuần tự với độ chính xác cao và chi phí tính toán tối thiểu.
Các lớp chú ý cửa sổ trượt bổ trợ cho lớp Mamba bằng cách xử lý các phụ thuộc phức tạp, phi Markov trong một cửa sổ ngữ cảnh giới hạn. SWA hoạt động với kích thước cửa sổ trượt trên chuỗi đầu vào, đảm bảo độ phức tạp tính toán tuyến tính.
Điều này cho phép mô hình truy xuất các tín hiệu độ phân giải cao từ lịch sử trung hạn đến ngắn hạn mà trạng thái đệ quy của Mamba không thể nắm bắt. Bằng cách điều chỉnh trọng tâm một cách linh hoạt, các lớp SWA giúp mô hình duy trì mạch lạc và ngữ cảnh, đặc biệt hữu ích cho các tác vụ đòi hỏi phản hồi phù hợp ngữ cảnh trên đầu vào dài.
Các lớp SwiGLU trong SAMBA hỗ trợ biến đổi phi tuyến và tăng cường khả năng truy hồi kiến thức. Những lớp này đưa tính phi tuyến vào mô hình, giúp nắm bắt các mẫu và tương tác phức tạp trong dữ liệu.
Hơn nữa, các lớp SwiGLU đảm bảo mô hình có thể xử lý và ghi nhớ thông tin, đóng góp vào độ vững và tính linh hoạt. Biến đổi phi tuyến này thiết yếu cho khả năng khái quát hoá từ dữ liệu huấn luyện sang ứng dụng thực tế.
Sau khi tìm hiểu kiến trúc của SAMBA, hãy cùng xem xét hiệu năng và hiệu quả của nó so với các mô hình khác.
SAMBA thể hiện hiệu năng tốt trên nhiều bộ đánh giá hiểu biết và suy luận ngôn ngữ, vượt trội cả các mô hình thuần chú ý và thuần SSM. Cụ thể, SAMBA được đánh giá trên các tác vụ như MMLU, GSM8K và HumanEval, đạt điểm 71,2 cho MMLU, 69,6 cho GSM8K và 54,9 cho HumanEval.
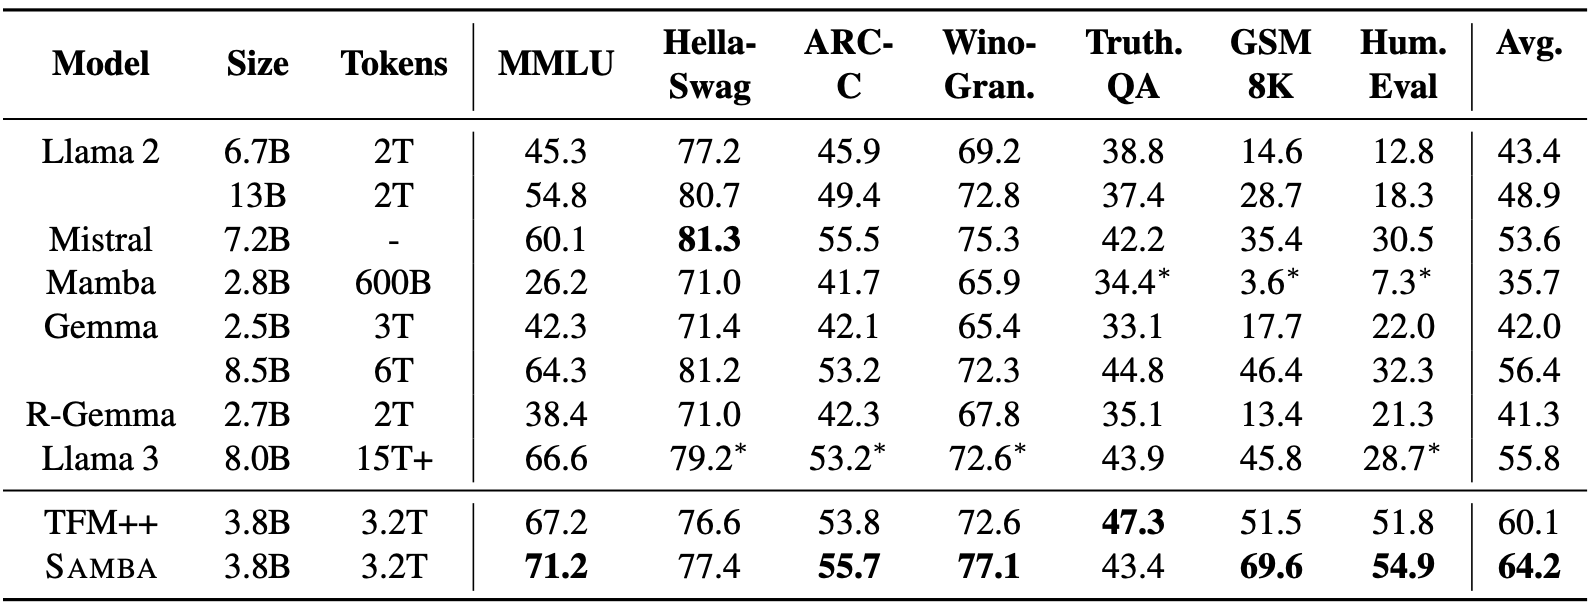
Nguồn: Ren et. al (2024)
Những kết quả này vượt xa các mô hình tiên tiến khác, bao gồm TFM++ và Llama-3, cho thấy khả năng của SAMBA trong xử lý đa dạng các tác vụ hiểu ngôn ngữ. Chẳng hạn, SAMBA đạt độ chính xác cao hơn 18,1% trong GSM8K so với TFM++, nhấn mạnh hiệu quả của kiến trúc lai kết hợp SSM với cơ chế chú ý.
Một trong những điểm nổi bật nhất của SAMBA là khả năng xử lý độ dài ngữ cảnh lớn hơn nhiều trong khi vẫn duy trì hiệu quả. Dù được tiền huấn luyện trên chuỗi dài 4K, SAMBA có thể ngoại suy lên tới 1M token với perplexity được cải thiện và vẫn giữ độ phức tạp thời gian giải mã tuyến tính.
Điều này đạt được nhờ kết hợp theo tầng các không gian trạng thái chọn lọc của Mamba với SWA, cho phép mô hình duy trì hiệu năng cao mà không cần chi phí tính toán bậc hai.
Trong thực tiễn, SAMBA đạt thông lượng giải mã nhanh hơn 3,64 lần so với kiến trúc Llama-3, đặc biệt với các chuỗi dài tới 128K token, minh chứng khả năng mở rộng và năng lực xử lý ngữ cảnh dài.
Kiến trúc lai của SAMBA tăng cường đáng kể khả năng ghi nhớ so với các SSM thuần. Trong các bài kiểm tra như Passkey Retrieval, SAMBA cho thấy khả năng ghi nhớ gần như hoàn hảo đến độ dài ngữ cảnh 256K sau khi tinh chỉnh chỉ 500 bước, trong khi các mô hình dựa trên SWA gặp khó vượt quá 4K.
Hiệu năng vượt trội này đến từ sức mạnh kết hợp giữa cấu trúc đệ quy của Mamba cho ngữ nghĩa phụ thuộc thời gian và khả năng truy xuất bộ nhớ của SWA. Nhờ đó, SAMBA xuất sắc ở cả tác vụ ghi nhớ ngắn hạn lẫn dài hạn, là giải pháp vững chắc cho các ứng dụng đòi hỏi hiểu ngữ cảnh sâu rộng.
Hãy xem xét kỹ hơn các lựa chọn thiết kế và chiến lược cụ thể góp phần vào hiệu năng ấn tượng của SAMBA.
SAMBA áp dụng chiến lược lai hoá tinh vi kết hợp các lớp Mamba, SWA và MLP (mạng perceptron nhiều lớp). Cách tiếp cận này tối ưu hiệu năng cho mô hình hoá ngôn ngữ ngữ cảnh dài bằng cách tận dụng đặc tính riêng của từng thành phần:
Bài báo SAMBA khảo sát nhiều mô hình hồi quy tuyến tính và cơ chế chú ý để xác định tổ hợp tối ưu. Các phương án như Multi-Scale Retention và GLA được cân nhắc như những thay thế tiềm năng cho Mamba. Bạn có thể tìm hiểu thêm về kiến trúc Mamba trong hướng dẫn giới thiệu về kiến trúc Mamba LLM
Những khảo sát này nhằm cân bằng giữa hiệu quả tính toán và hiệu năng trong các tác vụ mô hình hoá ngôn ngữ. So sánh cho thấy dù các lựa chọn thay thế mang lại một số lợi ích, sự kết hợp Mamba với các lớp SWA và MLP đạt hiệu năng và khả năng mở rộng tổng thể tốt nhất.
Phân tích entropy của phân bố chú ý mang lại những hiểu biết giá trị về hiệu năng của SAMBA và các mô hình tương đương như Mistral. Phân tích entropy chú ý cho thấy SAMBA duy trì khả năng ghi nhớ ổn định và đáng tin cậy trên các ngữ cảnh kéo dài.
Ví dụ, trong tác vụ Passkey Retrieval, SAMBA thể hiện khả năng truy xuất gần như hoàn hảo đến độ dài ngữ cảnh 256K, vượt trội đáng kể so với Mistral. Phân tích heatmap chỉ ra rằng kiến trúc lai của SAMBA cho phép duy trì độ chính xác truy xuất cao trên nhiều vị trí mật mã, nhấn mạnh năng lực truy xuất tầm xa xuất sắc.
Với khả năng xử lý hiệu quả các chuỗi dài, SAMBA mở ra nhiều ứng dụng tiềm năng.
Khả năng xử lý độ dài ngữ cảnh không giới hạn của SAMBA mở ra cơ hội lớn cho nhiều tác vụ ngữ cảnh dài. Mô hình có thể duy trì tính mạch lạc và mức độ liên quan xuyên suốt các chuỗi dài, đặc biệt phù hợp với các ứng dụng như:
Kiến trúc của SAMBA được thiết kế chú trọng hiệu quả, khắc phục các hạn chế điển hình của cả mô hình thuần chú ý và thuần SSM. Một số lợi ích chính gồm:
Nhìn về phía trước, có một số hướng nghiên cứu thú vị có thể tiếp tục phát triển năng lực của SAMBA:
SAMBA là một bước tiến đáng kể trong mô hình hoá ngôn ngữ, đưa ra kiến trúc lai mới kết hợp SSM với các lớp SWA và MLP. Những đổi mới và lợi thế chủ chốt của kiến trúc SAMBA gồm lai hoá SSM và cơ chế chú ý, hiệu quả trong xử lý ngữ cảnh dài, và khả năng ghi nhớ được tăng cường.
Dù bài viết kết thúc tại đây, một cách tuyệt vời để hiểu sâu hơn về kiến trúc SAMBA và các đổi mới của nó là thử nghiệm với bản triển khai trên GitHub.
Nếu bạn muốn tìm hiểu thêm về các đổi mới AI mới nhất, tôi gợi ý những bài viết sau:
Học AI với những khóa học này!
Khóa học
Lộ trình
Khóa học
blog
Matt Crabtree
10 phút
