OpenAI’nin ChatGPT’si ve Anthropic'in Claude’u gibi gelişmiş modelleri düzenli olarak kullanan biri olarak, girdi istemlerinin uzunluğu arttıkça performanslarının nasıl bozulduğunu, uzun metinlerde tutarlılık ve alaka düzeyini korumakta yaşanan sorunlara yol açtığını bizzat gözlemledim.
Bu sınırlamaları ele almak için, Microsoft ve Illinois Üniversitesi’nden araştırmacılar SAMBA—durum uzayı modellerini (SSM) kayan pencere dikkati (SWA) ile birleştiren yeni bir hibrit mimari—yi tanıtıyor.
Yaklaşımları, uzun vadeli bağımlılıkları yönetmede çok iyi olan SSM’lerin ve bağlam pencerelerini ele alıp hesaplamalı uygulanabilirliği koruyan SWA’nın güçlü yönlerinden yararlanıyor. Bu teknikleri bir araya getirerek SAMBA, pratikte sınırsız bağlam uzunluğu ile verimli dil modelleme sağlıyor.
Bu yazıda, SAMBA’nın mimarisini ve bağlamı yitirmeden uzun metin aralıklarını işleme konusundaki benzersiz yeteneğini inceleyeceğiz. Ayrıca, uzun dizileri işleme ve üretme konusunda dil modellerinin yeteneklerini önemli ölçüde artırma potansiyelini vurgulayarak dil modellemede yeni bir standart belirlediğini öne çıkarıyoruz.
Bağlam Darboğazını Anlamak
SAMBA’nın neden bu kadar yenilikçi olduğunu anlamak için önce geleneksel dil modellerinin uzun metin dizileriyle çalışırken karşılaştığı zorlukları kavramamız gerekir.
Geleneksel Transformer tabanlı modeller son derece güçlü olmakla birlikte, bağlam uzunluğuna göre karesel karmaşıklıkları nedeniyle uzun metin dizileriyle çalışırken önemli zorluklarla karşılaşır. Bu karesel karmaşıklık, dizideki her bir belirtecin diğer tüm belirteçlere dikkat etmesini gerektiren öz-dikkat mekanizmasından kaynaklanır.
Bunun sonucunda, dizi uzunluğu arttıkça hesaplama ve bellek maliyetleri hızla büyür; bu da çok uzun metinlerin işlenmesini gerektiren görevler için bu modelleri pratik olmaktan çıkarır.
Bu sınırlama, girişleri kesmeyi veya mevcut donanımın kısıtlamalarına sığdırmak için başka optimal olmayan stratejiler kullanmayı sık sık zorunlu kılar. Sonuçta bu uzlaşma, özellikle uzun belgeleri işlemesi gereken bir uygulama geliştirirken karşılaştığım gibi, modelin uzun dizilerdeki performansını koruma yeteneğini azaltır.
SSM’ler ve sınırlamaları
Durum Uzayı Modelleri (SSM’ler), doğrusal karmaşıklıklarıyla uzun dizileri ele almak için daha hesaplamalı verimlilik sunan bir alternatif sağlar. SSM’ler gelişen bir durumu sürdürerek, yasaklayıcı transformer maliyeti olmadan uzun soluklu bağımlılıkları yönetmelerine imkan tanır.
Ancak SSM’lerin de sınırlamaları vardır. Mevcut durumun yalnızca bir önceki duruma bağlı olduğu Markov doğaları nedeniyle, uzun dizilerde bellek geri çağırımında sıklıkla zorlanırlar. Bu sınırlı geri çağırım, özellikle dizinin çok daha önceki kısımlarından bilgiyi tutmayı ve referans vermeyi gerektiren uygulamalarda kapsamlı bağlam modellemedeki etkinliklerini düşürür.
Hibrit yaklaşımlara ihtiyaç
Hem Transformer’ların hem de SSM’lerin güçlü ve zayıf yanları göz önüne alındığında, her birinin avantajlarından yararlanırken sınırlamalarını hafifletecek hibrit yaklaşımlara duyulan ihtiyaç açıktır. SSM’leri dikkat mekanizmalarıyla birleştirmek umut verici bir çözümdür.
Bu hibrit yaklaşım, SSM’lerin verimliliği ve uzun menzilli bağımlılık özelliklerini, Transformer’ların dinamik ve odaklı dikkat mekanizmasıyla bir araya getirir. Bu iki yöntemi entegre ederek, gelişmiş bellek geri çağırımı ve bağlamsal anlayışla uzun dizileri sorunsuzca işleyen bir model oluşturabiliriz.
SAMBA: Basit Hibrit Durum Uzayı Modelleri
SAMBA, iki farklı yaklaşımın güçlü yönlerini birleştirerek bu bağlam darboğazına zarif bir çözüm sunar.
Temel fikir
SAMBA’nın arkasındaki temel fikir, bir SSM olan Mambayı, SwiGLU ve kayan pencere dikkati (SWA) katmanlarıyla dönüşümlü olarak kullanmaktır. Bu hibrit yapı hem yinelenen (recurrent) yapıları hem de hassas bellek geri getirmeyi yakalar.
SAMBA, uzun bağlamları yönetirken ayrıntılı bilgiyi korumak için SSM’lerin ve dikkat mekanizmalarının güçlü yönlerini birleştirerek bu yaklaşımı örnekler.
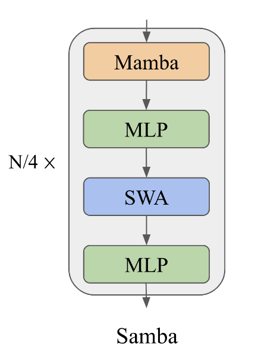
SAMBA mimarisini gösteren bir diyagram. Kaynak: Ren ve ark. (2024)
Mamba katmanları
SAMBA’daki Mamba katmanları, zamana bağlı semantik bilgileri yakalamada ustadır ve sıralı verileri ele almak için sağlam bir çerçeve sunar. Bu katmanlar, veriler içindeki zamansal bağımlılıkları yansıtan bir durumu koruyup güncelleyerek çalışır.
Mamba, modele ilgili girdilere odaklanma ve uzun diziler boyunca önemli bilgileri koruma olanağı tanıyan seçici durum uzaylarını kullanarak bunu başarır. Bu seçici kapılama (gating) mekanizması, hızlı kod çözme için kritik öneme sahiptir ve modelin sıralı kalıpları yüksek doğrulukla ve minimal hesaplama yüküyle yorumlayıp tahmin etmesini sağlar.
SWA katmanları
Kayan pencere dikkat katmanları, sınırlı bir bağlam penceresi içinde karmaşık, Markov olmayan bağımlılıkları ele alarak Mamba katmanlarını tamamlar. SWA, girdi dizisi üzerinde kayan bir pencere boyutunda çalışır ve doğrusal hesaplama karmaşıklığını garanti eder.
Bu sayede model, Mamba’nın yinelenen durumlarıyla yakalanamayan orta ve kısa vadeli geçmişten yüksek tanımlı sinyalleri geri getirebilir. Odağını dinamik olarak ayarlayarak SWA katmanları, özellikle uzun girdilerde bağlamsal olarak ilgili yanıtlar gerektiren görevlerde modelin tutarlılık ve bağlamı korumasını sağlar.
SwiGLU katmanları
SAMBA’daki SwiGLU katmanları, doğrusal olmayan dönüşümü kolaylaştırır ve bilgi geri çağırımını güçlendirir. Bu katmanlar modele doğrusal olmayanlık katarak, veri içindeki daha karmaşık örüntüleri ve etkileşimleri yakalamasını sağlar.
Ayrıca, SwiGLU katmanları modelin bilgiyi işleyip geri çağırabilmesini güvence altına alır; bu da dayanıklılığına ve çok yönlülüğüne katkıda bulunur. Bu doğrusal olmayan dönüşüm, modelin eğitim verilerinden gerçek dünya uygulamalarına genelleme yapabilmesi için esastır.
SAMBA’nın mimarisini incelediğimize göre, şimdi de diğer modellerle karşılaştırıldığında performans ve verimliliğine bakalım.
SAMBA, çeşitli dil anlama ve akıl yürütme kıyaslamalarında iyi performans sergileyerek, hem saf dikkat tabanlı hem de SSM tabanlı modelleri geride bırakıyor. Özellikle MMLU, GSM8K ve HumanEval gibi görevlerde değerlendirilmiş; MMLU için 71,2, GSM8K için 69,6 ve HumanEval için 54,9 puan elde etmiştir.
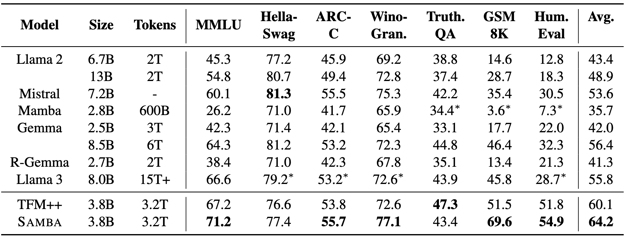
Kaynak: Ren ve ark. (2024)
Bu sonuçlar, TFM++ ve Llama-3 dâhil olmak üzere diğer son teknoloji modelleri önemli ölçüde geride bırakıyor ve SAMBA’nın çeşitli dil anlama görevlerini ele alma becerisini ortaya koyuyor. Örneğin SAMBA, TFM++ ile karşılaştırıldığında GSM8K’de %18,1 daha yüksek doğruluk elde ederek, SSM ile dikkat mekanizmalarını birleştiren hibrit mimarisinin yetkinliğini vurguluyor.
Verimli uzunluk ekstrapolasyonu
SAMBA’nın en dikkat çekici özelliklerinden biri, verimliliği korurken çok daha uzun bağlam uzunluklarını ele alabilmesidir. 4K uzunluğunda diziler üzerinde önceden eğitilmiş olmasına rağmen, SAMBA, geliştirilmiş perplexity ile 1M belirtece kadar ekstrapolasyon yapabilir ve yine de doğrusal kod çözme zaman karmaşıklığını korur.
Bu, Mamba’nın seçici durum uzaylarının SWA ile katman bazında birleştirilmesi sayesinde başarılır; böylece model, karesel hesaplama karmaşıklığı olmadan yüksek performansı sürdürebilir.
Pratik açıdan bakıldığında, SAMBA özellikle 128K belirtece kadar olan dizilerde Llama-3 mimarisine göre 3,64 kat daha hızlı kod çözme verimi elde ederek uzun bağlamları işleme konusundaki ölçeklenebilirliğini ve yetkinliğini gösterir.
İyileştirilmiş bellek geri çağırımı
SAMBA’nın hibrit mimarisi, saf SSM’lerle karşılaştırıldığında bellek geri çağırım yeteneklerini önemli ölçüde artırır. Passkey Retrieval gibi testlerde, yalnızca 500 adımlık ince ayardan sonra 256K bağlam uzunluğuna kadar neredeyse kusursuz bellek geri çağırımı göstermiş; SWA tabanlı modeller ise 4K uzunlukların ötesinde zorlanmıştır.
Bu olağanüstü performans, Mamba’nın zamana bağlı semantiklere yönelik yinelenen yapıları ile SWA’nın bellek geri getirme yeteneklerinin birleşimine atfedilir. Sonuç olarak SAMBA, kısa ve uzun vadeli bellek geri çağırım görevlerinde mükemmele yakın performans sergileyerek kapsamlı bağlam anlayışı gerektiren uygulamalar için sağlam bir çözüm sunar.
Teknik Analiz ve İçgörüler
Şimdi, SAMBA’nın etkileyici performansına katkıda bulunan belirli tasarım tercihleri ve stratejilere yakından bakalım.
Hibritleştirme stratejileri
SAMBA, Mamba, SWA ve Çok Katmanlı Algılayıcı (MLP) katmanlarını birleştiren sofistike bir hibritleştirme stratejisi kullanır. Bu yaklaşım, her bileşenin benzersiz özelliklerinden yararlanarak uzun bağlamlı dil modelleme için performansı optimize eder:
- Mamba katmanları: Yinelenen dizi yapılarını yakalamak üzere tasarlanan Mamba, dizi bilgisini yinelenen gizli durumlara seçici olarak sıkıştırmak için girdiye bağlı kapılamadan yararlanır. Bu, SAMBA’nın uzun menzilli bağımlılıkları sorunsuzca ele almasını ve sıralı veri işlemeye omurga sağlamasını mümkün kılar.
- SWA katmanları: Bu katmanlar, modelin hassas bellek geri getirme ihtiyacını karşılamak için kayan bir pencere içinde dikkat uygular. SWA, sınırlı bir bağlam penceresinde karmaşık, Markov olmayan bağımlılıkları yöneterek modelin belirli bilgileri dinamik olarak hatırlama yeteneğini geliştirir.
- MLP katmanları: MLP katmanları, olgusal bilginin geri çağrımını kolaylaştıran doğrusal olmayan dönüşümler sunar. Bu katmanların dahil edilmesiyle SAMBA, eğitim verilerinden genelleme yapma ve verideki karmaşık örüntüleri yakalama kapasitesini artırır.
Alternatiflerin incelenmesi
SAMBA makalesi, en iyi kombinasyonu belirlemek için çeşitli doğrusal yinelenen modelleri ve dikkat mekanizmalarını inceler. Mamba’ya potansiyel ikame olarak Çok Ölçekli Retention ve GLA gibi alternatifler değerlendirildi. Mamba mimarisi hakkında daha fazla bilgiyi bu Mamba LLM mimarisine giriş rehberinde bulabilirsiniz.
Bu araştırmalar, dil modelleme görevlerinde hesaplama verimliliği ile performans arasında denge kurmayı amaçladı. Karşılaştırma, bu alternatifler bazı faydalar sunsa da Mamba’nın SWA ve MLP katmanlarıyla birleşiminin genel performans ve ölçeklenebilirlikte en iyi sonucu verdiğini ortaya koydu.
Dikkat entropisi analizi
Dikkat dağılımlarının entropisini analiz etmek, SAMBA ve Mistral gibi karşılaştırılabilir modellerin performansına ilişkin değerli içgörüler sağladı. Dikkat entropisi analizi, SAMBA’nın uzun bağlamlar boyunca daha istikrarlı ve güvenilir bellek geri çağırımı sürdürdüğünü ortaya koydu.
Örneğin Passkey Retrieval görevinde SAMBA, 256K bağlam uzunluklarına kadar neredeyse kusursuz geri getirme sergileyerek Mistral’ı önemli ölçüde geride bıraktı. Isı haritası analizi, SAMBA’nın hibrit mimarisinin çeşitli parola konumlarında yüksek geri getirme doğruluğunu korumasına olanak tanıdığını ve olağanüstü uzun menzilli geri getirme yeteneklerini vurguladığını gösterdi.
SAMBA Uygulamaları
Uzun dizileri etkili biçimde işleme yeteneği göz önüne alındığında SAMBA, geniş bir potansiyel uygulama yelpazesinin kapısını açıyor.
Uzun bağlamlı görevler
SAMBA’nın sınırsız bağlam uzunluğunu ele alma yeteneği, çeşitli uzun bağlamlı görevler için önemli olanaklar sunar. Geniş diziler boyunca tutarlılık ve alaka düzeyini koruyabildiği için özellikle şu uygulamalar için uygundur:
- Uzun belge özetleme: SAMBA, tüm metin boyunca bağlamı ve kilit bilgileri koruyarak uzun belgeleri verimli biçimde özetler; kapsamlı ve tutarlı özetler sağlar.
- Geniş bilgi tabanlarında soru yanıtlama: İyileştirilmiş bellek geri çağırımı ve büyük bağlam pencerelerini ele alma becerisiyle SAMBA, kapsamlı bilgi tabanlarına veya uzun metinlere dayalı sorulara doğru yanıtlar verebilir.
- Kod üretimi: SAMBA’nın kapsamlı bağlamı işleyip geri çağırma yeteneği, büyük kod tabanları üretmek veya anlamak için idealdir; ayrıca kod tamamlama, dokümantasyon ve hata düzeltme gibi görevleri iyileştirir.
Verimlilik ve kaynak kullanımı
SAMBA’nın mimarisi, hem saf dikkat tabanlı hem de SSM tabanlı modellerin tipik sınırlamalarını ele alacak şekilde verimlilik odaklı tasarlanmıştır. Öne çıkan bazı faydalar şunlardır:
- Doğrusal zaman karmaşıklığı: SAMBA, kod çözme için doğrusal zaman karmaşıklığını koruyarak, karesel karmaşıklık sergileyen geleneksel Transformer modellere kıyasla hesaplama yükünü önemli ölçüde azaltır. Bu da SAMBA’yı kaynak kısıtlı cihazlarda dağıtım için daha uygun kılar.
- Azaltılmış bellek gereksinimleri: Seçici durum uzaylarını kayan pencere dikkatiyle birleştirerek SAMBA, verimli bellek kullanımına ulaşır. Bu sayede uzun dizileri ele alırken bile bellek ayak izi yönetilebilir kalır ve kapsamlı donanım kaynakları gerektirmeden çeşitli uygulamalar için daha erişilebilir olur.
- Yüksek verim (throughput): SAMBA, özellikle uzun diziler için Llama-3 gibi son teknoloji modellere kıyasla 3,64× daha hızlı kod çözme verimi gösterir. Bu yüksek verim, gerçek zamanlı uygulamalar ve işlem hızının kritik olduğu senaryolar için önemlidir.
SAMBA: Gelecek Yönelimler
İleriye bakıldığında, SAMBA’nın yeteneklerini daha da geliştirebilecek birkaç heyecan verici gelecek çalışma alanı bulunuyor:
- Göreve uyarlanabilir dinamik mimarilerin keşfi: Belirli görevlere ve veri kümelerine uyum sağlayabilen dinamik mimarilerin araştırılması, SAMBA’nın performans ve verimliliğini daha da optimize edebilir. Bu, belirli uygulamalara uygun çeşitli yapılandırmaların ve hibritleştirme stratejilerinin keşfini içerir.
- Donanım uygulamalarının optimize edilmesi: SAMBA’nın donanım uygulamalarının daha da optimize edilmesi, kaynak kısıtlı cihazlarda dağıtımı kolaylaştırabilir. Bu, verimlilik ve ölçeklenebilirliği en üst düzeye çıkarmak için paralelleştirme ve bellek yönetimi tekniklerinin rafine edilmesini içerir.
- Uygulama alanlarının genişletilmesi: SAMBA’nın daha geniş bir gerçek dünya görev ve sektöre uygulanması, pratik etkisini doğrulayabilir ve iyileştirme için ek alanları ortaya çıkarabilir. Buna hukuki belge analizi, tıbbi kayıt özetleme ve büyük ölçekli bilgi tabanı yönetimi gibi alanlar dahildir.
Sonuç
SAMBA, SSM’leri Kayan SWA ve MLP katmanlarıyla birleştiren yeni bir hibrit mimari sunarak dil modellemede önemli bir ilerlemeyi temsil eder. SAMBA mimarisinin temel yenilik ve avantajları; SSM ile dikkat mekanizmalarının hibritleştirilmesi, uzun bağlamları ele almada verimlilik ve geliştirilmiş bellek geri çağırımıdır.
SAMBA mimarisine ilişkin incelememizi burada noktalarken, mimariyi ve yeniliklerini daha derinlemesine kavramanın harika bir yolu, GitHub’daki uygulamayla denemeler yapmaktır.
En yeni yapay zeka yenilikleri hakkında daha fazla bilgi edinmek isterseniz şu blog yazılarını öneririm:



 Abid Ali Awan · 14 min

 Dario Radečić · 15 min

 Adel Nehme


OpenAI’nin ChatGPT’si ve Anthropic'in Claude’u gibi gelişmiş modelleri düzenli olarak kullanan biri olarak, girdi istemlerinin uzunluğu arttıkça performanslarının nasıl bozulduğunu, uzun metinlerde tutarlılık ve alaka düzeyini korumakta yaşanan sorunlara yol açtığını bizzat gözlemledim.
Bu sınırlamaları ele almak için, Microsoft ve Illinois Üniversitesi’nden araştırmacılar SAMBA—durum uzayı modellerini (SSM) kayan pencere dikkati (SWA) ile birleştiren yeni bir hibrit mimari—yi tanıtıyor.
Yaklaşımları, uzun vadeli bağımlılıkları yönetmede çok iyi olan SSM’lerin ve bağlam pencerelerini ele alıp hesaplamalı uygulanabilirliği koruyan SWA’nın güçlü yönlerinden yararlanıyor. Bu teknikleri bir araya getirerek SAMBA, pratikte sınırsız bağlam uzunluğu ile verimli dil modelleme sağlıyor.
Bu yazıda, SAMBA’nın mimarisini ve bağlamı yitirmeden uzun metin aralıklarını işleme konusundaki benzersiz yeteneğini inceleyeceğiz. Ayrıca, uzun dizileri işleme ve üretme konusunda dil modellerinin yeteneklerini önemli ölçüde artırma potansiyelini vurgulayarak dil modellemede yeni bir standart belirlediğini öne çıkarıyoruz.
Bağlam Darboğazını Anlamak
SAMBA’nın neden bu kadar yenilikçi olduğunu anlamak için önce geleneksel dil modellerinin uzun metin dizileriyle çalışırken karşılaştığı zorlukları kavramamız gerekir.
Transformer’larda sınırlı bağlam
Geleneksel Transformer tabanlı modeller son derece güçlü olmakla birlikte, bağlam uzunluğuna göre karesel karmaşıklıkları nedeniyle uzun metin dizileriyle çalışırken önemli zorluklarla karşılaşır. Bu karesel karmaşıklık, dizideki her bir belirtecin diğer tüm belirteçlere dikkat etmesini gerektiren öz-dikkat mekanizmasından kaynaklanır.
Bunun sonucunda, dizi uzunluğu arttıkça hesaplama ve bellek maliyetleri hızla büyür; bu da çok uzun metinlerin işlenmesini gerektiren görevler için bu modelleri pratik olmaktan çıkarır.
Bu sınırlama, girişleri kesmeyi veya mevcut donanımın kısıtlamalarına sığdırmak için başka optimal olmayan stratejiler kullanmayı sık sık zorunlu kılar. Sonuçta bu uzlaşma, özellikle uzun belgeleri işlemesi gereken bir uygulama geliştirirken karşılaştığım gibi, modelin uzun dizilerdeki performansını koruma yeteneğini azaltır.
SSM’ler ve sınırlamaları
Durum Uzayı Modelleri (SSM’ler), doğrusal karmaşıklıklarıyla uzun dizileri ele almak için daha hesaplamalı verimlilik sunan bir alternatif sağlar. SSM’ler gelişen bir durumu sürdürerek, yasaklayıcı transformer maliyeti olmadan uzun soluklu bağımlılıkları yönetmelerine imkan tanır.
Ancak SSM’lerin de sınırlamaları vardır. Mevcut durumun yalnızca bir önceki duruma bağlı olduğu Markov doğaları nedeniyle, uzun dizilerde bellek geri çağırımında sıklıkla zorlanırlar. Bu sınırlı geri çağırım, özellikle dizinin çok daha önceki kısımlarından bilgiyi tutmayı ve referans vermeyi gerektiren uygulamalarda kapsamlı bağlam modellemedeki etkinliklerini düşürür.
Hibrit yaklaşımlara ihtiyaç
Hem Transformer’ların hem de SSM’lerin güçlü ve zayıf yanları göz önüne alındığında, her birinin avantajlarından yararlanırken sınırlamalarını hafifletecek hibrit yaklaşımlara duyulan ihtiyaç açıktır. SSM’leri dikkat mekanizmalarıyla birleştirmek umut verici bir çözümdür.
Bu hibrit yaklaşım, SSM’lerin verimliliği ve uzun menzilli bağımlılık özelliklerini, Transformer’ların dinamik ve odaklı dikkat mekanizmasıyla bir araya getirir. Bu iki yöntemi entegre ederek, gelişmiş bellek geri çağırımı ve bağlamsal anlayışla uzun dizileri sorunsuzca işleyen bir model oluşturabiliriz.
SAMBA: Basit Hibrit Durum Uzayı Modelleri
SAMBA, iki farklı yaklaşımın güçlü yönlerini birleştirerek bu bağlam darboğazına zarif bir çözüm sunar.
Temel fikir
SAMBA’nın arkasındaki temel fikir, bir SSM olan Mambayı, SwiGLU ve kayan pencere dikkati (SWA) katmanlarıyla dönüşümlü olarak kullanmaktır. Bu hibrit yapı hem yinelenen (recurrent) yapıları hem de hassas bellek geri getirmeyi yakalar.
SAMBA, uzun bağlamları yönetirken ayrıntılı bilgiyi korumak için SSM’lerin ve dikkat mekanizmalarının güçlü yönlerini birleştirerek bu yaklaşımı örnekler.
SAMBA mimarisini gösteren bir diyagram. Kaynak: Ren ve ark. (2024)
Mamba katmanları
SAMBA’daki Mamba katmanları, zamana bağlı semantik bilgileri yakalamada ustadır ve sıralı verileri ele almak için sağlam bir çerçeve sunar. Bu katmanlar, veriler içindeki zamansal bağımlılıkları yansıtan bir durumu koruyup güncelleyerek çalışır.
Mamba, modele ilgili girdilere odaklanma ve uzun diziler boyunca önemli bilgileri koruma olanağı tanıyan seçici durum uzaylarını kullanarak bunu başarır. Bu seçici kapılama (gating) mekanizması, hızlı kod çözme için kritik öneme sahiptir ve modelin sıralı kalıpları yüksek doğrulukla ve minimal hesaplama yüküyle yorumlayıp tahmin etmesini sağlar.
SWA katmanları
Kayan pencere dikkat katmanları, sınırlı bir bağlam penceresi içinde karmaşık, Markov olmayan bağımlılıkları ele alarak Mamba katmanlarını tamamlar. SWA, girdi dizisi üzerinde kayan bir pencere boyutunda çalışır ve doğrusal hesaplama karmaşıklığını garanti eder.
Bu sayede model, Mamba’nın yinelenen durumlarıyla yakalanamayan orta ve kısa vadeli geçmişten yüksek tanımlı sinyalleri geri getirebilir. Odağını dinamik olarak ayarlayarak SWA katmanları, özellikle uzun girdilerde bağlamsal olarak ilgili yanıtlar gerektiren görevlerde modelin tutarlılık ve bağlamı korumasını sağlar.
SwiGLU katmanları
SAMBA’daki SwiGLU katmanları, doğrusal olmayan dönüşümü kolaylaştırır ve bilgi geri çağırımını güçlendirir. Bu katmanlar modele doğrusal olmayanlık katarak, veri içindeki daha karmaşık örüntüleri ve etkileşimleri yakalamasını sağlar.
Ayrıca, SwiGLU katmanları modelin bilgiyi işleyip geri çağırabilmesini güvence altına alır; bu da dayanıklılığına ve çok yönlülüğüne katkıda bulunur. Bu doğrusal olmayan dönüşüm, modelin eğitim verilerinden gerçek dünya uygulamalarına genelleme yapabilmesi için esastır.
SAMBA: Performans ve Ölçeklenebilirlik
SAMBA’nın mimarisini incelediğimize göre, şimdi de diğer modellerle karşılaştırıldığında performans ve verimliliğine bakalım.
Kıyaslamalarda güçlü performans
SAMBA, çeşitli dil anlama ve akıl yürütme kıyaslamalarında iyi performans sergileyerek, hem saf dikkat tabanlı hem de SSM tabanlı modelleri geride bırakıyor. Özellikle MMLU, GSM8K ve HumanEval gibi görevlerde değerlendirilmiş; MMLU için 71,2, GSM8K için 69,6 ve HumanEval için 54,9 puan elde etmiştir.
Kaynak: Ren ve ark. (2024)
Bu sonuçlar, TFM++ ve Llama-3 dâhil olmak üzere diğer son teknoloji modelleri önemli ölçüde geride bırakıyor ve SAMBA’nın çeşitli dil anlama görevlerini ele alma becerisini ortaya koyuyor. Örneğin SAMBA, TFM++ ile karşılaştırıldığında GSM8K’de %18,1 daha yüksek doğruluk elde ederek, SSM ile dikkat mekanizmalarını birleştiren hibrit mimarisinin yetkinliğini vurguluyor.
Verimli uzunluk ekstrapolasyonu
SAMBA’nın en dikkat çekici özelliklerinden biri, verimliliği korurken çok daha uzun bağlam uzunluklarını ele alabilmesidir. 4K uzunluğunda diziler üzerinde önceden eğitilmiş olmasına rağmen, SAMBA, geliştirilmiş perplexity ile 1M belirtece kadar ekstrapolasyon yapabilir ve yine de doğrusal kod çözme zaman karmaşıklığını korur.
Bu, Mamba’nın seçici durum uzaylarının SWA ile katman bazında birleştirilmesi sayesinde başarılır; böylece model, karesel hesaplama karmaşıklığı olmadan yüksek performansı sürdürebilir.
Pratik açıdan bakıldığında, SAMBA özellikle 128K belirtece kadar olan dizilerde Llama-3 mimarisine göre 3,64 kat daha hızlı kod çözme verimi elde ederek uzun bağlamları işleme konusundaki ölçeklenebilirliğini ve yetkinliğini gösterir.
İyileştirilmiş bellek geri çağırımı
SAMBA’nın hibrit mimarisi, saf SSM’lerle karşılaştırıldığında bellek geri çağırım yeteneklerini önemli ölçüde artırır. Passkey Retrieval gibi testlerde, yalnızca 500 adımlık ince ayardan sonra 256K bağlam uzunluğuna kadar neredeyse kusursuz bellek geri çağırımı göstermiş; SWA tabanlı modeller ise 4K uzunlukların ötesinde zorlanmıştır.
Bu olağanüstü performans, Mamba’nın zamana bağlı semantiklere yönelik yinelenen yapıları ile SWA’nın bellek geri getirme yeteneklerinin birleşimine atfedilir. Sonuç olarak SAMBA, kısa ve uzun vadeli bellek geri çağırım görevlerinde mükemmele yakın performans sergileyerek kapsamlı bağlam anlayışı gerektiren uygulamalar için sağlam bir çözüm sunar.
Teknik Analiz ve İçgörüler
Şimdi, SAMBA’nın etkileyici performansına katkıda bulunan belirli tasarım tercihleri ve stratejilere yakından bakalım.
Hibritleştirme stratejileri
SAMBA, Mamba, SWA ve Çok Katmanlı Algılayıcı (MLP) katmanlarını birleştiren sofistike bir hibritleştirme stratejisi kullanır. Bu yaklaşım, her bileşenin benzersiz özelliklerinden yararlanarak uzun bağlamlı dil modelleme için performansı optimize eder:
Alternatiflerin incelenmesi
SAMBA makalesi, en iyi kombinasyonu belirlemek için çeşitli doğrusal yinelenen modelleri ve dikkat mekanizmalarını inceler. Mamba’ya potansiyel ikame olarak Çok Ölçekli Retention ve GLA gibi alternatifler değerlendirildi. Mamba mimarisi hakkında daha fazla bilgiyi bu Mamba LLM mimarisine giriş rehberinde bulabilirsiniz.
Bu araştırmalar, dil modelleme görevlerinde hesaplama verimliliği ile performans arasında denge kurmayı amaçladı. Karşılaştırma, bu alternatifler bazı faydalar sunsa da Mamba’nın SWA ve MLP katmanlarıyla birleşiminin genel performans ve ölçeklenebilirlikte en iyi sonucu verdiğini ortaya koydu.
Dikkat entropisi analizi
Dikkat dağılımlarının entropisini analiz etmek, SAMBA ve Mistral gibi karşılaştırılabilir modellerin performansına ilişkin değerli içgörüler sağladı. Dikkat entropisi analizi, SAMBA’nın uzun bağlamlar boyunca daha istikrarlı ve güvenilir bellek geri çağırımı sürdürdüğünü ortaya koydu.
Örneğin Passkey Retrieval görevinde SAMBA, 256K bağlam uzunluklarına kadar neredeyse kusursuz geri getirme sergileyerek Mistral’ı önemli ölçüde geride bıraktı. Isı haritası analizi, SAMBA’nın hibrit mimarisinin çeşitli parola konumlarında yüksek geri getirme doğruluğunu korumasına olanak tanıdığını ve olağanüstü uzun menzilli geri getirme yeteneklerini vurguladığını gösterdi.
SAMBA Uygulamaları
Uzun dizileri etkili biçimde işleme yeteneği göz önüne alındığında SAMBA, geniş bir potansiyel uygulama yelpazesinin kapısını açıyor.
Uzun bağlamlı görevler
SAMBA’nın sınırsız bağlam uzunluğunu ele alma yeteneği, çeşitli uzun bağlamlı görevler için önemli olanaklar sunar. Geniş diziler boyunca tutarlılık ve alaka düzeyini koruyabildiği için özellikle şu uygulamalar için uygundur:
Verimlilik ve kaynak kullanımı
SAMBA’nın mimarisi, hem saf dikkat tabanlı hem de SSM tabanlı modellerin tipik sınırlamalarını ele alacak şekilde verimlilik odaklı tasarlanmıştır. Öne çıkan bazı faydalar şunlardır:
SAMBA: Gelecek Yönelimler
İleriye bakıldığında, SAMBA’nın yeteneklerini daha da geliştirebilecek birkaç heyecan verici gelecek çalışma alanı bulunuyor:
Sonuç
SAMBA, SSM’leri Kayan SWA ve MLP katmanlarıyla birleştiren yeni bir hibrit mimari sunarak dil modellemede önemli bir ilerlemeyi temsil eder. SAMBA mimarisinin temel yenilik ve avantajları; SSM ile dikkat mekanizmalarının hibritleştirilmesi, uzun bağlamları ele almada verimlilik ve geliştirilmiş bellek geri çağırımıdır.
SAMBA mimarisine ilişkin incelememizi burada noktalarken, mimariyi ve yeniliklerini daha derinlemesine kavramanın harika bir yolu, GitHub’daki uygulamayla denemeler yapmaktır.
En yeni yapay zeka yenilikleri hakkında daha fazla bilgi edinmek isterseniz şu blog yazılarını öneririm: