课程
面向开发者的 AI 辅助编码
1 小时 30 分钟
11.6K
实践并学习路径你的进步。
使用 Google 继续由前 OpenAI CTO Mira Murati 创立的实验室 Thinking Machines 发布了其首个模型:Inkling。与 OpenAI、Anthropic 和 Google 的旗舰模型不同,Inkling 提供可下载的完整权重,开发者无需仅通过计费 API 调用,而是可以直接修改模型本身。
Inkling 是一种专家混合(Mixture-of-Experts, MoE)Transformer,总参数量为 9750 亿,激活参数为 410 亿,支持 100 万 Token 的上下文窗口,并在 45 万亿个文本、图像、音频和视频 Token 上进行了预训练。
Thinking Machines 坦言这并非当前最强的模型:公司直言 Inkling “不是目前开源或闭源中整体最强的模型”。其定位是性能均衡,并通过公司微调平台 Tinker 的设计实现高度可定制。
本文将全面介绍 Inkling 的新内容,涵盖其功能、基准测试,并提出可自行上手的评测方案。也建议查看我们的本地运行 Inkling 指南。
Inkling 是一款开源权重的 MoE Transformer,总参数 9750 亿、单 Token 激活 410 亿,更像是用于微调的通用基础模型,而非榜单顶流的聊天机器人。它是一个计划系列的首发产品,于 2026 年 7 月 15 日发布,同时预览了更小的姊妹模型 Inkling-Small。
其设计目标是覆盖面广。Thinking Machines 让 Inkling 同时在代理、推理、编程、指令跟随、事实性、视觉与音频等任务上训练,而不是只针对单一领域做极致优化。
这很重要,因为公司押注于各类组织会用自身数据对模型进行微调,而更“宽”的基础能适配的工作流比“窄”的更多。
最抢眼的能力主打效率而非极限分数。按照 Terminal Bench 2.1,Thinking Machines 报告称,Inkling 以大约 NVIDIA Nemotron 3 Ultra 三分之一的 Token 消耗达到相同的编码性能。
对于将在长链路中被调用数百万次的模型而言,Token 成本曲线往往比单次的极限成绩更重要。
Inkling 的 MoE 设计基本遵循 DeepSeek-V3,包含 256 个路由专家、2 个共享专家、每个 Token 激活 6 个路由专家,使用带有无辅助损失负载均衡的 Sigmoid 路由器。
Thinking Machines 以 5:1 的比例交错使用滑动窗口注意力与全局注意力,并采用相对位置嵌入替代 RoPE,据称在更长序列的外推上表现更好。
预训练在 45 万亿多模态 Token 上进行,采用混合优化器:对大型矩阵权重使用 Muon,其余参数使用 Adam。
后训练阶段先用少量来自开源权重模型(包括 Kimi K2.5)的合成数据进行小规模 SFT 引导,然后进行两次连续运行、总计超过 3000 万次回合的大规模异步强化学习。
Inkling 的差异化更多体现在可定制与可控性上,而非单纯的原始能力。以下是几个亮点特性。
Inkling 允许您设置“思考力度”,以在详尽性与 Token 成本、延迟之间权衡。
面对难题,您可以将力度推到 0.99 以获得最大性能;处理高吞吐任务时,则可降低力度以追求速度与成本。
这是一种训练出来的行为,而非外层包装。
在大规模强化学习中,Thinking Machines 通过改变系统消息和调整每个 Token 的成本,在不同样本上变化力度水平,因此模型学会了在不同回合里花费不同的 Token 预算。
力度设置可以从编码或代理的封装中传入。
对于运行生产工作负载的从业者而言,这是我最看重的功能。交互式工具常常受制于延迟,且能在不更换模型的情况下按请求控制延迟,确实很有用。
Inkling 可对文本、图像与音频进行原生推理,其多模态组件基于通用领域数据从零开始训练。
它可以转录语音、遵循口头指令、回答录音问题、描述图像,并对图表与示意图进行推理。
其架构不含独立编码器。
音频以 dMel 频谱图形式输入,图像通过四层 hMLP 以 40x40 像素块编码,二者都通过轻量嵌入层,与文本 Token 一起联合处理。
在视觉方面,Inkling 在推理时可调用 Python 工具进行缩放和裁剪,将视觉推理与基于代码的推理在一次流程中结合。
需要注意的一点是:输入是多模态的,但当前工具链下的输出仅为文本。如果您的场景需要模型直接生成图像或音频,Inkling 并不支持。
Inkling 经过训练,会以恰当的自信度作答,包括在可能出错时说“我不确定”,Thinking Machines 将此归入模型的“认识论(epistemics)”。
公司通过在大量已定论的真实世界问题语料上,基于合适的计分规则进行强化学习来训练校准能力。
后训练阶段使用了两个自动评估器:一个是按清单核对优质答案应包含要点的评分细则评估器;另一个是通过代理式网页搜索逐条核查事实的陈述评估器。
陈述评估器会惩罚无法证实的断言,从而降低幻觉,而不是仅仅奖励回忆能力。
其意义在于,如果模型对每个答案都过度自信,您就不得不事事复核。在不使用搜索的 ForecastBench Brier 指数上,Inkling 得分 61.1,与 Grok 4.3 持平,略高于 GPT-5.5 的 59.1 和 Gemini 3.1 Pro 的 54.6。
在 Thinking Machines 对比的开源权重模型中,Inkling 的 FORTRESS 对抗安全得分最高,达到 78.0%。FORTRESS 同时测试对武器与暴力相关请求的拒绝能力,以及与其相似但无害的请求,因此高分意味着既能拒绝有害请求,又不会过度拒绝安全请求。
作为对比,Nemotron 3 Ultra 得分 77.6%,Kimi K2.5 得分 54.1%,GLM 5.2 得分 65.6%,DeepSeek V4 Pro 在同一对抗集上得分 36.0%。
Inkling 在 StrongREJECT(明确有害请求的拒绝测试)上也达到了 98.6%,与其他开源与闭源模型大体一致。
未解的问题是微调之后会发生什么变化。
Thinking Machines 表示仍在研究客户在 Tinker 上微调后安全行为的变化,这对任何可下载模型而言都是真实的担忧。
在开源权重模型中,Inkling 位于中游:在多数推理与编程测试上领先 Nemotron 3 Ultra 与 Kimi K2.5,但在最难的测试上落后于 GLM 5.2 与 Kimi K2.6。与 GPT-5.6 Sol、Gemini 3.1 Pro、Claude Fable 5 等闭源前沿模型相比,它则持续落后。以下所有分数均为力度 0.99 下的结果。
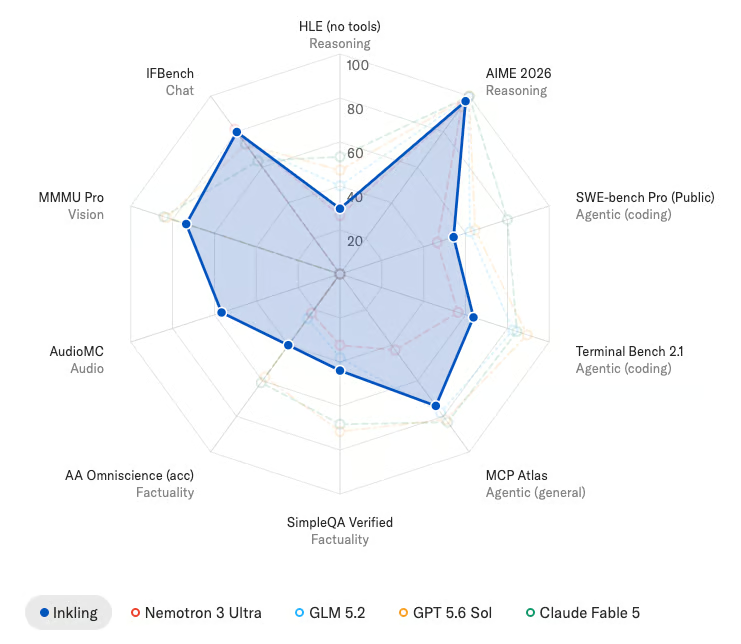
Terminal Bench 2.1 测试在终端环境中的代理式编码能力。
Inkling 在其最佳封装下得分 63.8%,领先 Nemotron 3 Ultra 的 56.4% 和 Kimi K2.5 的 51.3%,但显著落后于 GLM 5.2 的 82.7% 与 GPT-5.6 Sol 的 89.5%。
这也体现了其 Token 效率:Inkling 以大约三分之一的 Token 消耗达到 Nemotron 3 Ultra 的编码性能。
Humanity's Last Exam(HLE)是一项困难且广泛的推理基准。
Inkling 仅文本得分 29.7%,配合工具为 46.0%,领先于 Nemotron 3 Ultra(26.6% / 37.4%),但落后于 GLM 5.2(40.1% / 54.7%)与闭源模型,其中 GPT-5.6 Sol 的仅文本得分为 47.2%。
GPQA Diamond 测试研究生级别的科学问题。
在 SimpleQA Verified 上,Inkling 得分 43.9%,领先于 Nemotron 3 Ultra 的 32.4% 与 Kimi K2.5 的 36.9%,但远低于 Gemini 3.1 Pro 的 77.3% 与 GPT-5.6 Sol 的 71.6%。原始事实回忆并非其强项。
Inkling 的亮点在 AA Omniscience,该基准奖励“知道自己不知道”。
Inkling 得分为正的 2.1,而数个开源模型为负:Kimi K2.5 为 -8.0,DeepSeek V4 Pro 为 -10.0,Nemotron 3 Ultra 为 -1.0。这一差距反映了校准训练的效果。
在视觉推理基准 MMMU Pro(Standard 10)上,Inkling 得分 73.5%,落后于 Kimi K2.6 的 79.0% 与 Gemini 3.1 Pro 的 82.0%。
在图表推理的 Charxiv RQ 上,Inkling 得分 78.1%,在允许使用 Python 工具时可提升至 82.0%。
在音频方面,Inkling 在 VoiceBench 上得分 91.4%,MMAU 为 77.2%,Audio MC 为 56.6%,位列最强的开源权重音频模型之列。
Gemini 3.1 Pro 在这三项上仍保持领先,分别为 94.3%、82.5% 与 66.8%。
Inkling 现已可在 Tinker 上进行微调,提供 64K 与 256K 上下文长度可选,完整权重已在 Hugging Face 提供,包含原始检查点与面向 NVIDIA Blackwell 推理的 NVFP4 检查点。
Thinking Machines 正在限时提供 5 折优惠,完整定价见其文档。
在应用该折扣后,每 100 万 Token 的价格如下:
(注意:尽管 Tinker 将于 7 月 17 日上调多数模型的价格,但 Inkling 的费率不受此次上调影响。进行微调时,平台标准存储费用 $0.10/GB/月 仍然适用。)
部署支持面广。微调后的检查点可通过 TogetherAI、Fireworks、Modal、Databricks 与 Baseten 的 API 运行;开源推理支持包括 SGLang、vLLM 与 llama.cpp;同时还提供集成网页搜索的 Inkling Playground 聊天界面,限时免费。
与 Inkling 同期,Thinking Machines 预览了 Inkling-Small,这是一款 2760 亿参数的 MoE,激活参数为 120 亿(对比完整版的 410 亿)。通过改进更小模型的预训练数据与配方,它在多个基准上与大模型相当或更优。
Inkling-Small 在事实回忆与高难度的代理式编码上有所取舍,以换取更低的成本与更短的延迟,适合如评测、合成数据生成与高频编码等工作负载。完整权重将在测试完成后发布。
与其说 Inkling 是榜单胜利,不如说它体现了一种策略。Thinking Machines 押注于愿意微调并自有模型的组织能比调用闭源前沿模型的计费 API 获得更多价值,而 Inkling 正是为此提供的基础。
我认为这种坦诚令人耳目一新。公司直言 Inkling 不是最强模型,这在发布时并不常见,基准结果也印证了这一点:在最难的编码与推理测试上,它落后于 GLM 5.2 与 Kimi K2.6,并明显落后于 GPT-5.6 Sol 与 Gemini 3.1 Pro 等闭源模型。其优势在于覆盖面广、原生多模态输入、校准回答、可控思考力度,以及在对比的开源权重模型中最佳的 FORTRESS 对抗安全得分。
若您追求单项基准的最高分,Inkling 并非首选。若您需要一个可在自有数据上微调的开源权重基础模型,并希望开箱即用地获得良好的校准与安全性,它是一个合理的选择,不过对于高并发部署,仍需留意按 Token 定价与默认冗长度。
如果您想系统学习让 Inkling 这类模型更有用的微调技能,建议从我们的AI 基础技能路径开始。
热门 DataCamp 课程
课程
课程
实践并学习路径你的进步。
使用 Google 继续