
Cursus
AI-ondersteund coderen voor developers
1 uur 30 min
10.7K
Thinking Machines, het lab opgericht door voormalig OpenAI-CTO Mira Murati, heeft zijn eerste model uitgebracht: Inkling. In tegenstelling tot de vlaggenschipmodellen van OpenAI, Anthropic en Google levert Inkling volledige gewichten die je kunt downloaden, zodat ontwikkelaars het model direct kunnen aanpassen in plaats van het alleen via een afgerekende API aan te roepen.
Inkling is een Mixture-of-Experts (MoE) transformer met in totaal 975B parameters en 41B actief, een contextvenster van 1M tokens, en voorgetraind op 45 biljoen tokens aan tekst, afbeeldingen, audio en video.
Thinking Machines is transparant dat dit niet het sterkste beschikbare model is: het bedrijf stelt ronduit dat Inkling "niet het sterkste algehele model is dat vandaag beschikbaar is, open of gesloten". De propositie is evenwichtige prestaties plus een ontwerp dat bedoeld is om te worden aangepast via Tinker, het fine-tuningplatform van het bedrijf.
In dit artikel behandel ik alles wat nieuw is aan Inkling: de functies, de benchmarks en hands-on tests die je zelf kunt uitvoeren. Bekijk ook onze handleiding om Inkling lokaal te draaien.
Inkling is een open-weights MoE-transformer met in totaal 975B parameters en 41B actief per token, gepositioneerd als een brede basismodel voor fine-tuning in plaats van een top-chatbot op de ranglijsten. Het is de eerste release in een geplande familie, uitgebracht op 15 juli 2026, samen met een preview van een kleinere variant, Inkling-Small.
Het ontwerpdoel is breedte. Thinking Machines trainde Inkling op agentic, redeneren, coderen, instructievolgen, factualiteit, visie en audiotaken in plaats van te optimaliseren voor één domein.
Dat is belangrijk omdat het bedrijf erop gokt dat organisaties het model zullen fine-tunen op hun eigen data, en een brede basis past zich aan meer workflows aan dan een smalle.
De opvallende claim gaat over efficiëntie, niet over een piekbenchmark. Op Terminal Bench 2.1 meldt Thinking Machines dat Inkling een derde van het aantal tokens verbruikt van NVIDIA’s Nemotron 3 Ultra om dezelfde codeerprestatie te halen.
Voor een model dat je mogelijk miljoenen keren aanroept binnen langere workflows, weegt die tokenkostenlijn zwaarder dan één maximale-inspanning-score.
Inklings MoE-ontwerp volgt grotendeels DeepSeek-V3, met 256 gerouteerde experts, 2 gedeelde experts en 6 gerouteerde experts actief per token, met een sigmoidrouter en load balancing zonder auxiliary loss.
Thinking Machines verweeft sliding-window- en globale aandacht in een verhouding van 5:1 en gebruikt relatieve positionele embeddings in plaats van RoPE, met naar eigen zeggen betere extrapolatie naar langere sequenties.
Pretraining draaide op 45 biljoen multimodale tokens met een hybride optimizer: Muon voor grote matrixgewichten en Adam voor andere parameters.
Post-training werd opgestart met een kleine hoeveelheid SFT op synthetische data van open-weights-modellen, waaronder Kimi K2.5, gevolgd door grootschalige asynchrone RL opgeschaald naar meer dan 30M rollouts over twee continue runs.
De onderscheidende punten van Inkling zitten minder in ruwe capaciteit en meer in hoe het is gebouwd om te worden aangepast en gestuurd. Dit zijn de opvallende functies.
Met Inkling kun je een niveau van "denkinspanning" instellen om grondigheid af te wegen tegen tokenkosten en latentie.
Je kunt de inspanning opvoeren tot 0,99 voor maximale prestaties op een lastig probleem, of laag zetten voor een taak met hoog volume waar snelheid en kosten domineren.
Dit is getraind gedrag, geen wrapper.
Tijdens grootschalige reinforcement learning varieerde Thinking Machines de inspanningsniveaus per sample door het systeembericht te veranderen en de kost per token aan te passen, zodat het model leerde verschillende tokenbudgetten te besteden aan verschillende rollouts.
De inspanningsinstelling kan worden doorgegeven vanuit een code- of agent-harnas.
Voor practitioners met productieworkloads is dit de functie waar ik het meest om zou geven. Latentie is vaak de beperkende factor voor interactieve tools, en dit per verzoek kunnen sturen zonder van model te wisselen is echt nuttig.
Inkling redeneert native over tekst, afbeeldingen en audio, met de multimodale componenten vanaf nul getraind op data uit het algemene domein.
Het kan spraak transcriberen, gesproken instructies opvolgen, vragen over opnames beantwoorden, afbeeldingen beschrijven en redeneren over grafieken en diagrammen.
De architectuur is encoder-vrij.
Audio wordt ingevoerd als dMel-spectrogrammen, afbeeldingen worden gecodeerd als 40x40 pixelpatches via een vierlaagse hMLP, en beide gaan via een lichte embeddinglaag om samen met teksttokens te worden verwerkt.
Aan de visiekant kan Inkling tijdens het redeneren een Python-tool aanroepen om in te zoomen en te croppen, waarbij visueel en codegebaseerd redeneren in één keer worden gecombineerd.
Eén kanttekening: input is multimodaal, maar output is in de huidige tooling alleen tekst. Als je use case vereist dat het model direct afbeeldingen of audio genereert, dan kan Inkling dat niet.
Inkling is getraind om de juiste mate van zekerheid te uiten, inclusief zeggen "Dat weet ik niet" wanneer het waarschijnlijk fout zit; Thinking Machines schaart dit onder de "epistemics" van het model.
Het bedrijf trainde op calibratie via reinforcement learning met correcte scoringsregels op een groot corpus van opgeloste vragen uit de echte wereld.
Ze gebruikten twee geautomatiseerde beoordelaars in post-training: een rubric-grader die een antwoord toetst aan een checklist van wat een goed antwoord moet bevatten, en een claims-grader die elke feitelijke claim verifieert via agentische websearch.
De claims-grader bestraft claims die niet kloppen, wat hallucinaties vermindert in plaats van alleen recall te belonen.
Waarom dit ertoe doet: een model dat in elk antwoord zelfverzekerd is, dwingt je alles dubbel te checken. Op de ForecastBench Brier Index zonder search scoort Inkling 61,1, gelijk aan Grok 4.3 en net boven GPT-5.5 met 59,1 en Gemini 3.1 Pro met 54,6.
Inkling noteert de hoogste FORTRESS adversarial safety-score onder de vergeleken open-weights-modellen, met 78,0%. FORTRESS test het weigeren van verzoeken rond wapens en geweld naast goedaardige look-alike queries, dus een hoge score betekent schadelijke verzoeken weigeren zonder veilige verzoeken te vaak onterecht te weigeren.
Ter vergelijking: Nemotron 3 Ultra scoorde 77,6%, Kimi K2.5 54,1%, GLM 5.2 65,6% en DeepSeek V4 Pro 36,0% op dezelfde adversarial set.
Inkling haalt ook 98,6% op StrongREJECT, een weigeringstest met ondubbelzinnig schadelijke verzoeken, in lijn met andere open en gesloten modellen.
De open vraag is wat er gebeurt na fine-tuning.
Thinking Machines zegt nog te onderzoeken hoe veiligheidsgedrag verschuift wanneer klanten fine-tunen op Tinker, wat een reële zorg is bij elk downloadbaar model.
Inkling komt in de middenmoot onder open-weights-modellen: vóór Nemotron 3 Ultra en Kimi K2.5 op de meeste redeneer- en codeer-tests, maar achter GLM 5.2 en Kimi K2.6 op de moeilijkste. Tegen gesloten frontiermodellen als GPT-5.6 Sol, Gemini 3.1 Pro en Claude Fable 5 blijft het consequent achter. Alle onderstaande scores zijn gerapporteerd bij inspanning 0,99.
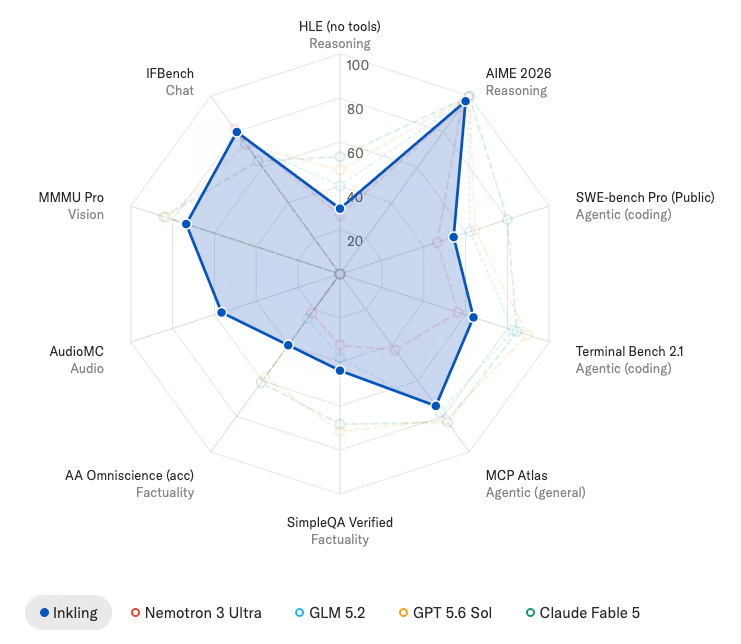
Terminal Bench 2.1 test agentisch coderen in een terminalomgeving.
Inkling scoort 63,8% op zijn beste harnas, vóór Nemotron 3 Ultra met 56,4% en Kimi K2.5 met 51,3%, maar ver achter GLM 5.2 met 82,7% en GPT-5.6 Sol met 89,5%.
Hier komt de token-efficiëntieclaim om de hoek: Inkling bereikt de codeerprestatie van Nemotron 3 Ultra met ruwweg een derde van het aantal tokens.
Humanity's Last Exam (HLE) is een lastige, brede redeneerbenchmark.
Inkling scoort 29,7% tekst-only en 46,0% met tools, vóór Nemotron 3 Ultra (26,6% / 37,4%) maar achter GLM 5.2 (40,1% / 54,7%) en de gesloten modellen, met GPT-5.6 Sol op 47,2% tekst-only.
GPQA Diamond test vragen op masterniveau in de wetenschap.
Inkling scoort 43,9% op SimpleQA Verified, vóór Nemotron 3 Ultra met 32,4% en Kimi K2.5 met 36,9%, maar ver achter Gemini 3.1 Pro met 77,3% en GPT-5.6 Sol met 71,6%. Ruwe feitelijke recall is niet zijn sterkste kant.
Waar Inkling opvalt is AA Omniscience, dat beloont dat je weet wat je niet weet.
Inkling scoort positief met 2,1, terwijl meerdere open modellen negatief gaan: Kimi K2.5 op -8,0, DeepSeek V4 Pro op -10,0 en Nemotron 3 Ultra op -1,0. Dat verschil weerspiegelt de vruchten van calibratie-training.
Op MMMU Pro (Standard 10), een visuele redeneerbenchmark, scoort Inkling 73,5%, achter Kimi K2.6 met 79,0% en Gemini 3.1 Pro met 82,0%.
Op Charxiv RQ voor grafiekredeneren haalt het 78,1%, oplopend tot 82,0% met een Python-tool.
Voor audio scoort Inkling 91,4% op VoiceBench, 77,2% op MMAU en 56,6% op Audio MC, waarmee het tot de sterkste open-weights-audiomodellen behoort.
Gemini 3.1 Pro leidt nog steeds op alle drie, met respectievelijk 94,3%, 82,5% en 66,8%.
Inkling is vandaag beschikbaar voor fine-tuning op Tinker, met contextlengtes van 64K en 256K tokens, en volledige gewichten staan op Hugging Face als zowel de originele checkpoint als een NVFP4-checkpoint voor NVIDIA Blackwell-inferentie.
Thinking Machines biedt tijdelijk 50% korting, met volledige prijzen in de documentatie.
Met deze korting toegepast, komt de prijs per 1 miljoen tokens neer op het volgende:
(Opmerking: Hoewel Tinker op 17 juli de prijzen voor de meeste modellen verhoogt, zijn de tarieven van Inkling beschermd tegen deze stijging. Standaard platformopslagkosten van $0,10 per GB/maand blijven gelden voor fine-tuning).
De uitrolondersteuning is breed. Fijn-afgestelde checkpoints draaien via API’s op TogetherAI, Fireworks, Modal, Databricks en Baseten, met open-source inference-ondersteuning in SGLang, vLLM en llama.cpp, plus een chatinterface met geïntegreerde webzoekfunctie in de Inkling Playground, tijdelijk gratis.
Naast Inkling gaf Thinking Machines een preview van Inkling-Small, een MoE met 276B parameters en 12B actief, tegenover 41B voor het volledige model. Dankzij verbeteringen in de pretrainingdata en -receptuur van het kleinere model evenaart of overtreft het op meerdere benchmarks zijn grotere broer.
Inkling-Small ruilt feitelijke recall en moeilijk agentisch coderen in voor lagere kosten en latentie, wat past bij workloads als beoordelen, synthetische datageneratie en coderen op hoge schaal. Volledige gewichten worden geleverd zodra het testen is afgerond.
Inkling is meer een strategische uitspraak dan een zege op de ranglijst. Thinking Machines gokt dat organisaties die bereid zijn een model te fine-tunen en te bezitten, meer waarde halen dan uit een afgerekende call naar een gesloten frontiermodel, en Inkling is de basis die ze daarvoor aanbieden.
Ik vind die eerlijkheid verfrissend. Het bedrijf zegt ronduit dat Inkling niet het sterkste model is, wat ongebruikelijk is bij een lancering, en de benchmarks staven dat: het blijft achter bij GLM 5.2 en Kimi K2.6 op de zwaarste codeer- en redeneertests, en het ligt duidelijk achter op gesloten modellen als GPT-5.6 Sol en Gemini 3.1 Pro. Wat het in plaats daarvan biedt is breedte, native multimodale input, gekalibreerde antwoorden, stuurbare denkinspanning en de beste FORTRESS adversarial safety-score onder de vergeleken open-weights-modellen.
Als je een topscore op één benchmark wilt, is Inkling niet je keuze. Als je een open-weights-basis wilt om te fine-tunen op je eigen data, met sterke calibratie en veiligheid out-of-the-box, is het een redelijke keuze, al zijn de prijs per token en de standaard-omvangrijkheid van antwoorden iets om in de gaten te houden bij grootschalige deployments.
Als je de fine-tuningvaardigheden wilt opbouwen die een model als Inkling nuttig maken, raad ik aan te beginnen met onze AI Fundamentals skill track.
Topcursussen bij DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

