
Curso
Codificação com IA para Desenvolvedores
1 h 30 min
10.5K
A Thinking Machines, o laboratório fundado pela ex-CTO da OpenAI, Mira Murati, lançou seu primeiro modelo: o Inkling. Diferente dos modelos carro-chefe de OpenAI, Anthropic e Google, o Inkling é disponibilizado com os pesos completos para download, permitindo que desenvolvedores o modifiquem diretamente, em vez de acessá-lo apenas via API com cobrança por uso.
O Inkling é um transformer Mixture-of-Experts (MoE) com 975B parâmetros totais e 41B ativos, janela de contexto de 1M tokens e pré-treinamento em 45 trilhões de tokens de texto, imagens, áudio e vídeo.
A Thinking Machines deixa claro que ele não é o modelo mais forte disponível: a empresa afirma abertamente que o Inkling "não é o modelo mais forte disponível hoje, aberto ou fechado". A proposta combina desempenho equilibrado com um design pensado para personalização via Tinker, a plataforma de fine-tuning da empresa.
Neste artigo, vou apresentar as novidades do Inkling, destacar seus recursos, explorar os benchmarks e sugerir testes práticos que você mesmo pode executar. Também recomendo conferir nosso guia para rodar o Inkling localmente.
O Inkling é um transformer MoE open-weights com 975B parâmetros totais e 41B ativos por token, posicionado como um modelo-base abrangente para fine-tuning, e não como um chatbot para topo de ranking. É o primeiro lançamento de uma família planejada, divulgado em 15 de julho de 2026, junto com um preview de um irmão menor, o Inkling-Small.
O objetivo de design é a abrangência. A Thinking Machines treinou o Inkling em tarefas de agentes, raciocínio, programação, seguimento de instruções, factualidade, visão e áudio, em vez de otimizar para um único domínio.
Isso importa porque a aposta é que as organizações vão ajustar o modelo com seus próprios dados, e uma base ampla se adapta a mais fluxos de trabalho do que uma base estreita.
O principal diferencial anunciado é a eficiência, não o pico de benchmark. No Terminal Bench 2.1, a Thinking Machines reporta que o Inkling gasta um terço dos tokens do Nemotron 3 Ultra da NVIDIA para atingir o mesmo desempenho em código.
Para um modelo que você pode chamar milhões de vezes dentro de fluxos mais longos, essa curva de custo por token pesa mais do que um único score de máximo esforço.
O design MoE do Inkling segue em grande parte o DeepSeek-V3, com 256 experts roteados, 2 compartilhados e 6 experts roteados ativos por token, usando um roteador sigmoid com balanceamento de carga sem perda auxiliar.
A Thinking Machines intercala atenções de janela deslizante e global na proporção de 5:1 e usa embeddings posicionais relativos em vez de RoPE, relatando melhor extrapolação para sequências longas.
O pré-treinamento ocorreu em 45 trilhões de tokens multimodais usando um otimizador híbrido: Muon para pesos de matrizes grandes e Adam para os demais parâmetros.
O pós-treinamento foi iniciado com uma pequena quantidade de SFT em dados sintéticos de modelos open-weights, incluindo o Kimi K2.5, seguido por RL assíncrono em larga escala, chegando a mais de 30M rollouts em duas execuções contínuas.
Os diferenciais do Inkling estão menos na capacidade bruta e mais em como ele foi projetado para ser personalizado e controlado. Estes são os recursos que mais se destacam.
O Inkling permite definir um nível de "esforço de raciocínio" para equilibrar profundidade com custo de tokens e latência.
Você pode aumentar o esforço até 0,99 para máximo desempenho em um problema difícil ou reduzir para tarefas de alto volume, em que velocidade e custo pesam mais.
Isso é um comportamento treinado, não apenas um wrapper.
Durante o reinforcement learning em larga escala, a Thinking Machines variou o nível de esforço por amostra mudando a mensagem de sistema e ajustando o custo por token, para que o modelo aprendesse a gastar orçamentos de tokens diferentes em rollouts distintos.
A configuração de esforço pode ser passada a partir de um harness de código ou de agente.
Para quem roda cargas em produção, este é o recurso que mais merece atenção. Latência costuma ser o gargalo em ferramentas interativas, e poder controlá-la por requisição sem trocar de modelo é realmente útil.
O Inkling realiza raciocínio nativo sobre texto, imagens e áudio, com componentes multimodais treinados do zero em dados de domínio geral.
Ele transcreve fala, segue instruções por voz, responde a perguntas sobre gravações, descreve imagens e raciocina sobre gráficos e diagramas.
A arquitetura dispensa encoder.
Áudio entra como espectrogramas dMel, imagens são codificadas em patches de 40x40 pixels via um hMLP de quatro camadas, e ambos passam por uma camada de embedding leve para processamento conjunto com tokens de texto.
No lado de visão, o Inkling pode chamar uma ferramenta em Python para dar zoom e recortar durante o raciocínio, combinando raciocínio visual e baseado em código em uma única passada.
Um ponto de atenção: a entrada é multimodal, mas a saída, nas ferramentas atuais, é apenas texto. Se o seu caso de uso exige que o modelo gere imagens ou áudio diretamente, o Inkling não atende.
O Inkling foi treinado para expressar o nível certo de confiança, inclusive dizendo "não sei" quando a chance de erro é alta — algo que a Thinking Machines agrupa sob a "epistemologia" do modelo.
A empresa treinou calibração usando reinforcement learning contra regras de pontuação próprias em um grande corpus de perguntas reais já resolvidas.
Foram usados dois avaliadores automáticos no pós-treinamento: um avaliador por rubrica, que confere a resposta contra um checklist do que uma boa resposta deve conter, e um avaliador de afirmações, que verifica cada alegação factual via busca web com agentes.
O avaliador de afirmações penaliza o que não se confirma, reduzindo alucinações em vez de apenas recompensar recall.
Por que isso importa: um modelo confiante em tudo obriga você a revalidar tudo. No ForecastBench Brier Index sem busca, o Inkling marca 61,1, empatando com o Grok 4.3 e superando levemente o GPT-5.5 (59,1) e o Gemini 3.1 Pro (54,6).
O Inkling registra a maior pontuação de segurança adversarial FORTRESS entre os modelos open-weights comparados pela Thinking Machines, com 78,0%. O FORTRESS testa recusas a solicitações relacionadas a armas e violência, ao lado de consultas inofensivas parecidas; portanto, uma pontuação alta significa recusar o que é nocivo sem recusar demais o que é seguro.
Para comparação, o Nemotron 3 Ultra marcou 77,6%, o Kimi K2.5 ficou em 54,1%, o GLM 5.2 em 65,6% e o DeepSeek V4 Pro em 36,0% no mesmo conjunto adversarial.
O Inkling também atinge 98,6% no StrongREJECT, um teste de recusa a solicitações claramente nocivas, em linha com outros modelos abertos e fechados.
A questão em aberto é o que acontece após o fine-tuning.
A Thinking Machines afirma que ainda estuda como o comportamento de segurança muda quando clientes fazem fine-tuning no Tinker — uma preocupação real para qualquer modelo baixável.
O Inkling fica no meio do pelotão entre modelos open-weights: à frente do Nemotron 3 Ultra e do Kimi K2.5 na maioria dos testes de raciocínio e código, mas atrás do GLM 5.2 e do Kimi K2.6 nos mais difíceis. Contra modelos fechados de fronteira, como GPT-5.6 Sol, Gemini 3.1 Pro e Claude Fable 5, fica consistentemente atrás. Todas as pontuações abaixo são com esforço 0,99.
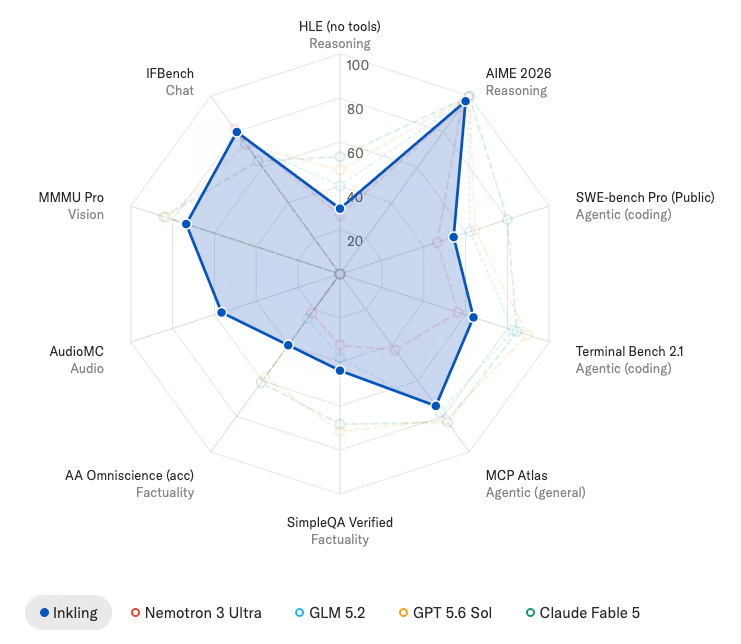
O Terminal Bench 2.1 testa programação com agentes em um ambiente de terminal.
O Inkling marca 63,8% no seu melhor harness, à frente do Nemotron 3 Ultra (56,4%) e do Kimi K2.5 (51,3%), mas bem atrás do GLM 5.2 (82,7%) e do GPT-5.6 Sol (89,5%).
É aqui que entra a alegação de eficiência em tokens: o Inkling alcança o desempenho em código do Nemotron 3 Ultra usando cerca de um terço dos tokens.
O Humanity's Last Exam (HLE) é um benchmark amplo e difícil de raciocínio.
O Inkling marca 29,7% só texto e 46,0% com ferramentas, à frente do Nemotron 3 Ultra (26,6% / 37,4%), mas atrás do GLM 5.2 (40,1% / 54,7%) e dos modelos fechados, com o GPT-5.6 Sol marcando 47,2% só texto.
O GPQA Diamond avalia questões de ciências em nível de pós-graduação.
O Inkling faz 43,9% no SimpleQA Verified, à frente do Nemotron 3 Ultra (32,4%) e do Kimi K2.5 (36,9%), mas bem atrás do Gemini 3.1 Pro (77,3%) e do GPT-5.6 Sol (71,6%). Recall factual bruto não é seu ponto forte.
Onde o Inkling se destaca é no AA Omniscience, que recompensa saber o que você não sabe.
O Inkling obtém 2,1 positivo, enquanto vários modelos abertos ficam no negativo: Kimi K2.5 em -8,0, DeepSeek V4 Pro em -10,0 e Nemotron 3 Ultra em -1,0. Essa diferença reflete o ganho do treinamento de calibração.
No MMMU Pro (Standard 10), um benchmark de raciocínio visual, o Inkling marca 73,5%, atrás do Kimi K2.6 (79,0%) e do Gemini 3.1 Pro (82,0%).
No Charxiv RQ, para raciocínio com gráficos, ele atinge 78,1%, subindo para 82,0% quando pode usar uma ferramenta em Python.
Em áudio, o Inkling marca 91,4% no VoiceBench, 77,2% no MMAU e 56,6% no Audio MC, colocando-o entre os modelos open-weights mais fortes em áudio.
O Gemini 3.1 Pro ainda lidera nos três, com 94,3%, 82,5% e 66,8%, respectivamente.
O Inkling está disponível para fine-tuning no Tinker hoje, com opções de comprimento de contexto de 64K e 256K tokens, e os pesos completos estão no Hugging Face tanto como o checkpoint original quanto como um checkpoint NVFP4 para inferência na NVIDIA Blackwell.
A Thinking Machines está oferecendo 50% de desconto por tempo limitado, com a tabela completa de preços na documentação.
Com o desconto aplicado, o preço por 1 milhão de tokens fica assim:
(Observação: embora o Tinker aumente os preços da maioria dos modelos em 17 de julho, as tarifas do Inkling estão protegidas desse reajuste. As taxas padrão de armazenamento da plataforma, de US$ 0,10 por GB/mês, continuam valendo para fine-tuning).
O suporte a deployment é amplo. Checkpoints ajustados rodam via APIs na TogetherAI, Fireworks, Modal, Databricks e Baseten, com suporte open-source de inferência em SGLang, vLLM e llama.cpp, além de uma interface de chat com busca web integrada no Inkling Playground, gratuita por tempo limitado.
Junto com o Inkling, a Thinking Machines apresentou o Inkling-Small, um MoE com 276B parâmetros e 12B ativos, contra 41B do modelo completo. Ele iguala ou supera o irmão maior em vários benchmarks graças a melhorias nos dados e na receita de pré-treinamento do modelo menor.
O Inkling-Small troca recall factual e programação agente difícil por menor custo e latência, o que combina com cargas como correção/avaliação, geração de dados sintéticos e programação em alto volume. Os pesos completos serão liberados assim que os testes forem concluídos.
O Inkling é mais uma declaração de estratégia do que uma busca por primeiro lugar em ranking. A Thinking Machines aposta que organizações dispostas a fazer fine-tuning e ter um modelo próprio extrairão mais valor do que teriam com chamadas tarifadas a um modelo fechado de fronteira — e o Inkling é a base oferecida para isso.
A franqueza chama atenção. A empresa afirma abertamente que o Inkling não é o mais forte, o que é incomum em um lançamento — e os benchmarks confirmam: ele fica atrás do GLM 5.2 e do Kimi K2.6 nos testes mais difíceis de código e raciocínio, e bem atrás de modelos fechados como GPT-5.6 Sol e Gemini 3.1 Pro. Em troca, entrega abrangência, entrada multimodal nativa, respostas calibradas, esforço de raciocínio controlável e a melhor pontuação FORTRESS de segurança adversarial entre os open-weights comparados.
Se você quer o topo em um único benchmark, o Inkling não é a melhor escolha. Se você busca uma base open-weights para ajustar com seus próprios dados, com forte calibração e segurança nativas, ele é uma opção sólida — embora o preço por token e a verbosidade padrão mereçam atenção em deployments de alto volume.
Se você quer desenvolver as habilidades de fine-tuning que tornam um modelo como o Inkling realmente útil, recomendo começar pela nossa trilha de habilidades AI Fundamentals.
Principais cursos da DataCamp
Curso
Curso
Curso
blog
Josep Ferrer
8 min
blog
Khalid Abdelaty
15 min
blog
Abid Ali Awan
9 min
blog
Richie Cotton
7 min
Tutorial
Josep Ferrer
11 min
Tutorial
Zoumana Keita
12 min





