
Corso
Programmazione assistita dall'AI per sviluppatori
1 ore 30 min
10.8K
Thinking Machines, il laboratorio fondato dall'ex CTO di OpenAI Mira Murati, ha rilasciato il suo primo modello: Inkling. A differenza dei modelli di punta di OpenAI, Anthropic e Google, Inkling viene distribuito con i pesi completi scaricabili, così gli sviluppatori possono modificarlo direttamente invece di doverlo chiamare solo tramite un'API a consumo.
Inkling è un trasformatore Mixture-of-Experts (MoE) con 975B parametri totali e 41B attivi, una finestra di contesto da 1M token e pretraining su 45 trilioni di token di testo, immagini, audio e video.
Thinking Machines è chiara sul fatto che non sia il modello più potente disponibile: l'azienda afferma apertamente che Inkling non è "il modello complessivamente più forte disponibile oggi, open o closed". La proposta punta a prestazioni equilibrate e a un design pensato per essere personalizzato tramite Tinker, la piattaforma di fine-tuning dell'azienda.
In questo articolo, vedrò tutte le novità di Inkling, esaminandone le funzionalità, esplorando i benchmark e proponendo test pratici che puoi eseguire tu stesso. Ti consiglio anche di consultare la nostra guida per eseguire Inkling in locale.
Inkling è un trasformatore MoE a pesi aperti con 975B parametri totali e 41B attivi per token, posizionato come modello base ampio per il fine-tuning più che come chatbot da top di classifica. È il primo rilascio di una famiglia pianificata, pubblicato il 15 luglio 2026 insieme a un'anteprima del fratello minore, Inkling-Small.
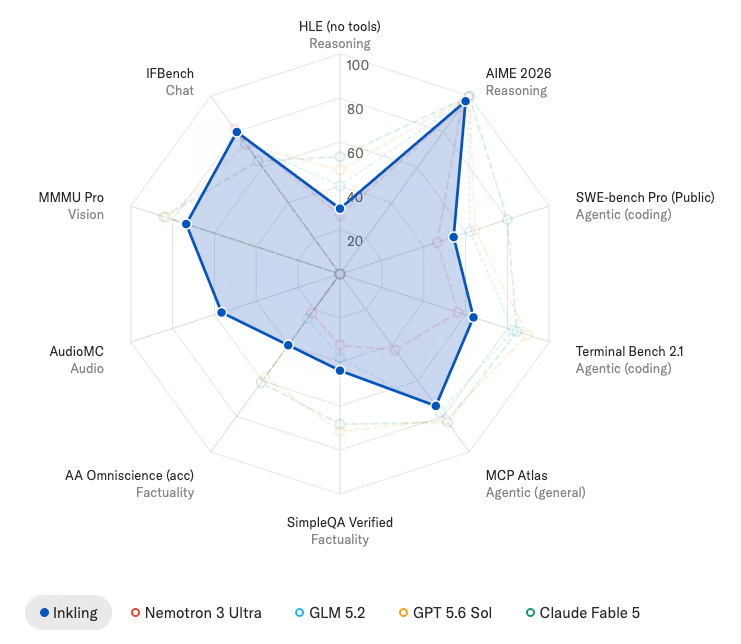
L'obiettivo progettuale è l'ampiezza. Thinking Machines ha addestrato Inkling su compiti di agentic, ragionamento, coding, instruction-following, factuality, visione e audio invece di ottimizzare per un singolo dominio.
Conta perché l'azienda scommette che le organizzazioni faranno fine-tuning del modello sui propri dati, e una base ampia si adatta a più flussi di lavoro rispetto a una ristretta.
La principale rivendicazione di capacità è l'efficienza più che un picco nei benchmark. Su Terminal Bench 2.1, Thinking Machines riporta che Inkling consuma un terzo dei token rispetto a Nemotron 3 Ultra di NVIDIA per raggiungere la stessa performance in coding.
Per un modello che potresti eseguire milioni di volte all'interno di flussi più lunghi, quella curva di costo in token conta più di un singolo punteggio al massimo sforzo.
Il design MoE di Inkling segue in gran parte DeepSeek-V3, con 256 expert instradati, 2 expert condivisi e 6 expert instradati attivi per token, usando un router sigmoide con bilanciamento del carico senza perdita ausiliaria.
Thinking Machines interseca attenzione a finestra scorrevole e attenzione globale con un rapporto 5:1 e usa embedding posizionali relativi invece di RoPE, riportando una migliore extrapolazione a sequenze più lunghe.
Il pretraining è stato eseguito su 45 trilioni di token multimodali usando un ottimizzatore ibrido: Muon per i pesi delle grandi matrici e Adam per gli altri parametri.
Il post-training è stato avviato con una piccola quantità di SFT su dati sintetici da modelli a pesi aperti, incluso Kimi K2.5, seguito da RL asincrono su larga scala fino a oltre 30M rollout in due run continui.
I tratti distintivi di Inkling risiedono meno nella capacità grezza e più nel modo in cui è costruito per essere personalizzato e controllato. Ecco le funzionalità che spiccano.
Inkling ti permette di impostare un livello di "sforzo di pensiero" per bilanciare approfondimento rispetto a costo in token e latenza.
Puoi spingere lo sforzo a 0,99 per la massima performance su un problema difficile, oppure abbassarlo per un'attività ad alto volume dove velocità e costi prevalgono.
È un comportamento addestrato, non un wrapper.
Durante l'RL su larga scala, Thinking Machines ha variato il livello di sforzo per campione modificando il messaggio di sistema e regolando il costo per token, così il modello ha imparato a spendere budget di token diversi in rollout differenti.
L'impostazione dello sforzo può essere passata dall'interno di un harness di coding o di un agente.
Per chi gestisce carichi in produzione, questa è la funzione che mi interessa di più. La latenza è spesso il vincolo principale per gli strumenti interattivi, e poterla controllare per richiesta senza cambiare modello è davvero utile.
Inkling ragiona in modo nativo su testo, immagini e audio, con componenti multimodali addestrati da zero su dati di dominio generale.
Può trascrivere parlato, seguire istruzioni vocali, rispondere a domande su registrazioni, descrivere immagini e ragionare su grafici e diagrammi.
L'architettura è senza encoder.
L'audio è fornito come spettrogrammi dMel, le immagini sono codificate come patch da 40x40 pixel tramite un hMLP a quattro strati, e entrambi passano attraverso un layer di embedding leggero per essere elaborati congiuntamente con i token di testo.
Sul fronte visivo, Inkling può chiamare uno strumento Python per zoom e crop durante il ragionamento, combinando in un unico passaggio ragionamento visivo e basato su codice.
Una precisazione utile: l'input è multimodale, ma l'output negli strumenti attuali è solo testuale. Se il tuo caso d'uso richiede che il modello generi direttamente immagini o audio, Inkling non lo fa.
Inkling è addestrato a esprimere il giusto livello di fiducia, incluso dire "Non lo so" quando è probabile che sbagli, aspetto che Thinking Machines raggruppa sotto le "epistemiche" del modello.
L'azienda ha addestrato la calibrazione usando reinforcement learning con scoring rule appropriate su un ampio corpus di domande reali risolte.
In post-training sono stati usati due valutatori automatici: un rubric grader che controlla una risposta rispetto a una checklist di cosa dovrebbe contenere una buona risposta, e un claims grader che verifica ogni affermazione fattuale tramite ricerca web agentica.
Il claims grader penalizza le affermazioni che non risultano verificate, riducendo le allucinazioni invece di premiare solo il richiamo.
Perché importa: un modello sicuro di ogni risposta ti costringe a ricontrollare tutto. Su ForecastBench Brier Index senza ricerca, Inkling segna 61,1, in linea con Grok 4.3 e poco sopra GPT-5.5 a 59,1 e Gemini 3.1 Pro a 54,6.
Inkling registra il punteggio di sicurezza avversaria FORTRESS più alto tra i modelli open-weights confrontati da Thinking Machines, al 78,0%. FORTRESS testa il rifiuto di richieste legate ad armi e violenza insieme a query innocue simili, quindi un punteggio alto significa rifiutare richieste dannose senza rifiutare eccessivamente quelle sicure.
Per confronto, Nemotron 3 Ultra ha segnato 77,6%, Kimi K2.5 54,1%, GLM 5.2 65,6% e DeepSeek V4 Pro 36,0% sullo stesso set avversario.
Inkling supera anche il 98,6% su StrongREJECT, un test di rifiuto di richieste chiaramente dannose, in linea con altri modelli open e closed.
La domanda aperta è cosa succede dopo il fine-tuning.
Thinking Machines afferma di stare ancora studiando come la sicurezza si modifichi quando i clienti fanno fine-tuning su Tinker, il che è una preoccupazione reale per qualsiasi modello scaricabile.
Inkling si posiziona a metà tra i modelli open-weights: avanti a Nemotron 3 Ultra e Kimi K2.5 nella maggior parte dei test di ragionamento e coding, ma dietro a GLM 5.2 e Kimi K2.6 nei più difficili. Contro modelli frontier closed come GPT-5.6 Sol, Gemini 3.1 Pro e Claude Fable 5, è costantemente indietro. Tutti i punteggi sotto sono riportati con sforzo 0,99.
Terminal Bench 2.1 testa il coding agentico in un ambiente terminale.
Inkling segna il 63,8% sul suo harness migliore, davanti a Nemotron 3 Ultra al 56,4% e Kimi K2.5 al 51,3%, ma ben dietro a GLM 5.2 all'82,7% e GPT-5.6 Sol all'89,5%.
Qui entra in gioco la rivendicazione di efficienza in token: Inkling raggiunge la performance di coding di Nemotron 3 Ultra usando circa un terzo dei token.
Humanity's Last Exam (HLE) è un benchmark di ragionamento ampio e difficile.
Inkling segna il 29,7% solo testo e il 46,0% con strumenti, davanti a Nemotron 3 Ultra (26,6% / 37,4%) ma dietro a GLM 5.2 (40,1% / 54,7%) e ai modelli closed, con GPT-5.6 Sol al 47,2% solo testo.
GPQA Diamond testa domande di scienze a livello graduate.
Inkling segna il 43,9% su SimpleQA Verified, davanti a Nemotron 3 Ultra al 32,4% e Kimi K2.5 al 36,9%, ma molto dietro a Gemini 3.1 Pro al 77,3% e GPT-5.6 Sol al 71,6%. Il richiamo fattuale grezzo non è il suo punto di forza.
Dove Inkling spicca è AA Omniscience, che premia il sapere ciò che non si sa.
Inkling segna un positivo 2,1, mentre diversi modelli open vanno in negativo: Kimi K2.5 a -8,0, DeepSeek V4 Pro a -10,0 e Nemotron 3 Ultra a -1,0. Questo divario riflette l'efficacia dell'addestramento alla calibrazione.
Su MMMU Pro (Standard 10), un benchmark di ragionamento visivo, Inkling segna il 73,5%, dietro a Kimi K2.6 al 79,0% e Gemini 3.1 Pro all'82,0%.
Su Charxiv RQ per il ragionamento su grafici, arriva al 78,1%, salendo all'82,0% quando è consentito uno strumento Python.
Per l'audio, Inkling segna il 91,4% su VoiceBench, il 77,2% su MMAU e il 56,6% su Audio MC, collocandosi tra i modelli audio open-weights più forti.
Gemini 3.1 Pro resta in testa su tutti e tre, rispettivamente al 94,3%, 82,5% e 66,8%.
Inkling è disponibile per il fine-tuning su Tinker oggi, con opzioni di lunghezza del contesto da 64K e 256K token, e i pesi completi sono su Hugging Face sia come checkpoint originale sia come checkpoint NVFP4 per l'inferenza su NVIDIA Blackwell.
Thinking Machines offre uno sconto del 50% per un periodo limitato, con prezzi completi nella documentazione.
Con questo sconto applicato, il prezzo per 1 milione di token è il seguente:
(Nota: mentre Tinker aumenterà i prezzi per la maggior parte dei modelli il 17 luglio, le tariffe di Inkling sono protette da questo aumento. Le tariffe standard di storage della piattaforma di $0,10 per GB/mese si applicano comunque per il fine-tuning).
Il supporto al deployment è ampio. I checkpoint fine-tuned sono eseguibili via API su TogetherAI, Fireworks, Modal, Databricks e Baseten, con supporto open-source all'inferenza in SGLang, vLLM e llama.cpp, oltre a un'interfaccia chat con ricerca web integrata nell'Inkling Playground, gratuita per un periodo limitato.
Insieme a Inkling, Thinking Machines ha presentato in anteprima Inkling-Small, un MoE da 276B parametri con 12B attivi rispetto ai 41B del modello completo. Eguaglia o supera il fratello maggiore in diversi benchmark grazie a miglioramenti ai dati e alla ricetta di pre-training del modello più piccolo.
Inkling-Small scambia richiamo fattuale e coding agentico difficile per costi e latenza inferiori, adatti a carichi come valutazione, generazione di dati sintetici e coding ad alto volume. I pesi completi saranno pubblicati una volta completati i test.
Inkling è più una dichiarazione di strategia che una vittoria in classifica. Thinking Machines scommette che le organizzazioni disposte a fare fine-tuning e possedere un modello otterranno più valore rispetto a una chiamata a consumo a un modello frontier chiuso, e Inkling è la base che offrono per questo.
Trovo l'onestà rinfrescante. L'azienda dice esplicitamente che Inkling non è il modello più forte, cosa insolita per un lancio, e i benchmark lo confermano: è dietro a GLM 5.2 e Kimi K2.6 nei test di coding e ragionamento più difficili, e resta ben dietro ai modelli chiusi come GPT-5.6 Sol e Gemini 3.1 Pro. Ciò che offre invece è ampiezza, input multimodale nativo, risposte calibrate, sforzo di ragionamento controllabile e il miglior punteggio di sicurezza avversaria FORTRESS tra i modelli open-weights confrontati.
Se vuoi un punteggio al top in un singolo benchmark, Inkling non è la tua scelta. Se vuoi una base open-weights su cui fare fine-tuning sui tuoi dati, con calibrazione e sicurezza solide già pronte, è una scelta ragionevole, anche se il prezzo per token e la verbosità predefinita vanno tenuti d'occhio per le distribuzioni ad alto volume.
Se vuoi sviluppare le competenze di fine-tuning che rendono utile un modello come Inkling, ti consiglio di iniziare con il nostro percorso di competenze AI Fundamentals.
I migliori corsi DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



