Curso
Programación asistida por IA para desarrolladores
1 h 30 min
10.8K
Thinking Machines, el laboratorio fundado por la ex CTO de OpenAI Mira Murati, ha lanzado su primer modelo: Inkling. A diferencia de los modelos insignia de OpenAI, Anthropic y Google, Inkling se publica con los pesos completos disponibles para descargar, de modo que los desarrolladores pueden modificarlo directamente en lugar de utilizarlo solo a través de una API con tarificación por uso.
Inkling es un transformer Mixture-of-Experts (MoE) con 975B parámetros totales y 41B activos, una ventana de contexto de 1M tokens y preentrenamiento con 45 billones de tokens de texto, imágenes, audio y vídeo.
Thinking Machines es clara al admitir que no es el modelo más potente: la empresa afirma sin rodeos que Inkling no es "el modelo más fuerte disponible hoy, abierto o cerrado". Su propuesta es un rendimiento equilibrado y un diseño pensado para personalizarse mediante Tinker, la plataforma de fine-tuning de la compañía.
En este artículo, repaso todo lo nuevo de Inkling: sus funciones, los benchmarks y pruebas prácticas que puedes ejecutar tú mismo. También te recomiendo consultar nuestra guía para ejecutar Inkling en local.
Inkling es un transformer MoE de pesos abiertos con 975B parámetros totales y 41B activos por token, concebido como un modelo base amplio para fine-tuning más que como un chatbot líder en rankings. Es el primer lanzamiento de una familia planificada, publicado el 15 de julio de 2026 junto con un avance de su hermano menor, Inkling-Small.
El objetivo de diseño es la amplitud. Thinking Machines entrenó Inkling en tareas de agentes, razonamiento, programación, seguimiento de instrucciones, factualidad, visión y audio, en lugar de optimizarlo para un único dominio.
Esto importa porque la apuesta de la empresa es que las organizaciones harán fine-tuning con sus propios datos, y una base amplia se adapta a más flujos de trabajo que una estrecha.
La promesa principal es la eficiencia, más que un pico en benchmarks. En Terminal Bench 2.1, Thinking Machines informa de que Inkling consume un tercio de los tokens que Nemotron 3 Ultra de NVIDIA para alcanzar el mismo rendimiento en programación.
Para un modelo que quizás ejecutes millones de veces dentro de flujos de trabajo largos, esa curva de coste por token importa más que una puntuación máxima aislada.
El diseño MoE de Inkling sigue en gran medida a DeepSeek-V3, con 256 expertos enrutados, 2 expertos compartidos y 6 expertos enrutados activos por token, usando un router sigmoide con balanceo de carga sin pérdida auxiliar.
Thinking Machines alterna atención de ventana deslizante y global en una proporción 5:1 y utiliza embeddings posicionales relativos en lugar de RoPE, lo que según informan mejora la extrapolación a secuencias más largas.
El preentrenamiento se realizó con 45 billones de tokens multimodales usando un optimizador híbrido: Muon para pesos de matrices grandes y Adam para el resto de parámetros.
El post-entrenamiento se arrancó con una pequeña cantidad de SFT sobre datos sintéticos de modelos de pesos abiertos, como Kimi K2.5, seguido de RL asíncrono a gran escala con más de 30M de rollouts en dos ejecuciones continuas.
Los diferenciales de Inkling no están tanto en la capacidad bruta como en cómo está pensado para personalizarse y controlarse. Estas son las funciones más destacadas.
Inkling te permite establecer un nivel de "esfuerzo de pensamiento" para equilibrar exhaustividad frente a coste en tokens y latencia.
Puedes subir el esfuerzo a 0.99 para máximo rendimiento en un problema difícil o bajarlo para una tarea de alto volumen donde primen la velocidad y el coste.
Es un comportamiento entrenado, no un simple envoltorio.
Durante el aprendizaje por refuerzo a gran escala, Thinking Machines varió el nivel de esfuerzo por muestra cambiando el mensaje del sistema y ajustando el coste por token, de forma que el modelo aprendió a gastar distintos presupuestos de tokens en diferentes rollouts.
El ajuste de esfuerzo puede pasarse desde un arnés de código o de agentes.
Para quienes ejecutan cargas en producción, esta es la función más interesante. La latencia suele ser la restricción clave en herramientas interactivas, y poder controlarla por solicitud sin cambiar de modelo es realmente útil.
Inkling razona de forma nativa sobre texto, imágenes y audio, con componentes multimodales entrenados desde cero en datos de dominio general.
Puede transcribir voz, seguir instrucciones habladas, responder preguntas sobre grabaciones, describir imágenes y razonar sobre gráficos y diagramas.
La arquitectura no usa encoder.
El audio entra como espectrogramas dMel; las imágenes se codifican en parches de 40x40 píxeles mediante una hMLP de cuatro capas; y ambos pasan por una capa de embeddings ligera para procesarse conjuntamente con tokens de texto.
En visión, Inkling puede llamar a una herramienta en Python para hacer zoom y recortar mientras razona, combinando razonamiento visual y basado en código en una sola pasada.
Un matiz importante: la entrada es multimodal, pero la salida en las herramientas actuales es solo texto. Si tu caso de uso requiere que el modelo genere imágenes o audio directamente, Inkling no lo hace.
Inkling está entrenado para expresar el grado adecuado de confianza, incluyendo decir "no lo sé" cuando es probable que falle; Thinking Machines engloba esto bajo la "epistémica" del modelo.
La empresa entrenó la calibración con aprendizaje por refuerzo frente a reglas de puntuación propias sobre un gran corpus de preguntas reales ya resueltas.
Usaron dos evaluadores automáticos en el post-entrenamiento: un evaluador por rúbrica que contrasta la respuesta con una lista de control de lo que debe contener una buena respuesta, y un evaluador de afirmaciones que verifica cada hecho mediante búsqueda web con agentes.
El evaluador de afirmaciones penaliza los enunciados que no se verifican, lo que reduce las alucinaciones en lugar de limitarse a premiar el recuerdo.
¿Por qué importa? Porque un modelo confiado en todo te obliga a revisarlo todo. En ForecastBench (índice de Brier) sin búsqueda, Inkling obtiene 61.1, igualando a Grok 4.3 y superando ligeramente a GPT-5.5 con 59.1 y a Gemini 3.1 Pro con 54.6.
Inkling presenta la puntuación de seguridad adversaria FORTRESS más alta entre los modelos de pesos abiertos comparados por Thinking Machines, con un 78.0%. FORTRESS evalúa la negativa ante solicitudes sobre armas y violencia junto a consultas inofensivas parecidas, así que una alta puntuación implica rechazar lo dañino sin sobre-rechazar lo seguro.
Como referencia, Nemotron 3 Ultra obtuvo 77.6%, Kimi K2.5 54.1%, GLM 5.2 65.6% y DeepSeek V4 Pro 36.0% en el mismo conjunto adversario.
Inkling también alcanza un 98.6% en StrongREJECT, una prueba de rechazo de solicitudes dañinas inequívocas, en línea con otros modelos abiertos y cerrados.
La incógnita es qué ocurre tras el fine-tuning.
Thinking Machines afirma que sigue estudiando cómo cambia el comportamiento de seguridad cuando los clientes hacen fine-tuning en Tinker, una preocupación real para cualquier modelo descargable.
Inkling se sitúa en la mitad del grupo entre los modelos de pesos abiertos: por delante de Nemotron 3 Ultra y Kimi K2.5 en la mayoría de pruebas de razonamiento y código, pero por detrás de GLM 5.2 y Kimi K2.6 en las más exigentes. Frente a modelos cerrados de frontera como GPT-5.6 Sol, Gemini 3.1 Pro y Claude Fable 5, queda consistentemente por detrás. Todas las puntuaciones siguientes se informan con esfuerzo 0.99.
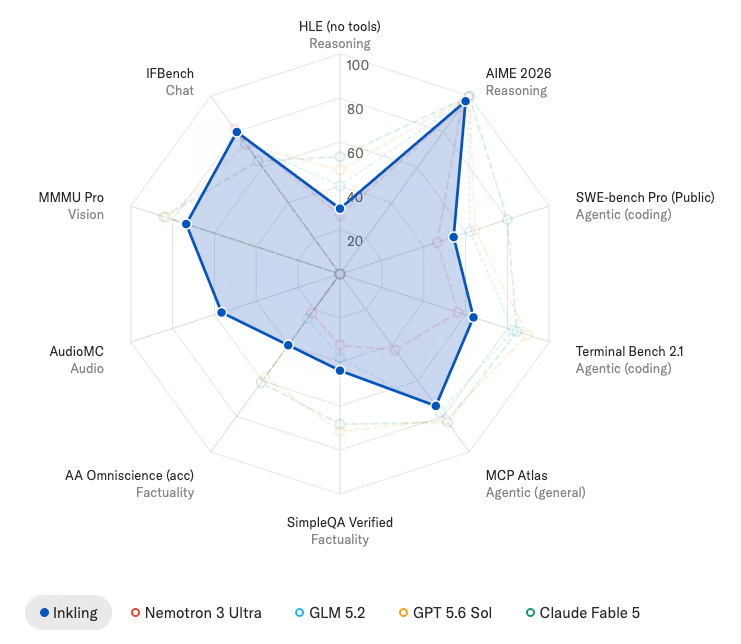
Terminal Bench 2.1 evalúa la programación con agentes en un entorno de terminal.
Inkling logra un 63.8% en su mejor arnés, por delante de Nemotron 3 Ultra con 56.4% y Kimi K2.5 con 51.3%, pero lejos de GLM 5.2 con 82.7% y GPT-5.6 Sol con 89.5%.
Aquí entra la promesa de eficiencia en tokens: Inkling alcanza el rendimiento en programación de Nemotron 3 Ultra usando aproximadamente un tercio de los tokens.
Humanity's Last Exam (HLE) es un benchmark exigente y amplio de razonamiento.
Inkling obtiene 29.7% solo texto y 46.0% con herramientas, por delante de Nemotron 3 Ultra (26.6% / 37.4%) pero por detrás de GLM 5.2 (40.1% / 54.7%) y de los modelos cerrados, con GPT-5.6 Sol en 47.2% solo texto.
GPQA Diamond evalúa preguntas de ciencias a nivel de posgrado.
Inkling logra 43.9% en SimpleQA Verified, por delante de Nemotron 3 Ultra con 32.4% y Kimi K2.5 con 36.9%, pero muy por detrás de Gemini 3.1 Pro con 77.3% y GPT-5.6 Sol con 71.6%. El recuerdo factual bruto no es su punto fuerte.
Donde destaca Inkling es en AA Omniscience, que premia saber lo que no sabes.
Inkling obtiene un 2.1 positivo, mientras que varios modelos abiertos dan negativo: Kimi K2.5 con -8.0, DeepSeek V4 Pro con -10.0 y Nemotron 3 Ultra con -1.0. Esa diferencia refleja que el entrenamiento en calibración da frutos.
En MMMU Pro (Standard 10), un benchmark de razonamiento visual, Inkling consigue 73.5%, por detrás de Kimi K2.6 con 79.0% y Gemini 3.1 Pro con 82.0%.
En Charxiv RQ para razonamiento sobre gráficos, alcanza 78.1%, subiendo a 82.0% cuando se le permite usar una herramienta en Python.
En audio, Inkling obtiene 91.4% en VoiceBench, 77.2% en MMAU y 56.6% en Audio MC, situándose entre los modelos de audio de pesos abiertos más fuertes.
Gemini 3.1 Pro sigue liderando en los tres, con 94.3%, 82.5% y 66.8% respectivamente.
Inkling está disponible hoy para fine-tuning en Tinker, con opciones de longitud de contexto de 64K y 256K tokens, y los pesos completos están en Hugging Face tanto como checkpoint original como en un checkpoint NVFP4 para inferencia en NVIDIA Blackwell.
Thinking Machines ofrece un 50% de descuento por tiempo limitado, con los precios completos en su documentación.
Con el descuento aplicado, el precio por 1 millón de tokens queda así:
(Nota: aunque Tinker sube precios para la mayoría de modelos el 17 de julio, las tarifas de Inkling no se ven afectadas. Se siguen aplicando las tarifas estándar de almacenamiento en la plataforma de 0,10 $ por GB/mes para fine-tuning).
El soporte de despliegue es amplio. Los checkpoints afinados se ejecutan vía API en TogetherAI, Fireworks, Modal, Databricks y Baseten; hay soporte de inferencia open source en SGLang, vLLM y llama.cpp; y un chat con búsqueda web integrada en Inkling Playground, gratis por tiempo limitado.
Junto con Inkling, Thinking Machines presentó Inkling-Small, un MoE de 276B parámetros con 12B activos frente a 41B del modelo completo. Igual a o supera a su hermano mayor en varios benchmarks gracias a mejoras en los datos y la receta de preentrenamiento del modelo pequeño.
Inkling-Small sacrifica recuerdo factual y programación agente compleja a cambio de menor coste y latencia, lo que encaja con cargas como evaluación, generación de datos sintéticos y programación de alto volumen. Los pesos completos se publicarán cuando termine la fase de pruebas.
Inkling es más una declaración de estrategia que una victoria en rankings. Thinking Machines apuesta a que las organizaciones dispuestas a hacer fine-tuning y "poseer" un modelo obtendrán más valor que con llamadas medidas a un modelo cerrado de frontera, e Inkling es la base que ofrecen para eso.
La honestidad se agradece. La empresa dice abiertamente que Inkling no es el modelo más fuerte, algo inusual en un lanzamiento, y los benchmarks lo confirman: queda por detrás de GLM 5.2 y Kimi K2.6 en las pruebas más duras de código y razonamiento, y bastante por detrás de modelos cerrados como GPT-5.6 Sol y Gemini 3.1 Pro. A cambio ofrece amplitud, entrada multimodal nativa, respuestas calibradas, esfuerzo de razonamiento controlable y la mejor puntuación de seguridad adversaria FORTRESS entre los modelos de pesos abiertos comparados.
Si buscas el primer puesto en un benchmark concreto, Inkling no es tu elección. Si quieres una base de pesos abiertos para afinar con tus propios datos, con buena calibración y seguridad de serie, es una opción sensata, aunque para despliegues de alto volumen conviene vigilar el precio por token y la verbosidad por defecto.
Si te interesa desarrollar las habilidades de fine-tuning que hacen útil un modelo como Inkling, te recomiendo empezar con nuestro itinerario de habilidades AI Fundamentals.
Los mejores cursos de DataCamp
Curso
Curso
Curso
blog
Abid Ali Awan
9 min
blog
Matt Crabtree
13 min
blog
Josep Ferrer
8 min
blog
Abid Ali Awan
9 min
blog
Abid Ali Awan
10 min
Tutorial
Josep Ferrer
11 min