Kurs
KI-gestütztes Programmieren für Entwickler
1 Std. 30 Min.
11.6K
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleThinking Machines, das von der ehemaligen OpenAI-CTO Mira Murati gegründete Labor, hat sein erstes Modell veröffentlicht: Inkling. Anders als die Flaggschiffmodelle von OpenAI, Anthropic und Google kommt Inkling mit vollständig verfügbaren Gewichten zum Herunterladen, sodass Entwickler es direkt anpassen können, statt es nur über eine abgerechnete API aufzurufen.
Inkling ist ein Mixture-of-Experts-Transformer (MoE) mit insgesamt 975B Parametern und 41B aktiven Parametern, einem Kontextfenster von 1M Tokens sowie Pretraining auf 45 Billionen Tokens aus Text, Bildern, Audio und Video.
Thinking Machines macht keinen Hehl daraus, dass es nicht das stärkste verfügbare Modell ist: Das Unternehmen sagt offen, Inkling sei „nicht das stärkste insgesamt verfügbare Modell, offen oder geschlossen“. Das Versprechen lautet: ausgewogene Leistung plus ein Design, das über Tinker, die hauseigene Fine-Tuning-Plattform, gezielt anpassbar ist.
In diesem Artikel zeige ich alles Neue an Inkling, gehe auf die Funktionen ein, beleuchte Benchmarks und schlage praktische Tests vor, die du selbst durchführen kannst. Lies dazu auch unseren Guide zum lokalen Ausführen von Inkling.
Inkling ist ein Open-Weights-MoE-Transformer mit insgesamt 975B Parametern und 41B aktiven pro Token, positioniert als breite Basis für Fine-Tuning statt als Spitzen-Chatbot für Bestenlisten. Es ist die erste Veröffentlichung einer geplanten Modellfamilie, erschienen am 15. Juli 2026, zusammen mit einer Vorschau auf das kleinere Geschwistermodell Inkling-Small.
Das Entwicklungsziel ist Breite. Thinking Machines hat Inkling für agentische Aufgaben, Reasoning, Coding, Anweisungsbefolgung, Faktentreue sowie für Vision- und Audioaufgaben trainiert, anstatt für eine einzelne Domäne zu optimieren.
Das ist wichtig, weil das Unternehmen darauf setzt, dass Organisationen das Modell mit eigenen Daten feinabstimmen, und eine breite Basis passt besser zu mehr Workflows als eine enge.
Die zentrale Leistungsbehauptung ist Effizienz statt Spitzenwert. Auf dem Terminal Bench 2.1 benötigt Inkling laut Thinking Machines nur ein Drittel so viele Tokens wie NVIDIAs Nemotron 3 Ultra, um dieselbe Coding-Performance zu erreichen.
Wenn ein Modell millionenfach in längeren Workflows läuft, zählt diese Token-Kostenkurve mehr als ein einzelner Maximalwert.
Inklings MoE-Design folgt weitgehend DeepSeek-V3, mit 256 gerouteten Experten, 2 geteilten Experten und 6 pro Token aktiven gerouteten Experten. Es verwendet einen Sigmoid-Router mit Load-Balancing ohne Zusatzverlust.
Thinking Machines verschachtelt Sliding-Window- und globale Attention im Verhältnis 5:1 und nutzt relative Positions-Embeddings statt RoPE, was laut Bericht besser auf längere Sequenzen extrapoliert.
Das Pretraining lief auf 45 Billionen multimodalen Tokens mit einem hybriden Optimierer: Muon für große Matrixgewichte und Adam für andere Parameter.
Das Post-Training wurde mit einer kleinen Menge SFT auf synthetischen Daten aus Open-Weights-Modellen, darunter Kimi K2.5, gestartet, gefolgt von großskaligem asynchronem RL mit über 30M Rollouts über zwei kontinuierliche Läufe.
Die Besonderheiten von Inkling liegen weniger in der rohen Leistungsstärke, sondern in der Möglichkeit, es gezielt anzupassen und zu steuern. Das sind die auffälligsten Features.
Inkling erlaubt es dir, einen „Denkaufwand“ festzulegen, um Gründlichkeit gegen Tokenkosten und Latenz abzuwägen.
Du kannst den Aufwand auf 0,99 hochdrehen, um bei harten Problemen maximale Leistung zu erzielen, oder für volumenstarke Aufgaben mit Fokus auf Geschwindigkeit und Kosten niedrig ansetzen.
Das ist erlerntes Verhalten, kein Wrapper.
Während des großskaligen Reinforcement Learning variierte Thinking Machines den Aufwand pro Beispiel, indem die Systemnachricht geändert und die Kosten pro Token angepasst wurden. So lernte das Modell, je nach Rollout unterschiedliche Tokenbudgets einzusetzen.
Die Aufwandseinstellung kann aus einem Coding- oder Agenten-Harness heraus übergeben werden.
Für Praktiker mit Produktions-Workloads ist das das relevanteste Feature. Latenz ist oft der Engpass für interaktive Tools, und sie pro Anfrage steuern zu können, ohne das Modell zu wechseln, ist wirklich hilfreich.
Inkling schließt nativ von Text, Bildern und Audio, mit von Grund auf auf allgemeinen Daten trainierten Multimodal-Komponenten.
Es kann Sprache transkribieren, gesprochene Anweisungen befolgen, Fragen zu Aufnahmen beantworten, Bilder beschreiben sowie über Diagramme und Charts schlussfolgern.
Die Architektur kommt ohne separaten Encoder aus.
Audio wird als dMel-Spektrogramm eingespeist, Bilder werden als 40x40-Pixel-Patches durch ein vierlagiges hMLP kodiert, und beides durchläuft eine schlanke Embedding-Schicht, um gemeinsam mit Texttokens verarbeitet zu werden.
Auf der Vision-Seite kann Inkling ein Python-Tool aufrufen, um beim Reasoning zu zoomen und zuzuschneiden, sodass visuelles und codebasiertes Reasoning in einem Durchgang kombiniert wird.
Ein wichtiger Hinweis: Die Eingabe ist multimodal, die Ausgabe in den aktuellen Tools jedoch nur Text. Wenn dein Use Case erfordert, dass das Modell direkt Bilder oder Audio generiert, leistet Inkling das nicht.
Inkling ist darauf trainiert, das passende Maß an Selbstvertrauen zu zeigen und „Ich weiß es nicht“ zu sagen, wenn es vermutlich falsch liegen würde. Thinking Machines fasst das unter den „Epistemics“ des Modells zusammen.
Für Kalibrierung wurde per Reinforcement Learning gegen Proper-Scoring-Regeln auf einem großen Korpus gelöster Realweltfragen trainiert.
Im Post-Training kamen zwei automatische Bewerter zum Einsatz: ein Rubrik-Bewerter, der eine Antwort gegen eine Checkliste guter Inhalte prüft, und ein Claims-Bewerter, der jede Tatsachenbehauptung per agentischer Websuche verifiziert.
Der Claims-Bewerter bestraft nicht belegbare Aussagen, was Halluzinationen reduziert, statt nur reines Erinnern zu belohnen.
Warum das zählt: Ein Modell, das bei jeder Antwort maximal selbstsicher ist, zwingt dich zum Dauerdoppelcheck. Auf dem ForecastBench Brier Index ohne Suche erzielt Inkling 61,1, gleichauf mit Grok 4.3 und vor GPT-5.5 mit 59,1 sowie Gemini 3.1 Pro mit 54,6.
Inkling erzielt mit 78,0% den stärksten FORTRESS-Adversarial-Safety-Score unter den verglichenen Open-Weights-Modellen. FORTRESS prüft die Verweigerung von Anfragen zu Waffen und Gewalt neben harmlosen, ähnlich klingenden Anfragen. Ein hoher Score bedeutet, schädliche Anfragen abzulehnen, ohne harmlose übermäßig zu blockieren.
Zum Vergleich: Nemotron 3 Ultra erzielte 77,6%, Kimi K2.5 54,1%, GLM 5.2 65,6% und DeepSeek V4 Pro 36,0% im selben Adversarial-Set.
Inkling erreicht außerdem 98,6% auf StrongREJECT, einem Verweigerungstest für eindeutig schädliche Anfragen, im Einklang mit anderen offenen und geschlossenen Modellen.
Offen bleibt die Frage, was nach dem Fine-Tuning passiert.
Thinking Machines untersucht noch, wie sich das Sicherheitsverhalten verändert, wenn Kunden auf Tinker feinabstimmen. Das ist bei jedem herunterladbaren Modell ein berechtigtes Thema.
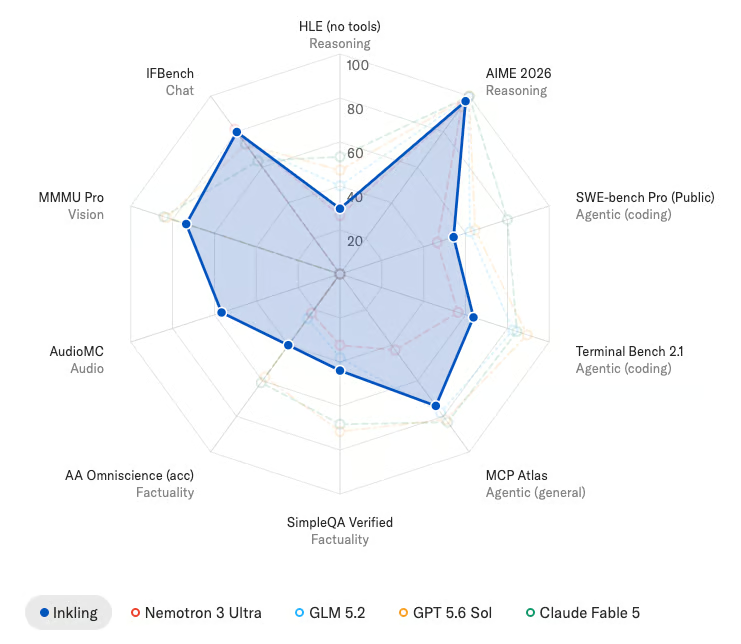
Inkling landet im Mittelfeld der Open-Weights-Modelle: vor Nemotron 3 Ultra und Kimi K2.5 bei den meisten Reasoning- und Coding-Tests, aber hinter GLM 5.2 und Kimi K2.6 bei den schwersten Aufgaben. Gegen geschlossene Spitzenmodelle wie GPT-5.6 Sol, Gemini 3.1 Pro und Claude Fable 5 liegt es durchgehend zurück. Alle untenstehenden Werte sind bei Aufwand 0,99 gemessen.
Terminal Bench 2.1 testet agentisches Coding in einer Terminalumgebung.
Inkling erzielt 63,8% auf seinem besten Harness, vor Nemotron 3 Ultra mit 56,4% und Kimi K2.5 mit 51,3%, aber deutlich hinter GLM 5.2 mit 82,7% und GPT-5.6 Sol mit 89,5%.
Hier greift der Token-Effizienzvorteil: Inkling erreicht die Coding-Performance von Nemotron 3 Ultra mit rund einem Drittel der Tokens.
Humanity’s Last Exam (HLE) ist ein harter, breiter Reasoning-Benchmark.
Inkling erzielt 29,7% nur Text und 46,0% mit Tools, vor Nemotron 3 Ultra (26,6% / 37,4%), aber hinter GLM 5.2 (40,1% / 54,7%) und den geschlossenen Modellen, mit GPT-5.6 Sol bei 47,2% nur Text.
GPQA Diamond prüft Fragen auf Graduiertenniveau in den Naturwissenschaften.
Inkling kommt auf 43,9% bei SimpleQA Verified, vor Nemotron 3 Ultra mit 32,4% und Kimi K2.5 mit 36,9%, aber weit hinter Gemini 3.1 Pro mit 77,3% und GPT-5.6 Sol mit 71,6%. Reine Faktenerinnerung ist nicht seine Stärke.
Heraus ragt Inkling bei AA Omniscience, das honoriert, wenn ein Modell seine Grenzen kennt.
Inkling erzielt dort +2,1, während mehrere offene Modelle negativ liegen: Kimi K2.5 bei -8,0, DeepSeek V4 Pro bei -10,0 und Nemotron 3 Ultra bei -1,0. Diese Lücke zeigt, dass das Kalibrierungstraining greift.
Bei MMMU Pro (Standard 10), einem Vision-Reasoning-Benchmark, erzielt Inkling 73,5%, hinter Kimi K2.6 mit 79,0% und Gemini 3.1 Pro mit 82,0%.
Bei Charxiv RQ für Chart-Reasoning erreicht es 78,1% und steigt auf 82,0%, wenn ein Python-Tool erlaubt ist.
Für Audio erzielt Inkling 91,4% auf VoiceBench, 77,2% auf MMAU und 56,6% auf Audio MC und gehört damit zu den stärksten Open-Weights-Audiomodellen.
Gemini 3.1 Pro führt weiter bei allen drei, mit 94,3%, 82,5% und 66,8%.
Inkling ist heute auf Tinker für Fine-Tuning verfügbar, mit Kontextlängen von 64K und 256K Tokens. Die vollständigen Gewichte liegen auf Hugging Face sowohl als ursprünglicher Checkpoint als auch als NVFP4-Checkpoint für NVIDIA-Blackwell-Inferenz.
Thinking Machines bietet für kurze Zeit 50% Rabatt, die vollständigen Preise stehen in der Dokumentation.
Mit diesem Rabatt ergibt sich pro 1 Million Tokens folgende Preisstruktur:
(Hinweis: Während Tinker am 17. Juli die Preise für die meisten Modelle erhöht, sind die Inkling-Tarife von dieser Anpassung ausgenommen. Standardmäßige Plattform-Speichergebühren von $0,10 pro GB/Monat gelten weiterhin für Fine-Tuning).
Die Deployment-Unterstützung ist breit. Feinabgestimmte Checkpoints laufen per API über TogetherAI, Fireworks, Modal, Databricks und Baseten, mit Open-Source-Inferenz in SGLang, vLLM und llama.cpp, plus einem Chat-Interface mit integrierter Websuche im Inkling Playground, für begrenzte Zeit kostenlos.
Parallel zu Inkling zeigte Thinking Machines eine Vorschau auf Inkling-Small, ein MoE mit 276B Parametern und 12B aktiven gegenüber 41B beim großen Modell. Dank Verbesserungen bei Trainingsdaten und -rezept des kleineren Modells erreicht oder übertrifft es den großen Bruder in mehreren Benchmarks.
Inkling-Small tauscht Faktenerinnerung und schwieriges agentisches Coding gegen geringere Kosten und Latenz ein und eignet sich damit für Workloads wie Bewertung, synthetische Datenerzeugung und Coding mit hohem Volumen. Die vollständigen Gewichte werden nach Abschluss der Tests veröffentlicht.
Inkling ist eher ein strategisches Statement als ein Sieg auf der Bestenliste. Thinking Machines setzt darauf, dass Organisationen, die bereit sind, ein Modell zu feinabzustimmen und zu besitzen, mehr Wert schöpfen als mit einem abgerechneten Aufruf an ein geschlossenes Spitzenmodell. Inkling ist die Basis dafür.
Die Ehrlichkeit ist erfrischend. Das Unternehmen sagt offen, dass Inkling nicht das stärkste Modell ist – ungewöhnlich für einen Launch – und die Benchmarks bestätigen das: Bei den härtesten Coding- und Reasoning-Tests liegt es hinter GLM 5.2 und Kimi K2.6 und deutlich hinter geschlossenen Modellen wie GPT-5.6 Sol und Gemini 3.1 Pro. Dafür bietet es Breite, native Multimodal-Eingabe, kalibrierte Antworten, steuerbaren Denkaufwand und den besten FORTRESS-Adversarial-Safety-Score unter den verglichenen Open-Weights-Modellen.
Wenn du eine Top-Score auf einem einzelnen Benchmark willst, ist Inkling nicht die erste Wahl. Wenn du eine Open-Weights-Basis suchst, die du mit eigenen Daten feinabstimmen kannst – mit starker Kalibrierung und Safety ab Werk –, ist es eine vernünftige Option. Die Tokenpreise und die Standard-Verbosity solltest du bei großen Volumina im Blick behalten.
Wenn du die Fine-Tuning-Kompetenzen aufbauen willst, die ein Modell wie Inkling wirklich nutzbar machen, starte am besten mit unserem AI Fundamentals Skill Track.
Top-DataCamp-Kurse
Kurs
Kurs
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleBlog
Blog
Hesam Sheikh Hassani
15 Min.
Tutorial
Josef Waples
8 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Josef Waples
3 Min.


