
Last chance! 50% off DataCamp Premium
Sale ends in
Thinking Machines, laboratorium yang didirikan oleh mantan CTO OpenAI Mira Murati, merilis model pertamanya: Inkling. Berbeda dengan model flagship dari OpenAI, Anthropic, dan Google, Inkling hadir dengan bobot penuh yang tersedia untuk diunduh, sehingga pengembang dapat memodifikasinya langsung alih-alih hanya memanggilnya melalui API berbasis meteran.
Inkling adalah transformer Mixture-of-Experts (MoE) dengan total 975B parameter dan 41B aktif, jendela konteks 1M token, serta pra-pelatihan pada 45 triliun token teks, gambar, audio, dan video.
Thinking Machines secara terbuka menyatakan bahwa ini bukan model terkuat yang tersedia: perusahaan menyebutkan secara gamblang bahwa Inkling "bukan model keseluruhan terkuat yang tersedia saat ini, terbuka maupun tertutup." Penawarannya adalah performa yang seimbang serta desain yang ditujukan untuk dikustomisasi melalui Tinker, platform fine-tuning milik perusahaan.
Dalam artikel ini, saya akan membahas semua hal baru di Inkling, melihat fiturnya, meninjau benchmark, dan mengusulkan pengujian langsung yang dapat Anda jalankan sendiri. Saya juga menyarankan Anda membaca panduan menjalankan Inkling secara lokal kami.
Inkling adalah transformer MoE open-weights dengan total 975B parameter dan 41B aktif per token, diposisikan sebagai model dasar luas untuk fine-tuning alih-alih chatbot papan atas. Ini adalah rilis pertama dalam keluarga yang direncanakan, dirilis pada 15 Juli 2026, bersamaan dengan pratinjau saudara yang lebih kecil, Inkling-Small.
Tujuan desainnya adalah keluasan. Thinking Machines melatih Inkling pada tugas-tugas agen, penalaran, pengkodean, mengikuti instruksi, faktualitas, visi, dan audio alih-alih mengoptimalkan untuk satu domain.
Hal ini penting karena perusahaan bertaruh bahwa organisasi akan melakukan fine-tuning model pada data mereka sendiri, dan basis yang luas beradaptasi dengan lebih banyak alur kerja dibandingkan yang sempit.
Klaim kapabilitas utama adalah efisiensi, bukan puncak benchmark. Pada Terminal Bench 2.1, Thinking Machines melaporkan Inkling menghabiskan sepertiga token dibandingkan Nemotron 3 Ultra milik NVIDIA untuk mencapai performa pengkodean yang sama.
Untuk model yang mungkin Anda jalankan jutaan kali dalam alur kerja lebih panjang, kurva biaya token itu lebih penting daripada satu skor upaya-maksimum.
Desain MoE Inkling sebagian besar mengikuti DeepSeek-V3, dengan 256 expert ter-routing, 2 expert bersama, dan 6 expert ter-routing aktif per token, menggunakan router sigmoid dengan penyeimbangan beban tanpa auxiliary loss.
Thinking Machines menginterleaving perhatian jendela geser dan global dengan rasio 5:1 dan menggunakan penyematan posisi relatif alih-alih RoPE, melaporkan extrapolasi yang lebih baik ke urutan yang lebih panjang.
Pra-pelatihan dijalankan pada 45 triliun token multimodal menggunakan optimizer hibrida: Muon untuk bobot matriks besar dan Adam untuk parameter lainnya.
Pasca-pelatihan dibangun dengan sejumlah kecil SFT pada data sintetis dari model open-weights, termasuk Kimi K2.5, diikuti RL asinkron skala besar yang diskalakan hingga lebih dari 30 juta rollout pada dua run berkelanjutan.
Pembeda Inkling kurang pada kapabilitas mentah dan lebih pada bagaimana model ini dibangun untuk dikustomisasi dan dikendalikan. Berikut fitur-fitur yang menonjol.
Inkling memungkinkan Anda menetapkan tingkat "upaya berpikir" untuk menukar ketelitian dengan biaya token dan latensi.
Anda dapat mendorong upaya ke 0,99 untuk kinerja maksimum pada masalah sulit, atau menurunkannya untuk tugas ber-volume tinggi di mana kecepatan dan biaya lebih dominan.
Ini adalah perilaku yang dilatih, bukan pembungkus.
Selama reinforcement learning skala besar, Thinking Machines memvariasikan tingkat upaya per sampel dengan mengubah pesan sistem dan menyesuaikan biaya per token, sehingga model belajar menghabiskan anggaran token yang berbeda pada rollout yang berbeda.
Pengaturan upaya dapat diteruskan dari dalam harness pengkodean atau agen.
Bagi praktisi yang menjalankan beban kerja produksi, inilah fitur yang paling saya perhatikan. Latensi sering kali menjadi kendala utama bagi alat interaktif, dan dapat mengendalikannya per permintaan tanpa mengganti model benar-benar bermanfaat.
Inkling melakukan penalaran secara native pada teks, gambar, dan audio, dengan komponen multimodal yang dilatih dari nol pada data domain umum.
Model ini dapat mentranskripsikan ucapan, mengikuti instruksi lisan, menjawab pertanyaan tentang rekaman, menjelaskan gambar, dan bernalar pada bagan serta diagram.
Arsitekturnya bebas encoder.
Audio dimasukkan sebagai spektrogram dMel, gambar dikodekan sebagai patch 40x40 piksel melalui hMLP empat lapis, dan keduanya melewati lapisan embedding ringan untuk diproses bersama token teks.
Pada sisi visi, Inkling dapat memanggil alat Python untuk memperbesar dan memotong saat bernalar, menggabungkan penalaran visual dan berbasis kode dalam satu lintasan.
Satu catatan penting: input bersifat multimodal, tetapi output pada tooling saat ini hanya teks. Jika kasus penggunaan Anda membutuhkan model untuk langsung menghasilkan gambar atau audio, Inkling tidak mendukung itu.
Inkling dilatih untuk mengekspresikan tingkat kepercayaan yang tepat, termasuk mengatakan "Saya tidak tahu" ketika kemungkinan salah, yang oleh Thinking Machines dikelompokkan dalam "epistemik" model.
Perusahaan melatih kalibrasi menggunakan reinforcement learning melawan aturan penilaian yang tepat pada korpus besar pertanyaan dunia nyata yang telah diselesaikan.
Mereka menggunakan dua penilai otomatis dalam pasca-pelatihan: penilai rubrik yang memeriksa respons terhadap daftar periksa apa yang seharusnya dimuat oleh jawaban yang baik, dan penilai klaim yang memverifikasi setiap klaim faktual melalui penelusuran web berbasis agen.
Penilai klaim memberi penalti pada klaim yang tidak terbukti, yang mengurangi halusinasi alih-alih hanya memberi penghargaan pada ingatan.
Alasannya penting karena model yang percaya diri pada setiap jawaban memaksa Anda untuk memeriksa ulang semuanya. Pada ForecastBench Brier Index tanpa pencarian, Inkling mencetak 61,1, menyamai Grok 4.3 dan sedikit di atas GPT-5.5 di 59,1 serta Gemini 3.1 Pro di 54,6.
Inkling mencatat skor keamanan adversarial FORTRESS terkuat di antara model open-weights yang dibandingkan oleh Thinking Machines, yaitu 78,0%. FORTRESS menguji penolakan permintaan terkait senjata dan kekerasan bersama kueri mirip yang tidak berbahaya, sehingga skor tinggi berarti menolak permintaan berbahaya tanpa berlebihan menolak yang aman.
Sebagai perbandingan, Nemotron 3 Ultra mencetak 77,6%, Kimi K2.5 mencetak 54,1%, GLM 5.2 mencetak 65,6%, dan DeepSeek V4 Pro mencetak 36,0% pada set adversarial yang sama.
Inkling juga lulus 98,6% pada StrongREJECT, tes penolakan untuk permintaan berbahaya yang tidak ambigu, sejalan dengan model terbuka dan tertutup lainnya.
Pertanyaan terbuka adalah apa yang terjadi setelah fine-tuning.
Thinking Machines mengatakan masih mempelajari bagaimana perilaku keamanan bergeser ketika pelanggan melakukan fine-tuning di Tinker, yang merupakan kekhawatiran nyata untuk model yang dapat diunduh.
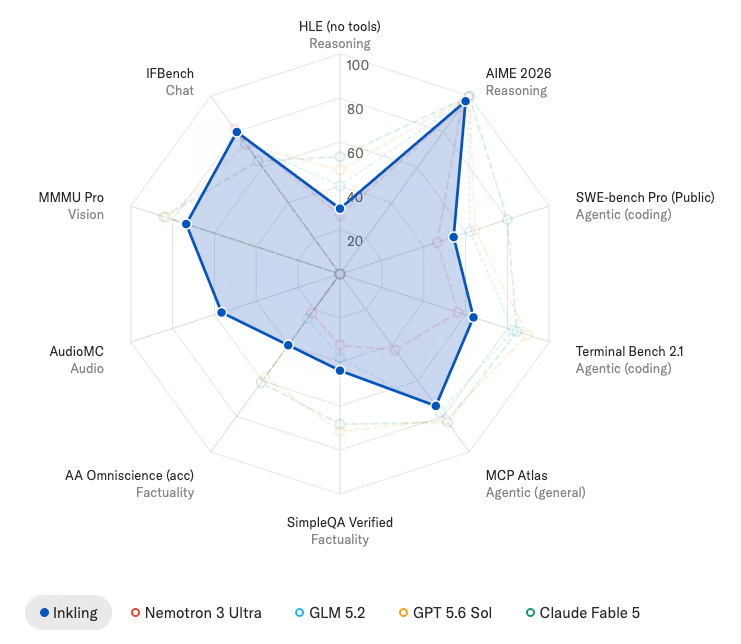
Inkling berada di posisi menengah di antara model open-weights: lebih baik dari Nemotron 3 Ultra dan Kimi K2.5 pada sebagian besar tes penalaran dan pengkodean, tetapi tertinggal dari GLM 5.2 dan Kimi K2.6 pada yang paling sulit. Dibandingkan model frontier tertutup seperti GPT-5.6 Sol, Gemini 3.1 Pro, dan Claude Fable 5, model ini konsisten tertinggal. Semua skor di bawah dilaporkan pada upaya 0,99.
Terminal Bench 2.1 menguji pengkodean agen dalam lingkungan terminal.
Inkling mencetak 63,8% pada harness terbaiknya, di depan Nemotron 3 Ultra di 56,4% dan Kimi K2.5 di 51,3%, tetapi tertinggal jauh dari GLM 5.2 di 82,7% dan GPT-5.6 Sol di 89,5%.
Di sinilah klaim efisiensi token masuk: Inkling mencapai performa pengkodean Nemotron 3 Ultra dengan menggunakan sekitar sepertiga jumlah token.
Humanity's Last Exam (HLE) adalah benchmark penalaran yang sulit dan luas.
Inkling mencetak 29,7% hanya teks dan 46,0% dengan alat, di depan Nemotron 3 Ultra (26,6% / 37,4%) tetapi di belakang GLM 5.2 (40,1% / 54,7%) dan model tertutup, dengan GPT-5.6 Sol di 47,2% hanya teks.
GPQA Diamond menguji pertanyaan sains tingkat pascasarjana.
Inkling mencetak 43,9% pada SimpleQA Verified, di depan Nemotron 3 Ultra di 32,4% dan Kimi K2.5 di 36,9%, tetapi jauh di belakang Gemini 3.1 Pro di 77,3% dan GPT-5.6 Sol di 71,6%. Daya ingat faktual mentah bukan kekuatannya.
Tempat Inkling menonjol adalah AA Omniscience, yang memberi penghargaan atas mengetahui apa yang tidak Anda ketahui.
Inkling mencetak positif 2,1, sementara beberapa model terbuka bernilai negatif: Kimi K2.5 di -8,0, DeepSeek V4 Pro di -10,0, dan Nemotron 3 Ultra di -1,0. Kesenjangan itu mencerminkan pelatihan kalibrasi yang membuahkan hasil.
Pada MMMU Pro (Standard 10), sebuah benchmark penalaran visi, Inkling mencetak 73,5%, di belakang Kimi K2.6 di 79,0% dan Gemini 3.1 Pro di 82,0%.
Pada Charxiv RQ untuk penalaran bagan, model ini mencapai 78,1%, naik menjadi 82,0% saat diizinkan menggunakan alat Python.
Untuk audio, Inkling mencetak 91,4% pada VoiceBench, 77,2% pada MMAU, dan 56,6% pada Audio MC, menempatkannya di antara model audio open-weights terkuat.
Gemini 3.1 Pro masih memimpin pada ketiganya, masing-masing di 94,3%, 82,5%, dan 66,8%.
Inkling tersedia untuk fine-tuning di Tinker hari ini, dengan opsi panjang konteks 64K dan 256K token, dan bobot penuh ada di Hugging Face sebagai checkpoint asli dan checkpoint NVFP4 untuk inferensi NVIDIA Blackwell.
Thinking Machines menawarkan diskon 50% untuk waktu terbatas, dengan harga lengkap di dokumentasinya.
Dengan diskon ini, harga per 1 juta token diuraikan sebagai berikut:
(Catatan: Sementara Tinker menaikkan harga untuk sebagian besar model pada 17 Juli, tarif Inkling tidak terdampak kenaikan ini. Biaya penyimpanan platform standar sebesar $0,10 per GB/bulan tetap berlaku untuk fine-tuning).
Dukungan deployment luas. Checkpoint hasil fine-tuning dijalankan via API di TogetherAI, Fireworks, Modal, Databricks, dan Baseten, dengan dukungan inferensi open-source di SGLang, vLLM, dan llama.cpp, plus antarmuka chat dengan penelusuran web terintegrasi di Inkling Playground, gratis untuk waktu terbatas.
Bersamaan dengan Inkling, Thinking Machines menayangkan pratinjau Inkling-Small, MoE 276B parameter dengan 12B aktif dibandingkan 41B untuk model penuh. Model ini menyamai atau melampaui saudaranya yang lebih besar pada beberapa benchmark berkat peningkatan pada data dan resep pra-pelatihan model yang lebih kecil.
Inkling-Small menukar daya ingat faktual dan pengkodean agen yang berat dengan biaya dan latensi yang lebih rendah, yang cocok untuk beban kerja seperti penilaian, pembuatan data sintetis, dan pengkodean ber-volume tinggi. Bobot penuh akan dirilis setelah pengujian selesai.
Inkling lebih merupakan pernyataan strategi daripada kemenangan papan peringkat. Thinking Machines bertaruh bahwa organisasi yang bersedia melakukan fine-tuning dan memiliki model akan mendapatkan nilai lebih daripada panggilan berbasis meter ke model frontier tertutup, dan Inkling adalah basis yang mereka tawarkan untuk itu.
Menurut saya kejujurannya menyegarkan. Perusahaan secara terbuka mengatakan bahwa Inkling bukan model terkuat, yang tidak biasa untuk peluncuran, dan benchmark mendukung hal itu: model ini tertinggal dari GLM 5.2 dan Kimi K2.6 pada tes pengkodean dan penalaran tersulit, dan jauh di belakang model tertutup seperti GPT-5.6 Sol dan Gemini 3.1 Pro. Yang ditawarkannya sebagai gantinya adalah keluasan, input multimodal native, jawaban terkalibrasi, upaya berpikir yang dapat dikendalikan, dan skor keamanan adversarial FORTRESS terbaik di antara model open-weights yang dibandingkan.
Jika Anda menginginkan skor tertinggi pada satu benchmark, Inkling bukan pilihan Anda. Jika Anda menginginkan basis open-weights untuk di-fine-tune pada data Anda sendiri, dengan kalibrasi dan keamanan yang kuat sejak awal, ini adalah pilihan yang masuk akal, meskipun harga per token dan verbositas default perlu diperhatikan untuk deployment ber-volume tinggi.
Jika Anda ingin membangun keterampilan fine-tuning yang membuat model seperti Inkling bermanfaat, saya sarankan mulai dengan jalur keterampilan AI Fundamentals kami.
Kursus Teratas di DataCamp
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt




