Cours
Coder avec l’aide de l’IA pour les développeurs
1 h 30 min
11.6K
S'entraîner et cursus vos progrès.
Continuer Avec GoogleThinking Machines, le laboratoire fondé par l'ancienne CTO d'OpenAI Mira Murati, a publié son premier modèle : Inkling. Contrairement aux modèles phares d'OpenAI, Anthropic et Google, Inkling est fourni avec ses poids complets en téléchargement, permettant aux développeurs de le modifier directement plutôt que d'y accéder uniquement via une API facturée à l'usage.
Inkling est un transformeur Mixture-of-Experts (MoE) avec 975 milliards de paramètres au total, 41 milliards actifs, une fenêtre de contexte d'un million de tokens, et un préentraînement sur 45 billions de tokens couvrant texte, images, audio et vidéo.
Thinking Machines est transparente sur le fait qu'il ne s'agit pas du modèle le plus performant : l'entreprise affirme clairement qu'Inkling n'est « pas le modèle globalement le plus puissant disponible aujourd'hui, ouvert ou fermé ». Leur proposition : des performances équilibrées et une architecture conçue pour être personnalisée via Tinker, la plateforme de fine-tuning de la société.
Dans cet article, je passe en revue les nouveautés d'Inkling : ses fonctionnalités, ses benchmarks, et je propose des tests pratiques à réaliser vous-même. Je vous recommande aussi notre guide pour exécuter Inkling en local.
Inkling est un transformeur MoE à poids ouverts, 975 milliards de paramètres au total et 41 milliards actifs par token, positionné comme un modèle de base généraliste pour le fine-tuning plutôt qu'un chatbot taillé pour dominer les classements. C'est la première sortie d'une famille annoncée, publiée le 15 juillet 2026, accompagnée d'un aperçu d'un petit frère, Inkling-Small.
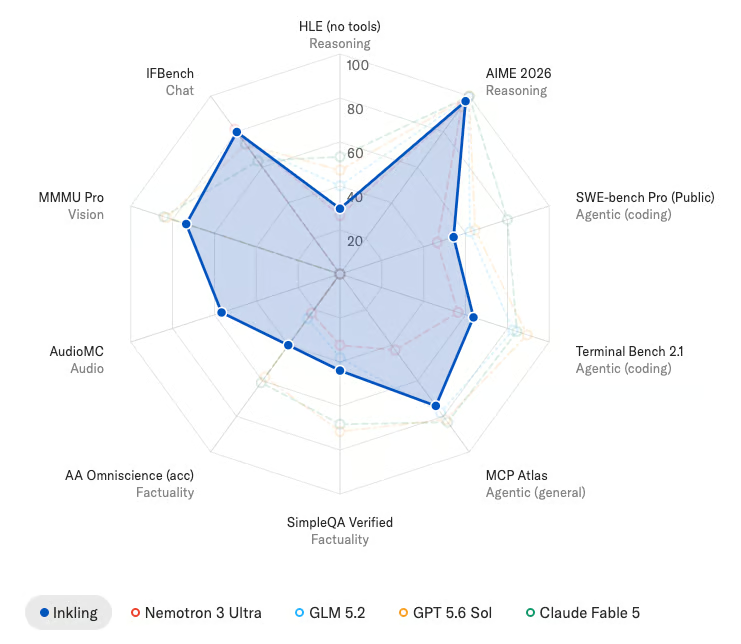
L'objectif de conception est la couverture. Thinking Machines a entraîné Inkling sur des tâches d'agentique, de raisonnement, de codage, de suivi d'instructions, de factualité, de vision et d'audio, sans optimiser pour un seul domaine.
Ce choix compte parce que l'entreprise parie que les organisations vont adapter le modèle à leurs propres données, et qu'une base large s'adapte à davantage de workflows qu'une base étroite.
La promesse phare porte sur l'efficacité plutôt que sur un pic de benchmark. Sur Terminal Bench 2.1, Thinking Machines indique qu'Inkling dépense trois fois moins de tokens que Nemotron 3 Ultra de NVIDIA pour atteindre la même performance en codage.
Pour un modèle appelé des millions de fois dans des workflows longs, la courbe de coût en tokens compte plus qu'un score maximal isolé.
Le design MoE d'Inkling suit largement DeepSeek-V3, avec 256 experts routés, 2 experts partagés et 6 experts routés actifs par token, en utilisant un routeur sigmoïde avec équilibrage de charge sans perte auxiliaire.
Thinking Machines entremêle des attentions fenêtres glissantes et globales selon un ratio 5 : 1, et utilise des embeddings positionnels relatifs plutôt que RoPE, annonçant une meilleure extrapolation aux longues séquences.
Le préentrêinment a porté sur 45 billions de tokens multimodaux, avec un optimiseur hybride : Muon pour les poids de grandes matrices et Adam pour les autres paramètres.
Le post-entraînement a démarré par un SFT léger sur des données synthétiques issues de modèles open-weights, dont Kimi K2.5, suivi d'un RL asynchrone à grande échelle, au-delà de 30 millions de rollouts sur deux exécutions continues.
Les différenciateurs d'Inkling tiennent moins à la puissance brute qu'à sa capacité à être personnalisé et contrôlé. Voici les points qui ressortent.
Inkling vous permet de définir un niveau d'« effort de raisonnement » pour arbitrer entre exhaustivité, coût en tokens et latence.
Vous pouvez pousser l'effort à 0,99 pour des performances maximales sur un problème difficile, ou le réduire pour des volumes élevés où vitesse et coût prévalent.
Il s'agit d'un comportement entraîné, pas d'une simple surcouche.
Lors du renforcement à grande échelle, Thinking Machines a varié l'effort par échantillon en modifiant le message système et en ajustant le coût par token, de sorte que le modèle a appris à dépenser des budgets de tokens différents selon les rollouts.
Le réglage d'effort peut être transmis depuis un harnais de codage ou d'agent.
Pour les praticiens en production, c'est la fonctionnalité à surveiller. La latence est souvent la contrainte principale pour les outils interactifs, et pouvoir la contrôler requête par requête sans changer de modèle est vraiment utile.
Inkling raisonne nativement sur du texte, des images et de l'audio, avec des composants multimodaux entraînés from scratch sur des données généralistes.
Il peut transcrire la parole, suivre des instructions orales, répondre à des questions sur des enregistrements, décrire des images et raisonner sur des graphiques et des schémas.
L'architecture est sans encodeur.
L'audio est fourni sous forme de spectrogrammes dMel, les images sont découpées en patches de 40 x 40 pixels via un hMLP à quatre couches, et les deux passent par une couche d'embedding légère pour être traités conjointement avec les tokens texte.
Côté vision, Inkling peut appeler un outil Python pour zoomer et recadrer pendant le raisonnement, combinant raisonnement visuel et fondé sur le code en un seul passage.
Un point d'attention : l'entrée est multimodale, mais la sortie, dans les outils actuels, est uniquement textuelle. Si votre cas d'usage exige une génération directe d'images ou d'audio, Inkling ne le fera pas.
Inkling est entraîné à exprimer le bon niveau de confiance, y compris à dire « Je ne sais pas » lorsqu'il est probablement dans l'erreur ; Thinking Machines regroupe cela sous l'« épistémique » du modèle.
L'entreprise a entraîné la calibration via l'apprentissage par renforcement contre des règles de scoring propres, sur un vaste corpus de questions résolues issues du monde réel.
Deux correcteurs automatisés ont été utilisés en post-entraînement : un correcteur à grille qui vérifie la réponse selon une checklist de critères, et un correcteur de faits qui valide chaque affirmation via une recherche web agentique.
Le correcteur de faits pénalise les affirmations non vérifiées, ce qui réduit l'hallucination au lieu de simplement récompenser le rappel.
L'enjeu : un modèle confiant en toute circonstance vous oblige à tout revérifier. Sur le ForecastBench Brier Index sans recherche, Inkling affiche 61,1, à hauteur de Grok 4.3 et devant GPT-5.5 à 59,1 et Gemini 3.1 Pro à 54,6.
Inkling obtient le meilleur score de sécurité adversariale FORTRESS parmi les modèles open-weights comparés par Thinking Machines, avec 78,0 %. FORTRESS évalue le refus de requêtes liées aux armes et à la violence, tout en proposant des requêtes inoffensives semblables ; un score élevé indique la capacité à refuser l'harmful sans sur-refuser le sûr.
À titre de comparaison, Nemotron 3 Ultra a obtenu 77,6 %, Kimi K2.5 54,1 %, GLM 5.2 65,6 % et DeepSeek V4 Pro 36,0 % sur le même set adversarial.
Inkling atteint aussi 98,6 % sur StrongREJECT, un test de refus face à des requêtes nuisibles sans ambiguïté, au niveau des meilleurs modèles ouverts et fermés.
La question ouverte reste : que se passe-t-il après le fine-tuning ?
Thinking Machines indique étudier encore l'évolution des comportements de sécurité lorsque les clients affinent le modèle sur Tinker, une vraie préoccupation pour tout modèle téléchargeable.
Inkling se situe au milieu du peloton des modèles open-weights : devant Nemotron 3 Ultra et Kimi K2.5 sur la plupart des tests de raisonnement et de codage, mais derrière GLM 5.2 et Kimi K2.6 sur les plus difficiles. Face aux modèles fermés de pointe comme GPT-5.6 Sol, Gemini 3.1 Pro et Claude Fable 5, il est constamment derrière. Tous les scores ci-dessous sont rapportés à l'effort 0,99.
Terminal Bench 2.1 évalue le codage agentique dans un environnement terminal.
Inkling obtient 63,8 % sur son meilleur harnais, devant Nemotron 3 Ultra à 56,4 % et Kimi K2.5 à 51,3 %, mais loin derrière GLM 5.2 à 82,7 % et GPT-5.6 Sol à 89,5 %.
C'est là que l'argument d'efficacité en tokens intervient : Inkling atteint la performance de codage de Nemotron 3 Ultra avec environ un tiers de tokens.
Humanity's Last Exam (HLE) est un benchmark exigeant et généraliste de raisonnement.
Inkling obtient 29,7 % en texte seul et 46,0 % avec outils, devant Nemotron 3 Ultra (26,6 % / 37,4 %) mais derrière GLM 5.2 (40,1 % / 54,7 %) et les modèles fermés, GPT-5.6 Sol affichant 47,2 % en texte seul.
GPQA Diamond évalue des questions de sciences niveau master.
Inkling atteint 43,9 % sur SimpleQA Verified, devant Nemotron 3 Ultra à 32,4 % et Kimi K2.5 à 36,9 %, mais loin derrière Gemini 3.1 Pro à 77,3 % et GPT-5.6 Sol à 71,6 %. Le rappel factuel brut n'est pas son point fort.
Là où Inkling se distingue, c'est AA Omniscience, qui valorise le fait de savoir ce que l'on ne sait pas.
Inkling obtient un score positif de 2,1, quand plusieurs modèles ouverts sont négatifs : Kimi K2.5 à -8,0, DeepSeek V4 Pro à -10,0, et Nemotron 3 Ultra à -1,0. Cet écart reflète l'effet de l'entraînement à la calibration.
Sur MMMU Pro (Standard 10), un benchmark de raisonnement visuel, Inkling atteint 73,5 %, derrière Kimi K2.6 à 79,0 % et Gemini 3.1 Pro à 82,0 %.
Sur Charxiv RQ pour le raisonnement sur graphiques, il atteint 78,1 %, et monte à 82,0 % avec un outil Python.
En audio, Inkling obtient 91,4 % sur VoiceBench, 77,2 % sur MMAU et 56,6 % sur Audio MC, ce qui le place parmi les meilleurs modèles audio open-weights.
Gemini 3.1 Pro garde toutefois la tête sur les trois, à 94,3 %, 82,5 % et 66,8 % respectivement.
Inkling est disponible dès aujourd'hui pour du fine-tuning sur Tinker, avec des options de longueur de contexte de 64 K et 256 K tokens, et ses poids complets sont sur Hugging Face, en checkpoint original et en checkpoint NVFP4 pour l'inférence sur NVIDIA Blackwell.
Thinking Machines propose une remise de 50 % pour une durée limitée, avec le détail des prix dans sa documentation.
Avec cette remise, le prix par 1 million de tokens se décompose comme suit :
(Remarque : si Tinker augmente les tarifs de la plupart des modèles le 17 juillet, les prix d'Inkling sont protégés de cette hausse. Des frais de stockage standard de plateforme de 0,10 $ par Go/mois s'appliquent toujours au fine-tuning.)
Le support de déploiement est large. Les checkpoints affinés tournent via des API sur TogetherAI, Fireworks, Modal, Databricks et Baseten, avec un support d'inférence open source dans SGLang, vLLM et llama.cpp, ainsi qu'une interface de chat avec recherche web intégrée dans l'Inkling Playground, gratuite pour une durée limitée.
Avec Inkling, Thinking Machines a présenté Inkling-Small, un MoE de 276 milliards de paramètres avec 12 milliards actifs, contre 41 milliards pour le modèle complet. Il égale ou dépasse son grand frère sur plusieurs benchmarks grâce à des améliorations des données et de la recette de préentraînement du petit modèle.
Inkling-Small sacrifie le rappel factuel et le codage agentique difficile au profit d'un coût et d'une latence plus faibles, idéal pour des charges telles que l'évaluation, la génération de données synthétiques et le codage à grand volume. Les poids complets seront publiés une fois les tests terminés.
Inkling est davantage une déclaration de stratégie qu'une victoire au classement. Thinking Machines parie que les organisations prêtes à affiner et à s'approprier un modèle en tireront plus de valeur qu'avec un appel métrisé à un modèle fermé de pointe, et Inkling est la base proposée pour cela.
J'apprécie cette franchise. L'entreprise dit explicitement qu'Inkling n'est pas le modèle le plus fort, ce qui est rare pour un lancement, et les benchmarks le confirment : il est devancé par GLM 5.2 et Kimi K2.6 sur les tests de codage et de raisonnement les plus ardus, et reste loin derrière des modèles fermés comme GPT-5.6 Sol et Gemini 3.1 Pro. En contrepartie, il offre la largeur de couverture, une entrée multimodale native, des réponses calibrées, un effort de raisonnement contrôlable et le meilleur score FORTRESS adversarial parmi les modèles open-weights comparés.
Si vous visez le meilleur score sur un benchmark unique, Inkling n'est pas le bon choix. Si vous cherchez une base open-weights à affiner sur vos propres données, avec une bonne calibration et une sécurité solide d'emblée, c'est une option pertinente, même si le prix par token et la verbosité par défaut sont à surveiller pour des déploiements à grand volume.
Si vous souhaitez développer les compétences de fine-tuning qui rendent un modèle comme Inkling utile, commencez par notre parcours de compétences AI Fundamentals.
Top DataCamp Courses
Cours
Cours
S'entraîner et cursus vos progrès.
Continuer Avec Googleblog
Kurtis Pykes
9 min
blog
blog
Lynn Heidmann
blog
Kurtis Pykes
15 min
Tutoriel
Tutoriel
Josef Waples
8 min