
课程
面向开发者的 AI 辅助编码
1 小时 30 分钟
11.7K
Thinking Machines Lab 是一家由 OpenAI 前首席技术官、曾短暂担任临时 CEO 的 Mira Murati 创立的人工智能研究与产品公司。Murati 于 2024 年 9 月离开 OpenAI 后,迅速组建了一支经验丰富的 AI 研究团队,并以 120 亿美元估值融资约 20 亿美元。如此的资金与人才规模,使外界普遍期待 Thinking Machines 将成为 OpenAI 等老牌 AI 实验室的有力竞争者。
Inkling 是该公司首个重要的自研模型发布,也是计划中的模型家族的首位成员。它是一款开放权重的多模态模型,面向推理、编程、工具调用与定制化,首次清晰展示了 Murati 及其团队的研发成果。
在本指南中,我将演示如何在本地运行 Inklink,首先通过免费的 Tinker Playground 测试 Inkling。随后,我将演示如何下载 Unsloth GGUF 量化版本,构建llama.cpp 的实验性 Inkling 分支,在四张 NVIDIA RTX PRO 6000 显卡上运行模型,并通过内置 Web UI 与 OpenAI 兼容的 API 进行交互。
Inkling 是 Thinking Machines Lab 推出的开放权重、通用型多模态模型。
它采用专家混合(Mixture-of-Experts)架构,总参数量为 9750 亿,活跃参数为 410 亿,支持文本、图像与音频输入,并提供最高可达一百万 tokens 的上下文窗口。
该模型面向推理、编程、工具使用、指令跟随以及跨不同领域的微调。
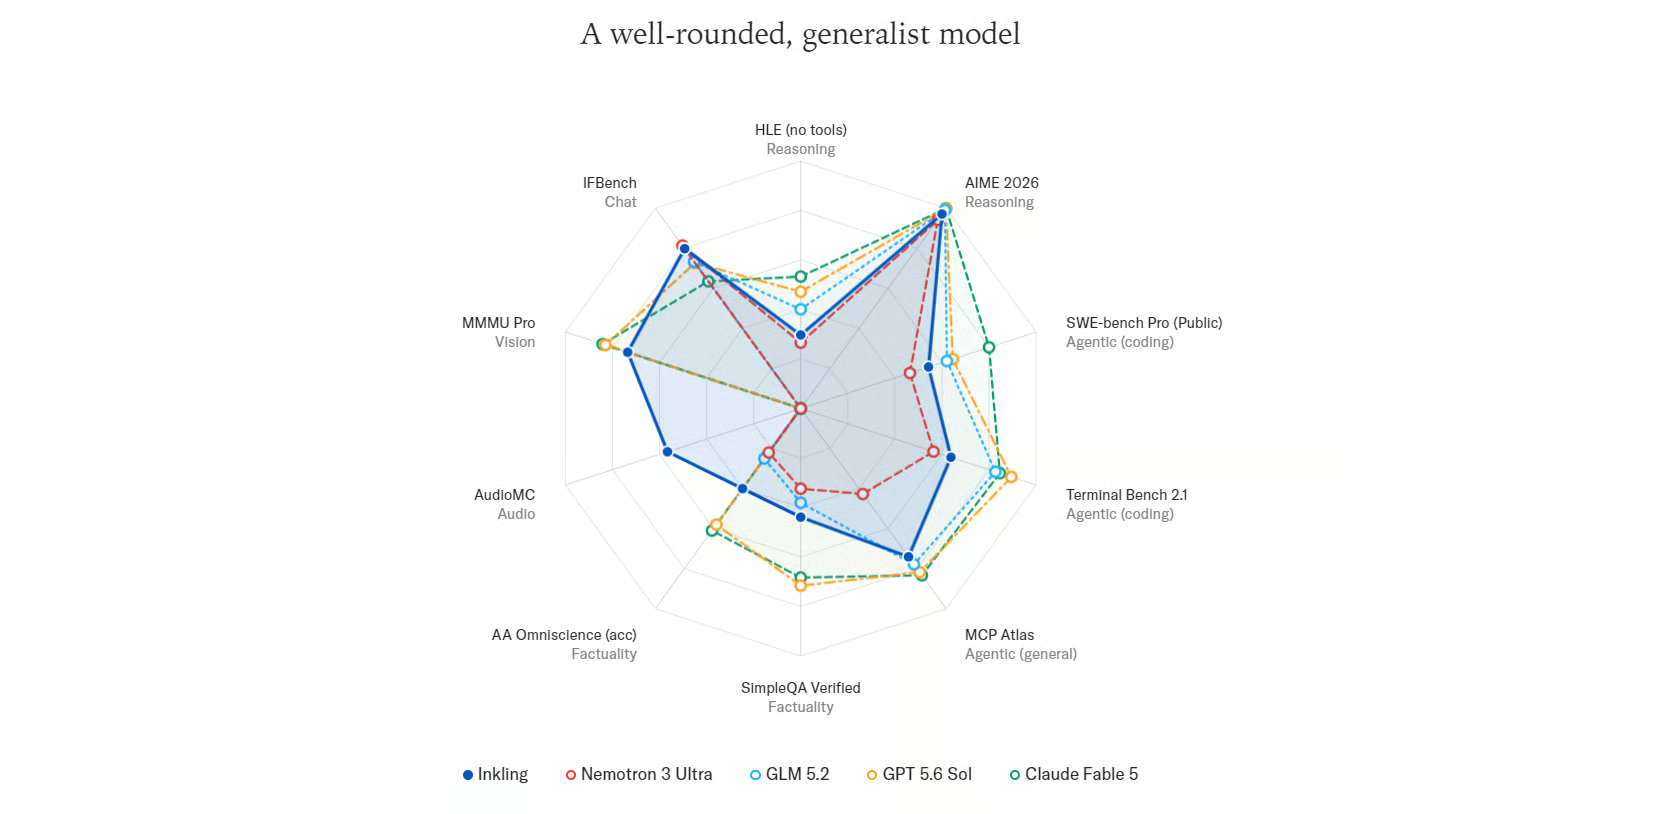
来源:Inkling - Thinking Machines Lab
Inkling 是一款各方面较为均衡的通用模型,在推理、代理式编程、事实性、视觉与音频基准上都有平衡表现。
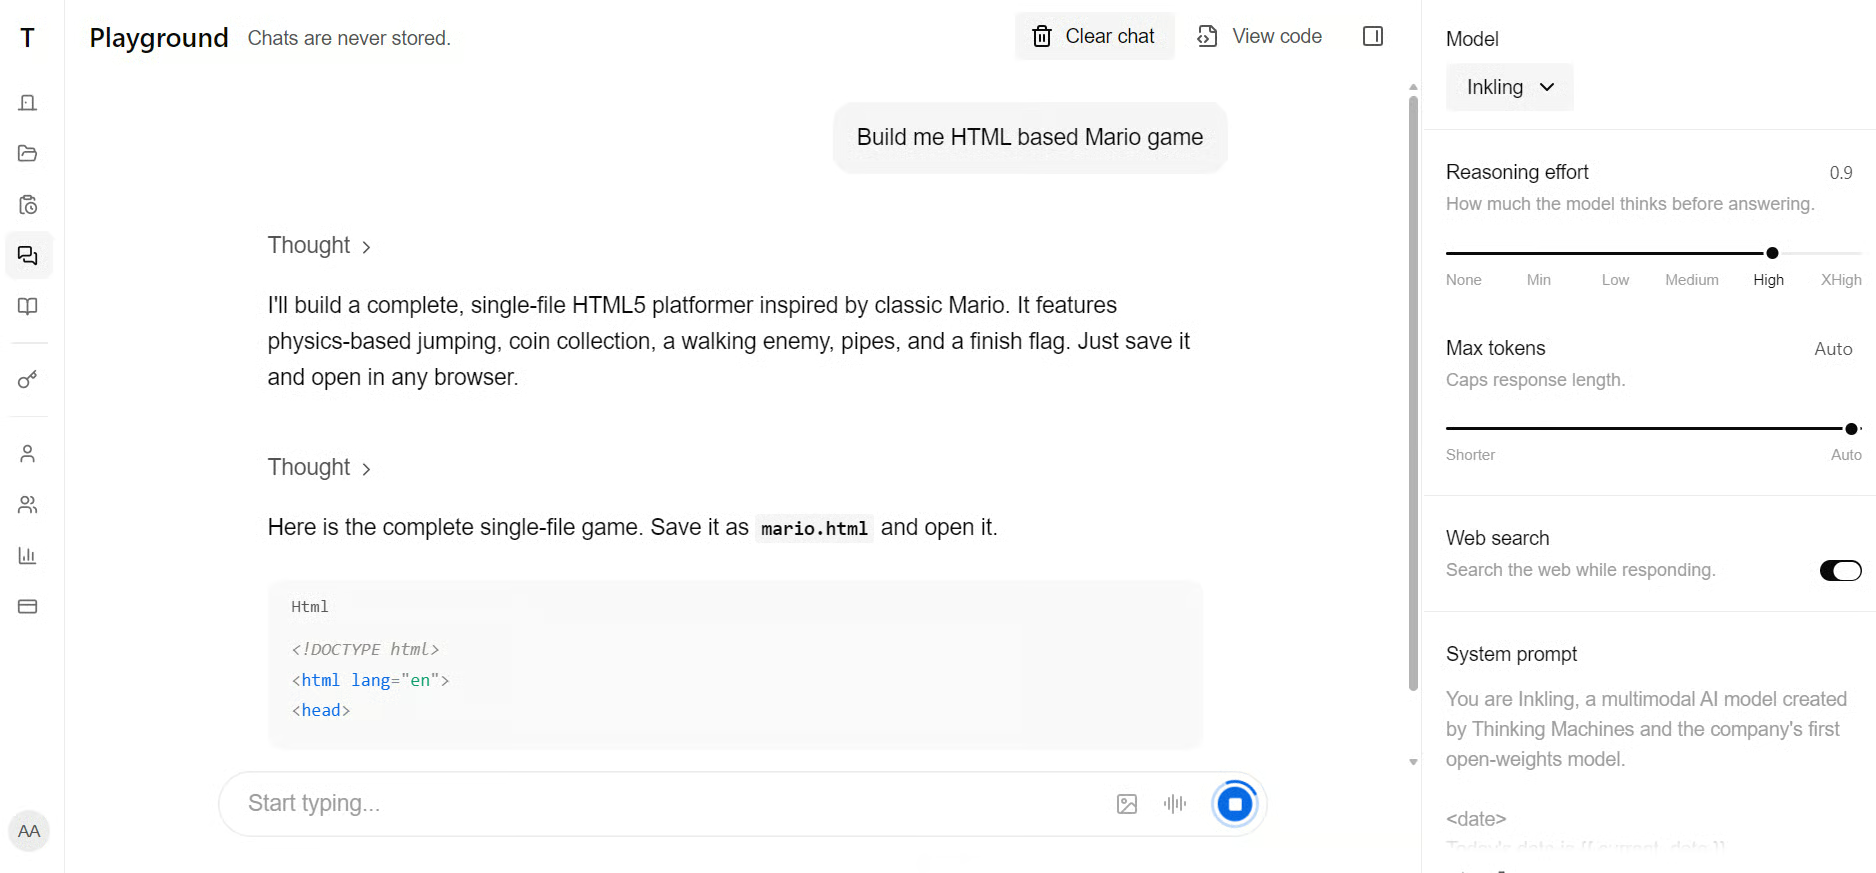
在本地运行 Inkling 之前,建议先通过Inkling Playground 体验其回复并了解模型的工作方式。目前可在限定时间内免费访问。
在本地运行 Inkling 需要企业级硬件。
Unsloth 的 UD-Q4_K_XL 量化约为587 GB,而全精度的 BF16 模型约需 1.89 TB。
这些内存可来自系统内存(RAM)与显存(VRAM)的组合、统一内存,或仅使用 RAM,但仅用 CPU 推理会慢得多。
此外,还需为上下文窗口与运行时开销预留额外内存。
在本指南中,我们使用更小的UD-Q2_K_XL 量化版本,其大小约为317 GB,并在一台 RunPod 服务器上进行配置,包含:
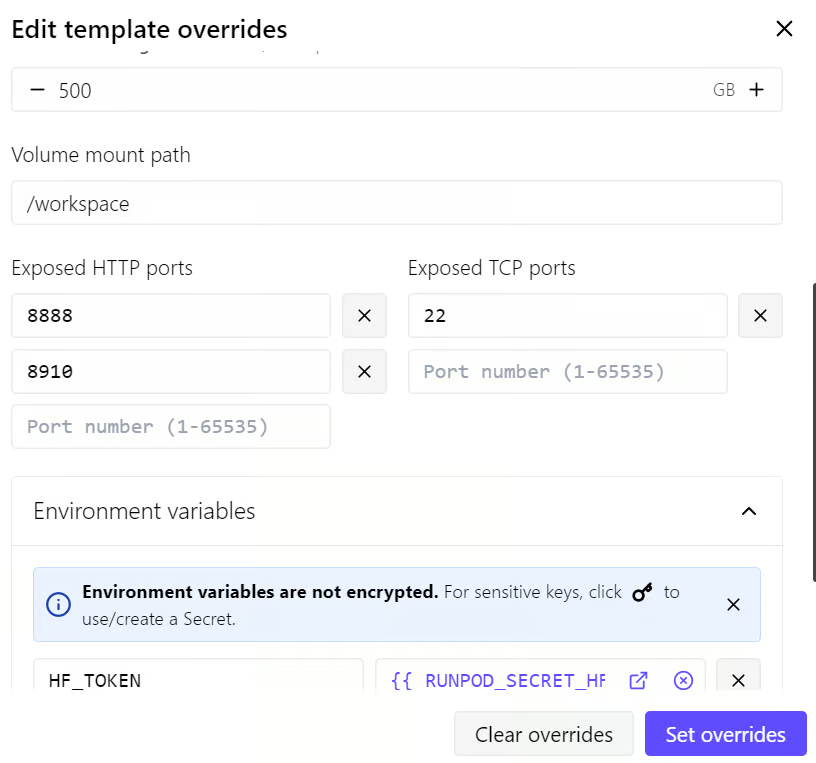
大型模型文件与 Hugging Face 缓存将存储在500 GB 卷磁盘上,以便在 Pod 重启后依然可用。
而100 GB 容器磁盘将用于系统包、构建依赖与其他运行时需求。
在下载 Inkling 之前,我们还将配置一个Hugging Face 访问令牌。
认证下载可避免匿名速率限制,并提供更快、更稳定的下载速度,这对于下载如此规模的模型至关重要。
通过常规 curl 命令安装的标准 llama.cpp 可执行文件无法运行 Inkling,因为其架构支持尚未合并进主分支。
目前可通过实验性的拉取请求 #25731 获得 Inkling 支持,因此必须从该分支编译 llama.cpp。
部署 RunPod 的 Pod 后,打开Connect 选项卡,并点击Jupyter Notebook 链接。
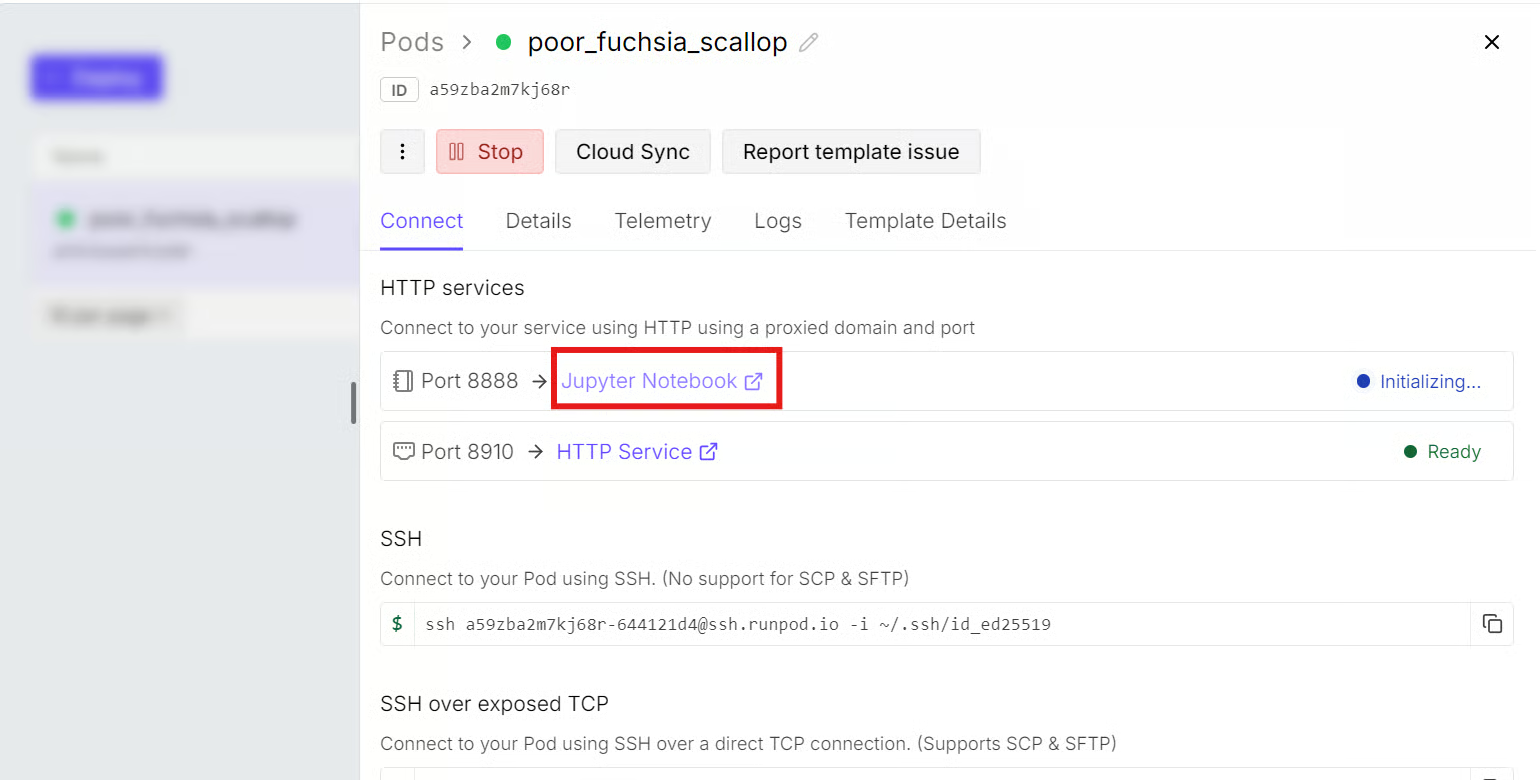
在 JupyterLab 中,启动一个新终端并安装所需的系统包:
apt-get update
apt-get install pciutils build-essential cmake curl libcurl4-openssl-dev -y
接下来,将 llama.cpp 克隆至 /workspace 卷,并切换到包含 Inkling 支持的分支:
cd /workspace

git clone https://github.com/ggml-org/llama.cpp
cd llama.cpp
Inkling 支持目前在一个实验性的草案 PR 中提供,而非 llama.cpp 主分支。拉取并切换到该分支:
git fetch origin pull/25731/head:inkling
git switch inkling
在启用 CUDA 加速的情况下构建 llama.cpp:
cmake -S /workspace/llama.cpp \
  -B /workspace/llama.cpp/build \
  -DBUILD_SHARED_LIBS=OFF \
  -DGGML_CUDA=ON \
  -DCMAKE_BUILD_TYPE=Release
编译命令行界面、多模态界面、服务器与 GGUF 工具:
cmake --build /workspace/llama.cpp/build \
  --config Release \
  --clean-first \
  --target llama-cli llama-mtmd-cli llama-server llama-gguf-split \
  -j "$(nproc)"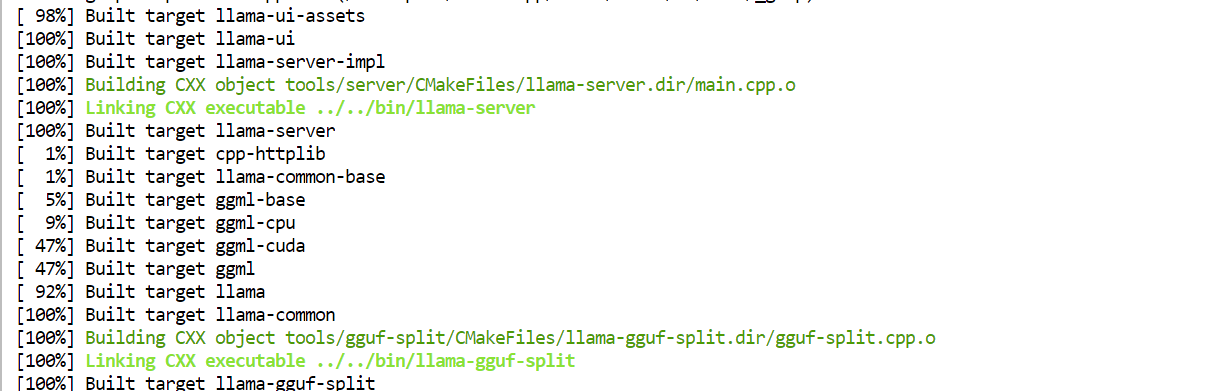
最后,将已编译的可执行文件复制到主 llama.cpp 目录中,便于访问:
cd /workspace
cp llama.cpp/build/bin/llama-* llama.cpp/安装 Hugging Face CLI 与 Xet 下载支持:
pip install -U huggingface_hub hf_xet在部署 Pod 时,Hugging Face 令牌已添加到 RunPod 的环境变量中,因此无需额外登录。
在500 GB 卷磁盘上创建 Hugging Face 缓存与 Inkling 模型目录:
mkdir -p /workspace/models/huggingface
mkdir -p /workspace/models/inkling-GGUF
设置缓存位置并启用高性能下载:
export HF_HOME=/workspace/models/huggingface
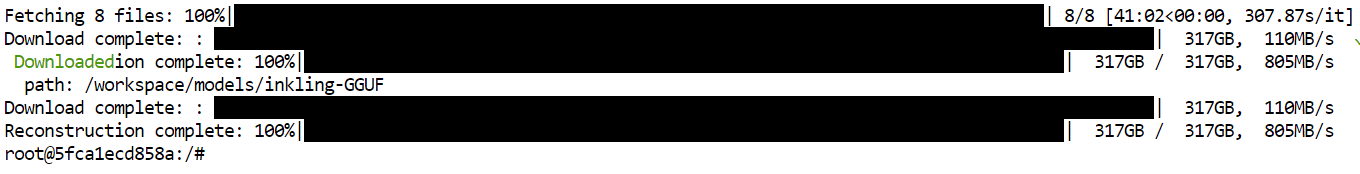
export HF_XET_HIGH_PERFORMANCE=1仅下载UD-Q2_K_XL 量化版本:
hf download unsloth/inkling-GGUF \
  --include "UD-Q2_K_XL/*" \
  --local-dir /workspace/models/inkling-GGUF
下载时间取决于您的网络连接。
我的下载速度约被限制在130 MB/s,整个模型耗时约42 分钟完成下载。
运行以下命令,将 Inkling 加载至四张 GPU,并启动一个与 OpenAI 兼容的推理服务器:
CUDA_VISIBLE_DEVICES=0,1,2,3 \
/workspace/llama.cpp/llama-server \
  -m /workspace/models/inkling-GGUF/UD-Q2_K_XL/inkling-UD-Q2_K_XL-00001-of-00008.gguf \
  --alias inkling-local \
  --host 0.0.0.0 \
  --port 8910 \
  --gpu-layers all \
  --split-mode layer \
  --tensor-split 1,1,1,1 \
  --ctx-size 8192 \
  --parallel 1 \
  --flash-attn on \
  --jinja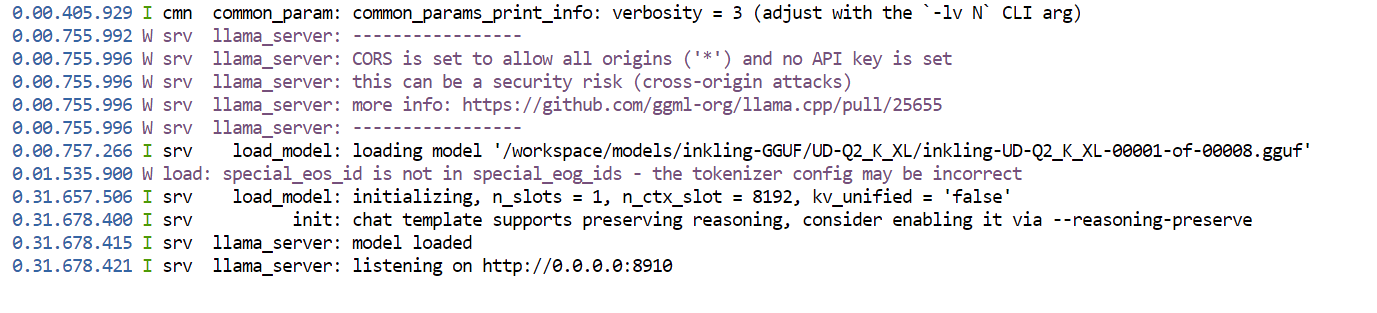
该命令将:
llama.cpp 会自动检测并加载其余七个分片。8910 上启动服务器。打开另一个 Jupyter 终端,检查 GPU 使用情况:
nvidia-smi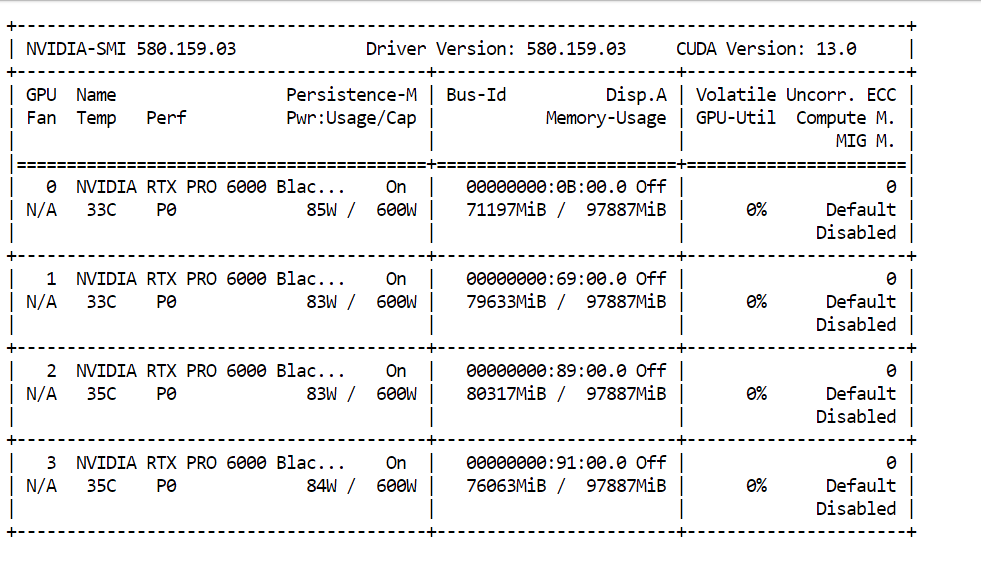
在此配置下,加载带有 8192 token 上下文窗口的模型后,约85% 的可用显存被占用。
更大的上下文窗口需要更多 KV-cache 内存,因此若将 Inkling 的上下文设置为 100,000 tokens,则需要显著更多的可用内存。
本地 OpenAI 兼容 API 地址为:
http://127.0.0.1:8910/v1在通过 Web UI 测试 Inkling 之前,先确认推理服务器已运行并能返回响应。打开新终端,向本地 API 发送测试请求:
curl http://127.0.0.1:8910/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "inkling-local",
    "messages": [
      {
        "role": "user",
        "content": "Write a Python function to calculate the Fibonacci sequence."
      }
    ],
    "max_tokens": 1024,
    "temperature": 0.2
  }'
API 成功返回,提示处理速度为81.1 tokens/秒,生成速度为37.2 tokens/秒。
此次调用使用了25 个提示 tokens与256 个补全部分 tokens,但在给出最终答案前因达到输出上限而停止。增大 max_tokens 可使模型完成输出。
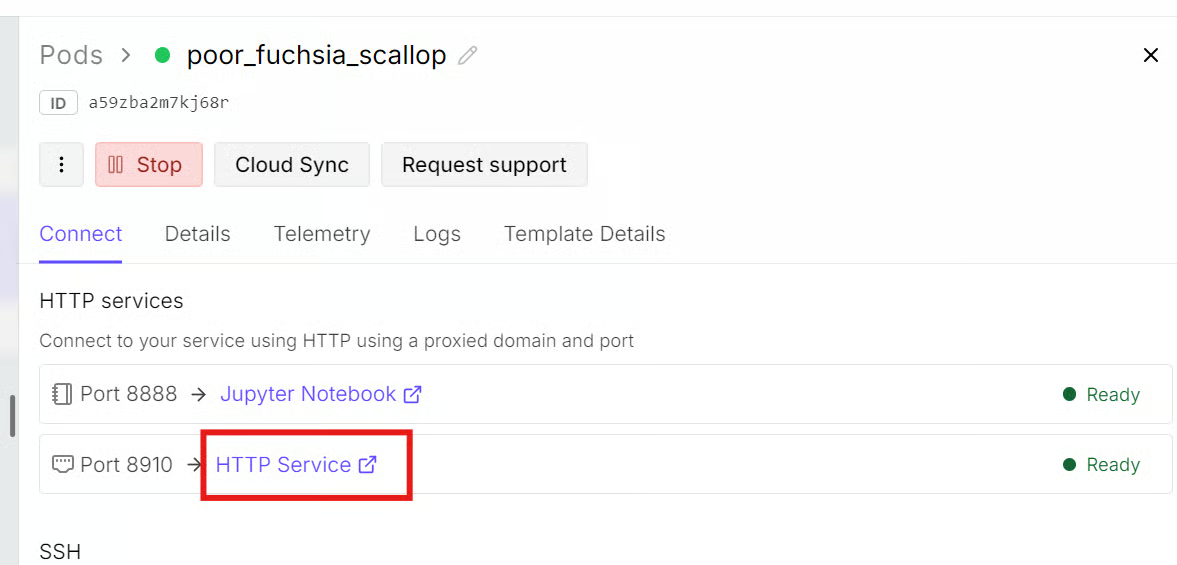
返回 RunPod 控制台,打开Connect 选项卡,点击列在HTTP Services 下、端口为 8910 的链接。
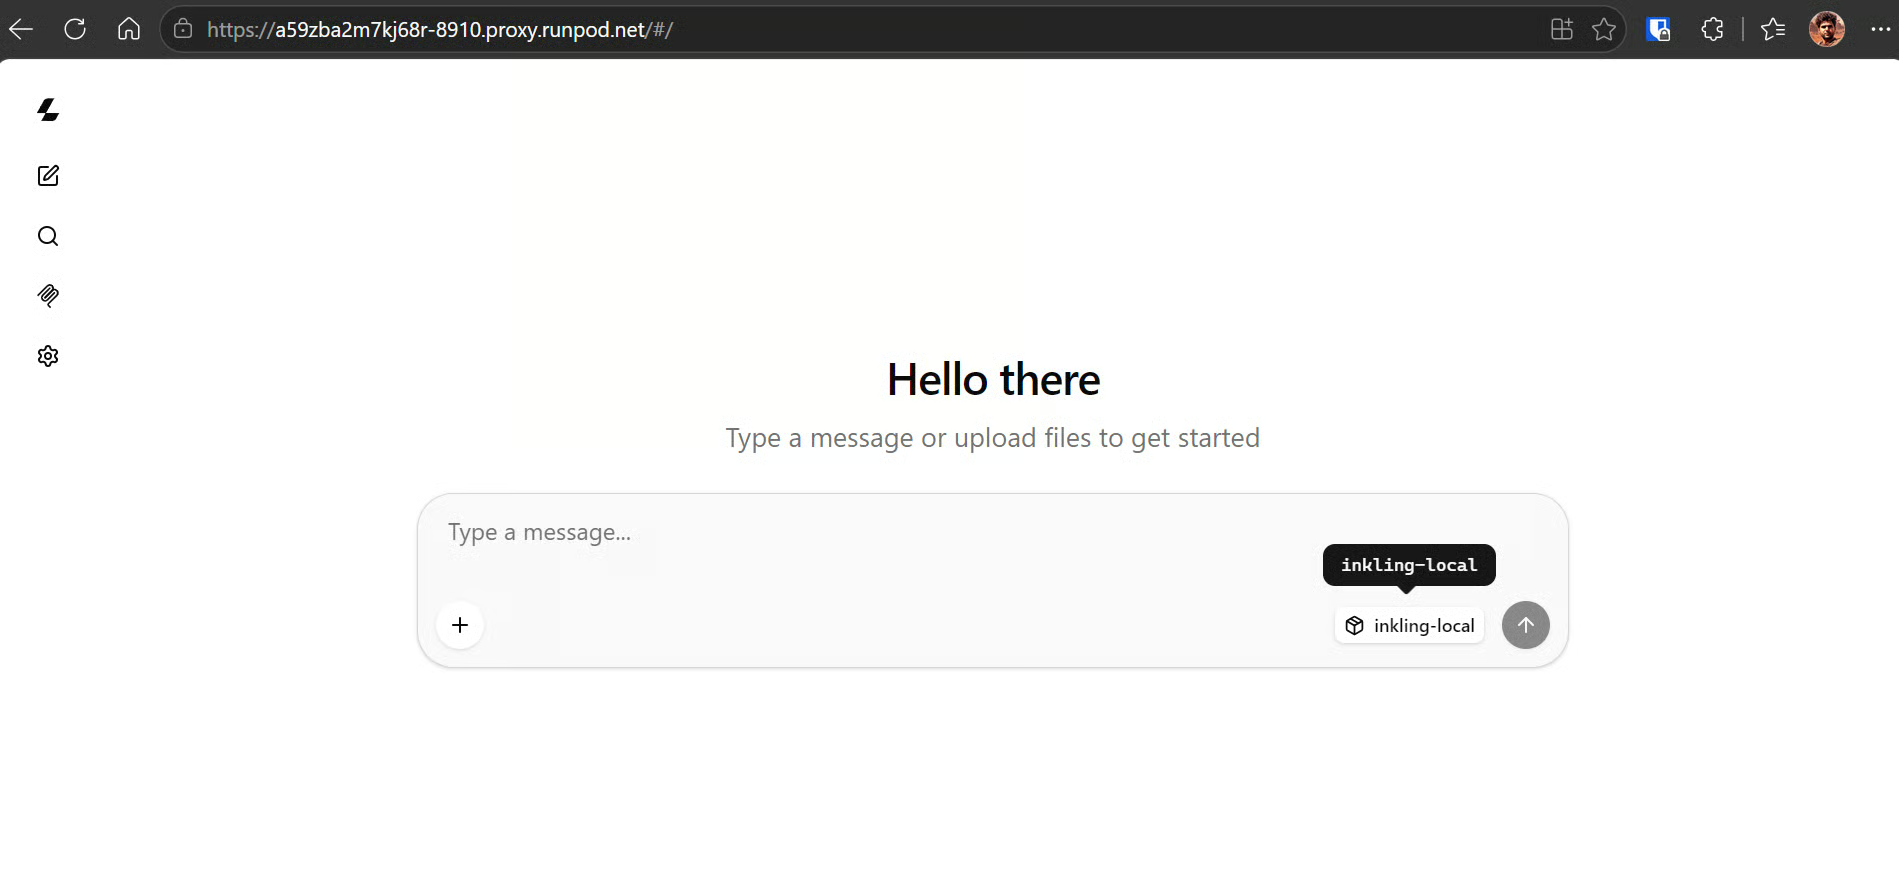
内置的 llama.cpp Web UI 提供类似 ChatGPT 的简洁界面,用于发送提示、调整生成设置并查看回复。
同一服务器还暴露了一个 OpenAI 兼容 API,便于外部应用与工具连接。
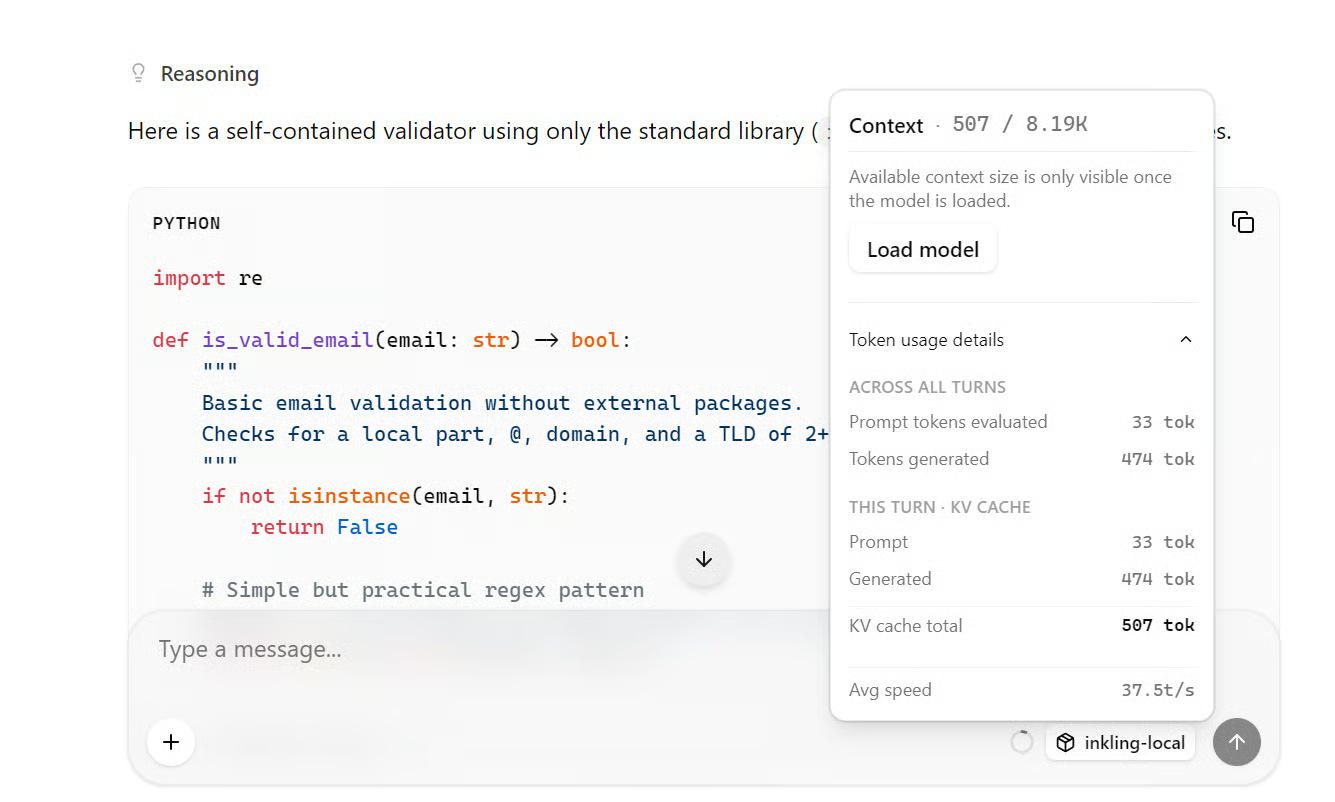
先从一个编程提示开始:
Write a Python function that validates an email address without external packages.
Include three pytest tests.
Inkling 给出了完整的讲解与可运行代码,平均生成速度约为37.5 tokens/秒。
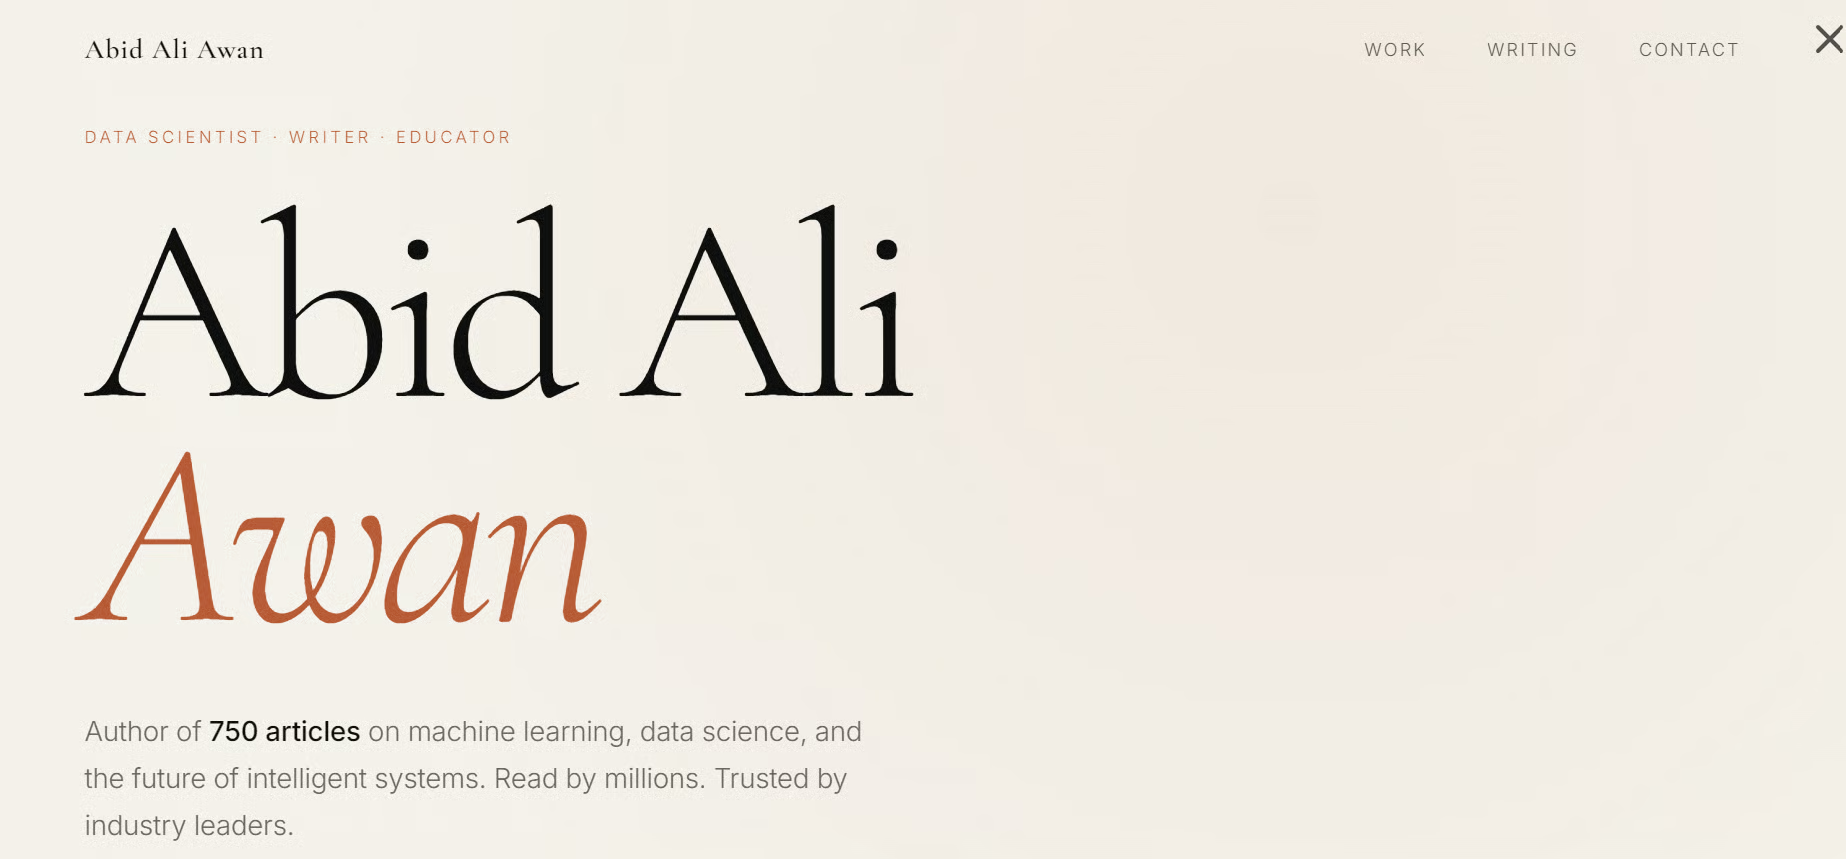
接着,我要求它创建一个个人网站。尽管使用的是高强度量化的模型,Inkling 依然生成了精致的排版、简洁的界面与可用的网站代码。
无论是在本地环境还是在线 Playground,Inkling 都未能让我眼前一亮。
其回复可用但中规中矩,而数个更小的开源模型在类似任务上表现更优。
不过,Inkling 的定位并非在某一维度称王。
它是一款平衡取向的通用模型,融合编程、写作、推理、多语种、视觉与音频能力。它在诸多基准上表现稳定,而非在某个单一领域领跑。
对于专注的编程、研究或写作任务,仍有更强的开源与闭源替代方案可选。
Inkling 的价值在于其灵活性:开放权重、多模态、可定制,并可通过Tinker(Thinking Machines 的开源训练与定制平台)进行训练或微调。
此次发布或许削弱了最初的部分热度,但也让公司的方向更为明晰。
Thinking Machines 似乎并非只为冲击最高分榜单,而是在构建围绕可适配模型的更广泛生态,使组织能够对其进行微调并用于多种任务。
Top DataCamp Courses
课程
课程
课程