
基础 Python 面试题
以下是您在初级 Python 面试中可能遇到的一些问题。
1. 什么是 Python?列举其一些关键特性。
Python 是一种多用途的高级编程语言,以易读的语法与广泛的应用而闻名。其关键特性包括:
- 简洁易读的语法:Python 语法清晰直观,便于初学者上手,也让经验丰富的开发者更高效。
- 解释型语言:逐行执行代码,便于调试与测试。
- 动态类型:无需显式声明数据类型,灵活性更高。
- 丰富的库与框架:如 NumPy、Pandas、Django 等,扩展了在数据科学、Web 开发等领域的能力。
- 跨平台兼容:可运行于 Windows、macOS、Linux 等操作系统。
2. 什么是 Python 的列表(list)与元组(tuple)?
列表与元组是 Python 的基础数据结构,具有不同的特性与用法。
列表:
- 可变: 创建后可修改元素。
- 内存占用: 占用较多内存。
- 性能: 遍历较元组慢,但插入与删除更灵活。
- 方法: 提供多种内置方法便于操作。
示例:
a_list = ["Data", "Camp", "Tutorial"]
a_list.append("Session")
print(a_list) # Output: ['Data', 'Camp', 'Tutorial', 'Session']元组:
- 不可变: 创建后不能修改元素。
- 内存占用: 占用较少内存。
- 性能: 遍历较列表快,但灵活性不如列表。
- 方法: 内置方法较少。
示例:
a_tuple = ("Data", "Camp", "Tutorial")
print(a_tuple) # Output: ('Data', 'Camp', 'Tutorial')可在我们的 Python 列表教程中了解更多。
3. Python 中的 __init__() 是什么?
__init__() 方法在面向对象编程(OOP)中被称为构造函数,用于在创建对象时初始化其状态。实例化一个类时会自动调用该方法。
目的:
- 为对象属性赋值。
- 执行初始化操作。
示例:
我们创建了 book_shop 类并添加了构造函数与 book() 方法。构造函数保存书名,book() 方法打印书名。
测试时,我们用 “Sandman” 初始化对象 b,并调用 book()。
class book_shop:
# constructor
def __init__(self, title):
self.title = title
# Sample method
def book(self):
print('The title of the book is', self.title)
b = book_shop('Sandman')
b.book()
# The title of the book is Sandman4. 可变数据类型与不可变数据类型有什么区别?
可变数据类型:
- 定义: 创建后可以被修改。
- 示例: 列表、字典、集合。
- 特性: 可添加、移除或更改元素。
- 用例: 适合需要频繁更新的集合。
示例:
# List Example
a_list = [1, 2, 3]
a_list.append(4)
print(a_list) # Output: [1, 2, 3, 4]
# Dictionary Example
a_dict = {'a': 1, 'b': 2}
a_dict['c'] = 3
print(a_dict) # Output: {'a': 1, 'b': 2, 'c': 3}不可变数据类型:
- 定义: 创建后不能被修改。
- 示例: 数值(int、float)、字符串、元组。
- 特性: 元素一旦设定不可更改;任何看似修改的操作都会创建新对象。
示例:
# Numeric Example
a_num = 10
a_num = 20 # Creates a new integer object
print(a_num) # Output: 20
# String Example
a_str = "hello"
a_str = "world" # Creates a new string object
print(a_str) # Output: world
# Tuple Example
a_tuple = (1, 2, 3)
# a_tuple[0] = 4 # This will raise a TypeError
print(a_tuple) # Output: (1, 2, 3)5. 解释列表、字典与元组的“推导式”,并举例说明。
列表
列表推导式用一行语法即可基于现有可迭代对象创建新列表。用 for 循环也能实现,但需要多行代码且可能更复杂。
列表推导式能更轻松地基于现有可迭代对象创建列表。
my_list = [i for i in range(1, 10)]
my_list
# [1, 2, 3, 4, 5, 6, 7, 8, 9]字典
与列表推导式类似,可用一行代码基于现有数据创建字典。需要用花括号 {} 包裹。
# Creating a dictionary using dictionary comprehension
my_dict = {i: i**2 for i in range(1, 10)}
# Output the dictionary
my_dict
{1: 1, 2: 4, 3: 9, 4: 16, 5: 25, 6: 36, 7: 49, 8: 64, 9: 81}元组
与列表和字典不同,没有专门的“元组推导式”。
当您用圆括号包裹推导式时,Python 实际创建的是生成器表达式,而非元组。若需要元组,需用 tuple() 转换生成器,或直接定义元组字面量。
# Generator expression (not a tuple)
my_gen = (i for i in range(1, 10))
my_gen
# <generator object <genexpr> ...>
# Converting generator to tuple
my_tuple = tuple(i for i in range(1, 10))
my_tuple
# (1, 2, 3, 4, 5, 6, 7, 8, 9)
# Or simply define a tuple directly
literal_tuple = (1, 2, 3)
literal_tuple
# (1, 2, 3)
可在我们的 Python 元组教程中进一步了解。
6. 什么是 Python 的全局解释器锁(GIL),为何重要?
全局解释器锁(GIL)是 CPython(Python 参考实现)中的一个互斥锁,用于确保任一时刻只有一个原生线程执行 Python 字节码。它通过保护内部数据结构(如引用计数)简化了内存管理,但也限制了 CPU 密集型任务的真正并行,使多线程对计算负载不那么有效。不过对于 I/O 密集型任务(如网络、文件、数据库操作中的等待),多线程仍然效果良好。
注意:Python 3.13 引入了实验性的无 GIL 构建(PEP 703),Python 3.14 增加了有文档的自由线程支持。部分 C 扩展与库可能尚未完全兼容。
中级 Python 面试题
以下是您在中级 Python 面试中可能遇到的问题。
7. 能说明 Python 中常见的搜索与图遍历算法吗?
Python 有多种强大的搜索与图遍历算法,它们针对不同数据结构与问题场景。如下:
- 二分查找:若需在已排序列表中快速定位目标,二分查找是不二之选。通过不断将搜索范围折半,直到找到目标。
- AVL 树:AVL 树可自平衡,适合频繁插入或删除的场景,避免树严重倾斜,从而保持搜索高效。
- 广度优先搜索(BFS):BFS按层遍历,适合在无权图中寻找最短路径,因为它会在深入前先检查每一层的所有可能。
- 深度优先搜索(DFS):DFS会沿分支尽可能深入,再回溯。适用于迷宫求解、树遍历等。
- A* 算法:A* 结合了 BFS 与 DFS 的优点,利用启发式函数高效寻找最短路径,常用于地图与游戏的路径规划。
8. 什么是 Python 中的 KeyError?如何处理?
当您尝试访问字典中不存在的键时,会抛出 KeyError。因为 Python 期望您查找的键存在,否则就会报错。
例如,在一个学生分数字典中访问不存在的学生会引发 KeyError。处理方式包括:
-
使用 .get() 方法:找不到键时返回
None(或指定默认值),而非报错。 -
使用 try-except 块:用
try-except捕获KeyError并优雅处理。 -
用 in 判断键是否存在: 在访问前用
if key in dictionary检查。
9. Python 如何进行内存管理?垃圾回收起何作用?
Python 通过私有堆自动管理内存,所有对象与数据结构都存储其中。内存管理由 Python 的内存管理器负责优化,而垃圾回收器则释放未使用或无引用的对象。
Python 的垃圾回收使用引用计数与循环垃圾收集器来检测并回收无用数据。对象无引用时即可回收。通过 gc 模块可与垃圾回收器交互,例如启用/禁用或手动回收。
10. 浅拷贝与深拷贝有何区别?各在何时使用?
浅拷贝与深拷贝都用于复制对象,但处理嵌套结构的方式不同。
-
浅拷贝:创建新对象,但内部元素仍引用原对象的子对象。若原对象包含可变对象(如嵌套列表),浅拷贝与原对象会共享这些子对象,修改可能相互影响。可用对象的
copy()方法或copy模块的copy()实现。 -
深拷贝:创建新对象,并递归复制其内部所有对象。即便是嵌套结构也会被完全复制,互不影响。可用
copy模块的deepcopy()实现。
因此,对仅含不可变对象或希望嵌套结构变更相互可见时用浅拷贝;处理复杂嵌套且需完全独立副本时用深拷贝。阅读我们的 Python 列表拷贝:必知要点 教程了解更多。
11. 如何使用 Python 的 collections 模块简化常见任务?
collections 模块提供了 defaultdict、Counter、deque、OrderedDict 等专用数据结构,能简化多种任务。例如 Counter 适合统计可迭代对象中的元素出现次数,defaultdict 可在无需显式检查的情况下初始化字典值。
示例:
from collections import Counter
data = ['a', 'b', 'c', 'a', 'b', 'a']
count = Counter(data)
print(count) # Output: Counter({'a': 3, 'b': 2, 'c': 1})高级 Python 面试题
以下问题面向更有经验的 Python 开发者。
12. 什么是 Python 中的猴子补丁(monkey patching)?
猴子补丁是一种动态技术,可在运行时更改代码行为。也就是说,您可以在运行时修改类或模块。
示例:
通过示例了解猴子补丁:
-
创建类
monkey,其中含有patch()方法;并在类外创建函数monk_p。 -
将
monkey.patch赋值为monk_p,以此替换patch。 -
最后通过创建
monkey对象并调用patch()来验证修改。
输出不再是 patch() is being called,而是 monk_p() is being called。
class monkey:
def patch(self):
print ("patch() is being called")
def monk_p(self):
print ("monk_p() is being called")
# replacing address of "patch" with "monk_p"
monkey.patch = monk_p
obj = monkey()
obj.patch()
# monk_p() is being called注意:请谨慎使用;猴子补丁可能降低代码可读性,并让协作开发者或测试人员感到意外。
13. Python 中的 “with” 语句用于什么?
with 语句用于异常处理,使代码更简洁,通常用于管理公共资源,如文件的创建、编辑与保存。
示例:
相比多行的 open/try/finally/close,使用 with 语句可更简洁地创建并写入文本文件。
# using with statement
with open('myfile.txt', 'w') as file:
file.write('DataCamp Black Friday Sale!!!')14. 为什么在 try/except 构造中使用 else?
try: 与 except: 常用于异常处理,那么 else: 有何用?当未发生异常时,会执行 else: 中的代码。
通过两个示例进一步理解 else:。
-
第一次输入:分子
2,分母d,输入不合法,触发except:并输出 “Invalid input!”。 -
第二次输入:分子
2,分母1,得到结果2。未触发异常,因此执行else:,打印Division is successful.
try:
num1 = int(input('Enter Numerator: '))
num2 = int(input('Enter Denominator: '))
division = num1/num2
print(f'Result is: {division}')
except:
print('Invalid input!')
else:
print('Division is successful.')
## Try 1 ##
# Enter Numerator: 2
# Enter Denominator: d
# Invalid input!
## Try 2 ##
# Enter Numerator: 2
# Enter Denominator: 1
# Result is: 2.0
# Division is successful.15. 什么是 Python 中的装饰器?
装饰器是一种设计模式,可在不修改对象结构的情况下为其添加新功能。常用于扩展函数或方法的行为。您可查看单独指南了解如何使用 Python 装饰器。
示例:
import functools
def my_decorator(func):
@functools.wraps(func) # preserves __name__, __doc__, etc.
def wrapper(*args, **kwargs):
print("Something is happening before the function is called.")
result = func(*args, **kwargs)
print("Something is happening after the function is called.")
return result
return wrapper
@my_decorator
def say_hello():
print("Hello!")
say_hello()
# Output:
# Something is happening before the function is called.
# Hello!
# Something is happening after the function is called.16. 什么是上下文管理器?如何实现?
上下文管理器用于管理资源,确保其被正确获取与释放。最常见的用法是 with 语句,例如:
class FileManager:
def __init__(self, filename, mode):
self.filename = filename
self.mode = mode
def __enter__(self):
self.file = open(self.filename, self.mode)
return self.file
def __exit__(self, exc_type, exc_value, traceback):
self.file.close()
with FileManager('test.txt', 'w') as f:
f.write('Hello, world!')在此示例中,FileManager 类是一个上下文管理器,确保在 with 代码块结束后文件被正确关闭。
17. 什么是元类?与普通类有何不同?
元类是“类的类”,用于定义类如何创建与行为。普通类用于创建对象,而元类用于创建类。通过元类,您可以在类创建期间修改类定义、强制规则或添加功能。
class Meta(type):
def __new__(cls, name, bases, dct):
print(f"Creating class {name}")
return super().__new__(cls, name, bases, dct)
class MyClass(metaclass=Meta):
pass
# Output: Creating class MyClassPython 数据科学面试题
若您更专注于 Python 在数据科学领域的应用,以下是可能遇到的问题。
18. NumPy 相比普通 Python 列表有哪些优势?
主要优势包括:
-
内存: NumPy 数组按连续内存块存储同类型元素,更省内存(具体取决于元素类型与系统,可用
sys.getsizeof或array.nbytes检查)。 -
速度: 底层用 C 优化,实现对大数组的操作远快于列表。
-
多样性: 支持向量化操作(如加法、乘法),并提供大量内置数学函数,这是列表所没有的。
19. merge、join 与 concatenate 有何区别?
Merge
使用唯一列标识将两个 DataFrame 或 Series 合并。
需要两个 DataFrame、两者共有的一列,以及指定“如何”连接。支持 left、right、outer、inner 与 cross 连接,默认是 inner。
pd.merge(df1, df2, how='outer', on='Id')Join
按索引 join DataFrame。可选的 on 参数也可指定一列或多列。默认执行左连接。
df1.join(df2)Concatenate
拼接沿指定轴(行或列)合并两个或多个 DataFrame。无需 on 参数。
pd.concat(df1,df2)- join():按索引合并两个 DataFrame。
- merge():按指定列合并两个 DataFrame。
- concat():按垂直或水平方式合并两个或多个 DataFrame。
20. 如何识别并处理缺失值?
识别缺失值
可用 isnull() 并结合 sum() 统计缺失值。isnull() 返回布尔值,sum() 给出每列缺失数量。
示例中,我们先创建列表字典并转为 pandas DataFrame,随后用 isnull().sum() 获取每列缺失数量。
import pandas as pd
import numpy as np
# dictionary of lists
dict = {'id':[1, 4, np.nan, 9],
'Age': [30, 45, np.nan, np.nan],
'Score':[np.nan, 140, 180, 198]}
# creating a DataFrame
df = pd.DataFrame(dict)
df.isnull().sum()
# id 1
# Age 2
# Score 1处理缺失值
在 Python 中有多种处理缺失值的方法。
-
若行或列包含缺失值,可用
dropna()删除。此方法可能丢失重要信息,不太推荐。 -
用常数、均值、后向填充、前向填充等方式配合
fillna()填补。 -
用
replace()将缺失值替换为常量字符串、整数或浮点数。 -
使用插值法进行填补。
注意:使用 dropna() 时尽量确保数据集足够大。
# drop missing values
df.dropna(axis = 0, how ='any')
#fillna
df.fillna(method ='bfill')
#replace null values with -999
df.replace(to_replace = np.nan, value = -999)
# Interpolate
df.interpolate(method ='linear', limit_direction ='forward')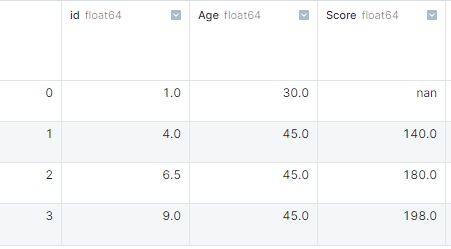
21. 您使用过哪些 Python 可视化库?
数据可视化是数据分析中最重要的环节之一。通过可视化可以直观看到数据,帮助发现隐藏模式。
最流行的 Python 可视化库包括:
- Matplotlib
- Seaborn
- Plotly
- Bokeh
Matplotlib 与 Seaborn 最为常见。
对于交互式与更复杂的应用,我们使用 Plotly,可用于创建 Web 应用或仪表板。
Bokeh 适用于大数据集上的高互动性、细节丰富的图形。
22. 您会如何在 Python 中进行归一化或标准化?
归一化将数据缩放至特定范围,通常为 [0, 1];标准化将数据转换为均值为 0、标准差为 1。这两种技术都是训练机器学习模型的关键预处理步骤。
from sklearn.preprocessing import MinMaxScaler, StandardScaler
import numpy as np
data = np.array([[1, 2], [3, 4], [5, 6]])
# Normalize
normalizer = MinMaxScaler()
normalized = normalizer.fit_transform(data)
print(normalized)
# Standardize
scaler = StandardScaler()
standardized = scaler.fit_transform(data)
print(standardized)Python 编程面试题
若您即将参加 Python 编程面试,练习类似以下问题有助于打动面试官。
23. 如何将字符串中的空格替换为指定字符?
这是一个简单的字符串处理挑战:将空格替换为指定字符。
-
示例 1:给定字符串
l vey u与字符o,输出loveyou。 -
示例 2:给定字符串
D t C mpBl ckFrid yS le与字符a,输出DataCampBlackFridaySale。
最简单的方式是使用内置的 str.replace() 方法直接将空格替换为给定字符。
def str_replace(text, ch):
return text.replace(" ", ch)
text = "D t C mpBl ckFrid yS le"
ch = "a"
str_replace(text, ch)
# 'DataCampBlackFridaySale'
24. 给定正整数 num,若 num 为完全平方数则返回 True,否则返回 False。
此题较为直接。可通过以下方法判断该数是否有整数平方根:
-
使用
math.isqrt(num)获取整数平方根。 -
将其平方并与原数比较。
-
返回布尔结果。
测试 1
将数字 10 传入 valid_square():
- 整数平方根为 3;
- 3 的平方为 9;
- 9 不等于原数,返回 False。
测试 2
将数字 36 传入 valid_square():
- 整数平方根为 6;
- 6 的平方为 36;
- 36 等于原数,返回 True。
import math
def valid_square(num):
if num < 0:
return False
square = math.isqrt(num)
return square * square == num
valid_square(10)
# False
valid_square(36)
# True25. 给定整数 n,返回 n 的阶乘 n! 中末尾零的个数。
要通过此题,您需要先计算 n!,再计算末尾零的个数。
计算阶乘
第一步,用 while 循环迭代计算 n!,当 n 等于 1 时停止。
计算末尾零
第二步,我们计算的是末尾零(trailing zeros),而非总零数,两者不同。
7! = 50407 的阶乘共有两个 0,但仅有一个末尾零,故应返回 1。
- 将阶乘结果转为字符串。
- 反向遍历。
- 若字符为 0,结果计数 +1,否则跳出循环。
- 返回结果。
方案简洁,但实现需细致。
def factorial_trailing_zeros(n):
fact = n
while n > 1:
fact *= n - 1
n -= 1
result = 0
for i in str(fact)[::-1]:
if i == "0":
result += 1
else:
break
return result
factorial_trailing_zeros(10) # 2
factorial_trailing_zeros(18) # 3参加这门关键课程:练习 Python 编程面试题,为您的下一次 Python 编程面试做好准备。
26. 字符串能否被切分为字典中的单词?
给定一个长字符串与一个词典,判断该字符串能否被切分为词典中的单词。
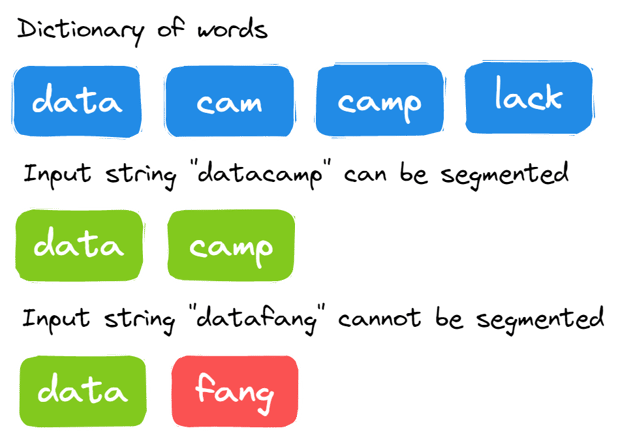
解法较直观:在每个位置切分长字符串,检查能否切分为词典中的单词。
-
按字符串长度遍历循环。
-
构造两个子串。
-
第一个子串检查
s[0:i]是否在词典中。 -
若不在,继续;
-
若在,则构造第二个子串
s[i:]。 -
若第二个子串在词典中或长度为 0,则返回 True;否则递归调用
can_segment_str()判断第二个子串能否被切分。 -
为提升长字符串的效率,引入记忆化,避免重复计算子串。
def can_segment_str(s, dictionary, memo=None):
if memo is None:
memo = {}
if s in memo:
return memo[s]
if not s:
return True
for i in range(1, len(s) + 1):
first_str = s[0:i]
if first_str in dictionary:
second_str = s[i:]
if (
not second_str
or second_str in dictionary
or can_segment_str(second_str, dictionary, memo)
):
memo[s] = True
return True
memo[s] = False
return False
s = "datacamp"
dictionary = ["data", "camp", "cam", "lack"]
can_segment_str(s, dictionary)
# True27. 能从有序数组中移除重复元素吗?
给定递增排序的整数数组,移除重复,使每个唯一元素仅出现一次。由于 Python 列表长度无法就地改变,请将结果放在同一数组的前 k 个位置并返回 k(新长度)。调用后仅前 k 个元素有效,其后元素作废。
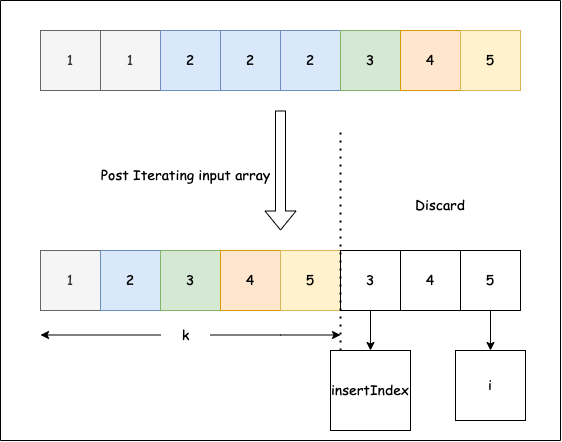
图片来源 LeetCode
示例 1:输入 [1,1,2,2],函数应返回 2。
示例 2:输入 [1,1,2,3,3],函数应返回 3。
解法:
-
从索引 1 遍历到末尾,比较当前元素与上一个唯一元素;若不同,将其写入
insertIndex位置并递增insertIndex。返回insertIndex。 -
返回的
insertIndex即为 k。
理解题意后实现并不难,关键在于把握细节。
def removeDuplicates(array):
size = len(array)
if size == 0:
return 0
insertIndex = 1
for i in range(1, size):
if array[i - 1] != array[i]:
array[insertIndex] = array[i]
insertIndex += 1
return insertIndex
array_1 = [1, 2, 2, 3, 3, 4]
k1 = removeDuplicates(array_1)
# 4; array_1[:k1] -> [1, 2, 3, 4]
array_2 = [1, 1, 3, 4, 5, 6, 6]
k2 = removeDuplicates(array_2)
# 5; array_2[:k2] -> [1, 3, 4, 5, 6]
28. 找出数组中缺失的数字
给定 1 到 n 的正整数列表,恰有一个数 x 缺失,找出 x。
示例:
|
4 |
5 |
3 |
2 |
8 |
1 |
6 |
- n = 8
- 缺失数字 = 7
这道题是简单的数学问题。
- 求列表元素之和。
- 用等差数列求和公式计算 1..n 的期望和。
- 返回期望和与实际和的差值。
def find_missing(input_list):
sum_of_elements = sum(input_list)
# There is exactly 1 number missing
n = len(input_list) + 1
actual_sum = (n * ( n + 1 ) ) / 2
return int(actual_sum - sum_of_elements)
list_1 = [1,5,6,3,4]
find_missing(list_1) # 229. 编写函数判断给定字符串是否为回文。
若一个字符串正反读都相同,则为回文。
示例:
def is_palindrome(s):
s = ''.join(e for e in s if e.isalnum()).lower() # Remove non-alphanumeric and convert to lowercase
return s == s[::-1]
print(is_palindrome("A man, a plan, a canal: Panama")) # Output: True
print(is_palindrome("hello")) # Output: False面向 Facebook、Amazon、Apple、Netflix、Google 的 Python 面试题
下面精选了一些您在热门企业(如 Meta、Amazon、Google 等)岗位面试中可能遇到的问题。
30. 找出一次买入卖出可获得的最大收益
给定股票价格列表,返回买入价与卖出价,使收益最大。
注意:只允许一次买入/卖出;若无法获利,应尽量减小亏损。
示例 1:stock_price = [8, 4, 12, 9, 20, 1],买入 = 4,卖出 = 20,最大化利润。
示例 2:stock_price = [8, 6, 5, 4, 3, 2, 1],买入 = 6,卖出 = 5,最小化亏损。
解法:
- 以列表首元素为当前买入价,以第二个元素为全局卖出价,二者差为全局利润。
- 循环遍历索引 1 至末尾。
- 在循环中,用当前元素与当前买入价计算当前利润。
- 若当前利润大于全局利润,更新全局利润与全局卖出价。
- 若当前买入价大于当前元素,更新当前买入价。
- 最终返回全局买入与全局卖出:全局买入 = 全局卖出 - 全局利润。
此题略有迷惑性,您也可以设计自己的算法来解决。
def buy_sell_stock_prices(stock_prices):
current_buy = stock_prices[0]
global_sell = stock_prices[1]
global_profit = global_sell - current_buy
for i in range(1, len(stock_prices)):
current_profit = stock_prices[i] - current_buy
if current_profit > global_profit:
global_profit = current_profit
global_sell = stock_prices[i]
if current_buy > stock_prices[i]:
current_buy = stock_prices[i]
return global_sell - global_profit, global_sell
stock_prices_1 = [10,9,16,17,19,23]
buy_sell_stock_prices(stock_prices_1)
# (9, 23)
stock_prices_2 = [8, 6, 5, 4, 3, 2, 1]
buy_sell_stock_prices(stock_prices_2)
# (6, 5)其他可能的面试题包括:
31. 数组中是否存在毕达哥拉斯三元组?
编写函数,当存在满足 a2 + b2 = c2 的三元组时返回 True。
示例:
|
输入 |
输出 |
|
[3, 1, 4, 6, 5] |
True |
|
[10, 4, 6, 12, 5] |
False |
解法:
-
将数组中所有元素平方。
-
按升序排序。
-
双层循环:外层从末尾到 1,内层从(外层索引 - 1)到起点。
-
用
set()存储外层与内层索引之间的元素。 -
检查集合中是否存在等于
(array[outerLoopIndex] – array[innerLoopIndex])的数;若有返回True,否则返回False。
def checkTriplet(array):
n = len(array)
for i in range(n):
array[i] = array[i]**2
array.sort()
for i in range(n - 1, 1, -1):
s = set()
for j in range(i - 1, -1, -1):
if (array[i] - array[j]) in s:
return True
s.add(array[j])
return False
arr = [3, 2, 4, 6, 5]
checkTriplet(arr)
# True32. 用硬币与总金额有多少种找零方式?
编写函数,给定硬币面额列表与总金额,返回找零的方式数量。
例如给定面额 [1, 2, 5] 与总金额 5,共有 四 种方式。
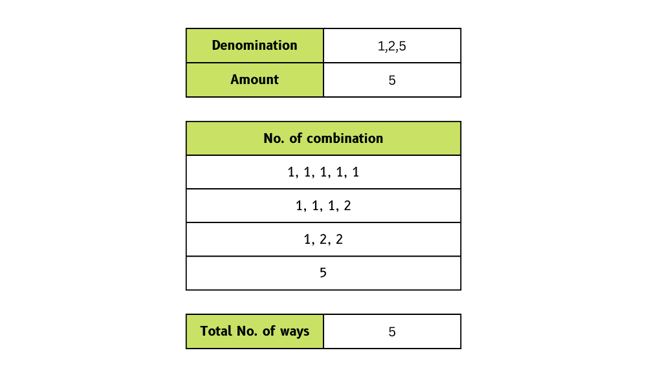
解法:
-
创建长度为
amount + 1的列表,多出的空间用于金额为 0 的解。 -
初始化
solution[0] = 1。 -
双层循环:外层遍历面额,内层从当前面额到
amount + 1。 -
不同面额的结果累加到数组 solution 中,即
solution[i] = solution[i] + solution[i - den]。
对每个面额重复上述过程,最终在 solution 列表的最后一个元素得到答案。
def solve_coin_change(denominations, amount):
solution = [0] * (amount + 1)
solution[0] = 1
for den in denominations:
for i in range(den, amount + 1):
solution[i] += solution[i - den]
return solution[amount]
denominations = [1, 2, 5]
amount = 5
solve_coin_change(denominations, amount)
# 4Google 的 Python 面试题
与其他公司类似,Google 的 Python 面试会根据岗位与经验而变化,但常见问题包括:
33. 定义 Python 中的 lambda 函数、迭代器与生成器。
Lambda 函数也称匿名函数,可接收任意数量的参数,但仅有一个表达式。
迭代器是可用于遍历可迭代对象(如列表、字典、元组、集合)的对象。
生成器与普通函数相似,但用 yield 关键字返回值;函数体中包含 yield 时即成为生成器。
在我们的完整教程中阅读更多关于Python 迭代器与生成器的内容。
34. 给定数组 arr[],找到满足 arr[j] > arr[i] 的最大 j – i
题目直观但需注意细节。给定正整数数组,找出使 array[j] > array[i] 的最大 j - i。
示例:
- 输入:[20, 70, 40, 50, 12, 38, 98],输出:6(j = 6, i = 0)
- 输入:[10, 3, 2, 4, 5, 6, 7, 8, 18, 0],输出:8(j = 8, i = 0)
解法:
- 计算数组长度,将最大差初始化为 -1。
- 双层循环:外层从左侧选元素,内层从右侧开始比较。
- 当右侧元素大于左侧选定元素时更新最大差 j - i,并继续收缩右侧索引。
def max_index_diff(array):
n = len(array)
max_diff = -1
for i in range(0, n):
j = n - 1
while(j > i):
if array[j] > array[i] and max_diff < (j - i):
max_diff = j - i
j -= 1
return max_diff
array_1 = [20,70,40,50,12,38,98]
max_index_diff(array_1)
# 635. 如何在 Python 中使用三元运算符?
三元运算符也称条件表达式:根据条件为 True 或 False 评估不同的表达式。
可用一行代码替代多行 if-else,使代码更简洁。
例如可将嵌套的 if-else 精简为一行:
If-else 写法
score = 75
if score < 70:
if score < 50:
print('Fail')
else:
print('Merit')
else:
print('Distinction')
# Distinction嵌套三元运算符
print('Fail' if score < 50 else 'Merit' if score < 70 else 'Distinction')
# Distinction36. 如何在 Python 中实现 LRU 缓存?
Python 提供内置的 functools.lru_cache 装饰器实现 LRU(最近最少使用)缓存;也可用 collections 中的 OrderedDict 手动实现。
使用 functools 的示例:
from functools import lru_cache
@lru_cache(maxsize=3)
def add(a, b):
return a + b
print(add(1, 2)) # Calculates and caches result
print(add(1, 2)) # Retrieves result from cachePython AI 与机器学习面试题
随着 AI 与大语言模型(LLM)的快速发展,Python 面试愈发聚焦现代 AI/ML 概念。以下是 2026 年需要准备的关键问题。
37. 什么是大语言模型(LLM)?如何在 Python 中使用?
大语言模型(LLM)是在海量文本数据上训练的深度学习模型,能够理解并生成类人文本。常见 LLM 包括 GPT-5、Claude、Llama、Gemini。您可以在 Python 中通过 API 调用或本地运行来使用它们。
使用 OpenAI API 的示例:
from openai import OpenAI
client = OpenAI(api_key="your-api-key")
response = client.chat.completions.create(
model="gpt-4",
messages=[
{"role": "system", "content": "You are a helpful assistant."},
{"role": "user", "content": "Explain Python decorators in simple terms."}
]
)
print(response.choices[0].message.content)在我们的教程中了解更多:如何用 LangChain 构建 LLM 应用。
38. 什么是 RAG(检索增强生成)?为何重要?
RAG 将检索系统与生成式 AI 结合,以生成更准确、基于事实的回答。它不是只依赖 LLM 的训练数据,而是从知识库检索相关文档作为生成上下文。
RAG 系统关键组件:
- 文档存储:向量数据库(如 Pinecone、Chroma、FAISS)存储嵌入后的文档
- 检索器:基于查询相似度查找相关文档
- 生成器:利用检索到的上下文进行回答的 LLM
RAG 工作流示例:
from langchain.vectorstores import Chroma
from langchain.embeddings import OpenAIEmbeddings
from langchain.chat_models import ChatOpenAI
from langchain.chains import RetrievalQA
# Create vector store from documents
embeddings = OpenAIEmbeddings()
vectorstore = Chroma.from_documents(documents, embeddings)
# Create RAG chain
llm = ChatOpenAI(model="gpt-4")
qa_chain = RetrievalQA.from_chain_type(
llm=llm,
retriever=vectorstore.as_retriever()
)
# Query the system
result = qa_chain.invoke("What are Python best practices?")
print(result)进阶技巧请阅读如何提升 RAG 性能。
39. 在 AI 应用中如何使用 Python 的 async/await?
异步编程对需要大量 API 调用或并发请求的 AI 应用至关重要。Python 的 asyncio 模块支持非阻塞 I/O。
示例:并发进行 LLM API 调用:
import asyncio
from openai import AsyncOpenAI
client = AsyncOpenAI()
async def get_completion(prompt: str) -> str:
response = await client.chat.completions.create(
model="gpt-4",
messages=[{"role": "user", "content": prompt}]
)
return response.choices[0].message.content
async def process_multiple_prompts(prompts: list[str]) -> list[str]:
tasks = [get_completion(prompt) for prompt in prompts]
return await asyncio.gather(*tasks)
# Run concurrent requests
prompts = ["Explain Python lists", "Explain Python dicts", "Explain Python sets"]
results = asyncio.run(process_multiple_prompts(prompts))
for result in results:
print(result)深入阅读我们的Python 异步编程指南。
40. 什么是嵌入(embeddings)?其在机器学习中的作用是什么?
嵌入是对数据(文本、图像等)的稠密向量表示,能捕捉语义信息。相似的项目有相似的嵌入,支持语义搜索、聚类与推荐等任务。
示例:创建文本嵌入:
from sentence_transformers import SentenceTransformer
import numpy as np
# Load embedding model
model = SentenceTransformer('all-MiniLM-L6-v2')
# Create embeddings
sentences = [
"Python is a programming language",
"JavaScript is used for web development",
"Python is great for data science"
]
embeddings = model.encode(sentences)
# Calculate similarity
def cosine_similarity(a, b):
return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))
# Python sentences are more similar to each other
print(f"Similarity 0-2: {cosine_similarity(embeddings[0], embeddings[2]):.3f}") # Higher
print(f"Similarity 0-1: {cosine_similarity(embeddings[0], embeddings[1]):.3f}") # Lower41. 如何在 Python 中构建一个 AI Agent?
AI Agent 是能感知环境、做出决策并采取行动以达成目标的自治系统。现代 AI Agent 通常结合 LLM、工具与记忆。
AI Agent 的关键组件:
- LLM 核心:处理输入并做出行动决策的推理引擎
- 工具:Agent 可调用的函数(如网页搜索、代码执行、API)
- 记忆:短期(对话)与长期(向量库)记忆
- 规划:将复杂任务拆解为子任务
使用 LangChain 的示例:
from langchain.agents import create_openai_functions_agent, AgentExecutor
from langchain.chat_models import ChatOpenAI
from langchain.tools import Tool
from langchain import hub
# Define tools
def search_database(query: str) -> str:
return f"Results for: {query}"
tools = [
Tool(
name="DatabaseSearch",
func=search_database,
description="Search the company database for information"
)
]
# Create agent
llm = ChatOpenAI(model="gpt-4")
prompt = hub.pull("hwchase17/openai-functions-agent")
agent = create_openai_functions_agent(llm, tools, prompt)
agent_executor = AgentExecutor(agent=agent, tools=tools)
# Run agent
result = agent_executor.invoke({"input": "Find sales data for Q4"})
print(result["output"])了解更多:用 LangChain 构建 Agent 实现自动化。
用 Python 为团队赋能
Python 面试准备对求职者与招聘经理至关重要,同时企业也应为团队持续投入 Python 培训。在自动化、数据分析与软件开发至关重要的时代,确保员工具备扎实的 Python 技能,将成为推动公司成功的关键因素。
如果您是团队负责人或企业主,希望确保团队整体精通 Python,DataCamp for Business 提供定制培训项目,帮助员工从基础到高级全面掌握 Python 技能。我们可以提供:
- 定向学习路径:可根据团队当前水平与业务需求定制。
- 实践练习:基于真实场景的项目与编程练习,强化学习与记忆。
- 进度追踪:监控与评估团队进展,确保达成学习目标。
通过如 DataCamp 这样的平台进行 Python 技能提升,不仅增强团队能力,也将为企业带来战略优势,助力创新、保持竞争力并交付有影响力的成果。欢迎联系团队并申请演示。
结语
无论您是有志成为数据从业者、开发者,还是软件工程师,熟练掌握 Python 面试题对在技术面试中脱颖而出至关重要。本文概述了从基础到高级的常见 Python 面试题、编码挑战,以及顶尖科技公司的特定问题。
通过练习这些问题并理解其解法,您可以显著提升问题解决能力与技术素养,为顺利通过技术与编码环节打下坚实基础。
追求顶尖的Python 认证,并通过课程与项目持续学习,将进一步巩固您的专业能力与行业竞争力。若您需要温习技能,务必完成我们的 Associate Data Scientist in Python 职业路径。
若您正准备 AI 与机器学习岗位面试,我们的 Python 机器学习教程 提供基于 scikit-learn 与其他关键库的动手实践。
Python 面试常见问答
如何准备 Python 面试?
您需要复习 Python 语法、函数、类、数据类型、算法、数据结构与异常处理。此外,阅读技术教程、回顾示例项目、查看备忘单与模拟题,并多做编码挑战,帮助通过面试。
需准备通用的 Python 原生功能问题、岗位相关问题(数据工程师、数据科学家、后端开发等),以及限时的代码题。您可以在 DataCamp 练习机器学习 Python 面试题与统计类 Python 面试题。
如何在 Python 编程面试中脱颖而出?
您需要展示编写整洁、可用于生产的代码能力,理解岗位相关的 Python 库、工具与算法,并能为复杂问题提出独到解法。这些都可以通过练习编码挑战或参与开源项目来实现。
同时,您还可以通过在 GitHub 与个人网站上创建基于 Python 的项目组合来脱颖而出。
Python 中的 Lambda 是什么?
Python 的五大主要用途是什么?
- 开发网站与软件
- 脚本与实用工具
- 桌面应用
- 数据分析
- 机器学习
map 比 for 循环更快吗?
当对可迭代对象的每个元素都应用同一函数时,“map” 通常比 “for 循环” 更快。
是否有免费的 Python 面试备考资源?
当然!如果您是高校教师或学生,可以使用 DataCamp Classrooms 免费获取我们完整课程目录。
2026 年 AI/ML 面试应重点关注哪些 Python 主题?
针对 2026 年的 AI/ML 面试,请重点关注:LLM 概念(Transformer、注意力机制、微调 vs 提示)、RAG(检索增强生成)系统、向量数据库与嵌入、用于 API 调用的 Python 异步编程,以及 LangChain、Hugging Face、PyTorch 等框架。您还应了解提示工程技巧与模型评估方法。
Python 作为最通用、最受欢迎的编程语言之一,持续引领科技行业。无论您是在准备技术面试,还是想提升编码能力,精通 Python 都至关重要。面试通常会涉及用 Python 解决挑战并解释复杂功能。
本指南汇总了最常见与进阶的 Python 面试题清单。通过练习这些问题,数据从业者、开发者与软件工程师将具备在技术面试中脱颖而出的能力,推动职业发展。
要点速览
__init__(),以及 GIL