
बेसिक Python इंटरव्यू प्रश्न
ये कुछ प्रश्न हैं जो आपको एंट्री-लेवल Python इंटरव्यू में मिल सकते हैं।
1. Python क्या है, और इसकी कुछ प्रमुख विशेषताएँ बताइए।
Python एक बहुउद्देशीय, उच्च-स्तरीय प्रोग्रामिंग भाषा है, जो आसान और पढ़ने योग्य सिंटैक्स और व्यापक अनुप्रयोगों के लिए जानी जाती है। यहाँ Python की कुछ प्रमुख विशेषताएँ हैं:
- सरल और पठनीय सिंटैक्स: Python का सिंटैक्स स्पष्ट और सीधा है, जो शुरुआती लोगों के लिए सुलभ और अनुभवी डेवलपर्स के लिए कुशल है।
- इंटरप्रेटेड भाषा: Python कोड को पंक्ति-दर-पंक्ति निष्पादित करता है, जो डिबगिंग और टेस्टिंग में मदद करता है।
- डायनामिक टाइपिंग: Python में स्पष्ट डेटा टाइप डिक्लेरेशन की आवश्यकता नहीं होती, जिससे अधिक लचीलापन मिलता है।
- विस्तृत लाइब्रेरी और फ्रेमवर्क: NumPy, Pandas, और Django जैसी लाइब्रेरी Python की क्षमताओं को डेटा साइंस, वेब डेवलपमेंट और अन्य विशेष कार्यों के लिए बढ़ाती हैं।
- क्रॉस-प्लेटफॉर्म संगतता: Python Windows, macOS, और Linux सहित अलग-अलग ऑपरेटिंग सिस्टम पर चल सकता है।
2. Python में lists और tuples क्या हैं?
Lists और tuples Python की मूलभूत डेटा संरचनाएँ हैं, जिनकी विशेषताएँ और उपयोग अलग-अलग होते हैं।
List:
- Mutable: निर्माण के बाद तत्व बदले जा सकते हैं।
- मेमोरी उपयोग: अधिक मेमोरी लेती है।
- प्रदर्शन: tuples की तुलना में iteration धीमा, लेकिन insertion और deletion के लिए बेहतर।
- मेथड्स: मैनीपुलेशन के लिए कई बिल्ट-इन मेथड्स उपलब्ध।
उदाहरण:
a_list = ["Data", "Camp", "Tutorial"]
a_list.append("Session")
print(a_list) # Output: ['Data', 'Camp', 'Tutorial', 'Session']Tuple:
- Immutable: निर्माण के बाद तत्व नहीं बदले जा सकते।
- मेमोरी उपयोग: कम मेमोरी लेता है।
- प्रदर्शन: lists की तुलना में iteration तेज, लेकिन लचीलापन कम।
- मेथड्स: सीमित बिल्ट-इन मेथड्स।
उदाहरण:
a_tuple = ("Data", "Camp", "Tutorial")
print(a_tuple) # Output: ('Data', 'Camp', 'Tutorial')और जानें: Python Lists ट्यूटोरियल।
3. Python में __init__() क्या है?
__init__() मेथड OOP शब्दावली में कंस्ट्रक्टर कहलाता है। यह किसी ऑब्जेक्ट के बनते समय उसकी स्टेट इनिशियलाइज़ करने के लिए उपयोग होता है। यह मेथड किसी क्लास के नए इंस्टेंस के बनने पर स्वतः कॉल होता है।
उद्देश्य:
- ऑब्जेक्ट की प्रॉपर्टीज़ को मान असाइन करना।
- कोई भी इनिशियलाइजेशन ऑपरेशन करना।
उदाहरण:
हमने book_shop क्लास बनाया और उसमें कंस्ट्रक्टर तथा book() फंक्शन जोड़ा। कंस्ट्रक्टर किताब के शीर्षक को स्टोर करेगा और book() फंक्शन किताब का नाम प्रिंट करेगा।
कोड टेस्ट करने के लिए हमने b ऑब्जेक्ट को “Sandman” से इनिशियलाइज़ किया और book() चलाया।
class book_shop:
# constructor
def __init__(self, title):
self.title = title
# Sample method
def book(self):
print('The title of the book is', self.title)
b = book_shop('Sandman')
b.book()
# The title of the book is Sandman4. Mutable और Immutable डेटा टाइप में क्या अंतर है?
Mutable डेटा टाइप्स:
- परिभाषा: ऐसे डेटा टाइप्स जिन्हें बनाने के बाद बदला जा सकता है।
- उदाहरण: List, Dictionary, Set.
- विशेषताएँ: तत्व जोड़े, हटाए या बदले जा सकते हैं।
- उपयोग: उन कलेक्शंस के लिए उपयुक्त जहाँ बार-बार अपडेट आवश्यक हो।
उदाहरण:
# List Example
a_list = [1, 2, 3]
a_list.append(4)
print(a_list) # Output: [1, 2, 3, 4]
# Dictionary Example
a_dict = {'a': 1, 'b': 2}
a_dict['c'] = 3
print(a_dict) # Output: {'a': 1, 'b': 2, 'c': 3}Immutable डेटा टाइप्स:
- परिभाषा: ऐसे डेटा टाइप्स जिन्हें बनाने के बाद बदला नहीं जा सकता।
- उदाहरण: Numeric (int, float), String, Tuple.
- विशेषताएँ: एक बार सेट होने के बाद तत्वों को बदला नहीं जा सकता; कोई भी ऑपरेशन जो बदलाव जैसा लगे, वह नया ऑब्जेक्ट बनाता है।
उदाहरण:
# Numeric Example
a_num = 10
a_num = 20 # Creates a new integer object
print(a_num) # Output: 20
# String Example
a_str = "hello"
a_str = "world" # Creates a new string object
print(a_str) # Output: world
# Tuple Example
a_tuple = (1, 2, 3)
# a_tuple[0] = 4 # This will raise a TypeError
print(a_tuple) # Output: (1, 2, 3)5. List, Dictionary, और Tuple comprehension को उदाहरण सहित समझाइए।
List
List comprehension मौजूदा सूची के मानों के आधार पर नई सूची बनाने के लिए एक-लाइन सिंटैक्स देता है। आप for लूप से भी यही कर सकते हैं, लेकिन वह कई पंक्तियाँ लेगा और कभी-कभी जटिल हो सकता है।
List comprehension किसी मौजूदा iterable के आधार पर सूची बनाना आसान बनाता है।
my_list = [i for i in range(1, 10)]
my_list
# [1, 2, 3, 4, 5, 6, 7, 8, 9]Dictionary
List comprehension की तरह, आप एक लाइन में मौजूदा तालिका के आधार पर dictionary बना सकते हैं। ऑपरेशन को कर्ली ब्रैकेट्स {} में रखना होता है।
# Creating a dictionary using dictionary comprehension
my_dict = {i: i**2 for i in range(1, 10)}
# Output the dictionary
my_dict
{1: 1, 2: 4, 3: 9, 4: 16, 5: 25, 6: 36, 7: 49, 8: 64, 9: 81}Tuple
Lists और dictionaries के विपरीत, कोई विशेष “tuple comprehension” नहीं है।
Parentheses के साथ comprehension का उपयोग करने पर Python वास्तव में generator expression बनाता है, न कि tuple। Tuple पाने के लिए या तो tuple() से जनरेटर को कन्वर्ट करें या सीधे tuple literal परिभाषित करें।
# Generator expression (not a tuple)
my_gen = (i for i in range(1, 10))
my_gen
# <generator object <genexpr> ...>
# Converting generator to tuple
my_tuple = tuple(i for i in range(1, 10))
my_tuple
# (1, 2, 3, 4, 5, 6, 7, 8, 9)
# Or simply define a tuple directly
literal_tuple = (1, 2, 3)
literal_tuple
# (1, 2, 3)
इसके बारे में अधिक जानें: Python Tuples ट्यूटोरियल।
6. Python में Global Interpreter Lock (GIL) क्या है और यह क्यों महत्वपूर्ण है?
GIL CPython (रिफरेंस Python इम्प्लीमेंटेशन) में एक म्यूटेक्स है जो सुनिश्चित करता है कि एक समय में केवल एक नेटिव थ्रेड Python बाइटकोड निष्पादित करे। यह रेफरेंस काउंट्स जैसी आंतरिक डेटा संरचनाओं की सुरक्षा करके मेमोरी प्रबंधन को सरल बनाता है, लेकिन CPU-बाउंड टास्क्स में वास्तविक पैरेललिज़्म को सीमित करता है, जिससे कंप्यूटेशनल वर्कलोड के लिए मल्टीथ्रेडिंग कम प्रभावी होती है। हालाँकि, I/O-बाउंड टास्क्स के लिए यह अच्छा काम करता है, जहाँ थ्रेड्स नेटवर्क, फाइल, या डेटाबेस ऑपरेशंस का इंतज़ार करते हैं।
नोट: Python 3.13 में एक एक्सपेरिमेंटल no-GIL बिल्ड (PEP 703) आया, और Python 3.14 दस्तावेजीकृत फ्री-थ्रेडेड सपोर्ट जोड़ता है। कुछ C एक्सटेंशंस और लाइब्रेरी अभी पूरी तरह संगत नहीं हो सकते।
इंटरमीडिएट Python इंटरव्यू प्रश्न
ये कुछ प्रश्न हैं जो इंटरमीडिएट-लेवल Python इंटरव्यू में आ सकते हैं।
7. Python में सामान्य सर्चिंग और ग्राफ ट्रैवर्सल एल्गोरिदम समझाइए।
Python में सर्चिंग और ग्राफ ट्रैवर्सल के कई शक्तिशाली एल्गोरिदम हैं, जो अलग-अलग डेटा स्ट्रक्चर्स और समस्याओं के लिए उपयोगी हैं। संक्षेप में:
- Binary Search: सॉर्टेड लिस्ट में तेजी से आइटम ढूँढने के लिए बाइनरी सर्च उपयोगी है। यह रेंज को बार-बार आधा करता है।
- AVL Tree: AVL ट्री सेल्फ-बैलेंसिंग बाइनरी सर्च ट्री है, जो बार-बार insertion/deletion पर भी सर्च तेज रखता है।
- Breadth-First Search (BFS): BFS ग्राफ को लेवल-बाय-लेवल एक्सप्लोर करता है। अनवेटेड ग्राफ में शॉर्टेस्ट पाथ ढूँढने में खासा उपयोगी।
- Depth-First Search (DFS): DFS हर ब्रांच में जितना संभव हो उतना गहराई तक जाता है, फिर बैकट्रैक करता है। मेज़-सॉल्विंग या ट्री ट्रैवर्सल के लिए बढ़िया।
- A* Algorithm: A* heuristic का उपयोग करके कुशलतापूर्वक शॉर्टेस्ट पाथ खोजता है। मैप्स और गेम्स में आम।
8. Python में KeyError क्या है, और इसे कैसे संभालते हैं?
KeyError तब होता है जब आप dictionary में मौजूद नहीं किसी key को एक्सेस करते हैं। Python अपेक्षा करता है कि जो key आप ढूँढ रहे हैं वह dictionary में हो; नहीं होने पर KeyError उठता है।
जैसे, यदि आपके पास स्टूडेंट स्कोर की dictionary है और आप ऐसे स्टूडेंट को एक्सेस करते हैं जो मौजूद नहीं, तो KeyError आएगा। इसे संभालने के तरीके:
-
.get() मेथड का उपयोग: key न मिलने पर यह
None(या दिया गया डिफॉल्ट) लौटाता है, एरर नहीं फेंकता। -
try-except ब्लॉक का उपयोग:
try-exceptमें कोड लपेटकरKeyErrorपकड़ें और ग्रेसफुल हैंडल करें। -
in के साथ key जाँचें: एक्सेस से पहले
if key in dictionaryसे जाँच करें।
9. Python मेमोरी मैनेजमेंट कैसे करता है, और garbage collection की क्या भूमिका है?
Python एक private heap के माध्यम से मेमोरी एलोकेशन/डीएलोकेशन स्वतः प्रबंधित करता है, जहाँ सभी ऑब्जेक्ट्स और डेटा संरचनाएँ संग्रहीत होती हैं। मेमोरी मैनेजर मेमोरी उपयोग को ऑप्टिमाइज़ करता है, जबकि garbage collector अनयूज़्ड/अनरेफरेंस्ड ऑब्जेक्ट्स को हटाकर मेमोरी मुक्त करता है।
Python में garbage collection रेफरेंस काउंटिंग और cyclic GC दोनों का उपयोग करता है। जब किसी ऑब्जेक्ट के रेफरेंसेज़ नहीं बचते, तो वह कलेक्शन के लिए पात्र होता है। gc मॉड्यूल से आप GC को सक्षम/अक्षम कर सकते हैं या मैनुअल कलेक्शन कर सकते हैं।
10. Shallow copy और deep copy में क्या अंतर है, और कब किसका उपयोग करेंगे?
दोनों कॉपी करना संभव बनाते हैं, पर nested स्ट्रक्चर्स को अलग तरह से हैंडल करते हैं।
-
Shallow Copy: नया ऑब्जेक्ट बनता है, लेकिन अंदर के mutable ऑब्जेक्ट्स के रेफरेंस कॉपी होते हैं। nested संरचनाओं में बदलाव दोनों में प्रतिबिंबित हो सकते हैं।
copy()मेथड याcopyमॉड्यूल कीcopy()से बनाते हैं। -
Deep Copy: नया ऑब्जेक्ट बनाकर अंदर तक recursively कॉपी करता है, इसलिए बदलाव स्वतंत्र रहते हैं।
copy.deepcopy()से बनाते हैं।
इसलिए, shallow copy तब ठीक है जब अंदर केवल immutable हों या साझा बदलाव चाहिए हों; deep copy जटिल nested ऑब्जेक्ट्स के स्वतंत्र डुप्लीकेट के लिए। और पढ़ें: Python Copy List: What You Should Know ट्यूटोरियल।
11. सामान्य कार्यों को सरल बनाने के लिए आप Python के collections मॉड्यूल का उपयोग कैसे करेंगे?
collections मॉड्यूल defaultdict, Counter, deque, और OrderedDict जैसे विशेष डेटा स्ट्रक्चर्स देता है। जैसे Counter iterable में तत्वों की गिनती के लिए बढ़िया है, जबकि defaultdict बिना जाँच के डिफॉल्ट मान सेट कर देता है।
उदाहरण:
from collections import Counter
data = ['a', 'b', 'c', 'a', 'b', 'a']
count = Counter(data)
print(count) # Output: Counter({'a': 3, 'b': 2, 'c': 1})एडवांस्ड Python इंटरव्यू प्रश्न
ये प्रश्न अधिक अनुभवी Python प्रैक्टिशनर्स के लिए हैं।
12. Python में monkey patching क्या है?
Monkey patching एक डायनामिक तकनीक है जिससे रन-टाइम पर कोड के व्यवहार को बदला जा सकता है। संक्षेप में, आप रन-टाइम पर किसी क्लास या मॉड्यूल को संशोधित कर सकते हैं।
उदाहरण:
इसे उदाहरण से समझते हैं।
-
हमने
monkeyक्लास बनाया जिसमेंpatch()फंक्शन है। क्लास के बाहरmonk_pफंक्शन भी बनाया। -
अब
monkey.patchकोmonk_pअसाइन करकेpatchको रिप्लेस करेंगे। -
अंत में
monkeyसे ऑब्जेक्ट बनाकरpatch()चलाकर बदलाव टेस्ट करेंगे।
patch() is being called की जगह monk_p() is being called दिखेगा।
class monkey:
def patch(self):
print ("patch() is being called")
def monk_p(self):
print ("monk_p() is being called")
# replacing address of "patch" with "monk_p"
monkey.patch = monk_p
obj = monkey()
obj.patch()
# monk_p() is being calledसावधानी: इसे कम उपयोग करें; monkey patching कोड को पढ़ना कठिन बना सकता है और सहकर्मियों या टेस्ट्स के लिए आश्चर्यजनक हो सकता है।
13. Python में “with” स्टेटमेंट किसके लिए डिज़ाइन किया गया है?
with स्टेटमेंट एक्सेप्शन हैंडलिंग और रिसोर्स मैनेजमेंट को सरल और साफ बनाता है। इसे आमतौर पर फाइल बनाना, एडिट करना, और सेव करने जैसे कॉमन रिसोर्स मैनेजमेंट के लिए उपयोग करते हैं।
उदाहरण:
open, try, finally, close की कई पंक्तियाँ लिखने के बजाय with से फाइल बनाना/लिखना आसान है।
# using with statement
with open('myfile.txt', 'w') as file:
file.write('DataCamp Black Friday Sale!!!')14. Python में try/except संरचना में else का उपयोग क्यों करते हैं?
try: और except: एक्सेप्शन हैंडलिंग के लिए जाने जाते हैं; else: तब चलता है जब कोई एक्सेप्शन नहीं उठता।
इसे उदाहरण से समझते हैं:
-
पहली बार
2न्यूमेरेटर औरdडिनॉमिनेटर दिया। यह गलत है,except:ट्रिगर हुआ: “Invalid input!”. -
दूसरी बार
2न्यूमेरेटर और1डिनॉमिनेटर दिया, परिणाम2मिला। कोई एक्सेप्शन नहीं, इसलिएelse:चला:Division is successful.
try:
num1 = int(input('Enter Numerator: '))
num2 = int(input('Enter Denominator: '))
division = num1/num2
print(f'Result is: {division}')
except:
print('Invalid input!')
else:
print('Division is successful.')
## Try 1 ##
# Enter Numerator: 2
# Enter Denominator: d
# Invalid input!
## Try 2 ##
# Enter Numerator: 2
# Enter Denominator: 1
# Result is: 2.0
# Division is successful.15. Python में decorators क्या होते हैं?
Decorators एक डिज़ाइन पैटर्न है जो किसी मौजूदा ऑब्जेक्ट के स्ट्रक्चर को बदले बिना नई फंक्शनैलिटी जोड़ने देता है। इन्हें प्रायः फंक्शंस/मेथड्स के व्यवहार को बढ़ाने के लिए उपयोग करते हैं। अधिक पढ़ें: Python decorators का उपयोग कैसे करें।
उदाहरण:
import functools
def my_decorator(func):
@functools.wraps(func) # preserves __name__, __doc__, etc.
def wrapper(*args, **kwargs):
print("Something is happening before the function is called.")
result = func(*args, **kwargs)
print("Something is happening after the function is called.")
return result
return wrapper
@my_decorator
def say_hello():
print("Hello!")
say_hello()
# Output:
# Something is happening before the function is called.
# Hello!
# Something is happening after the function is called.16. Python में context managers क्या होते हैं, और इन्हें कैसे इम्प्लीमेंट करते हैं?
Context managers रिसोर्स मैनेजमेंट के लिए होते हैं ताकि रिसोर्स सही तरह से हासिल/रिलीज़ हों। सबसे सामान्य उपयोग with स्टेटमेंट है, जैसे:
class FileManager:
def __init__(self, filename, mode):
self.filename = filename
self.mode = mode
def __enter__(self):
self.file = open(self.filename, self.mode)
return self.file
def __exit__(self, exc_type, exc_value, traceback):
self.file.close()
with FileManager('test.txt', 'w') as f:
f.write('Hello, world!')इस उदाहरण में FileManager एक context manager है जो with ब्लॉक के बाद फाइल को सही तरह से बंद कर देता है।
17. Python में metaclasses क्या हैं, और ये सामान्य क्लासेस से कैसे भिन्न हैं?
Metaclasses, क्लासेस की क्लासेस होती हैं। ये क्लासेस के व्यवहार और निर्माण को परिभाषित करती हैं। जहाँ सामान्य क्लासेस ऑब्जेक्ट्स बनाती हैं, metaclasses क्लासेस बनाती हैं। इनके माध्यम से आप क्लास डेफिनिशन में बदलाव, नियम लागू, या निर्माण के दौरान फंक्शनैलिटी जोड़ सकते हैं।
class Meta(type):
def __new__(cls, name, bases, dct):
print(f"Creating class {name}")
return super().__new__(cls, name, bases, dct)
class MyClass(metaclass=Meta):
pass
# Output: Creating class MyClassPython डेटा साइंस इंटरव्यू प्रश्न
जो लोग Python के डेटा साइंस अनुप्रयोगों पर अधिक केंद्रित हैं, उनके लिए ये कुछ प्रश्न आ सकते हैं।
18. साधारण Python lists पर NumPy के क्या फायदे हैं?
NumPy के कई फायदे हैं, जैसे:
-
मेमोरी: NumPy arrays समान प्रकार के तत्वों को सटे हुए ब्लॉक्स में स्टोर करते हैं, hence अधिक मेमोरी-कुशल होते हैं। (सटीक उपयोग एलिमेंट टाइप और सिस्टम पर निर्भर है;
sys.getsizeofयाarray.nbytesसे जाँचें।) -
स्पीड: NumPy ऑप्टिमाइज़्ड C इम्प्लीमेंटेशंस का उपयोग करता है, बड़े arrays पर ऑपरेशंस lists से काफी तेज़ हैं।
-
वर्सेटिलिटी: NumPy वेक्टराइज़्ड ऑपरेशंस (जैसे जोड़, गुणा) सपोर्ट करता है और कई बिल्ट-इन गणितीय फंक्शंस देता है, जो Python lists में नहीं हैं।
19. merge, join, और concatenate में क्या अंतर है?
Merge
दो DataFrames या series ऑब्जेक्ट्स को यूनिक कॉलम आइडेंटिफायर से मर्ज करें।
दो DataFrames, दोनों में एक कॉमन कॉलम, और “कैसे” जोड़ना है—left, right, outer, inner, या cross—की ज़रूरत होती है। डिफॉल्ट inner join है।
pd.merge(df1, df2, how='outer', on='Id')Join
DataFrames को join यूनिक इंडेक्स से करता है। वैकल्पिक on आर्ग्युमेंट एक कॉलम/मल्टिपल कॉलम नाम हो सकता है। डिफॉल्ट left join है।
df1.join(df2)Concatenate
Concatenate दो/एकाधिक DataFrames को चुने हुए axis (rows या columns) पर जोड़ता है। on आर्ग्युमेंट की आवश्यकता नहीं।
pd.concat(df1,df2)- join(): इंडेक्स द्वारा दो DataFrames को जोड़ता है।
- merge(): निर्दिष्ट कॉलम/कॉलम्स द्वारा जोड़ता है।
- concat(): दो या अधिक DataFrames को वर्टिकली/हॉरिजॉन्टली जोड़ता है।
20. आप missing values की पहचान और हैंडलिंग कैसे करेंगे?
Missing values की पहचान
isnull() के साथ sum() लगाने से DataFrame में मिसिंग वैल्यूज़ पहचानी जा सकती हैं। isnull() बूलियन देता है, और sum प्रति कॉलम मिसिंग वैल्यूज़ की संख्या।
उदाहरण में हमने लिस्ट्स की dictionary से pandas DataFrame बनाया, और isnull().sum() से प्रत्येक कॉलम में मिसिंग वैल्यूज़ गिनीं।
import pandas as pd
import numpy as np
# dictionary of lists
dict = {'id':[1, 4, np.nan, 9],
'Age': [30, 45, np.nan, np.nan],
'Score':[np.nan, 140, 180, 198]}
# creating a DataFrame
df = pd.DataFrame(dict)
df.isnull().sum()
# id 1
# Age 2
# Score 1Missing values की हैंडलिंग
Python में मिसिंग वैल्यूज़ को हैंडल करने के कई तरीके हैं।
-
dropna()से मिसिंग वैल्यूज़ वाली पूरी rows/columns हटाएँ। यह अनुशंसित नहीं, क्योंकि जानकारी खो सकती है। -
fillna()से constant, average, backward fill, या forward fill से भरें। -
replace()से मिसिंग वैल्यूज़ को किसी constant String, Integer, या Float से बदलें। -
Interpolation मेथड से वैल्यूज़ भरें।
नोट: dropna() का उपयोग करते समय सुनिश्चित करें कि डेटासेट बड़ा हो।
# drop missing values
df.dropna(axis = 0, how ='any')
#fillna
df.fillna(method ='bfill')
#replace null values with -999
df.replace(to_replace = np.nan, value = -999)
# Interpolate
df.interpolate(method ='linear', limit_direction ='forward')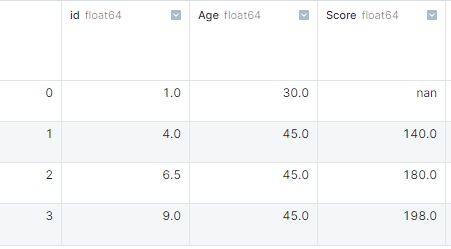
21. आपने विज़ुअलाइज़ेशन के लिए कौन-सी Python लाइब्रेरीज़ इस्तेमाल की हैं?
डेटा विज़ुअलाइज़ेशन डेटा विश्लेषण का सबसे महत्वपूर्ण भाग है। इससे आप अपने डेटा को क्रिया में देखते हैं और छिपे पैटर्न ढूँढते हैं।
लोकप्रिय Python डेटा विज़ुअलाइज़ेशन लाइब्रेरीज़:
- Matplotlib
- Seaborn
- Plotly
- Bokeh
Matplotlib और Seaborn सबसे आम हैं।
इंटरैक्टिव और जटिल एप्लिकेशंस के लिए Plotly उपयोग करते हैं, जिससे वेब ऐप या डैशबोर्ड बना सकते हैं।
Bokeh बड़े डेटासेट्स पर उच्च इंटरैक्टिविटी के साथ विस्तृत ग्राफिक्स के लिए उपयोग होता है।
22. आप किसी डेटासेट को normalize या standardize कैसे करेंगे?
Normalization डेटा को किसी विशिष्ट रेंज, आमतौर पर [0, 1], में स्केल करता है; standardization डेटा को mean 0 और standard deviation 1 में ट्रांसफॉर्म करता है। दोनों तकनीकें ML मॉडल्स के लिए डेटा तैयार करने में आवश्यक हैं।
from sklearn.preprocessing import MinMaxScaler, StandardScaler
import numpy as np
data = np.array([[1, 2], [3, 4], [5, 6]])
# Normalize
normalizer = MinMaxScaler()
normalized = normalizer.fit_transform(data)
print(normalized)
# Standardize
scaler = StandardScaler()
standardized = scaler.fit_transform(data)
print(standardized)Python कोडिंग इंटरव्यू प्रश्न
यदि आपका Python कोडिंग इंटरव्यू आने वाला है, तो इन जैसे प्रश्नों की तैयारी इंटरव्यूअर को प्रभावित कर सकती है।
23. आप Python में स्ट्रिंग के स्पेस को दिए गए कैरेक्टर से कैसे बदलेंगे?
यह सरल स्ट्रिंग मैनीपुलेशन चुनौती है। आपको स्पेस को किसी विशिष्ट कैरेक्टर से बदलना है।
-
उदाहरण 1: स्ट्रिंग
l vey uऔर कैरेक्टरoदिया गया, आउटपुटloveyouहोगा। -
उदाहरण 2: स्ट्रिंग
D t C mpBl ckFrid yS leऔर कैरेक्टरaदिया गया, आउटपुटDataCampBlackFridaySaleहोगा।
सबसे सरल तरीका बिल्ट-इन str.replace() मेथड का उपयोग है, जिससे स्पेसेज़ को सीधे दिए गए कैरेक्टर से बदला जा सकता है।
def str_replace(text, ch):
return text.replace(" ", ch)
text = "D t C mpBl ckFrid yS le"
ch = "a"
str_replace(text, ch)
# 'DataCampBlackFridaySale'
24. दिए गए पॉज़िटिव इंटीजर num के लिए एक फंक्शन लिखें जो बताए कि num परफेक्ट स्क्वायर है या नहीं (True/False)।
यह अपेक्षाकृत सीधा है। आप जाँच सकते हैं कि संख्या का परफेक्ट स्क्वायर रूट है या नहीं:
-
सटीक इंटीजर स्क्वायर रूट पाने के लिए
math.isqrt(num)का उपयोग करें। -
उसे स्क्वायर करके मूल संख्या से बराबरी जाँचें।
-
बूलियन रूप में परिणाम लौटाएँ।
टेस्ट 1
हमने valid_square() को 10 दिया:
- इंटीजर स्क्वायर रूट 3 है।
- 3 का स्क्वायर 9 है।
- 9 मूल संख्या के बराबर नहीं, इसलिए False।
टेस्ट 2
हमने valid_square() को 36 दिया:
- इंटीजर स्क्वायर रूट 6 है।
- 6 का स्क्वायर 36 है।
- 36 बराबर है, इसलिए True।
import math
def valid_square(num):
if num < 0:
return False
square = math.isqrt(num)
return square * square == num
valid_square(10)
# False
valid_square(36)
# True25. दिए गए n के लिए n! में trailing zeroes की संख्या लौटाएँ
इस चुनौती में पहले n फैक्टोरियल (n!) निकालना और फिर trailing zeros गिनना है।
फैक्टोरियल निकालना
पहले चरण में while लूप से n को 1 तक घटाते हुए फैक्टोरियल निकालेंगे।
Trailing zeros गिनना
दूसरे चरण में कुल zeros नहीं, बल्कि trailing zeros गिनेंगे—फर्क बड़ा है।
7! = 50407! में कुल दो zeros हैं पर trailing zeros एक है, तो परिणाम 1 होना चाहिए।
- फैक्टोरियल को स्ट्रिंग में बदलें।
- पीछे से पढ़ें और लूप चलाएँ।
- यदि अंक 0 है, तो result में +1; वरना लूप ब्रेक।
- परिणाम लौटाएँ।
समाधान सुसंगत है, पर बारीकी ज़रूरी है।
def factorial_trailing_zeros(n):
fact = n
while n > 1:
fact *= n - 1
n -= 1
result = 0
for i in str(fact)[::-1]:
if i == "0":
result += 1
else:
break
return result
factorial_trailing_zeros(10) # 2
factorial_trailing_zeros(18) # 3अपने अगले Python कोडिंग इंटरव्यू की तैयारी के लिए यह आवश्यक प्रैक्टिसिंग कोडिंग इंटरव्यू क्वेश्चंस कोर्स लें।
26. क्या स्ट्रिंग को dictionary शब्दों में बाँटा जा सकता है?
आपको एक बड़ी स्ट्रिंग और शब्दों की dictionary दी गई है। जाँचें कि इन शब्दों का उपयोग करके स्ट्रिंग को सेगमेंट किया जा सकता है या नहीं।
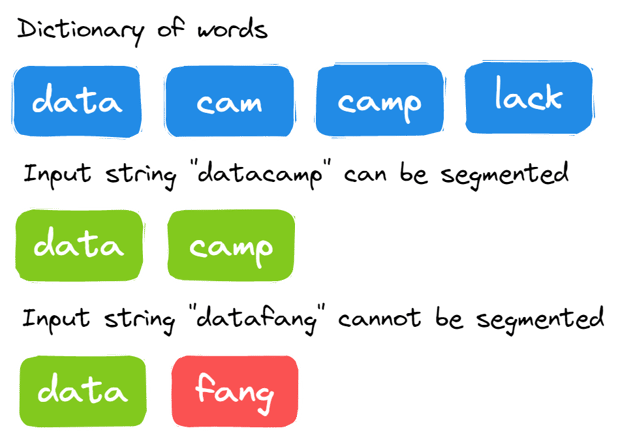
समाधान काफी सीधा है। हर बिंदु पर स्ट्रिंग को बाँटकर देखें कि क्या dictionary के शब्दों में सेगमेंट किया जा सकता है।
-
बड़ी स्ट्रिंग की लंबाई तक लूप चलाएँ।
-
दो सबस्ट्रिंग बनाएँ।
-
पहली सबस्ट्रिंग
s[0:i]होगी। -
यदि पहली सबस्ट्रिंग dictionary में नहीं, तो False लौटाएँ।
-
यदि पहली सबस्ट्रिंग dictionary में है, तो
s[i:]से दूसरी सबस्ट्रिंग बनाएँ। -
यदि दूसरी सबस्ट्रिंग dictionary में है या दूसरी सबस्ट्रिंग की लंबाई शून्य है, तो True लौटाएँ। अन्यथा
can_segment_str()को दूसरी सबस्ट्रिंग के साथ रिकर्सिवली कॉल करें और यदि वह सेगमेंट हो सके तो True लौटाएँ। -
लंबी स्ट्रिंग्स के लिए समाधान कुशल बनाने हेतु memoization जोड़ें ताकि सबस्ट्रिंग्स बार-बार न गणना हों।
def can_segment_str(s, dictionary, memo=None):
if memo is None:
memo = {}
if s in memo:
return memo[s]
if not s:
return True
for i in range(1, len(s) + 1):
first_str = s[0:i]
if first_str in dictionary:
second_str = s[i:]
if (
not second_str
or second_str in dictionary
or can_segment_str(second_str, dictionary, memo)
):
memo[s] = True
return True
memo[s] = False
return False
s = "datacamp"
dictionary = ["data", "camp", "cam", "lack"]
can_segment_str(s, dictionary)
# True27. क्या आप sorted array से duplicates हटा सकते हैं?
इनक्रीसिंग ऑर्डर में सॉर्टेड इंटीजर ऐरे दिया है। डुप्लीकेट्स हटाएँ ताकि हर यूनिक एलिमेंट केवल एक बार आए। Python लिस्ट की लंबाई इन-प्लेस नहीं बदलते, इसलिए परिणामों को उसी ऐरे के पहले k स्थानों में रखें और k (नई लंबाई) लौटाएँ। कॉल के बाद केवल पहले k तत्व वैध हैं; k के बाद वाले स्टेल हैं।
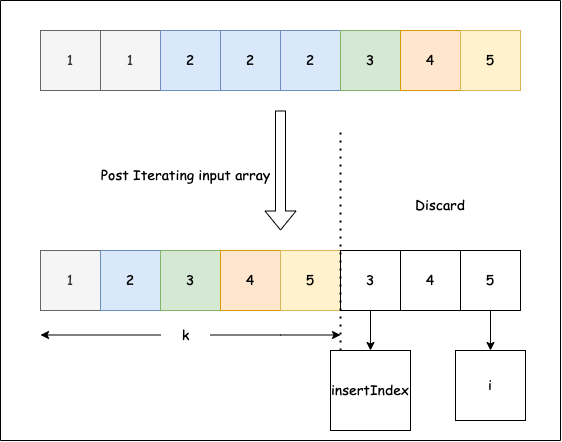
छवि: LeetCode
उदाहरण 1: इनपुट [1,1,2,2], फंक्शन 2 लौटाए।
उदाहरण 2: इनपुट [1,1,2,3,3], फंक्शन 3 लौटाए।
समाधान:
-
इंडेक्स 1 से अंत तक लूप चलाएँ। करंट एलिमेंट को पिछले यूनिक एलिमेंट से तुलना करें; अलग होने पर उसे
insertIndexपर लिखें औरinsertIndexबढ़ाएँ। -
अंत में
insertIndexलौटाएँ—यही k है।
वक्तव्य समझने पर यह प्रश्न सरल हो जाता है।
def removeDuplicates(array):
size = len(array)
if size == 0:
return 0
insertIndex = 1
for i in range(1, size):
if array[i - 1] != array[i]:
array[insertIndex] = array[i]
insertIndex += 1
return insertIndex
array_1 = [1, 2, 2, 3, 3, 4]
k1 = removeDuplicates(array_1)
# 4; array_1[:k1] -> [1, 2, 3, 4]
array_2 = [1, 1, 3, 4, 5, 6, 6]
k2 = removeDuplicates(array_2)
# 5; array_2[:k2] -> [1, 3, 4, 5, 6]
28. क्या आप ऐरे में missing number ढूँढ सकते हैं?
आपको 1 से n तक के पॉज़िटिव इंटीजर की लिस्ट दी है। 1 से n तक सभी नंबर मौजूद हैं सिवाय x के; x ढूँढना है।
उदाहरण:
|
4 |
5 |
3 |
2 |
8 |
1 |
6 |
- n = 8
- missing number = 7
यह एक सरल गणितीय समस्या है।
- लिस्ट के सभी तत्वों का योग निकालें।
- अंकगणितीय श्रेणी के सूत्र से पहले n संख्याओं का अपेक्षित योग निकालें।
- अपेक्षित योग और वास्तविक योग का अंतर लौटाएँ।
def find_missing(input_list):
sum_of_elements = sum(input_list)
# There is exactly 1 number missing
n = len(input_list) + 1
actual_sum = (n * ( n + 1 ) ) / 2
return int(actual_sum - sum_of_elements)
list_1 = [1,5,6,3,4]
find_missing(list_1) # 229. एक Python फंक्शन लिखिए जो बताए कि दी गई स्ट्रिंग palindrome है या नहीं।
यदि कोई स्ट्रिंग आगे और पीछे से एक-सी पढ़ी जाए तो वह palindrome है।
उदाहरण:
def is_palindrome(s):
s = ''.join(e for e in s if e.isalnum()).lower() # Remove non-alphanumeric and convert to lowercase
return s == s[::-1]
print(is_palindrome("A man, a plan, a canal: Panama")) # Output: True
print(is_palindrome("hello")) # Output: FalseFacebook, Amazon, Apple, Netflix, और Google के लिए Python इंटरव्यू प्रश्न
नीचे, हमने उन प्रश्नों का चयन किया है जो Meta, Amazon, Google जैसी कंपनियों में प्रचलित भूमिकाओं के लिए आपसे पूछे जा सकते हैं।
30. क्या आप अधिकतम सिंगल सेल प्रॉफिट निकाल सकते हैं?
स्टॉक प्राइसेज़ की लिस्ट दी गई है; आपको बाय और सेल प्राइस लौटाने हैं ताकि अधिकतम प्रॉफिट बने।
नोट: केवल एक बार खरीद/बिक्री से अधिकतम प्रॉफिट बनाना है; यदि प्रॉफिट संभव नहीं, तो लॉस को कम करना है।
उदाहरण 1: stock_price = [8, 4, 12, 9, 20, 1], buy = 4, sell = 20. अधिकतम प्रॉफिट।
उदाहरण 2: stock_price = [8, 6, 5, 4, 3, 2, 1], buy = 6, sell = 5. लॉस न्यूनतम।
समाधान:
- ग्लोबल प्रॉफिट = दूसरी वैल्यू (sell) - पहली वैल्यू (buy)।
- इंडेक्स 1 से लिस्ट के अंत तक लूप।
- लूप में करंट प्रॉफिट = करंट प्राइस - करंट बाय।
- यदि करंट प्रॉफिट > ग्लोबल प्रॉफिट, तो ग्लोबल प्रॉफिट/ग्लोबल सेल अपडेट करें।
- यदि करंट बाय > करंट प्राइस, तो करंट बाय अपडेट करें।
- अंत में ग्लोबल बाय और सेल लौटाएँ। ग्लोबल बाय = ग्लोबल सेल - ग्लोबल प्रॉफिट।
यह प्रश्न थोड़ा पेचीदा है; आप अपनी अनूठी एल्गोरिदम से भी सुलझा सकते हैं।
def buy_sell_stock_prices(stock_prices):
current_buy = stock_prices[0]
global_sell = stock_prices[1]
global_profit = global_sell - current_buy
for i in range(1, len(stock_prices)):
current_profit = stock_prices[i] - current_buy
if current_profit > global_profit:
global_profit = current_profit
global_sell = stock_prices[i]
if current_buy > stock_prices[i]:
current_buy = stock_prices[i]
return global_sell - global_profit, global_sell
stock_prices_1 = [10,9,16,17,19,23]
buy_sell_stock_prices(stock_prices_1)
# (9, 23)
stock_prices_2 = [8, 6, 5, 4, 3, 2, 1]
buy_sell_stock_prices(stock_prices_2)
# (6, 5)अन्य इंटरव्यू प्रश्नों में शामिल हो सकते हैं:
31. क्या आप किसी ऐरे में पायथागोरस ट्रिपलेट ढूँढ सकते हैं?
ऐसा फंक्शन लिखें जो a2+ b2 = c2 संतुष्ट करने वाला ट्रिपलेट हो तो True लौटाए।
उदाहरण:
|
इनपुट |
आउटपुट |
|
[3, 1, 4, 6, 5] |
True |
|
[10, 4, 6, 12, 5] |
False |
समाधान:
-
ऐरे के सभी तत्वों का वर्ग लें।
-
ऐरे को इनक्रीसिंग ऑर्डर में सॉर्ट करें।
-
दो लूप चलाएँ: बाहरी लूप आखिरी इंडेक्स से 1 तक; अंदरूनी लूप (
outer_loop_index - 1) से शुरुआत तक। -
बाहरी और अंदरूनी इंडेक्स के बीच के तत्वों के लिए
set()बनाएँ। -
जाँचें कि सेट में कोई संख्या
(array[outerLoopIndex] – array[innerLoopIndex])के बराबर है या नहीं। है तोTrue, अन्यथाFalse।
def checkTriplet(array):
n = len(array)
for i in range(n):
array[i] = array[i]**2
array.sort()
for i in range(n - 1, 1, -1):
s = set()
for j in range(i - 1, -1, -1):
if (array[i] - array[j]) in s:
return True
s.add(array[j])
return False
arr = [3, 2, 4, 6, 5]
checkTriplet(arr)
# True32. दिए गए कॉइन और टोटल अमाउंट से कितने तरीकों से चेंज बना सकते हैं?
हमें एक फंक्शन बनाना है जो कॉइन डिनॉमिनेशंस और टोटल अमाउंट लेकर चेंज बनाने के तरीकों की संख्या लौटाए।
उदाहरण में डिनॉमिनेशंस [1, 2, 5] और टोटल 5 है। लौटे परिणाम में चार तरीके मिलते हैं।
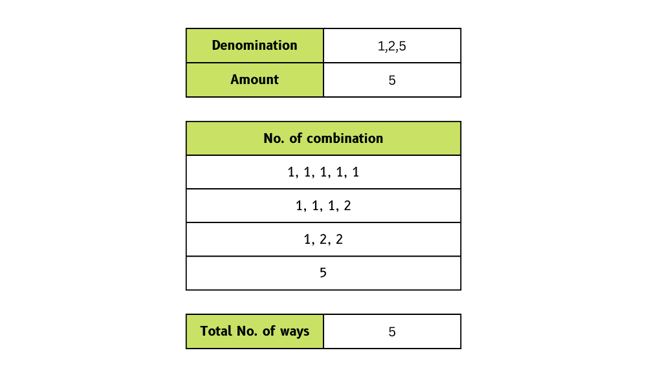
समाधान:
-
आकार
amount + 1की लिस्ट बनाएँ। zero अमाउंट के लिए अतिरिक्त स्पेस। -
सोल्यूशन लिस्ट इनिशियलाइज़ करें:
solution[0] = 1। -
दो लूप चलाएँ: बाहरी लूप डिनॉमिनेशंस पर; अंदरूनी लूप करंट डिनॉमिनेशन से
amount + 1तक। -
विभिन्न डिनॉमिनेशंस के परिणाम solution में स्टोर होंगे:
solution[i] = solution[i] + solution[i - den]।
प्रक्रिया सभी डिनॉमिनेशंस पर दोहराएँ; सोल्यूशन लिस्ट के अंतिम एलिमेंट पर उत्तर होगा।
def solve_coin_change(denominations, amount):
solution = [0] * (amount + 1)
solution[0] = 1
for den in denominations:
for i in range(den, amount + 1):
solution[i] += solution[i - den]
return solution[amount]
denominations = [1, 2, 5]
amount = 5
solve_coin_change(denominations, amount)
# 4Google Python इंटरव्यू प्रश्न
अन्य कंपनियों की तरह, Google में भी प्रश्न भूमिका और अनुभव पर निर्भर करते हैं। सामान्य प्रश्न:
33. Python में lambda function, iterator, और generator परिभाषित कीजिए।
Lambda function को anonymous function भी कहते हैं। इसमें पैरामीटर्स कितने भी हो सकते हैं, पर एक ही स्टेटमेंट होता है।
Iterator एक ऐसा ऑब्जेक्ट है जिससे हम lists, dictionaries, tuples, sets जैसे iterable पर iterate कर सकते हैं।
Generator सामान्य फंक्शन जैसा होता है, पर return की जगह yield से वैल्यू जेनरेट करता है। बॉडी में yield होने पर फंक्शन अपने-आप जेनरेटर बन जाता है।
और पढ़ें: Python iterators और generators।
34. दिए गए ऐरे arr[] के लिए अधिकतम j – i ढूँढें ताकि arr[j] > arr[i]
यह सीधा है, पर सावधानी चाहिए। पॉज़िटिव इंटीजर का ऐरे दिया है; अधिकतम अंतर j - i ढूँढना है जहाँ array[j] > array[i]।
उदाहरण:
- इनपुट: [20, 70, 40, 50, 12, 38, 98], आउटपुट: 6 (j = 6, i = 0)
- इनपुट: [10, 3, 2, 4, 5, 6, 7, 8, 18, 0], आउटपुट: 8 ( j = 8, i = 0)
समाधान:
- ऐरे की लंबाई निकालकर max difference = -1 से शुरू करें।
- दो लूप चलाएँ: बाहरी लूप लेफ्ट से एलिमेंट चुनता है; अंदरूनी लूप राइट से तुलना करता है।
- जब भी राइट एलिमेंट > चुना हुआ लेफ्ट एलिमेंट, j - i से max difference अपडेट करें।
def max_index_diff(array):
n = len(array)
max_diff = -1
for i in range(0, n):
j = n - 1
while(j > i):
if array[j] > array[i] and max_diff < (j - i):
max_diff = j - i
j -= 1
return max_diff
array_1 = [20,70,40,50,12,38,98]
max_index_diff(array_1)
# 635. Python में ternary operators का उपयोग कैसे करेंगे?
Ternary operators को conditional expressions भी कहते हैं। ये शर्तों के True/False होने पर expressions का मान निकालते हैं।
एक पंक्ति में if-else की तर्ज़ पर लिख सकते हैं, जिससे कोड साफ और कॉम्पैक्ट होता है।
उदाहरण, nested if-else को एक पंक्ति में:
If-else स्टेटमेंट
score = 75
if score < 70:
if score < 50:
print('Fail')
else:
print('Merit')
else:
print('Distinction')
# DistinctionNested Ternary Operator
print('Fail' if score < 50 else 'Merit' if score < 70 else 'Distinction')
# Distinction36. आप Python में LRU Cache कैसे इम्प्लीमेंट करेंगे?
Python में functools.lru_cache डेकोरेटर से LRU (Least Recently Used) cache सीधे इम्प्लीमेंट कर सकते हैं। वैकल्पिक रूप से collections के OrderedDict से मैन्युअल इम्प्लीमेंटेशन किया जा सकता है।
functools का उदाहरण:
from functools import lru_cache
@lru_cache(maxsize=3)
def add(a, b):
return a + b
print(add(1, 2)) # Calculates and caches result
print(add(1, 2)) # Retrieves result from cachePython AI और मशीन लर्निंग इंटरव्यू प्रश्न
AI और बड़े भाषा मॉडल्स (LLMs) की तेज़ वृद्धि के साथ, Python इंटरव्यू में आधुनिक AI/ML कॉन्सेप्ट्स के प्रश्न बढ़ रहे हैं। 2026 के लिए ये प्रमुख प्रश्न तैयार रखें।
37. Large Language Model (LLM) क्या है, और Python में इसका उपयोग कैसे करेंगे?
LLM एक डीप लर्निंग मॉडल है जो विशाल टेक्स्ट डेटासेट्स पर ट्रेन होता है ताकि मानव-समान टेक्स्ट समझ/जनरेट कर सके। लोकप्रिय LLMs: GPT-5, Claude, Llama, Gemini। Python में आप APIs के ज़रिए इंटरैक्ट कर सकते हैं या लोकली चला सकते हैं।
OpenAI की API का उदाहरण:
from openai import OpenAI
client = OpenAI(api_key="your-api-key")
response = client.chat.completions.create(
model="gpt-4",
messages=[
{"role": "system", "content": "You are a helpful assistant."},
{"role": "user", "content": "Explain Python decorators in simple terms."}
]
)
print(response.choices[0].message.content)और जानें: LangChain के साथ LLM एप्लिकेशन कैसे बनाएं।
38. RAG (Retrieval-Augmented Generation) क्या है, और यह क्यों महत्वपूर्ण है?
RAG, रिट्रीवल सिस्टम्स को जनरेटिव AI के साथ जोड़कर अधिक सटीक और ग्राउंडेड उत्तर देता है। LLM के ट्रेनिंग डेटा पर ही निर्भर रहने के बजाय, यह नॉलेज बेस से प्रासंगिक दस्तावेज़ लाकर उन्हें संदर्भ के रूप में उपयोग करता है।
RAG सिस्टम के मुख्य घटक:
- Document Store: एम्बेडेड दस्तावेज़ रखने वाला वेक्टर डेटाबेस (जैसे Pinecone, Chroma, FAISS)
- Retriever: क्वेरी समानता के आधार पर प्रासंगिक दस्तावेज़ ढूँढता है
- Generator: LLM जो रिट्रीव्ड संदर्भ का उपयोग कर उत्तर बनाता है
उदाहरण RAG वर्कफ्लो:
from langchain.vectorstores import Chroma
from langchain.embeddings import OpenAIEmbeddings
from langchain.chat_models import ChatOpenAI
from langchain.chains import RetrievalQA
# Create vector store from documents
embeddings = OpenAIEmbeddings()
vectorstore = Chroma.from_documents(documents, embeddings)
# Create RAG chain
llm = ChatOpenAI(model="gpt-4")
qa_chain = RetrievalQA.from_chain_type(
llm=llm,
retriever=vectorstore.as_retriever()
)
# Query the system
result = qa_chain.invoke("What are Python best practices?")
print(result)उन्नत तकनीकों के लिए पढ़ें: RAG परफॉर्मेंस कैसे सुधारें।
39. AI एप्लिकेशंस के लिए Python में async/await कैसे हैंडल करेंगे?
ऐसी AI एप्लिकेशंस में जहाँ कई API कॉल्स या concurrent रिक्वेस्ट्स हैं, asynchronous प्रोग्रामिंग आवश्यक है। Python का asyncio मॉड्यूल non-blocking I/O सक्षम करता है।
उदाहरण: समांतर LLM API कॉल्स
import asyncio
from openai import AsyncOpenAI
client = AsyncOpenAI()
async def get_completion(prompt: str) -> str:
response = await client.chat.completions.create(
model="gpt-4",
messages=[{"role": "user", "content": prompt}]
)
return response.choices[0].message.content
async def process_multiple_prompts(prompts: list[str]) -> list[str]:
tasks = [get_completion(prompt) for prompt in prompts]
return await asyncio.gather(*tasks)
# Run concurrent requests
prompts = ["Explain Python lists", "Explain Python dicts", "Explain Python sets"]
results = asyncio.run(process_multiple_prompts(prompts))
for result in results:
print(result)और गहराई में जानें: Python Async Programming गाइड।
40. Embeddings क्या हैं, और मशीन लर्निंग में इनका उपयोग कैसे होता है?
Embeddings डेटा (टेक्स्ट, इमेज, आदि) के dense वेक्टर रिप्रेज़ेंटेशंस हैं जो सैमांटिक अर्थ कैप्चर करते हैं। समान आइटम्स के embeddings समान होते हैं, जिससे semantic search, क्लस्टरिंग, और रिकमेंडेशन जैसे कार्य संभव होते हैं।
उदाहरण: टेक्स्ट embeddings बनाना
from sentence_transformers import SentenceTransformer
import numpy as np
# Load embedding model
model = SentenceTransformer('all-MiniLM-L6-v2')
# Create embeddings
sentences = [
"Python is a programming language",
"JavaScript is used for web development",
"Python is great for data science"
]
embeddings = model.encode(sentences)
# Calculate similarity
def cosine_similarity(a, b):
return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))
# Python sentences are more similar to each other
print(f"Similarity 0-2: {cosine_similarity(embeddings[0], embeddings[2]):.3f}") # Higher
print(f"Similarity 0-1: {cosine_similarity(embeddings[0], embeddings[1]):.3f}") # Lower41. आप Python में एक AI एजेंट कैसे बनाएँगे?
AI एजेंट ऐसे स्वायत्त सिस्टम हैं जो अपने परिवेश को समझते, निर्णय लेते, और लक्ष्यों के लिए कार्रवाई करते हैं। आधुनिक एजेंट LLMs को टूल्स और मेमोरी के साथ जोड़ते हैं।
AI एजेंट के मुख्य घटक:
- LLM Core: इनपुट प्रोसेस कर निर्णय लेने वाला इंजन
- Tools: एजेंट द्वारा कॉल किए जा सकने वाले फंक्शंस (वेब सर्च, कोड एक्ज़ीक्यूशन, APIs)
- Memory: शॉर्ट-टर्म (कन्वर्सेशन) और लॉन्ग-टर्म (वेक्टर स्टोर)
- Planning: जटिल कार्यों को उप-कार्यों में बाँटना
LangChain का उपयोग करते हुए उदाहरण:
from langchain.agents import create_openai_functions_agent, AgentExecutor
from langchain.chat_models import ChatOpenAI
from langchain.tools import Tool
from langchain import hub
# Define tools
def search_database(query: str) -> str:
return f"Results for: {query}"
tools = [
Tool(
name="DatabaseSearch",
func=search_database,
description="Search the company database for information"
)
]
# Create agent
llm = ChatOpenAI(model="gpt-4")
prompt = hub.pull("hwchase17/openai-functions-agent")
agent = create_openai_functions_agent(llm, tools, prompt)
agent_executor = AgentExecutor(agent=agent, tools=tools)
# Run agent
result = agent_executor.invoke({"input": "Find sales data for Q4"})
print(result["output"])और जानें: LangChain एजेंट्स बनाना।
Python के साथ अपनी टीम को अपस्किल करना
जहाँ नौकरी चाहने वालों और हायरिंग मैनेजर्स के लिए Python इंटरव्यू तैयारी आवश्यक है, वहीं व्यवसायों के लिए भी अपनी टीम के सतत Python प्रशिक्षण में निवेश करना उतना ही महत्वपूर्ण है। ऐसे दौर में जहाँ ऑटोमेशन, डेटा विश्लेषण, और सॉफ्टवेयर विकास अहम हैं, आपकी टीम के मजबूत Python कौशल आपकी कंपनी की सफलता के लिए निर्णायक हो सकते हैं।
यदि आप टीम लीडर या बिज़नेस ओनर हैं और पूरी टीम को Python में दक्ष बनाना चाहते हैं, तो DataCamp for Business आपके कर्मचारियों को बेसिक्स से लेकर उन्नत कॉन्सेप्ट्स तक Python कौशल में महारत दिलाने के लिए टेलर्ड ट्रेनिंग प्रोग्राम्स प्रदान करता है। हम दे सकते हैं:
- टार्गेटेड लर्निंग पाथ्स: आपकी टीम के मौजूदा कौशल स्तर और बिज़नेस आवश्यकताओं के अनुरूप।
- हैंड्स-ऑन प्रैक्टिस: वास्तविक प्रोजेक्ट्स और कोडिंग एक्सरसाइज़, जो सीखने को सुदृढ़ करें।
- प्रोग्रेस ट्रैकिंग: टूल्स जो आपकी टीम की प्रगति मॉनिटर/आंकें, ताकि वे अपने लक्ष्यों तक पहुँचें।
DataCamp जैसे प्लेटफॉर्म्स के साथ Python अपस्किलिंग में निवेश, आपकी टीम की क्षमताओं को बढ़ाने के साथ आपके व्यवसाय को रणनीतिक बढ़त देता है—नवाचार, प्रतिस्पर्धात्मकता, और प्रभावी परिणामों के लिए। हमारी टीम से जुड़ें और आज ही डेमो रिक्वेस्ट करें।
अंतिम विचार
Python इंटरव्यू प्रश्नों में महारत, तकनीकी इंटरव्यू में उत्कृष्टता पाने के लिए महत्वपूर्ण है—चाहे आप उदीयमान डेटा प्रोफेशनल हों, डेवलपर हों, या सॉफ्टवेयर इंजीनियर। इस गाइड ने बेसिक से एडवांस्ड स्तर तक के सामान्य Python प्रश्नों, कोडिंग चुनौतियों, और शीर्ष टेक कंपनियों के विशिष्ट प्रश्नों का अवलोकन दिया है।
इन प्रश्नों का अभ्यास कर और उनके समाधानों को समझकर, आप अपनी समस्या-समाधान क्षमता और तकनीकी ज्ञान में उल्लेखनीय बढ़त ला सकते हैं, जिससे आप इंटरव्यू के तकनीकी और कोडिंग चरणों को सफलतापूर्वक पार कर सकें।
शीर्ष Python सर्टिफिकेशंस हासिल करना और कोर्स व प्रोजेक्ट्स के माध्यम से सतत सीखना आपके विशेषज्ञता और करियर संभावनाओं को और मजबूत करेगा। यदि आपको अपने कौशल ताज़ा करने हैं, तो हमारा Associate Data Scientist in Python करियर ट्रैक ज़रूर पूरा करें।
AI और मशीन लर्निंग भूमिकाओं की तैयारी करने वालों के लिए, हमारा Python Machine Learning ट्यूटोरियल scikit-learn और अन्य आवश्यक लाइब्रेरीज़ के साथ हैंड्स-ऑन प्रैक्टिस देता है।
Python इंटरव्यू FAQs
मैं Python इंटरव्यू की तैयारी कैसे करूँ?
आपको Python सिंटैक्स, फंक्शंस, क्लासेस, डेटा टाइप्स, एल्गोरिदम, डेटा स्ट्रक्चर्स, और एक्सेप्शन हैंडलिंग दोहराने की ज़रूरत है। साथ ही, तकनीकी ट्यूटोरियल्स पढ़ें, उदाहरण प्रोजेक्ट्स, चीट शीट्स, और मॉक प्रश्नों की समीक्षा करें, और कोडिंग चुनौतियाँ हल करें ताकि इंटरव्यू स्टेज पास कर सकें।
जनरल Python प्रश्नों (नेटिव फंक्शनैलिटी), जॉब-विशिष्ट प्रश्नों (डेटा इंजीनियर, डेटा साइंटिस्ट, बैकएंड डेवलपर), और टाइम्ड कोड-बेस्ड प्रश्नों की तैयारी करें। आप मशीन लर्निंग Python प्रश्न और स्टैटिस्टिक्स Python इंटरव्यू प्रश्न DataCamp पर अभ्यास कर सकते हैं।
Python कोडिंग इंटरव्यू में अलग कैसे दिखें?
आपको साफ, प्रोडक्शन-रेडी कोड लिखने की क्षमता दिखानी होगी, जॉब-विशिष्ट Python लाइब्रेरीज़, टूल्स, और एल्गोरिदम समझने होंगे, और जटिल समस्याओं के लिए अनूठे समाधान लाने होंगे। यह सब आप कोडिंग चुनौतियों का अभ्यास या ओपन-सोर्स प्रोजेक्ट पर काम करके कर सकते हैं।
आप GitHub और पर्सनल वेबसाइट्स पर Python-आधारित प्रोजेक्ट्स का पोर्टफोलियो बनाकर भी अलग दिख सकते हैं।
Python में Lambda क्या है?
Python के पाँच मुख्य उपयोग क्या हैं?
- वेबसाइट्स और सॉफ्टवेयर विकसित करना
- स्क्रिप्टिंग और यूटिलिटी सॉफ्टवेयर
- डेस्कटॉप एप्लिकेशंस
- डेटा विश्लेषण
- मशीन लर्निंग
क्या map, for loop से तेज़ है?
यदि आप किसी iterable के हर आइटम पर एक फंक्शन लगा रहे हैं तो “map” “for loop” से तेज़ होता है।
क्या Python इंटरव्यू की तैयारी के लिए मुफ्त संसाधन उपलब्ध हैं?
हाँ! यदि आप यूनिवर्सिटी टीचर या स्टूडेंट हैं, तो आप DataCamp Classrooms का उपयोग कर हमारा पूरा कोर्स कैटलॉग मुफ्त में प्राप्त कर सकते हैं।
2026 के AI/ML इंटरव्यू के लिए मुझे Python में किन विषयों पर ध्यान देना चाहिए?
2026 के AI/ML इंटरव्यू के लिए ध्यान दें: LLM कॉन्सेप्ट्स (ट्रांसफॉर्मर्स, अटेंशन मेकैनिज़्म, फाइन-ट्यूनिंग बनाम प्रॉम्प्टिंग), RAG सिस्टम्स, वेक्टर डेटाबेस और embeddings, API कॉल्स के लिए Python async प्रोग्रामिंग, और LangChain, Hugging Face, PyTorch जैसे फ्रेमवर्क्स। साथ ही प्रॉम्प्ट इंजीनियरिंग तकनीकें और ML मॉडल इवैल्यूएशन समझें।
Python अपनी बहुमुखी प्रतिभा और मांग के कारण टेक उद्योग में लगातार हावी है। चाहे आप तकनीकी इंटरव्यू की तैयारी कर रहे हों या अपने कोडिंग कौशल को निखारना चाह रहे हों, Python में महारत ज़रूरी है। इंटरव्यू में अक्सर Python में चुनौतियाँ हल करना और जटिल फंक्शनैलिटीज़ समझाना शामिल होता है।
यह गाइड सबसे आम और उन्नत Python इंटरव्यू प्रश्नों की एक व्यापक सूची प्रदान करता है। इन प्रश्नों का अभ्यास करने से डेटा प्रोफेशनल्स, डेवलपर्स, और सॉफ्टवेयर इंजीनियर्स को तकनीकी इंटरव्यू में उत्कृष्ट प्रदर्शन करने और अपने करियर को आगे बढ़ाने में मदद मिलेगी।
TL;DR
__init__(), और GIL