# Define the decision tree as a dictionary
tree ={'A':['B','C'],# Node A connects to B and C'B':['D','E'],# Node B connects to D and E'C':['F','G'],# Node C connects to F and G'D':['H','I'],# Node D connects to H and I'E':['J','K'],# Node E connects to J and K'F':['L','M'],# Node F connects to L and M'G':['N','O'],# Node G connects to N and O'H':[],'I':[],'J':[],'K':[],# Leaf nodes have no children'L':[],'M':[],'N':[],'O':[]# Leaf nodes have no children}技术支持
from collections import deque # Import deque for efficient queue operations# Define the BFS functiondefbfs(tree, start):
visited =[]# List to keep track of visited nodes
queue = deque([start])# Initialize the queue with the starting nodewhile queue:# While there are still nodes to process
node = queue.popleft()# Dequeue a node from the front of the queueif node notin visited:# Check if the node has been visited
visited.append(node)# Mark the node as visitedprint(node, end=" ")# Output the visited node# Enqueue all unvisited neighbors (children) of the current nodefor neighbor in tree[node]:if neighbor notin visited:
queue.append(neighbor)# Add unvisited neighbors to the queue技术支持
创建好 BFS 函数后,我们可以从根节点 A 开始,在这棵树上运行它。
# Execute BFS starting from node 'A'
bfs(tree,'A')技术支持



想象一下,您正试图绘制穿越迷宫的最快路线、识别人际社交网络中的连接,或寻找跨越互联网传输数据的最高效方式。这些挑战有一个共同目标:系统地探索不同点之间的关系。广度优先搜索正是能够帮助您实现这一点的算法。
广度优先搜索被应用于数据科学中的各类问题,从图遍历到路径寻址。它对在无权图中寻找最短路径尤为有用。继续阅读,我将详细讲解广度优先搜索,并展示一个 Python 实现。如果在开始时您希望获得更多 Python 帮助,欢迎报名我们的极其全面的Python 入门课程。
什么是广度优先搜索?
广度优先搜索(BFS)是一种按层次逐级探索图或树的遍历算法。从指定的源节点开始,BFS 会先访问其所有直接相邻的节点,然后再进入下一层节点。这样可确保同一深度的节点在更深层之前被处理。正因如此,BFS 适用于需要以结构化、系统化方式检查所有可能路径的问题。
BFS 有助于在节点之间找到最短路径,因为 BFS 第一次到达某节点时,所用的便是最短路线。这使得 BFS 在诸如网络路由之类的场景中非常实用,其目标是在两点之间找到最高效的路径。下图展示了 BFS 如何探索一棵树的简化示意。
广度优先搜索算法的关键特性
广度优先搜索旨在通过先访问某节点的所有邻居,再推进到下一层,来探索图或树。这种结构化的遍历确保在深入之前,先探索特定深度的所有节点。按层推进的方法让 BFS 成为在复杂网络中导航的一种系统且可靠的方式。
遍历方式
BFS 会先遍历当前深度层的每个节点,然后再进入下一层。这意味着,在更深入之前,会处理与起点距离相同的所有节点。
基于队列的实现
BFS 使用队列来管理待访问的节点。算法处理一个节点、将其未访问的邻居加入队列,并持续重复这一模式。队列遵循先进先出原则,确保节点按发现顺序被探索。
无权图中保证最短路径
在无权图(或每条边长度相同的图)中,BFS 能保证找到节点间的最短路径。由于 BFS 按层次探索邻居,它第一次到达某节点时,使用的就是可能的最短路线。因此,在所有边权相等的情况下,BFS 对最短路径问题尤其有效。
适用于图与树
BFS 既适用于图,也适用于树。图是由相连节点构成的网络,可能包含环,例如社交网络;而树是具有唯一根节点且无环的层级结构,例如族谱。BFS 对二者都很有用,因此可广泛应用于多种任务。
在 Python 中实现广度优先搜索
让我们在 Python 中演示在一棵树上运行广度优先搜索算法。如果您需要回顾 Python 技能,请查看 DataCamp 的Python 编程技能路径。如需了解不同数据结构与算法的更多信息,请参加我们的Python 数据结构与算法课程,并阅读我们的数据结构:含 Python 示例的全面指南教程。
让我们开始吧。首先,我们需要为 BFS 设置一棵简单的决策树以供搜索。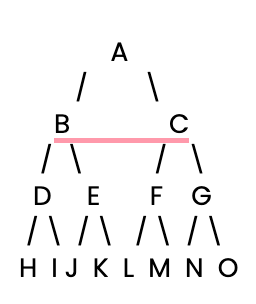
接下来,我们将使用一个 Python 字典来定义这棵简单的决策树,其中每个键是一个节点,其值是该节点子节点的列表。
现在让我们在 Python 中实现 BFS 算法。BFS 的工作方式是先访问当前层的所有节点,再移动到下一层。我们将使用队列来管理下一步要访问的节点。
创建好 BFS 函数后,我们可以从根节点 A 开始,在这棵树上运行它。
运行后,它会按访问顺序输出每个节点。
树与图上的 BFS 差异
树本身无环,BFS 的遍历模式相对直观。算法从根开始,先访问所有子节点,再进入下一层。这种按层遍历与树的层级关系相呼应:每个节点只有一个父节点和多个子节点,因而模式可预期。
相较之下,图可能包含环。节点之间的多条路径可能回到已访问的节点。这会给 BFS 带来麻烦,需要谨慎管理重复访问。记录哪些节点已访问可防止不必要的重复处理,并避免导致循环的环。在前面的 BFS 实现中,我们使用了一个 visited 列表来确保每个节点只被处理一次。若遇到已访问节点就跳过,使 BFS 能够顺畅继续。
时间与空间复杂度
广度优先搜索的效率如何?我们可以使用大 O 表示法来评估 BFS 的效率如何随图规模变化。
时间复杂度
BFS 的时间复杂度为 O(V+E),其中 V 为顶点(节点)数量,E 为图中的边数量。这意味着 BFS 的性能取决于节点数及其之间的连接数。
空间复杂度
BFS 的空间复杂度为 O(V),源于队列中存储节点所需的内存。在较“宽”的图上,可能需要同时存储大量节点。在最坏情况下,甚至可能需要同时持有所有节点。
广度优先搜索的实际应用
广度优先搜索在计算机科学、网络与人工智能等领域具有众多实用场景。其按层、有条不紊的探索方式,使其非常适合搜索与路径寻找问题。
使用场景
BFS 的一个应用是网络路由算法。当数据包在网络中传输时,路由器使用 BFS 来寻找最短路径。通过在深入之前先探索所有相邻节点,BFS 能快速识别高效路线,降低延迟并提升性能。
BFS 也适用于解谜,如迷宫或滑块拼图。每个位置是一个节点,连接即是边。BFS 能高效地从起点找到到出口的最短路径。
另一个重要用途是社交网络分析。BFS 有助于发现用户之间的关系并识别关键节点。它可以探索社交连接并发现相关用户的簇群,从而揭示网络结构的洞见。
AI 应用
BFS 在 AI 训练中同样有用。例如,它可用于在象棋等游戏中搜索博弈状态。AI 算法可以使用 BFS 按层探索可能的走法,评估未来状态以决定最佳行动,从而找到通往胜利的最短路径。
BFS 还应用于机器人路径规划。它使机器人能够通过映射环境并在避开障碍物的同时寻找路径,从而在复杂环境中导航。
广度优先搜索与其他搜索算法对比
让我们把 BFS 与其他常见搜索算法进行比较,如深度优先搜索和 Dijkstra 算法。
与深度优先搜索的比较
广度优先搜索和深度优先搜索(DFS)都是图遍历算法,但它们的探索方式不同。BFS 会在深入之前访问当前深度的所有邻居;而 DFS 则会沿着一条路径尽可能向下探索,直到需要回溯。
BFS 擅长在无权图中寻找最短路径。这一优势使其适用于如迷宫导航和网络等问题。相比之下,DFS 不一定总能找到最短路径,但在深且广的图中,它可能更省空间。这使其更适合诸如拓扑排序或调度问题等任务,在这些任务中需要完整遍历且不希望占用过多内存。
与 Dijkstra 算法的比较
Dijkstra 算法是为加权图设计的图遍历算法,边具有不同的代价。不同于将所有边一视同仁的 BFS,Dijkstra 会基于边权计算最短路径。它最适用于代价相关的应用场景,例如在考虑旅行时间的前提下寻找最优路线。
虽然 Dijkstra 在加权图上很强大,但其更复杂且计算开销更高。使用优先队列时,Dijkstra 的时间复杂度为 O((V+E)logV),明显高于 BFS 的 O(V+E)。您可以在用 Python 实现 Dijkstra 算法:分步教程中了解更多。
潜在问题
使用 BFS 时,您可能遇到的一个问题是陷入环路。环路发生在路径返回到先前访问过的节点,从而在遍历中形成循环。如果 BFS 未正确跟踪已访问节点,可能会导致无限循环。重要的是维护一个已访问节点列表,或在处理后标记每个节点为已探索。这个简单的方法应能确保您的 BFS 高效探索图并正确终止。
另一个常见陷阱是错误使用队列。BFS 依赖队列来跟踪需要探索的节点。如果队列管理不当,可能会导致遗漏节点或遍历路径错误。为避免这种情况,请按需要探索的顺序将节点加入队列并再将其取出。这样有助于 BFS 按预期逐层探索节点。使用可靠的数据结构(如 Python 中的
collections.deque)也很有帮助。何时不该使用 BFS
尽管 BFS 十分通用,但并非在任何情况下都是最佳选择。首先,BFS 并不总适用于非常大或非常深的图,此时深度优先搜索可能更实用。此外,BFS 不适用于加权图,因为它将所有边视为相等。像 Dijkstra 或A* 这样的算法更适合这些场景,因为它们在计算最短路径时会考虑不同的代价。
总结
BFS 在无权图中寻找最短路径方面尤为重要。其按层探索的方式,使其非常适合需要在每一深度层全面探索节点的场景。
如果您对搜索算法感兴趣,欢迎阅读我在本系列中的其他文章,包括:Python 中的二分查找:高效搜索的完整指南。您或许也会对AVL 树:含 Python 实现的完整指南以及Python 网络分析入门感兴趣。