Last chance! 50% off DataCamp Premium
Sale ends in
यदि आप प्रौद्योगिकी जगत से अपडेट रहते हैं, तो आपने ‘लार्ज लैंग्वेज मॉडल्स (LLMs)’ शब्द ज़रूर सुना होगा। LLMs फिलहाल सबसे चर्चित तकनीकी शब्द हैं, और कृत्रिम बुद्धिमत्ता (AI) की दुनिया में उनकी अहमियत दिन-ब-दिन बढ़ती जा रही है। LLMs, ChatGPT और Bard जैसे मानव भाषाओं को संसाधित करना सीखने वाले मॉडलों की बदौलत, जनरेटिव AI क्रांति को आगे बढ़ा रहे हैं।
आज के बदलते बाजार में LLMs एक बड़ा खिलाड़ी बन चुके हैं, क्योंकि वे अपनी गहन प्राकृतिक भाषा संसाधन (NLP) प्रणालियों के जरिए मानव वार्तालाप का रूप धारण कर सकते हैं। स्वाभाविक है, हर चीज़ की सीमाएँ होती हैं, और AI-संचालित सहायक भी अपने अनूठे चुनौतियों के साथ आते हैं।
इनमें सबसे विशिष्ट चुनौती है LLM पक्षपात (bias) की संभावना, जो मॉडलों को प्रशिक्षित करने के लिए इस्तेमाल किए गए डेटा में निहित होती है।
ज़रा एक कदम पीछे चलें। LLMs क्या हैं?
LLMs ऐसे AI सिस्टम हैं, जैसे ChatGPT, जिनका उपयोग मानव भाषा का मॉडल बनाने और उसे संसाधित करने के लिए किया जाता है। यह AI एल्गोरिदम का एक प्रकार है जो डीप लर्निंग तकनीकों का उपयोग करके सामग्री का सार प्रस्तुत करता है, नई सामग्री जनरेट करता है, और भविष्यवाणी करता है। इन्हें “लार्ज” इसलिए कहा जाता है क्योंकि मॉडल को प्रशिक्षित करने के लिए लाखों या अरबों पैरामीटर्स की ज़रूरत होती है, जिन्हें ‘बड़े’ पाठ-डेटा संभार (corpus) पर प्रशिक्षित किया जाता है।
LLMs और NLP साथ-साथ काम करते हैं, क्योंकि वे मानव भाषा और उसके पैटर्न की उच्च समझ विकसित करने तथा बड़े डेटासेट्स के माध्यम से ज्ञान सीखने का लक्ष्य रखते हैं।
यदि आप LLMs की दुनिया में नए हैं, तो आपको गति पकड़ने के लिए निम्न लेख उपयोगी रहेगा:
LLM क्या है? लार्ज लैंग्वेज मॉडल्स और उनके काम करने का तरीका—एक मार्गदर्शिका। या हमारा Large Language Models (LLMs) Concepts Course करें, जो LLMs सीखने के लिए भी उपयुक्त है।
LLMs का उपयोग विभिन्न प्रकार के AI अनुप्रयोगों में व्यापक रूप से हुआ है। ये दिन-ब-दिन अधिक लोकप्रिय हो रहे हैं, और व्यवसाय कार्यप्रवाह उत्पादकता बढ़ाने के लिए उन्हें अपने मौजूदा सिस्टम और टूलिंग में एकीकृत करने के तरीके खोज रहे हैं।
LLMs का उपयोग निम्न उद्देश्यों के लिए किया जा सकता है:
LLMs Transformer मॉडलों का उपयोग करते हैं—एक डीप लर्निंग आर्किटेक्चर जो अनुक्रमिक डेटा विश्लेषण के जरिए संदर्भ सीखता है और समझ विकसित करता है।
Tokenization वह प्रक्रिया है जिसमें इनपुट टेक्स्ट को छोटे-छोटे यूनिट्स, यानी टोकन्स, में तोड़ा जाता है ताकि मॉडल उन्हें गणितीय समीकरणों के माध्यम से संसाधित और विश्लेषित कर सके और विभिन्न टोकन्स के बीच संबंधों की खोज कर सके। यह गणितीय प्रक्रिया संभाव्य (probabilistic) दृष्टिकोण अपनाती है ताकि प्रशिक्षण चरण के दौरान अगले शब्दों के क्रम की भविष्यवाणी की जा सके।
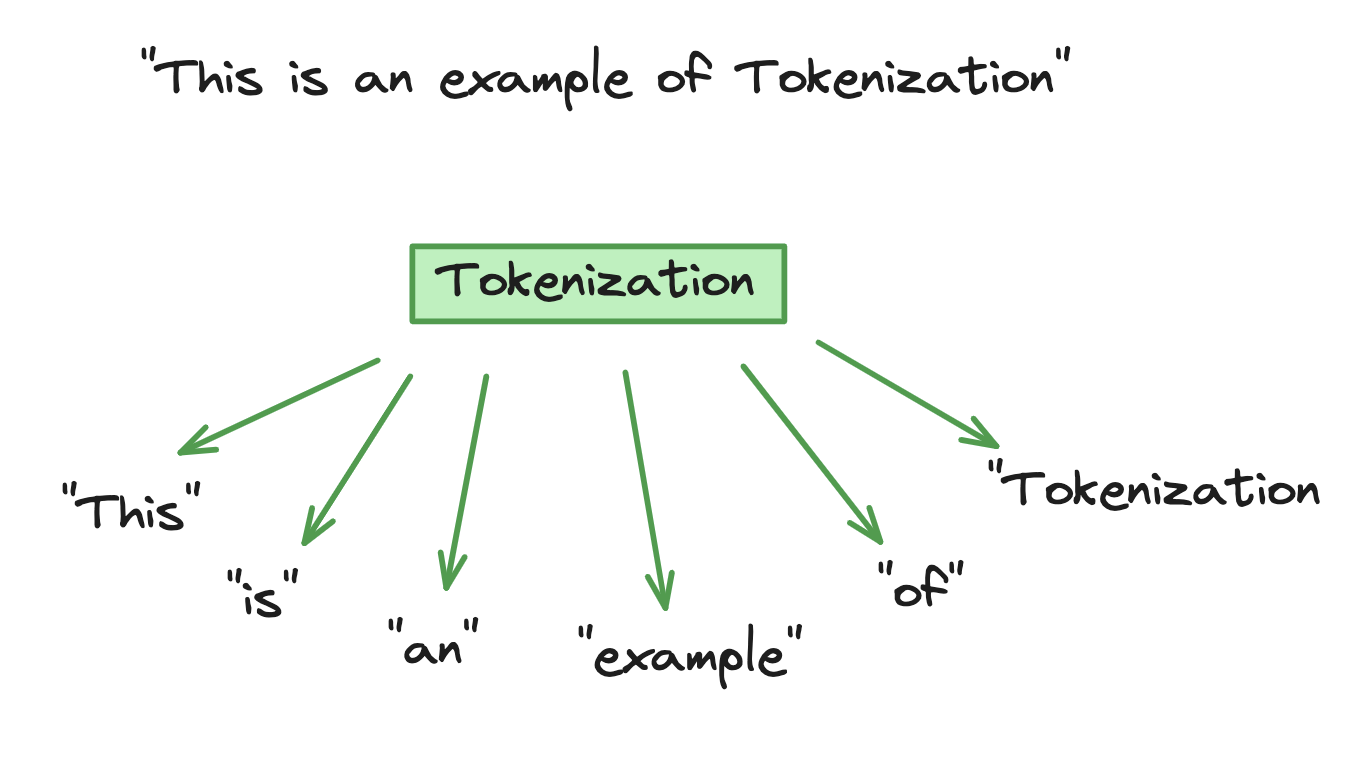
टोकनाइज़ेशन का उदाहरण
प्रशिक्षण चरण में मॉडल को विशाल मात्रा में पाठ-डेटा दिया जाता है ताकि वह विभिन्न भाषायी संदर्भों, बारीकियों और शैलियों को समझ सके। LLMs एक ऐसा ज्ञान-आधार निर्मित कर लेते हैं, जिससे वे मानव भाषा का प्रभावी ढंग से अनुकरण कर सकें।
LLMs की बहुआयामी क्षमता और भाषा-समझ उनकी उन्नत AI क्षमता का प्रमाण है। कानूनी दस्तावेजों से लेकर कथात्मक साहित्य तक, विविध शैलियों और विधाओं के व्यापक डेटासेट्स पर प्रशिक्षण ने LLMs को अलग-अलग परिदृश्यों और संदर्भों के अनुरूप ढलने की क्षमता दी है।
हालाँकि, LLMs की बहुमुखी प्रतिभा सिर्फ टेक्स्ट भविष्यवाणी तक सीमित नहीं है। विभिन्न भाषाओं, अलग-अलग संदर्भों और विविध आउटपुट प्रारूपों में कार्यों को संभाल पाना ऐसी बहुमुखी प्रतिभा है जो ग्राहक सेवा जैसे अनुप्रयोगों में अनुकूलनशीलता के रूप में दिखती है। यह बड़े, विशिष्ट डेटासेट्स पर व्यापक प्रशिक्षण और फाइन-ट्यूनिंग प्रक्रिया के कारण संभव हुआ है, जिसने अलग-अलग क्षेत्रों में इसकी प्रभावशीलता बढ़ाई है।
फिर भी, हमें LLM की विशिष्ट चुनौती याद रखनी चाहिए: पक्षपात।
जैसा कि हम जानते हैं, LLMs को विभिन्न स्रोतों से आए तरह-तरह के पाठ-डेटा पर प्रशिक्षित किया जाता है। जब डेटा मॉडल में डाला जाता है, तो मॉडल इसे अपने एकमात्र ज्ञान-आधार के रूप में लेता है और तथ्यात्मक मान लेता है। परंतु, डेटा में पूर्वाग्रह और गलत सूचना समाहित हो सकती है, जिससे LLM के आउटपुट में पक्षपात झलक सकता है।
उत्पादकता बढ़ाने और रोज़मर्रा के कार्यों में सहायता करने के लिए प्रसिद्ध एक टूल नैतिक चिंताओं के क्षेत्र दिखा रहा है। हमारे पाठ्यक्रम में आप AI की नैतिकता के बारे में और जान सकते हैं।
आम तौर पर, जितना अधिक डेटा, उतना बेहतर। यदि LLMs के प्रशिक्षण डेटा में अप्रतिनिधिक नमूने या पूर्वाग्रह मौजूद हैं, तो स्वाभाविक रूप से मॉडल इन्हें आत्मसात कर लेगा और सीख लेगा। LLM पक्षपात के उदाहरणों में लिंग, नस्ल और सांस्कृतिक पक्षपात शामिल हैं।
उदाहरण के लिए, यदि अधिकांश डेटा यह दर्शाता है कि महिलाएँ मुख्यतः क्लीनर या नर्स के रूप में काम करती हैं और पुरुष प्रायः इंजीनियर या CEO होते हैं, तो LLM लिंग-पक्षपात प्रदर्शित कर सकता है। इस तरह, प्रशिक्षण डेटा के कारण मॉडल ने समाज के रूढ़िगत धारणाओं को आत्मसात कर लिया। एक और उदाहरण नस्लीय पक्षपात है, जहाँ LLMs कुछ जातीय समूहों को रूढ़ियों के अनुरूप दर्शा सकते हैं; इसी तरह, सांस्कृतिक पक्षपात में रूढ़ियों के अनुरूप अति-प्रतिनिधित्व शामिल हो सकता है।
LLMs में पक्षपात की दो मुख्य उत्पत्तियाँ हैं:
हालाँकि LLMs बहुत बहुमुखी हैं, यह चुनौती दिखाती है कि बहुसांस्कृतिक सामग्री के मामले में मॉडल कम प्रभावी हो सकते हैं। निर्णय लेने की प्रक्रियाओं में LLMs के उपयोग के साथ जुड़ी नैतिक चिंताएँ स्वाभाविक रूप से उठती हैं।
LLMs में पक्षपात के प्रभाव मॉडल के उपयोगकर्ताओं और व्यापक समाज—दोनों पर पड़ते हैं।
जैसा कि ऊपर उल्लेख किया, संस्कृति और लिंग जैसी विभिन्न प्रकार की रूढ़ियाँ मौजूद हैं। LLMs के प्रशिक्षण डेटा में मौजूद पूर्वाग्रह इन हानिकारक रूढ़ियों को लगातार सुदृढ़ करते हैं, जिससे समाज पूर्वाग्रह के चक्र में फँसा रहता है और प्रगति बाधित होती है।
यदि LLMs पक्षपाती डेटा पचाते रहेंगे, तो वे सांस्कृतिक विभाजन और लैंगिक असमानता को आगे बढ़ाते रहेंगे।
भेदभाव अलग-अलग वर्गों के लोगों के साथ उनके लिंग, जातीयता, आयु या दिव्यांगता के आधार पर पूर्वाग्रहपूर्ण व्यवहार है। प्रशिक्षण डेटा कई बार अत्यधिक अल्प-प्रतिनिधित होता है, जिसमें विभिन्न समूहों का सही प्रतिनिधित्व नहीं मिलता।
यदि LLMs के आउटपुट में ऐसे पक्षपाती उत्तर हों जो नस्ल, लिंग और आयु के भेदभाव को बनाए रखें, तो यह हाशिये पर मौजूद समुदायों के लोगों के दैनिक जीवन पर नकारात्मक प्रभाव डालता है—जैसे भर्ती प्रक्रिया से लेकर शिक्षा के अवसरों तक। इससे LLMs के आउटपुट में विविधता और समावेशन की कमी होती है, और चूँकि इन आउटपुट का उपयोग आगे निर्णय लेने में हो सकता है, नैतिक चिंताएँ बढ़ती हैं।
यदि इस बात की शंका हो कि LLMs के प्रशिक्षण डेटा में अप्रतिनिधिक नमूने या पूर्वाग्रह हैं, तो यह प्रश्न भी उठता है कि क्या डेटा में दी गई जानकारी सही है। LLMs के माध्यम से भ्रामक सूचना या दुष्प्रचार का प्रसार गंभीर परिणाम ला सकता है।
उदाहरण के लिए, स्वास्थ्य सेवा में, पक्षपाती जानकारी वाले LLMs का उपयोग खतरनाक स्वास्थ्य निर्णयों की ओर ले जा सकता है। एक अन्य उदाहरण है राजनीतिक रूप से पक्षपाती डेटा वाले LLMs, जो ऐसा आख्यान आगे बढ़ा सकते हैं जिससे राजनीतिक दुष्प्रचार फैल सकता है।
LLMs के इर्द-गिर्द नैतिक चिंताएँ ही वह एकमात्र कारण नहीं हैं जिनकी वजह से समाज का एक हिस्सा हमारे दैनिक जीवन में AI सिस्टम्स के क्रियान्वयन को लेकर सहज नहीं है। कुछ या कई लोगों को AI सिस्टम्स के उपयोग और उनके समाज पर प्रभाव—जैसे नौकरी का नुकसान और आर्थिक अस्थिरता—को लेकर चिंता है।
AI सिस्टम्स के प्रति पहले से ही भरोसे की कमी है। इसलिए, LLMs द्वारा उत्पन्न पक्षपात समाज के AI पर बचे-खुचे भरोसे को भी खत्म कर सकता है। LLM तकनीक को निश्चिंत होकर अपनाने के लिए समाज का उस पर विश्वास होना आवश्यक है।
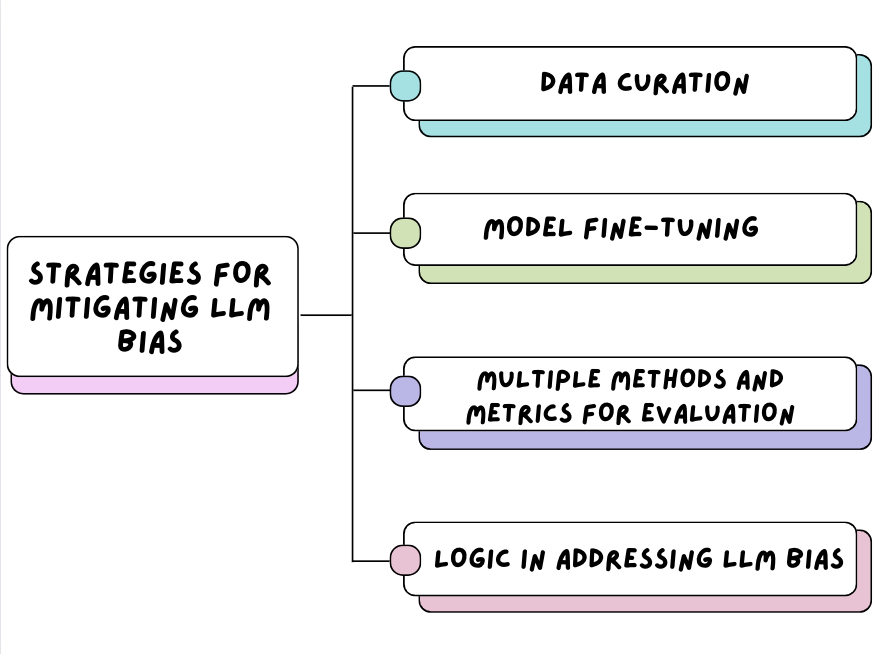
LLM पक्षपात कम करने की रणनीतियाँ
शुरुआत यहीं से करते हैं—डेटा से। कंपनियों को इस बात की उच्च जिम्मेदारी लेनी चाहिए कि वे मॉडलों में किस प्रकार का डेटा इनपुट कर रहे हैं।
यह सुनिश्चित करना कि LLMs के प्रशिक्षण डेटा विविध डेटा स्रोतों की व्यापक श्रेणी से क्यूरेट किया गया हो। अलग-अलग जनसांख्यिकी, भाषाओं और संस्कृतियों से आए पाठ-डेटासेट्स मानव भाषा के प्रतिनिधित्व का संतुलन बनाएँगे। इससे प्रशिक्षण डेटा में अप्रतिनिधिक नमूनों की गुंजाइश कम होगी और लक्षित मॉडल फाइन-ट्यूनिंग प्रयासों को दिशा मिलेगी, जो व्यापक समुदाय द्वारा उपयोग के समय पक्षपात के प्रभाव को घटा सकती है।
जब अलग-अलग डेटा स्रोतों को संकलित करके मॉडल में डाला जा चुका हो, तब संगठन मॉडल फाइन-ट्यूनिंग के जरिए सटीकता बढ़ाने और पक्षपात घटाने का काम जारी रख सकते हैं। फाइन-ट्यूनिंग के कई तरीके हैं, जैसे:
आप हमारे Fine-Tuning LLaMA 2 ट्यूटोरियल के साथ फाइन-ट्यूनिंग प्रक्रिया के बारे में अधिक जान सकते हैं, जिसमें प्री-ट्रेंड मॉडल को समायोजित करने की चरण-दर-चरण गाइड है।
आज के समाज के साथ सुरक्षित रूप से एकीकृत होने योग्य AI सिस्टम्स के सतत विकास हेतु, संगठनों को अपने मूल्यांकन प्रक्रिया में अनेक पद्धतियों और मीट्रिक्स का उपयोग करना चाहिए। LLMs जैसे AI सिस्टम्स को व्यापक समुदाय के लिए खोलने से पहले, सही पद्धतियाँ और मीट्रिक्स लागू करना आवश्यक है ताकि LLM आउटपुट में पक्षपात के विभिन्न आयामों को पकड़ा जा सके।
विधियों के उदाहरणों में मानव मूल्यांकन, स्वचालित मूल्यांकन या हाइब्रिड मूल्यांकन शामिल हैं। ये सभी विधियाँ LLMs में पक्षपात का पता लगाने, आकलन करने या फ़िल्टर करने के लिए उपयोग होती हैं। मीट्रिक्स के उदाहरणों में शुद्धता (accuracy), भाव (sentiment), निष्पक्षता (fairness) आदि आते हैं। ये मीट्रिक्स LLM आउटपुट में मौजूद पक्षपात पर फीडबैक देते हैं और LLMs में पहचाने गए पक्षपात को लगातार सुधारने में मदद करते हैं।
यदि आप LLM गुणवत्ता सुधारने के लिए उपयोग में आने वाले विभिन्न मूल्यांकनों के बारे में अधिक जानना चाहते हैं, तो हमारा कोड-अलॉन्ग Evaluating LLM Responses देखें।
MIT के कंप्यूटर साइंस और आर्टिफिशियल इंटेलिजेंस लैबोरेटरी (CSAIL) के एक अध्ययन ने तार्किक तर्क (logical reasoning) को एकीकृत करके LLMs में उल्लेखनीय प्रगति की है: Large language models are biased. Can logic help save them?
LLMs में तार्किक और संरचित सोच का महत्व इस बात में निहित है कि मॉडल तार्किक तर्क और समालोचनात्मक सोच लागू करके आउटपुट संसाधित व जनरेट कर सकें, ताकि वे अपने पीछे के तर्क के आधार पर अधिक सटीक उत्तर प्रदान करें।
इस प्रक्रिया में एक न्यूट्रल लैंग्वेज मॉडल बनाना शामिल है, जिसमें टोकन्स के बीच संबंधों को ‘न्यूट्रल’ माना जाता है, क्योंकि उनके बीच संबंध का कोई तर्क उपस्थित नहीं है। CSAIL ने इस पद्धति को एक भाषा मॉडल पर प्रशिक्षित किया और पाया कि नया प्रशिक्षित मॉडल बिना अतिरिक्त डेटा और एल्गोरिदमिक प्रशिक्षण के भी कम पक्षपाती था।
तर्क-सचेत (logic-aware) भाषा मॉडल हानिकारक रूढ़ियों को उत्पन्न करने से बचने में सक्षम होंगे।
Google Research अपने LLM BERT को अधिक समावेशी और विविध बनाए रखने के लिए इसके प्रशिक्षण डेटा का विस्तार करके निरंतर सुधार रहा है। प्री-ट्रेनिंग चरण के लिए बिना एनोटेशन वाले बड़े टेक्स्ट डेटासेट्स के उपयोग ने मॉडल को बाद में विशिष्ट कार्यों के अनुरूप फाइन-ट्यून करने में सक्षम बनाया है। उद्देश्य है कम पक्षपाती और अधिक मज़बूत आउटपुट देने वाला LLM बनाना। Google Research ने बताया है कि इस पद्धति से मॉडल द्वारा जनरेट की गई रूढ़िगत आउटपुट में कमी दिखी है और अलग-अलग बोलियों व सांस्कृतिक संदर्भों को समझने के प्रदर्शन में लगातार सुधार हुआ है।
Google Research टीम ने ‘Fairness Indicators’ नामक कई टूल्स विकसित किए हैं, जिनका उद्देश्य मशीन लर्निंग मॉडलों में पक्षपात का पता लगाना और उसे कम करने की प्रक्रिया से गुजरना है। ये इंडिकेटर्स फॉल्स पॉज़िटिव्स और फॉल्स नेगेटिव्स जैसी मीट्रिक्स का उपयोग करके प्रदर्शन का मूल्यांकन करते हैं और वे अंतराल पहचानते हैं जो सामान्य मीट्रिक्स से छिपे रह सकते हैं।
OpenAI ने व्यापक समुदाय को आश्वस्त किया है कि सुरक्षा, गोपनीयता और नैतिक चिंताएँ उनके लक्ष्यों के केंद्र में हैं। DALL-E 2 के लिए उनके pre-training mitigations में प्रशिक्षण डेटासेट से हिंसक और यौन चित्रों को फ़िल्टर करना, परस्पर दृश्यतः अत्यधिक समान छवियों को हटाना, और फिर मॉडल को सिखाना शामिल था कि डेटासेट को फ़िल्टर करने के प्रभावों को कैसे कम किया जाए।
कई बार एक चीज़ हासिल करना बिना दूसरी का त्याग किए संभव नहीं लगता। यही बात LLM पक्षपात घटाने और साथ ही मॉडल के प्रदर्शन को बनाए रखने या सुधारने के बीच संतुलन साधने पर लागू होती है। निष्पक्षता प्राप्त करने के लिए डि-बायसिंग मॉडल अनिवार्य हैं, लेकिन मॉडल का प्रदर्शन और सटीकता प्रभावित नहीं होनी चाहिए।
एक रणनीतिक दृष्टिकोण अपनाना होगा ताकि पक्षपात घटाने के उपाय—जैसे डेटा क्यूरेशन, मॉडल फाइन-ट्यूनिंग और बहु-पद्धति का उपयोग—मॉडल की भाषा समझने और आउटपुट जनरेट करने की क्षमता पर असर न डालें। सुधार आवश्यक हैं; तथापि, प्रदर्शन कोई समझौता नहीं होना चाहिए।
यह परीक्षण-त्रुटि, निगरानी-समायोजन, डि-बायसिंग-और-सुधार की सतत प्रक्रिया है।
इस लेख में हमने कवर किया:
LLM पक्षपात एक जटिल और बहुआयामी चुनौती है, जिसे प्राथमिकता देना आवश्यक है ताकि समाज में उस पर अधिक भरोसा बने और उसे रोज़मर्रा के कार्यों में सहजता से अपनाया जा सके। संगठनों को समझना चाहिए कि रूढ़ियाँ व्यक्तियों और समाज पर दीर्घकालिक नकारात्मक प्रभाव डालती हैं, और इसी समझ के आधार पर डेटा क्यूरेशन, मॉडल फाइन-ट्यूनिंग और तार्किक मॉडलिंग के माध्यम से LLM पक्षपात कम करने का पथ सुनिश्चित करना चाहिए।
LLMs के बारे में और जानने के लिए हमारा Large Language Models Concepts पाठ्यक्रम देखें, जो बताता है कि ये शक्तिशाली टूल्स AI परिदृश्य को कैसे पुनर्गठित कर रहे हैं।
आज ही अपनी AI यात्रा शुरू करें!
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}