
Program
AI Temelleri
10 sa
Alıştırma and program your progress.
Google Ile Devam EdinTeknoloji dünyasını takip ediyorsanız, son dönemde ‘Büyük Dil Modelleri (LLM’ler)’ terimini sıkça duymuşsunuzdur. LLM’ler bugün en popüler teknoloji terimlerinden biri ve yapay zeka (YZ) alanındaki önemi her geçen gün artıyor. Bu modeller, insan dillerini işler hâle geldikçe ChatGPT ve Bard gibi üretken YZ devrimini beslemeye devam ediyor.
LLM’ler, derin doğal dil işleme (NLP) sistemleri sayesinde insan konuşmalarını yansıtabilme yetenekleriyle günümüzün hızla değişen piyasasında önemli bir oyuncu hâline geldi. Elbette her şeyin sınırlamaları vardır ve YZ destekli asistanların da kendilerine özgü zorlukları bulunur.
Bu özgün zorluk, modelleri eğitmek için kullanılan verilere kök salmış olan LLM önyargısı potansiyelidir.
Bir adım geri gidelim. LLM’ler nedir?
LLM’ler, insan dilini modellemek ve işlemek için kullanılan ChatGPT gibi YZ sistemleridir. Derin öğrenme tekniklerini kullanarak yeni içerikleri özetleyen, üreten ve tahmin eden bir YZ algoritması türüdür. “Büyük” olarak adlandırılmalarının nedeni, modeli ‘büyük’ bir metin veri külliyatıyla eğitmek için milyonlarca hatta milyarlarca parametre gerektirmeleridir.
LLM’ler ve NLP, insan dilini ve kalıplarını yüksek düzeyde anlama ve geniş veri kümeleriyle bilgi edinme hedefleri doğrultusunda el ele çalışır.
LLM dünyasında yeniyseniz, hız kazanmanız için aşağıdaki makaleyi öneririz:
LLM Nedir? Büyük Dil Modellerine ve Nasıl Çalıştıklarına Dair Bir Kılavuz. Ya da LLM’ler hakkında bilgi edinmek için mükemmel bir seçenek olan Büyük Dil Modelleri (LLM) Kavramları kursumuzu alın.
LLM’ler farklı türde YZ uygulamalarında yaygın biçimde kullanılmaktadır. Her geçen gün daha popüler hâle geliyorlar ve işletmeler, iş akışı verimliliğini artırmak için bunları mevcut sistem ve araçlarına entegre etmenin yollarını arıyor.
LLM’ler şu kullanım alanlarında değerlendirilebilir:
LLM’ler, bağlamı öğrenen ve ardışık veri analizi yoluyla anlayış geliştiren derin öğrenme mimarisi Transformer modellerini kullanır.
Tokenizasyon, girdi metninin modelin işlemesi ve matematiksel denklemler aracılığıyla farklı token’lar arasındaki ilişkileri keşfetmesi için token adı verilen daha küçük birimlere bölünmesidir. Bu matematiksel süreç, modelin eğitim aşamasında bir sonraki kelime dizisini tahmin etmek için olasılıksal bir yaklaşım benimsemeyi içerir.
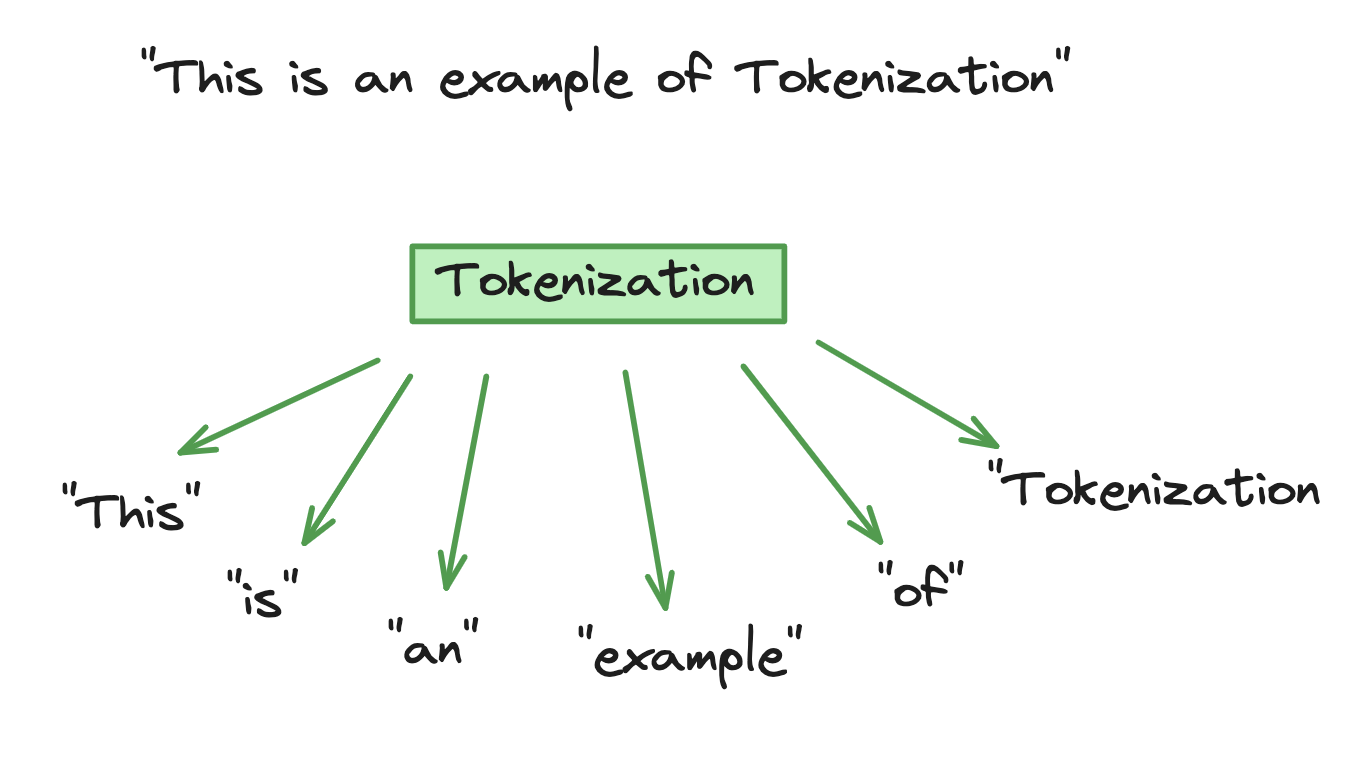
Tokenizasyon Örneği
Eğitim aşaması, modele çeşitli dilsel bağlamları, incelikleri ve tarzları anlamasına yardımcı olmak için devasa metin veri kümelerinin verilmesini içerir. LLM’ler böylece insan dilini etkili biçimde taklit edebilecekleri bir bilgi tabanı oluşturur.
LLM’lerin sahip olduğu çok yönlülük ve dil kavrayışı, gelişmiş YZ yeteneklerinin bir kanıtıdır. Hukuki belgelerden kurgu anlatılarına kadar farklı tür ve üsluplardan oluşan kapsamlı veri kümeleriyle eğitilmeleri, LLM’lere farklı senaryo ve bağlamlara uyum sağlama becerisi kazandırmıştır.
Ancak LLM’lerin çok yönlülüğü, metin tahmininin ötesine geçer. Farklı dillerde, farklı bağlamlarda ve farklı çıktılarda görevleri ele alabilmeleri; müşteri hizmetleri gibi çeşitli uyarlanabilirlik uygulamalarında gösterilen bir çok yönlülüktür. Bu, büyük ve belirli veri kümeleri üzerinde kapsamlı eğitim ve etkilerini çeşitli alanlarda artıran ince ayar süreci sayesinde mümkün olmuştur.
Yine de LLM’lerin özgün zorluğunu unutmamak gerekir: önyargı.
Bilindiği üzere LLM’ler çeşitli kaynaklardan farklı metin verileriyle eğitilir. Veriler modele aktarıldığında, model bu verileri tek bilgi kaynağı olarak kullanır ve olgusal kabul eder. Ancak veriler, yanlış bilgilendirmeyle birlikte önyargılar da barındırabilir; bu da LLM çıktılarının önyargıyı yansıtmasına yol açabilir.
Günlük görevlerde üretkenliği artırdığı bilinen bir aracın etik açıdan endişe verici yönleri ortaya çıkmaktadır. YZ etiği hakkında daha fazla bilgiyi kursumuzda edinebilirsiniz.
Ne kadar çok veri, o kadar iyi. LLM’ler için kullanılan eğitim verileri temsili olmayan örnekler veya önyargılar içeriyorsa, model doğal olarak bu önyargıları devralır ve öğrenir. LLM önyargısına örnek olarak cinsiyet, ırk ve kültürel önyargılar verilebilir.
Örneğin, verilerinin çoğu kadınların ağırlıklı olarak temizlikçi ya da hemşire, erkeklerin ise tipik olarak mühendis ya da CEO olduğunu gösteriyorsa LLM’ler cinsiyetlere karşı önyargılı olabilir. Model, kendisine beslenen eğitim verileri nedeniyle toplumun kalıp yargılarını devralmıştır. Bir diğer örnek, belirli etnik grupları kalıp yargılarla yansıtan ırksal önyargı ile bu kalıba uymak üzere aşırı temsil içeren kültürel önyargıdır.
LLM’lerdeki önyargıların iki ana kaynağı şunlardır:
LLM’ler çok yönlü olsa da bu zorluk, modelin çok kültürlü içerik söz konusu olduğunda daha az etkili olduğunu gösterir. LLM’ler ve önyargılar etrafındaki endişeler, LLM’lerin karar verme süreçlerinde kullanılmasına dayanır ve doğal olarak etik kaygıları gündeme getirir.
LLM’lerdeki önyargının etkileri hem model kullanıcılarını hem de daha geniş toplumu etkiler.
Yukarıda değindiğimiz gibi kültür ve cinsiyet gibi farklı türlerde kalıp yargılar vardır. LLM’lerin eğitim verilerindeki önyargılar, bu zararlı kalıp yargıları pekiştirmeye devam ederek toplumun önyargı döngüsünde kalmasına ve toplumsal ilerlemenin fiilen engellenmesine neden olur.
LLM’ler önyargılı verileri sindirmeye devam ederse kültürel ayrışmayı ve cinsiyet eşitsizliğini körüklemeyi sürdürecektir.
Ayrımcılık; insanları cinsiyet, etnisite, yaş veya engellilik gibi kategorilerine dayalı önyargılı muamele etmektir. Eğitim verileri, farklı grupların gerçek bir temsilini sunmayan biçimde ciddi derecede yetersiz temsil içerebilir.
Irk, cinsiyet ve yaş ayrımcılığını koruyan ve sürdüren önyargılı yanıtlar üreten LLM çıktıları; işe alım süreçlerinden eğitim fırsatlarına kadar, dezavantajlı topluluklardan insanların günlük yaşamları üzerinde olumsuz etki yaratır. Bu durum, LLM çıktılarında çeşitlilik ve kapsayıcılık eksikliğine yol açar ve bu çıktılar karar verme süreçlerinde kullanılabildiği için etik kaygıları artırır.
LLM’ler için kullanılan eğitim verilerinin temsili olmayan örnekler veya önyargılar içerdiğine dair endişeler varsa, verilerin doğru bilgiyi içerip içermediği sorusu da gündeme gelir. LLM’ler aracılığıyla yanlış bilgi veya dezenformasyonun yayılması ciddi sonuçlar doğurabilir.
Örneğin sağlık alanında, önyargılı bilgiler içeren LLM’lerin kullanımı tehlikeli sağlık kararlarına yol açabilir. Bir başka örnek, siyasi açıdan önyargılı veriler içeren LLM’lerin bu söylemi iterek siyasi dezenformasyona neden olmasıdır.
LLM’ler etrafındaki etik kaygılar, toplumun bir bölümünün YZ sistemlerinin gündelik yaşamımıza entegrasyonuna mesafeli yaklaşmasının tek nedeni değildir. Bazı ya da birçok kişi, YZ sistemlerinin kullanımı ve bunların toplumumuzu nasıl etkileyeceği konusunda; örneğin iş kaybı ve ekonomik istikrarsızlık gibi, endişelere sahiptir.
YZ sistemleri söz konusu olduğunda zaten bir güven eksikliği bulunmaktadır. Bu nedenle LLM’lerin ürettiği önyargı, toplumun genel olarak YZ sistemlerine duyduğu güveni tamamen zedeleyebilir. LLM teknolojisinin güvenle benimsenmesi için toplumun ona güvenmesi gerekir.
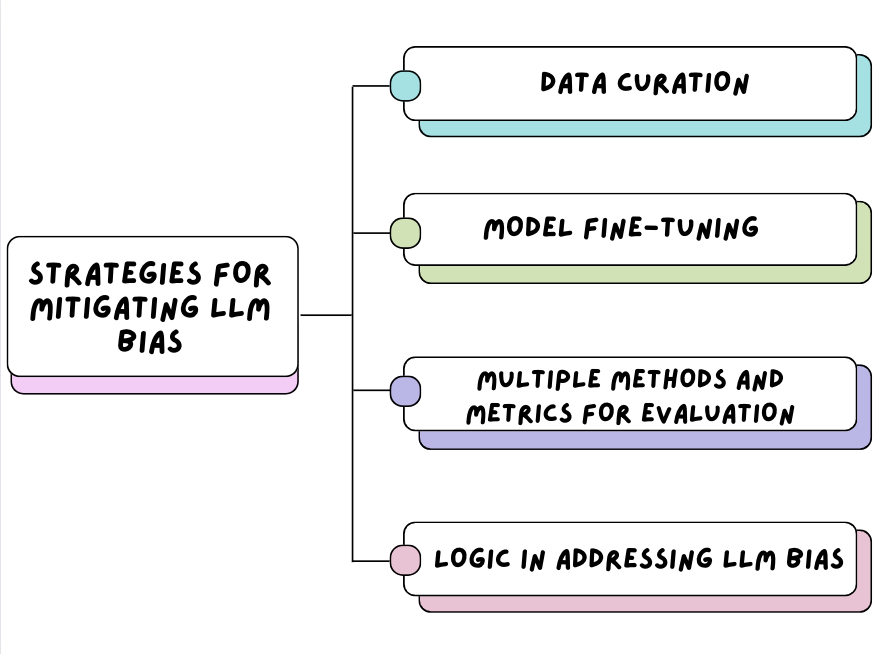
LLM Önyargısını Azaltma Stratejileri
En baştan, veriden başlayalım. Şirketler, modellere aktardıkları veri türü konusunda yüksek düzeyde sorumluluk taşımalıdır.
LLM’ler için kullanılan eğitim verilerinin çeşitli kaynaklardan küratörlüğü yapılarak derlenmesini sağlamak gerekir. Farklı demografilerden, dillerden ve kültürlerden gelen metin veri kümeleri, insan dilinin temsilini dengeler. Bu, eğitim verilerinin temsili olmayan örnekler içermemesini sağlar ve hedefli model ince ayar çabalarına yön vererek geniş topluluk tarafından kullanıldığında önyargının etkisini azaltabilir.
Farklı veri kaynakları derlenip modele aktarıldıktan sonra kuruluşlar, model ince ayarı yoluyla doğruluğu artırmaya ve önyargıları azaltmaya devam edebilir. Birkaç ince ayar yaklaşımı vardır, örneğin:
Önceden eğitilmiş bir modeli adım adım nasıl ayarlayacağınızı anlatan LLaMA 2 İnce Ayar eğitimimizle ince ayar süreci hakkında daha fazla bilgi edinebilirsiniz.
YZ sistemlerini günümüz toplumuyla güvenli şekilde entegre edecek biçimde sürekli geliştirmek için kuruluşların değerlendirme süreçlerinde birden fazla yöntem ve metrik kullanması gerekir. LLM gibi YZ sistemleri geniş topluluğa açılmadan önce, LLM çıktılarına yansıyan önyargının farklı boyutlarını yakalamak için doğru yöntem ve metriklerin uygulanması şarttır.
Yöntem örnekleri arasında insan değerlendirmesi, otomatik değerlendirme veya hibrit değerlendirme bulunur. Bu yöntemlerin tümü, LLM’lerdeki önyargıları tespit etmek, tahmin etmek veya filtrelemek için kullanılır. Metrik örnekleri arasında doğruluk, duygu, adalet ve daha fazlası yer alır. Bu metrikler, LLM çıktılarındaki önyargı hakkında geri bildirim sağlayabilir ve LLM’lerde tespit edilen önyargıların sürekli iyileştirilmesine yardımcı olabilir.
LLM kalitesini artırmak için kullanılan farklı değerlendirmeler hakkında daha fazla bilgi edinmek isterseniz LLM Yanıtlarını Değerlendirme uygulamalı içeriğimize göz atın.
MIT Bilgisayar Bilimi ve Yapay Zeka Laboratuvarı’nın (CSAIL) bir çalışması, mantıksal akıl yürütmeyi entegre ederek LLM’lerde önemli ilerlemeler kaydetti: Büyük dil modelleri önyargılı. Mantık onları kurtarmaya yardımcı olabilir mi?
LLM’lerde mantıklı ve yapılandırılmış düşünmenin önemi, modellerin mantıksal akıl yürütme ve eleştirel düşünmeyi uygulayarak çıktılar üretmesini ve böylece dayandıkları gerekçeyi kullanarak daha doğru yanıtlar verebilmesini sağlar.
Süreç, token’lar arasındaki ilişkilerin herhangi bir ilişki olduğuna dair mantık bulunmadığı için ‘tarafsız’ kabul edildiği tarafsız bir dil modeli inşa etmeyi içerir. CSAIL bu yöntemi bir dil modeli üzerinde eğitti ve yeni eğitilen modelin, ek veri veya ilave algoritma eğitimi olmaksızın daha az önyargılı olduğunu buldu.
Mantık farkındalığı olan dil modelleri, zararlı kalıp yargılar üretmekten kaçınma yeteneğine sahip olacaktır.
Google Research, eğitim verilerini genişleterek LLM’i BERT’i daha kapsayıcı ve çeşitli hâle getirmeye devam ediyor. Ön eğitim aşamasında açıklama içermeyen büyük metin veri kümelerinin kullanılması, modelin daha sonra belirli görevlere uyum sağlayacak şekilde ince ayar yapılmasına olanak tanıdı. Amaç, daha az önyargılı ve daha sağlam çıktılar üreten bir LLM oluşturmaktır. Google Research, bu yöntemin modelin ürettiği kalıp yargısal çıktılarda azalma gösterdiğini ve farklı lehçeleri ve kültürel bağlamları anlama performansını artırmaya devam ettiğini belirtiyor.
Google Research ekibi, makine öğrenimi modellerindeki önyargıları tespit etmeyi ve bir azaltma sürecinden geçirmeyi amaçlayan ‘Fairness Indicators’ adlı çeşitli araçlar geliştirdi. Bu göstergeler, performansı değerlendirmek ve genel metriklerin gizleyebileceği boşlukları belirlemek için yanlış pozitifler ve yanlış negatifler gibi metrikler kullanır.
OpenAI, güvenlik, gizlilik ve etik kaygıların hedeflerinin ön saflarında yer aldığını topluluğa güvence etti. DALL‑E 2 için ön eğitim azaltmaları, eğitim veri setinden şiddet ve cinsellik içeren görüntülerin filtrelenmesini, birbirine görsel olarak çok benzeyen görüntülerin kaldırılmasını ve ardından modelin veri setinin filtrelenmesinin etkilerini hafifletmeyi öğrenmesini içeriyordu.
Bazen birini başarmak için diğerinden ödün vermemek imkânsız olabilir. Bu, LLM önyargısını azaltırken modelin performansını koruma hatta iyileştirme dengesini kurmaya çalışırken de geçerlidir. Önyargıdan arındırma, adaleti sağlamak için zorunludur. Ancak modelin performansı ve doğruluğu da feda edilmemelidir.
Veri kürasyonu, model ince ayarı ve çoklu yöntemlerin kullanımı gibi önyargıyı azaltmaya yönelik yöntemlerin, modelin dili anlama ve çıktı üretme becerisini etkilememesini sağlamak için stratejik bir yaklaşım uygulanmalıdır. İyileştirmeler yapılmalıdır; ancak modelin performansı bir ödün alanı olmamalıdır.
Bu, deneme-yanılma, izleme ve ayarlama, önyargıdan arındırma ve iyileştirme meselesidir.
Bu yazıda şunları ele aldık:
LLM önyargısı, toplumun ona daha fazla güven duyması ve günlük görevlere entegrasyonunu özgürce kabul edebilmesi için önceliklendirilmesi gereken karmaşık ve çok boyutlu bir meydan okumadır. Kuruluşlar, kalıp yargıların bireyler ve toplum üzerindeki kalıcı olumsuz etkisini anlamalı ve bunu, veri kürasyonu, model ince ayarı ve mantıksal modelleme yoluyla LLM önyargılarını azaltma yolunu tesis etmek için kullanmalıdır.
LLM’ler hakkında daha fazla bilgi edinmek için, bu güçlü araçların YZ dünyasını nasıl yeniden şekillendirdiğini ele alan Büyük Dil Modelleri Kavramları kursumuza göz atın.
Yapay Zekâ Yolculuğunuza Bugün Başlayın!
Program
Kurs
Alıştırma and program your progress.
Google Ile Devam Edinblog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




