{count, plural, one {Programma} other {Programmi}}
Nozioni di base sull'intelligenza artificiale
{hours} ore
Se stai al passo con il mondo della tecnologia, avrai sentito parlare spesso di “Large Language Models (LLM)”. Gli LLM sono oggi il termine tech più gettonato e la loro importanza nel mondo dell’intelligenza artificiale (AI) cresce di giorno in giorno. Gli LLM continuano ad alimentare la rivoluzione dell’AI generativa man mano che questi modelli imparano a elaborare le lingue umane, come ChatGPT e Bard.
Gli LLM sono diventati un attore di primo piano nell’attuale mercato in evoluzione grazie alla loro capacità di rispecchiare le conversazioni umane attraverso sistemi avanzati di elaborazione del linguaggio naturale (NLP). Naturalmente, tutto ha i suoi limiti, e gli assistenti basati sull’AI presentano sfide specifiche.
Questa sfida particolare è il potenziale bias degli LLM, radicato nei dati utilizzati per addestrare i modelli.
Facciamo un passo indietro. Cosa sono gli LLM?
Gli LLM sono sistemi di AI come ChatGPT, usati per modellare ed elaborare il linguaggio umano. Sono un tipo di algoritmo di AI che utilizza tecniche di deep learning per riassumere, generare e prevedere nuovi contenuti. Sono definiti “large” perché il modello richiede milioni o addirittura miliardi di parametri, utilizzati per addestrarlo su un “ampio” corpus di testi.
LLM e NLP lavorano in sinergia: puntano a comprendere a fondo la lingua umana e i suoi schemi e a imparare conoscenza usando grandi dataset.
Se sei alle prime armi con il mondo degli LLM, ti consigliamo il seguente articolo per metterti in pari:
Cos’è un LLM? Guida ai Large Language Models e a come funzionano. Oppure segui il nostro corso sui concetti di Large Language Models (LLM), perfetto per imparare a conoscere gli LLM.
Gli LLM sono stati ampiamente impiegati in diversi tipi di applicazioni di AI. Sono sempre più diffusi e le aziende cercano modi per integrarli nei propri sistemi e strumenti per migliorare la produttività dei flussi di lavoro.
Gli LLM possono essere usati per i seguenti casi d’uso:
Gli LLM utilizzano i modelli Transformer, un’architettura di deep learning che apprende il contesto e la comprensione attraverso l’analisi sequenziale dei dati.
La tokenizzazione consiste nel suddividere il testo in input in unità più piccole chiamate token, che il modello può elaborare e analizzare tramite equazioni matematiche per scoprire le relazioni tra i vari token. Il processo matematico adotta un approccio probabilistico per prevedere la successiva sequenza di parole durante la fase di addestramento del modello.
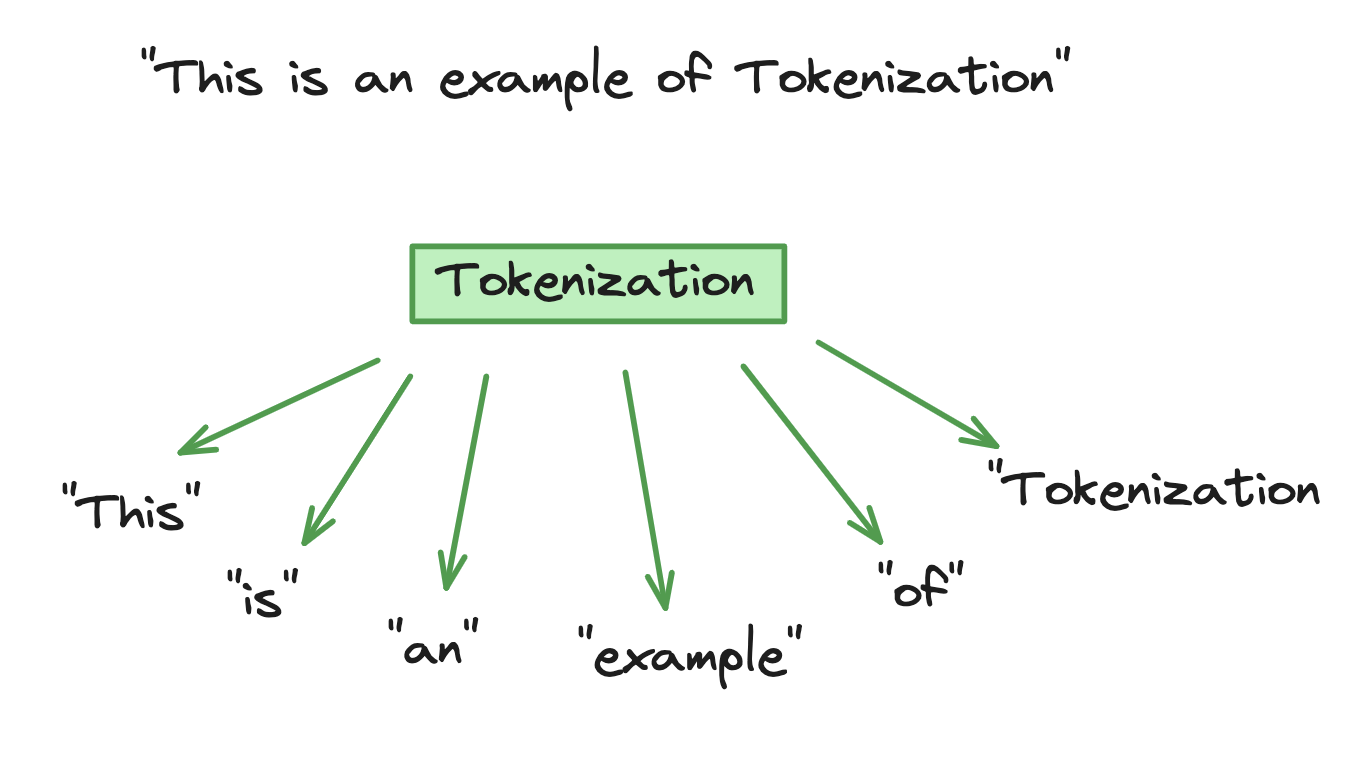
Esempio di tokenizzazione
La fase di addestramento consiste nell’alimentare il modello con enormi insiemi di testi per aiutarlo a comprendere vari contesti linguistici, sfumature e stili. Gli LLM creano così una base di conoscenza grazie alla quale possono imitare efficacemente il linguaggio umano.
La versatilità e la comprensione linguistica che gli LLM possiedono sono una testimonianza delle loro capacità avanzate di AI. Essendo addestrati su vasti dataset di generi e stili diversi, come documenti legali e narrativa, gli LLM hanno acquisito la capacità di adattarsi a scenari e contesti differenti.
Tuttavia, la versatilità degli LLM va oltre la previsione del testo. Gestire compiti in lingue diverse, contesti diversi e con output differenti è una forma di versatilità che si manifesta in varie applicazioni di adattabilità, come l’assistenza clienti. Ciò è possibile grazie all’addestramento estensivo su grandi dataset specifici e al processo di fine-tuning, che ne ha migliorato l’efficacia in campi diversi.
Ricordiamoci però della sfida specifica degli LLM: il bias.
Come sappiamo, gli LLM sono addestrati su una varietà di testi provenienti da fonti diverse. Quando i dati vengono immessi nel modello, questo li usa come unica base di conoscenza e li interpreta come fattuali. Tuttavia, i dati possono essere intrisi di bias e disinformazione, portando gli output degli LLM a riflettere tali pregiudizi.
Uno strumento noto per migliorare la produttività e assistere nelle attività quotidiane mostra dunque aree di preoccupazione etica. Puoi approfondire l’etica dell’AI nel nostro corso.
Più dati hai, meglio è. Se i dati di addestramento usati per gli LLM contengono campioni non rappresentativi o bias, è naturale che il modello li erediti e li apprenda. Esempi di bias negli LLM sono i pregiudizi di genere, razza e cultura.
Per esempio, gli LLM possono essere di parte rispetto ai generi se la maggior parte dei loro dati mostra che le donne lavorano prevalentemente come addette alle pulizie o infermiere, e gli uomini tipicamente come ingegneri o CEO. L’LLM ha ereditato gli stereotipi della società a causa dei dati di addestramento. Un altro esempio è il bias razziale, in cui gli LLM possono riflettere stereotipi su determinati gruppi etnici, così come bias culturali di sovrarappresentazione per adattarsi allo stereotipo.
Le due principali origini dei bias negli LLM sono:
Sebbene gli LLM siano molto versatili, questa sfida mostra come il modello sia meno efficace con contenuti multiculturali. La preoccupazione sui bias degli LLM riguarda l’uso degli LLM nei processi decisionali, sollevando naturalmente questioni etiche.
Gli impatti del bias negli LLM riguardano sia gli utenti del modello sia la società in senso più ampio.
Come accennato sopra, esistono diversi tipi di stereotipi, ad esempio culturali e di genere. I bias nei dati di addestramento degli LLM continuano a rafforzare questi stereotipi dannosi, mantenendo la società in un ciclo di pregiudizi e ostacolando di fatto il progresso.
Se gli LLM continueranno a digerire dati distorti, continueranno anche a spingere divisioni culturali e disuguaglianze di genere.
La discriminazione è il trattamento pregiudizievole di categorie di persone sulla base di sesso, etnia, età o disabilità. I dati di addestramento possono essere fortemente sotto-rappresentativi, non offrendo una reale rappresentazione dei diversi gruppi.
Output di LLM che contengono risposte distorte e che perpetuano discriminazioni razziali, di genere o di età incidono negativamente sulla vita quotidiana delle persone appartenenti a comunità emarginate, ad esempio nei processi di selezione del personale o nelle opportunità educative. Ciò porta a una mancanza di diversità e inclusione negli output degli LLM, sollevando preoccupazioni etiche poiché questi output possono essere ulteriormente utilizzati per prendere decisioni.
Se c’è il timore che i dati di addestramento degli LLM contengano campioni non rappresentativi o bias, sorge anche la domanda se i dati contengano informazioni corrette. La diffusione di misinformation o disinformazione tramite gli LLM può avere effetti rilevanti.
Per esempio, in ambito sanitario, l’uso di LLM che contengono informazioni distorte può portare a decisioni mediche pericolose. Un altro esempio è rappresentato da LLM con dati politicamente di parte che spingono una certa narrazione, favorendo la disinformazione politica.
Le preoccupazioni etiche attorno agli LLM non sono l’unica ragione per cui una parte della società fatica ad accettare l’implementazione di sistemi di AI nella vita quotidiana. Alcune, o molte, persone sono preoccupate per l’uso dei sistemi di AI e per il loro impatto sulla società, ad esempio la perdita di posti di lavoro e l’instabilità economica.
Esiste già una carenza di fiducia nei confronti dei sistemi di AI. Pertanto, il bias prodotto dagli LLM può annullare completamente la poca fiducia o confidenza che la società ripone complessivamente in questi sistemi. Affinché la tecnologia LLM sia accettata con convinzione, è necessario che la società si fidi di essa.
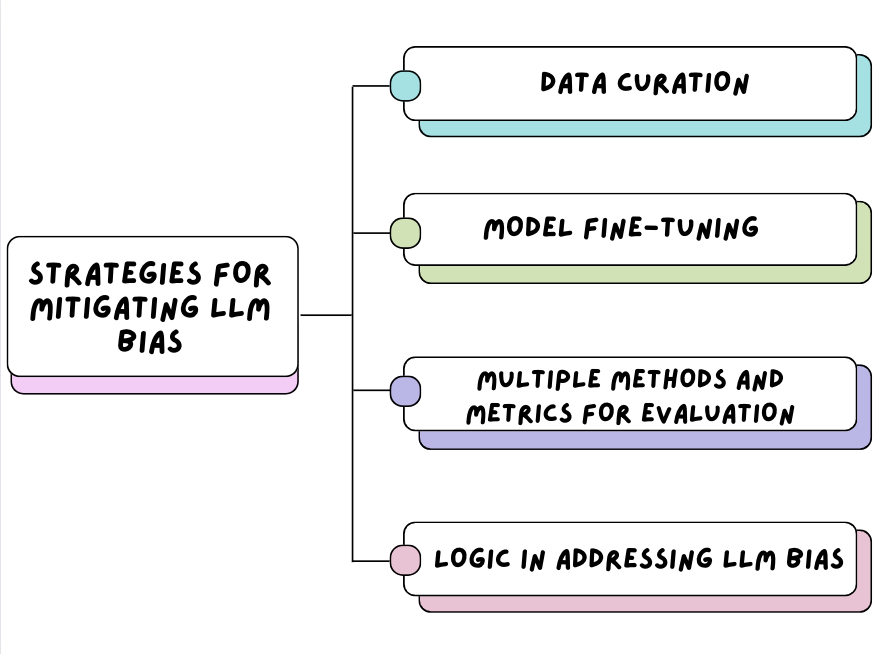
Strategie per mitigare il bias negli LLM
Partiamo dall’inizio: i dati coinvolti. Le aziende devono essere altamente responsabili del tipo di dati che immettono nei modelli.
Bisogna garantire che i dati di addestramento usati per gli LLM siano curati attingendo a un’ampia gamma di fonti. Dataset testuali provenienti da demografie, lingue e culture diverse bilanceranno la rappresentazione del linguaggio umano. Ciò assicura che i dati di addestramento non contengano campioni non rappresentativi e guida sforzi mirati di fine-tuning del modello, riducendo l’impatto del bias quando il modello è usato dalla comunità più ampia.
Una volta raccolta e immessa nel modello una gamma di fonti di dati, le organizzazioni possono continuare a migliorare l’accuratezza e ridurre i bias tramite il fine-tuning. Esistono diversi approcci di fine-tuning, come:
Puoi saperne di più sul processo di fine-tuning con il nostro tutorial sul Fine-Tuning di LLaMA 2, che offre una guida passo passo alla regolazione del modello pre-addestrato.
Per far crescere in modo continuo sistemi di AI integrabili in sicurezza nella società odierna, le organizzazioni devono adottare metodi e metriche molteplici nel processo di valutazione. Prima che sistemi di AI come gli LLM siano resi disponibili alla collettività, occorre implementare metodi e metriche adeguati per assicurare che le diverse dimensioni del bias siano rilevate negli output.
Esempi di metodi includono valutazione umana, valutazione automatica o ibrida. Tutti questi metodi servono a individuare, stimare o filtrare i bias negli LLM. Esempi di metriche includono accuratezza, sentiment, fairness e altro. Queste metriche possono fornire feedback sul bias negli output degli LLM e aiutare a migliorare continuamente i pregiudizi rilevati.
Se vuoi saperne di più sulle diverse valutazioni usate per migliorare la qualità degli LLM, dai un’occhiata al nostro code-along su Valutare le risposte degli LLM.
Uno studio del Computer Science and Artificial Intelligence Laboratory (CSAIL) del MIT ha compiuto progressi significativi negli LLM integrando il ragionamento logico: I large language model sono di parte. La logica può salvarli?
L’importanza del pensiero logico e strutturato negli LLM consente ai modelli di elaborare e generare output applicando ragionamento logico e pensiero critico, in modo da fornire risposte più accurate sostenute da un percorso argomentativo.
Il processo consiste nel costruire un modello linguistico neutrale in cui le relazioni tra token sono considerate “neutrali” poiché non c’è logica che affermi l’esistenza di una relazione tra i due. Il CSAIL ha addestrato questo metodo su un modello linguistico e ha riscontrato che il nuovo modello era meno di parte senza bisogno di più dati o di ulteriore addestramento algoritmico.
I modelli linguistici attenti alla logica avranno la capacità di evitare la produzione di stereotipi dannosi.
Google Research continua a migliorare il suo LLM BERT ampliando i dati di addestramento per renderli più inclusivi e diversificati. L’uso di grandi dataset contenenti testo non annotato per la fase di pre-addestramento ha permesso in seguito di effettuare il fine-tuning del modello per adattarlo a compiti specifici. L’obiettivo è creare un LLM meno di parte e con output più robusti. Google Research ha dichiarato che questo metodo ha mostrato una riduzione degli output stereotipati generati dal modello e continua a migliorarne le prestazioni nella comprensione di dialetti e contesti culturali diversi.
Il team di Google Research ha riunito diversi strumenti chiamati “Fairness Indicators”, volti a rilevare il bias nei modelli di machine learning e a intraprendere un processo di mitigazione. Questi indicatori utilizzano metriche come falsi positivi e falsi negativi per valutare le prestazioni e identificare lacune che potrebbero essere nascoste da metriche generali.
OpenAI ha assicurato alla comunità che sicurezza, privacy e questioni etiche sono in cima ai loro obiettivi. Le loro mitigazioni nel pre-addestramento per DALL-E 2 includevano il filtraggio di immagini violente e sessuali dal dataset di addestramento, la rimozione di immagini visivamente simili tra loro e l’insegnamento al modello di mitigare gli effetti del filtraggio del dataset.
Riuscire a ottenere una cosa senza sacrificare l’altra a volte può essere impossibile. Questo vale quando si cerca di bilanciare la riduzione del bias degli LLM con il mantenimento, o addirittura il miglioramento, delle prestazioni del modello. Il debiasing dei modelli è fondamentale per raggiungere l’equità; tuttavia, le prestazioni e l’accuratezza non dovrebbero essere compromesse.
È necessario adottare un approccio strategico per garantire che i metodi di mitigazione del bias, come la curazione dei dati, il fine-tuning del modello e l’uso di metodi multipli, non compromettano la capacità del modello di comprendere e generare output linguistici. Servono miglioramenti, ma le prestazioni del modello non dovrebbero essere oggetto di compromesso.
Si tratta di prove ed errori, monitoraggio e aggiustamenti, debiasing e miglioramento.
In questo articolo abbiamo visto:
Il bias negli LLM è una sfida complessa e multifattoriale che va prioritarizzata affinché la società vi riponga maggiore fiducia e ne accetti liberamente l’integrazione nelle attività quotidiane. Le organizzazioni devono comprendere l’impatto negativo duraturo che gli stereotipi hanno sugli individui e sulla società e usare questa consapevolezza per tracciare un percorso di mitigazione dei bias degli LLM attraverso curazione dei dati, fine-tuning del modello e modellazione logica.
Per saperne di più sugli LLM, esplora il nostro corso Large Language Models Concepts, che illustra come questi potenti strumenti stanno rimodellando il panorama dell’AI.
Inizia oggi il tuo percorso nell’AI!
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min



