
Lộ trình
Cơ bản về Trí tuệ Nhân tạo
10 giờ
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleNếu bạn theo dõi thế giới công nghệ, hẳn bạn đã nghe cụm từ ‘Mô hình ngôn ngữ lớn (LLM)’ được nhắc đến liên tục. LLM hiện là thuật ngữ công nghệ phổ biến nhất, và tầm quan trọng của chúng trong thế giới trí tuệ nhân tạo (AI) ngày càng lớn. LLM tiếp tục thúc đẩy cuộc cách mạng AI tạo sinh khi các mô hình này học cách xử lý ngôn ngữ tự nhiên của con người, như ChatGPT và Bard.
LLM đã trở thành một nhân tố đáng kể trên thị trường hiện nay nhờ khả năng mô phỏng hội thoại của con người thông qua hệ thống xử lý ngôn ngữ tự nhiên (NLP) chuyên sâu. Tất nhiên, mọi thứ đều có giới hạn, và các trợ lý chạy bằng AI cũng có những thách thức riêng.
Thách thức đặc thù này là nguy cơ thiên kiến trong LLM, vốn bám rễ trong dữ liệu dùng để huấn luyện các mô hình.
Hãy quay lại một bước. LLM là gì?
LLM là các hệ thống AI như ChatGPT, được dùng để mô hình hóa và xử lý ngôn ngữ của con người. Đây là một loại thuật toán AI sử dụng các kỹ thuật học sâu để tóm tắt, tạo và dự đoán nội dung mới. Chúng được gọi là “lớn” vì mô hình cần đến hàng triệu hoặc thậm chí hàng tỷ tham số, được dùng để huấn luyện mô hình bằng một kho văn bản ‘lớn’.
LLM và NLP hoạt động song hành vì chúng hướng tới việc hiểu sâu ngôn ngữ của con người và các quy luật của nó, đồng thời học kiến thức từ các bộ dữ liệu khổng lồ.
Nếu bạn là người mới với thế giới LLM, bài viết sau đây sẽ giúp bạn nắm bắt nhanh:
LLM là gì? Hướng dẫn về Mô hình Ngôn ngữ Lớn và Cách Chúng Hoạt động. Hoặc học khóa học Khái niệm Mô hình Ngôn ngữ Lớn (LLM) của chúng tôi, rất phù hợp để tìm hiểu về LLM.
LLM đã được sử dụng rộng rãi trong nhiều loại ứng dụng AI. Chúng ngày càng phổ biến, và các doanh nghiệp đang tìm cách tích hợp chúng vào hệ thống và công cụ hiện có để nâng cao năng suất quy trình.
LLM có thể được dùng cho các trường hợp sau:
LLM sử dụng mô hình Transformer, một kiến trúc học sâu học ngữ cảnh và hiểu thông qua phân tích dữ liệu tuần tự.
Tokenization là khi văn bản đầu vào được chia nhỏ thành các đơn vị gọi là token để mô hình xử lý và phân tích thông qua các phép toán nhằm khám phá mối quan hệ giữa các token khác nhau. Quá trình toán học này áp dụng cách tiếp cận xác suất để dự đoán chuỗi từ tiếp theo trong giai đoạn huấn luyện của mô hình.
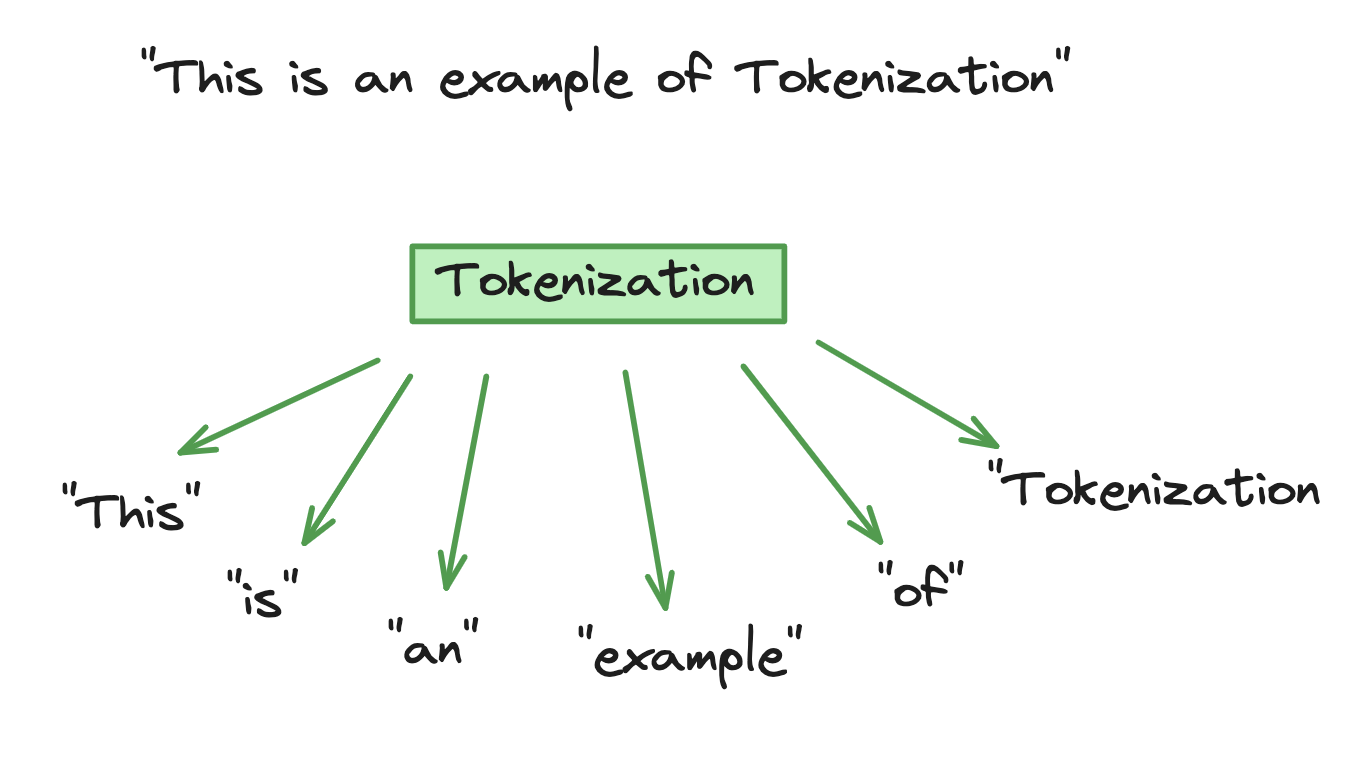
Ví dụ về Tokenization
Giai đoạn huấn luyện gồm việc đưa vào mô hình những bộ dữ liệu văn bản khổng lồ để giúp mô hình hiểu nhiều bối cảnh, sắc thái và phong cách ngôn ngữ. LLM sẽ tạo ra một nền tảng tri thức để có thể mô phỏng hiệu quả ngôn ngữ con người.
Tính linh hoạt và khả năng hiểu ngôn ngữ mà LLM sở hữu là minh chứng cho năng lực AI tiên tiến của chúng. Được huấn luyện trên các bộ dữ liệu đồ sộ từ nhiều thể loại và phong cách, như tài liệu pháp lý và truyện hư cấu, đã giúp LLM có khả năng thích ứng với nhiều kịch bản và ngữ cảnh khác nhau.
Tuy nhiên, sự linh hoạt của LLM vượt ra ngoài dự đoán văn bản. Khả năng xử lý tác vụ ở nhiều ngôn ngữ, bối cảnh và định dạng đầu ra khác nhau thể hiện trong các ứng dụng đa dạng như dịch vụ khách hàng. Điều này nhờ vào quá trình huấn luyện chuyên sâu trên các bộ dữ liệu lớn có tính chuyên biệt và quá trình tinh chỉnh mô hình, giúp nâng cao hiệu quả trong nhiều lĩnh vực.
Tuy vậy, chúng ta phải nhớ đến thách thức đặc thù của LLM: thiên kiến.
Như đã biết, LLM được huấn luyện trên nhiều dữ liệu văn bản từ nhiều nguồn. Khi dữ liệu được đưa vào mô hình, nó được dùng làm nền tảng tri thức duy nhất và được mô hình diễn giải như sự thật. Tuy nhiên, dữ liệu có thể chứa thiên kiến cũng như thông tin sai lệch, dẫn đến việc đầu ra của LLM phản ánh thiên kiến.
Một công cụ vốn được cho là cải thiện năng suất và hỗ trợ công việc hàng ngày lại bộc lộ các vấn đề đạo đức. Bạn có thể tìm hiểu thêm về đạo đức AI trong khóa học của chúng tôi.
Dữ liệu càng nhiều càng tốt. Nếu dữ liệu huấn luyện dùng cho LLM chứa các mẫu không đại diện hoặc thiên kiến, mô hình tự nhiên sẽ kế thừa và học theo các thiên kiến đó. Ví dụ về thiên kiến trong LLM gồm thiên kiến giới tính, chủng tộc và văn hóa.
Chẳng hạn, LLM có thể thiên lệch về giới nếu đa số dữ liệu cho thấy phụ nữ chủ yếu làm công việc dọn dẹp hoặc y tá, còn nam giới thường là kỹ sư hoặc CEO. LLM đã kế thừa những khuôn mẫu xã hội do dữ liệu huấn luyện được nạp vào. Một ví dụ khác là thiên kiến chủng tộc, khi LLM có thể phản ánh một số nhóm sắc tộc theo các khuôn mẫu, cũng như thiên kiến văn hóa do sự đại diện quá mức để phù hợp với khuôn mẫu.
Hai nguồn gốc chính của thiên kiến trong LLM là:
Mặc dù LLM rất linh hoạt, thách thức này cho thấy mô hình kém hiệu quả hơn khi xử lý nội dung đa văn hóa. Mối lo ngại về LLM và thiên kiến xuất phát từ việc sử dụng LLM trong quá trình ra quyết định, tự nhiên làm dấy lên các vấn đề đạo đức.
Các tác động của thiên kiến trong LLM ảnh hưởng cả người dùng mô hình lẫn xã hội rộng lớn hơn.
Như đã đề cập, có nhiều loại khuôn mẫu như văn hóa và giới. Thiên kiến trong dữ liệu huấn luyện của LLM tiếp tục củng cố những khuôn mẫu gây hại này, khiến xã hội mắc kẹt trong vòng luẩn quẩn của định kiến và cản trở tiến bộ.
Nếu LLM tiếp tục hấp thụ dữ liệu thiên lệch, chúng sẽ tiếp tục thúc đẩy chia rẽ văn hóa và bất bình đẳng giới.
Phân biệt đối xử là việc đối xử thiên lệch với các nhóm người khác nhau dựa trên giới tính, sắc tộc, tuổi tác hoặc khuyết tật. Dữ liệu huấn luyện có thể bị thiếu đại diện nghiêm trọng, trong đó dữ liệu không phản ánh đúng các nhóm khác nhau.
Đầu ra của LLM chứa phản hồi thiên kiến, tiếp tục duy trì phân biệt chủng tộc, giới tính và tuổi tác, gây tác động tiêu cực đến cuộc sống hằng ngày của những cộng đồng thiểu số, như trong quy trình tuyển dụng hay cơ hội giáo dục. Điều này dẫn đến thiếu đa dạng và hòa nhập trong đầu ra của LLM, làm dấy lên các vấn đề đạo đức khi những đầu ra này có thể tiếp tục được dùng trong quá trình ra quyết định.
Nếu lo ngại rằng dữ liệu huấn luyện dùng cho LLM chứa các mẫu không đại diện hoặc thiên kiến, cũng cần đặt câu hỏi liệu dữ liệu có đúng hay không. Việc lan truyền thông tin sai lệch hoặc đánh lạc hướng qua LLM có thể gây hậu quả nghiêm trọng.
Ví dụ, trong lĩnh vực chăm sóc sức khỏe, sử dụng LLM chứa thông tin thiên lệch có thể dẫn đến các quyết định nguy hiểm về sức khỏe. Một ví dụ khác là LLM chứa dữ liệu thiên kiến chính trị và thúc đẩy luận điệu này, có thể dẫn tới thông tin sai lệch về chính trị.
Những lo ngại đạo đức quanh LLM không phải là lý do duy nhất khiến một bộ phận xã hội chưa sẵn lòng với việc triển khai hệ thống AI trong đời sống hằng ngày. Một số, thậm chí nhiều người, lo ngại về việc sử dụng hệ thống AI và cách chúng tác động tới xã hội, ví dụ như mất việc làm và bất ổn kinh tế.
Đã có sẵn sự thiếu tin tưởng đối với hệ thống AI. Do đó, thiên kiến do LLM tạo ra có thể làm tiêu tan bất kỳ niềm tin hay sự tin cậy nào mà xã hội dành cho hệ thống AI nói chung. Để công nghệ LLM được chấp nhận một cách tự tin, xã hội cần phải tin tưởng nó.
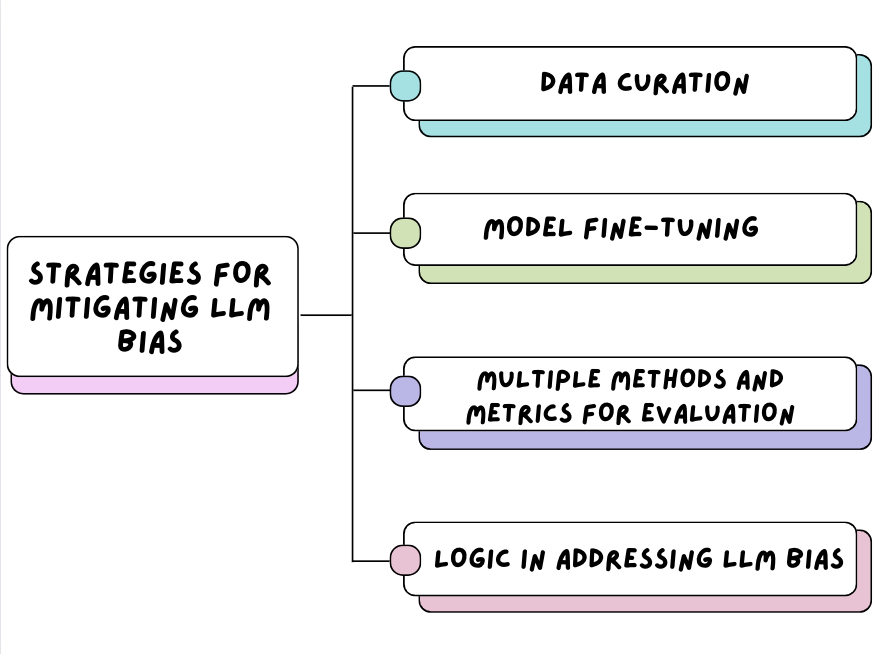
Chiến lược giảm thiểu thiên kiến trong LLM
Hãy bắt đầu từ đầu, tức là dữ liệu liên quan. Các công ty cần có trách nhiệm cao với loại dữ liệu mà họ đưa vào mô hình.
Đảm bảo dữ liệu huấn luyện dùng cho LLM được tuyển chọn từ nhiều nguồn đa dạng. Các bộ dữ liệu văn bản đến từ nhiều nhân khẩu học, ngôn ngữ và văn hóa sẽ cân bằng sự đại diện của ngôn ngữ con người. Điều này giúp dữ liệu huấn luyện không chứa các mẫu thiếu đại diện và định hướng nỗ lực tinh chỉnh mô hình một cách có mục tiêu, từ đó giảm tác động của thiên kiến khi được cộng đồng rộng rãi sử dụng.
Khi đã tổng hợp và đưa nhiều nguồn dữ liệu vào mô hình, các tổ chức có thể tiếp tục cải thiện độ chính xác và giảm thiên kiến thông qua tinh chỉnh mô hình. Có một số cách tiếp cận tinh chỉnh, như:
Bạn có thể tìm hiểu thêm về quy trình tinh chỉnh với hướng dẫn Tinh chỉnh LLaMA 2 của chúng tôi, cung cấp từng bước điều chỉnh mô hình đã huấn luyện sẵn.
Để liên tục phát triển các hệ thống AI có thể tích hợp an toàn với xã hội ngày nay, các tổ chức cần sử dụng nhiều phương pháp và chỉ số trong quy trình đánh giá. Trước khi các hệ thống AI như LLM mở cho cộng đồng rộng rãi, cần áp dụng đúng phương pháp và chỉ số để đảm bảo nắm bắt được các chiều kích khác nhau của thiên kiến trong đầu ra LLM.
Ví dụ về phương pháp gồm đánh giá của con người, đánh giá tự động hoặc đánh giá kết hợp. Tất cả đều được dùng để phát hiện, ước lượng hoặc lọc thiên kiến trong LLM. Ví dụ về chỉ số gồm độ chính xác, cảm xúc, tính công bằng và nhiều hơn nữa. Các chỉ số này có thể cung cấp phản hồi về thiên kiến trong đầu ra LLM và giúp liên tục cải thiện các thiên kiến được phát hiện.
Nếu bạn muốn tìm hiểu thêm về các đánh giá khác nhau nhằm cải thiện chất lượng LLM, hãy xem phần thực hành theo mã về Đánh giá phản hồi của LLM.
Một nghiên cứu từ Phòng thí nghiệm Khoa học Máy tính và Trí tuệ Nhân tạo (CSAIL) của MIT đã đạt tiến bộ đáng kể trong LLM bằng cách tích hợp suy luận logic: Các mô hình ngôn ngữ lớn có thiên kiến. Liệu logic có thể cứu chúng?
Tầm quan trọng của tư duy logic và có cấu trúc trong LLM cho phép các mô hình xử lý và tạo đầu ra với việc áp dụng suy luận logic và tư duy phản biện, để LLM có thể đưa ra phản hồi chính xác hơn dựa trên lý lẽ phía sau.
Quy trình bao gồm xây dựng một mô hình ngôn ngữ trung tính, trong đó mối quan hệ giữa các token được coi là ‘trung tính’ vì không có logic nào khẳng định tồn tại mối quan hệ giữa chúng. CSAIL đã huấn luyện phương pháp này trên một mô hình ngôn ngữ và nhận thấy mô hình mới huấn luyện có ít thiên kiến hơn mà không cần thêm dữ liệu hay huấn luyện thuật toán bổ sung.
Các mô hình ngôn ngữ có nhận thức về logic sẽ có khả năng tránh tạo ra các khuôn mẫu gây hại.
Google Research tiếp tục cải tiến LLM BERT bằng cách mở rộng dữ liệu huấn luyện để đảm bảo tính bao trùm và đa dạng hơn. Việc sử dụng các bộ dữ liệu lớn chứa văn bản chưa gán nhãn cho giai đoạn tiền huấn luyện cho phép mô hình sau đó được tinh chỉnh để thích ứng với các tác vụ cụ thể. Mục tiêu là tạo ra một LLM ít thiên kiến hơn và cho đầu ra vững vàng hơn. Google Research cho biết phương pháp này đã cho thấy sự giảm thiểu các đầu ra mang tính khuôn mẫu do mô hình tạo ra và tiếp tục cải thiện hiệu suất trong việc hiểu các phương ngữ và bối cảnh văn hóa khác nhau.
Nhóm Google Research đã xây dựng một số công cụ gọi là ‘Fairness Indicators,’ nhằm phát hiện thiên kiến trong các mô hình học máy và tiến hành quy trình giảm thiểu. Các chỉ báo này sử dụng các chỉ số như dương tính giả và âm tính giả để đánh giá hiệu suất và xác định các khoảng trống có thể bị che khuất bởi các chỉ số tổng quát.
OpenAI đã đảm bảo với cộng đồng rộng rãi rằng an toàn, quyền riêng tư và các vấn đề đạo đức là trọng tâm mục tiêu của họ. Các biện pháp giảm thiểu trong tiền huấn luyện cho DALL-E 2 bao gồm lọc bỏ hình ảnh bạo lực và khiêu dâm khỏi bộ dữ liệu huấn luyện, loại bỏ các hình ảnh có độ tương đồng thị giác cao, và sau đó huấn luyện mô hình để giảm thiểu tác động của việc lọc bộ dữ liệu.
Đạt được điều này mà không phải hy sinh điều kia đôi khi là bất khả thi. Điều này đúng khi cố gắng cân bằng giữa việc giảm thiên kiến trong LLM trong khi vẫn duy trì hoặc thậm chí cải thiện hiệu suất của mô hình. Khử thiên kiến cho mô hình là điều bắt buộc để đạt được công bằng. Tuy nhiên, hiệu suất và độ chính xác của mô hình không nên bị đánh đổi.
Cần triển khai một cách tiếp cận chiến lược để đảm bảo các phương pháp giảm thiểu thiên kiến như chọn lọc dữ liệu, tinh chỉnh mô hình và sử dụng đa phương pháp không ảnh hưởng đến khả năng hiểu và tạo đầu ra ngôn ngữ của mô hình. Cần có các cải tiến, nhưng hiệu suất của mô hình không nên là cái giá phải trả.
Đó là vấn đề của thử nghiệm và sai số, giám sát và điều chỉnh, khử thiên kiến và cải tiến.
Trong bài viết này, chúng tôi đã đề cập:
Thiên kiến trong LLM là một thách thức phức tạp và đa chiều cần được ưu tiên để xã hội có thêm niềm tin và chấp nhận việc tích hợp chúng vào các công việc hằng ngày. Các tổ chức cần hiểu tác động tiêu cực kéo dài mà các khuôn mẫu gây ra cho cá nhân và xã hội, và dùng điều đó để đảm bảo con đường giảm thiểu thiên kiến trong LLM thông qua chọn lọc dữ liệu, tinh chỉnh mô hình và mô hình hóa logic được thiết lập.
Để tìm hiểu thêm về LLM, hãy xem khóa học Khái niệm Mô hình Ngôn ngữ Lớn của chúng tôi, trình bày cách những công cụ mạnh mẽ này đang định hình lại bức tranh AI.
Bắt đầu hành trình AI của bạn ngay hôm nay!
Lộ trình
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
