Lernpfad
Grundlagen der KI
10 Std.
Wenn du die Tech-Welt verfolgst, bist du sicher schon über den Begriff „Large Language Models (LLMs)“ gestolpert. LLMs sind derzeit das Gesprächsthema der Branche, und ihre Bedeutung in der Welt der Künstlichen Intelligenz (KI) wächst täglich. Sie treiben die Revolution rund um generative KI voran, indem Modelle lernen, menschliche Sprache zu verarbeiten – etwa ChatGPT und Bard.
LLMs sind in der heutigen, sich schnell wandelnden Landschaft ein Schwergewicht, weil sie mithilfe fortgeschrittener Natural Language Processing (NLP) Systeme Gespräche in menschenähnlicher Qualität führen können. Doch wie jede Technologie haben auch KI-gestützte Assistenten Grenzen und spezifische Herausforderungen.
Eine dieser besonderen Herausforderungen ist das Risiko von Bias in LLMs – verankert in den Daten, mit denen die Modelle trainiert werden.
Fangen wir von vorne an. Was sind LLMs?
LLMs sind KI-Systeme wie ChatGPT, die dazu dienen, menschliche Sprache zu modellieren und zu verarbeiten. Es handelt sich um eine Art KI-Algorithmus, der Deep-Learning-Techniken nutzt, um Inhalte zusammenzufassen, zu generieren und vorherzusagen. „Large“ heißen sie, weil sie Millionen bis Milliarden Parameter umfassen und mit einem „großen“ Korpus an Textdaten trainiert werden.
LLMs und NLP gehen Hand in Hand: Ziel ist ein tiefes Verständnis für Sprache, Muster und Wissenserwerb auf Basis großer Datensätze.
Wenn du neu in der Welt der LLMs bist, empfehlen wir dir diesen Einstieg:
What is an LLM? A Guide on Large Language Models and How They Work. Oder absolviere unseren Large Language Models (LLMs) Concepts Course – perfekt, um LLMs praxisnah kennenzulernen.
LLMs kommen in zahlreichen KI-Anwendungen zum Einsatz. Ihre Beliebtheit steigt rasant, und Unternehmen prüfen, wie sie LLMs in bestehende Systeme und Tools integrieren können, um Workflows produktiver zu machen.
Typische Einsatzfelder von LLMs sind:
LLMs nutzen Transformer-Modelle – eine Deep-Learning-Architektur, die durch die Analyse sequentieller Daten Kontext erlernt und versteht.
Tokenisierung bedeutet, dass Eingabetext in kleinere Einheiten (Tokens) zerlegt wird, die das Modell dann mithilfe mathematischer Verfahren analysiert, um Beziehungen zwischen Tokens aufzudecken. Dabei arbeitet das Modell probabilistisch und sagt in der Trainingsphase die nächste Wortsequenz voraus.
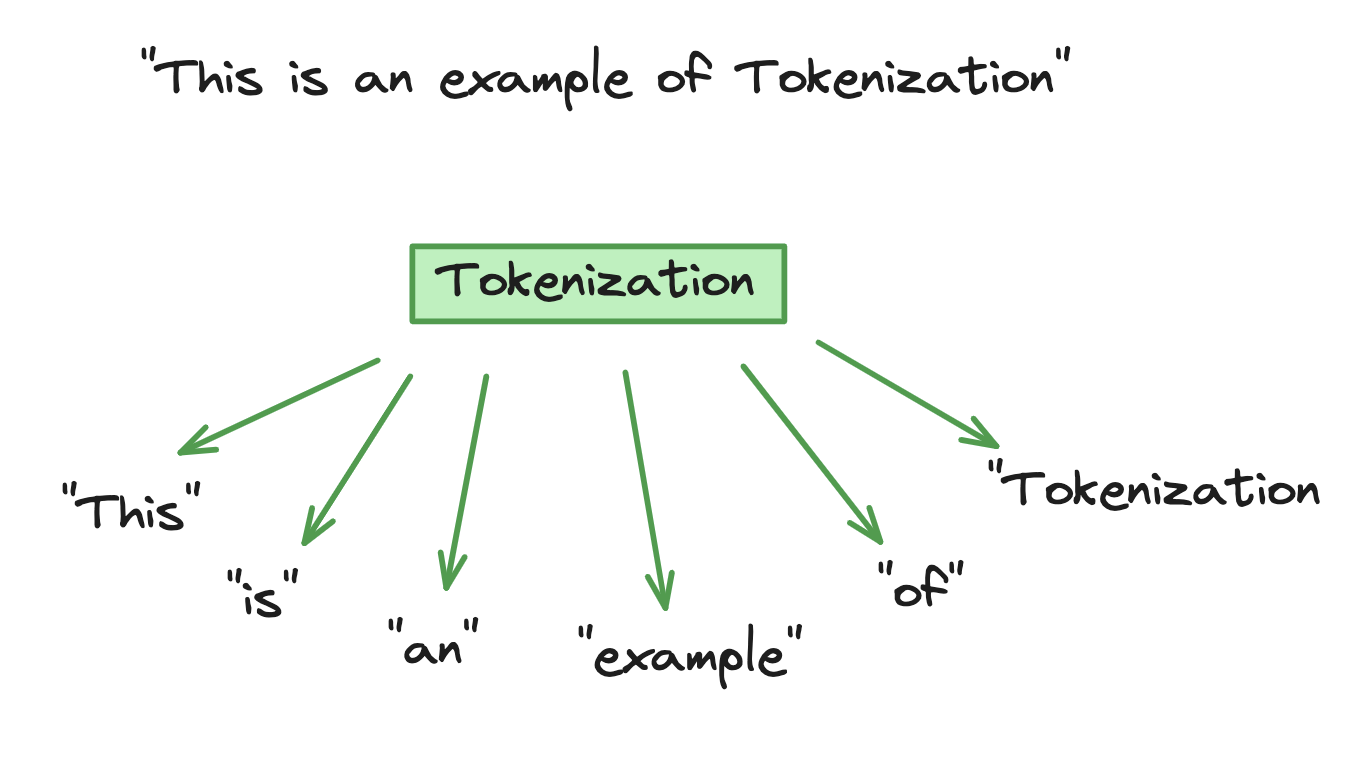
Beispiel für Tokenisierung
In der Trainingsphase wird das Modell mit riesigen Mengen an Textdaten gefüttert, um unterschiedliche sprachliche Kontexte, Nuancen und Stile zu erfassen. So entsteht eine Wissensbasis, mit der LLMs menschliche Sprache wirkungsvoll nachbilden können.
Die Vielseitigkeit und das Sprachverständnis von LLMs belegen ihre fortgeschrittenen KI-Fähigkeiten. Das Training auf umfangreichen Datensätzen verschiedenster Genres und Stile – von juristischen Texten bis zu fiktionalen Erzählungen – ermöglicht es ihnen, sich an unterschiedliche Szenarien und Kontexte anzupassen.
Doch die Vielseitigkeit geht über reine Textvorhersage hinaus. Aufgaben in verschiedenen Sprachen, Kontexten und Ausgabeformaten zu bewältigen, zeigt sich in Anwendungen wie dem Kundenservice. Das verdanken LLMs dem umfangreichen Training auf domänenspezifischen Datensätzen sowie dem anschließenden Fine-Tuning, das ihre Wirksamkeit in vielen Bereichen steigert.
Dennoch dürfen wir die besondere Herausforderung von LLMs nicht vergessen: Bias.
LLMs werden aus zahlreichen, vielfältigen Quellen trainiert. Das Modell nutzt diese Daten als zentrale Wissensbasis und interpretiert sie als Fakten. Sind die Daten jedoch von Verzerrungen oder Fehlinformationen geprägt, werden sich diese Biases in den Ausgaben des LLM niederschlagen.
Ein eigentlich produktivitätssteigerndes Werkzeug, das uns im Alltag unterstützen soll, wirft damit ethische Fragen auf. Mehr zu den ethischen Aspekten von KI erfährst du in unserem Kurs.
Viel hilft viel – aber nur, wenn die Daten repräsentativ sind. Enthalten Trainingsdaten für LLMs verzerrte oder nicht repräsentative Beispiele, wird das Modell diese Verzerrungen übernehmen. Typische Bias-Formen sind Geschlechter-, Rassen- und Kultur-Bias.
Ein Beispiel: Wenn ein Großteil der Daten Frauen überwiegend als Reinigungskräfte oder Pflegerinnen und Männer als Ingenieure oder CEOs darstellt, übernimmt das LLM gesellschaftliche Stereotype aus seinen Trainingsdaten. Ein weiteres Beispiel ist Rassismus-Bias, bei dem ethnische Gruppen stereotypisiert werden, sowie Kultur-Bias durch Überrepräsentation bestimmter Darstellungen.
Zwei zentrale Ursachen für Bias in LLMs sind:
So vielseitig LLMs auch sind: Bei multikulturellen Inhalten stoßen sie oft an Grenzen. Besonders kritisch wird es, wenn LLMs in Entscheidungsprozesse einfließen – dann stellen sich unweigerlich ethische Fragen.
Bias in LLMs betrifft sowohl die Nutzerinnen und Nutzer der Modelle als auch die Gesellschaft insgesamt.
Wie oben beschrieben, gibt es unterschiedliche Stereotype, etwa kulturelle oder geschlechtsspezifische. Verzerrungen in Trainingsdaten verfestigen solche schädlichen Stereotype, halten Vorurteile am Leben und bremsen gesellschaftlichen Fortschritt aus.
Solange LLMs voreingenommene Daten verarbeiten, fördern sie kulturelle Spaltung und Ungleichheit der Geschlechter.
Diskriminierung ist die ungerechte Behandlung von Menschen aufgrund von Geschlecht, ethnischer Zugehörigkeit, Alter oder Behinderung. Trainingsdaten können stark unterrepräsentativ sein und Gruppen verzerrt abbilden.
Wenn LLM-Ausgaben Vorurteile reproduzieren – etwa zu Rasse, Geschlecht oder Alter – hat das reale Folgen im Alltag marginalisierter Gruppen, von der Personalauswahl bis zu Bildungschancen. So fehlen Diversität und Inklusion in den Ausgaben, was ethische Sorgen verstärkt, insbesondere wenn diese Ergebnisse in Entscheidungen einfließen.
Wenn Trainingsdaten unrepräsentativ oder verzerrt sind, stellt sich auch die Frage nach ihrer inhaltlichen Korrektheit. Die Verbreitung von Fehl- oder Desinformation über LLMs kann gravierende Konsequenzen haben.
Beispielsweise können im Gesundheitswesen verzerrte Informationen gefährliche Entscheidungen nach sich ziehen. Oder politisch gefärbte Trainingsdaten können zu Desinformation im politischen Kontext führen.
Ethische Bedenken sind nicht der einzige Grund, warum Teile der Gesellschaft KI-Systemen skeptisch gegenüberstehen. Viele sorgen sich um Jobverluste oder wirtschaftliche Instabilität.
Das Vertrauen in KI-Systeme ist ohnehin fragil. Verzerrte Ausgaben von LLMs können es vollends untergraben. Damit LLM-Technologie breite Akzeptanz findet, braucht es Vertrauen.
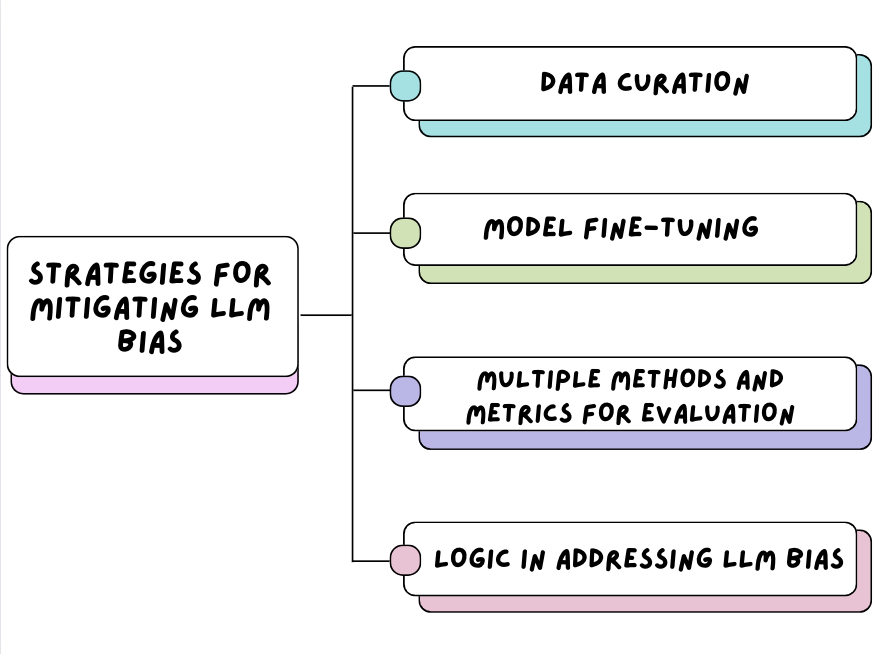
Strategien zur Minderung von LLM-Bias
Beginnen wir bei den Daten. Unternehmen tragen eine hohe Verantwortung für die Auswahl dessen, was in ihre Modelle einfließt.
Wichtig ist, dass die Trainingsdaten aus vielfältigen Quellen kuratiert werden. Textdatensätze aus unterschiedlichen Demografien, Sprachen und Kulturen sorgen für eine ausgewogene Abbildung menschlicher Sprache. So werden Unterrepräsentationen vermieden und zielgerichtetes Fine-Tuning erleichtert – mit dem Ergebnis, dass Bias in der breiten Nutzung weniger stark durchschlägt.
Sind unterschiedliche Datenquellen zusammengetragen und ins Modell eingespeist, lässt sich Genauigkeit weiter steigern und Bias reduzieren – durch gezieltes Fine-Tuning. Mögliche Ansätze sind:
Mehr zum Fine-Tuning erfährst du in unserem Fine-Tuning LLaMA 2 Tutorial mit Schritt-für-Schritt-Anleitung zum Anpassen eines vortrainierten Modells.
Damit KI-Systeme sicher in den Alltag integriert werden können, sollten Organisationen verschiedene Evaluationsmethoden und -metriken einsetzen. Bevor LLMs breit ausgerollt werden, müssen geeignete Verfahren implementiert sein, um unterschiedliche Dimensionen von Bias in den Ausgaben zu erfassen.
Beispiele für Methoden sind Humanevaluation, automatische Evaluation oder hybride Ansätze. Sie dienen dazu, Bias zu erkennen, zu schätzen oder herauszufiltern. Wichtige Metriken sind etwa Genauigkeit, Sentiment, Fairness und mehr. So lassen sich Verzerrungen systematisch bewerten und kontinuierlich reduzieren.
Wenn du mehr über Evaluationsansätze zur Qualitätssteigerung von LLMs erfahren möchtest, sieh dir unser Code-Along zu Evaluating LLM Responses an.
Eine Studie aus dem Computer Science and Artificial Intelligence Laboratory (CSAIL) des MIT zeigt Fortschritte bei LLMs durch die Integration logischen Schließens: Large language models are biased. Can logic help save them?
Logisches und strukturiertes Denken in LLMs hilft, Ausgaben mit nachvollziehbarer Begründung zu erzeugen – das verbessert Genauigkeit und Nachvollziehbarkeit.
Der Ansatz: Ein „neutrales“ Sprachmodell, bei dem Beziehungen zwischen Tokens zunächst als „neutral“ gelten, solange keine logische Verbindung belegt ist. CSAIL trainierte diese Methode auf einem Sprachmodell und stellte fest: Das neue Modell war weniger voreingenommen – ohne zusätzliche Daten oder weiteres Algorithmustraining.
Logikbewusste Sprachmodelle können schädliche Stereotype eher vermeiden.
Google Research verbessert sein LLM BERT kontinuierlich, indem die Trainingsdaten breiter, inklusiver und diverser werden. Große Datensätze mit unannotiertem Text für die Vortrainingsphase ermöglichen späteres Fine-Tuning für spezifische Aufgaben. Ziel ist ein weniger verzerrtes, robusteres Modell. Laut Google Research reduziert dieser Ansatz stereotype Ausgaben und verbessert das Verständnis verschiedener Dialekte und kultureller Kontexte.
Das Team von Google Research hat Tools entwickelt, die sich „Fairness Indicators“ nennen. Sie helfen, Bias in Machine-Learning-Modellen zu erkennen und zu mindern. Mithilfe von Kennzahlen wie False Positives und False Negatives wird die Performance bewertet und Lücken aufgedeckt, die in aggregierten Metriken verborgen bleiben könnten.
OpenAI betont gegenüber der Community, dass Sicherheit, Datenschutz und Ethik zentrale Ziele sind. Zu den Pre-Training-Maßnahmen für DALL-E 2 gehörten das Herausfiltern gewalttätiger und sexueller Inhalte aus dem Trainingsdatensatz, das Entfernen visuell sehr ähnlicher Bilder und das anschließende Training des Modells, um die Effekte des Filterns auszugleichen.
Beides gleichzeitig zu erreichen, ist oft eine Gratwanderung: Bias reduzieren und gleichzeitig die Modellleistung erhalten oder sogar verbessern. Debiasing ist entscheidend für Fairness, darf aber Genauigkeit und Leistung nicht untergraben.
Es braucht eine durchdachte Strategie, damit Maßnahmen wie Datenkuratierung, Fine-Tuning und vielseitige Evaluation die Sprachkompetenz und Generierungsqualität nicht beeinträchtigen. Verbesserungen sind nötig – ohne dass Performance zum Opfer wird.
Letztlich ist es ein Prozess aus Ausprobieren und Lernen, Monitoring und Anpassung, Entzerrung und Optimierung.
In diesem Artikel hast du erfahren:
LLM-Bias ist eine komplexe, vielschichtige Herausforderung, die Priorität haben muss, damit die Gesellschaft mehr Vertrauen fasst und die Integration in den Alltag gelingen kann. Organisationen müssen die langfristigen negativen Effekte von Stereotypen verstehen und diesen Weg nutzen, um über Datenkuratierung, Fine-Tuning und logische Modellierung wirksame Maßnahmen gegen Bias zu etablieren.
Wenn du mehr über LLMs lernen möchtest, schau dir unseren Kurs Large Language Models Concepts an – er zeigt, wie diese leistungsstarken Tools die KI-Landschaft verändern.
Starte heute deine KI-Reise!
Lernpfad
Kurs
Kurs