20 世纪 50 年代初,富有远见的数学家和计算机科学家 Richard Bellman 着手破解不确定环境中的决策复杂性。出于对高效求解方法的需求,他提出了革命性的动态规划理念,将错综复杂的问题分解为可管理的子问题。
在探索这一方法的过程中,Bellman 提出了后来被称为贝尔曼方程的理论: 一种根据潜在的未来状态及其相关奖励来评估在给定状态下决策价值的数学表达式。 他的开创性工作最终汇集于 1957 年出版的著作 Dynamic Programming(动态规划),为最优化与控制理论奠定了理论基础,并为人工智能与强化学习的发展铺平了道路。
如今,Bellman 的思想持续塑造着机器如何学习并适应其环境,在数学与计算机科学领域留下了深远影响。在强化学习中,贝尔曼方程对于理解智能体如何与环境交互至关重要,是求解马尔可夫决策过程(MDP)中各类问题的基础。
本文将探讨这一方程是什么、与贝尔曼最优性方程的比较、其在强化学习中的用法等内容。
什么是贝尔曼方程?
贝尔曼方程是一种用于决策与强化学习的递归公式。它表明处于某一状态的价值取决于所获得的奖励以及未来状态的价值。
简单来说,贝尔曼方程将复杂问题分解为更小的步骤,从而更易求解。当结果取决于一系列动作时,该方程有助于找到最佳决策方式。
从数学上,贝尔曼方程写作:
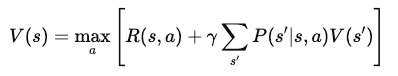
其中:
- V(s):状态 sss 的价值,即处于该状态的长期回报。
- R(s,a):在状态 sss 采取动作 aaa 所获得的即时奖励。
- γ:折扣因子(介于 0 和 1 之间),用于衡量未来奖励相对于即时奖励的重要性。
- P(s′∣s,a) 从状态 sss 采取动作 a 转移到状态 s′ 的概率。
- maxa:使未来奖励期望值最大化的最优动作。
该求和将每个可能的下一个状态的价值与到达该状态的概率相乘,从而有效地刻画了期望的未来回报。
贝尔曼方程 vs. 贝尔曼最优性方程
贝尔曼方程根据采取动作所获得的奖励以及未来状态的期望价值来计算某一状态的价值。它是评估智能体在环境中遵循某一策略时该策略优劣的关键组成部分。该方程考察所有可能的动作与结果,帮助确定处于某一状态的价值。
相比之下,贝尔曼最优性方程用于在目标是寻找最佳(“最优”)策略时。
它并非仅根据某一特定策略来评估状态的价值,而是通过考虑所有可能的动作与策略来寻找可达到的最大价值。最优性方程通过在每个状态下对所有可用动作取最大期望回报来实现这一点。由此,它告诉我们在每个状态中若以最佳方式行动,所能获得的最高可能价值。
换言之,这两类方程的主要区别在于关注点不同。
标准的贝尔曼方程通过估计遵循某一策略的期望价值来评估该策略的有效性。另一方面,贝尔曼最优性方程旨在通过识别每个状态中能带来最大发电长回报的动作来寻找全局最优策略。
TLDR:标准贝尔曼方程用于策略评估,而最优性方程用于策略改进与控制。
贝尔曼最优性方程对于求解控制问题至关重要,其目标是在最大化回报的前提下选择最佳的动作序列。在此类问题中,智能体既要最大化即时回报,也要兼顾未来回报。
最优性方程提供了一种系统化的方法来评估并选择能带来最高长期回报的动作,从而帮助找到最优策略。它是诸如Q-learning 与价值迭代等算法的核心,这些算法用于训练强化学习智能体以尽可能最佳的方式行动。
强化学习中的贝尔曼方程
贝尔曼方程是强化学习的核心组成部分。它通过将复杂任务拆分为更小的步骤,帮助智能体学会如何做出最佳决策。
具体而言,贝尔曼方程使智能体能够计算不同状态与动作的价值,从而指导其选择最大化回报的最佳路径。
因此,在强化学习中,贝尔曼方程用于评估与改进策略,确保智能体在积累经验的过程中做出更佳决策。
在 Q-learning 中的作用
Q-learning 是一种流行的强化学习算法。该算法利用贝尔曼方程来估计状态-动作对的价值,即 Q 值。这些数值告诉智能体:在给定状态下采取某一动作并随后遵循最优策略,将会多有回报。
Q-learning 的贝尔曼最优性方程在每个动作上寻找最大期望价值,帮助智能体识别能最大化长期回报的最佳行动。
例如,在一个分幕式强化学习问题中,设想一个智能体在网格世界中导航。当它到达某一状态时,会使用以下方程来更新该状态-动作对的 Q 值:
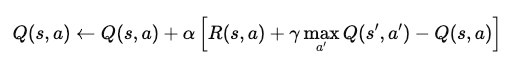
其中:
- Q(s,a):在状态 s 下采取动作 a 的 Q 值。
- α:学习率,决定新信息覆盖旧 Q 值的程度。
- R(s,a):在状态 s 下采取动作 a 后获得的即时奖励。
- γ:折扣因子,用于衡量未来奖励相对于即时奖励的权重。
- maxa′Q(s′,a′):在下一个状态 s′ 下,针对所有可能动作 a′ 的最大 Q 值。
该方程根据即时奖励与最大期望未来回报来更新 Q 值。通过反复应用,智能体逐步逼近最优 Q 值,并据此确定最大化长期回报的最佳行动。
用于策略评估的贝尔曼方程
贝尔曼方程也用于通过估计价值函数来评估策略。在该语境下,它计算智能体从特定状态出发、遵循给定策略时的期望长期回报。这有助于判断策略的有效性,即展示智能体可期望获得的平均回报。
策略迭代算法利用这种评估来改进策略。它先估计某一策略的价值函数,然后基于该价值更新策略以选择更优动作。该过程反复进行,直到策略收敛到最优策略,此时已无法进一步改进。
贝尔曼方程的推导
本节将从第一性原理出发,逐步拆解贝尔曼方程。随后我们将探讨奖励与转移如何构建价值函数,从而引导智能体选择最佳动作。
逐步推导
要推导贝尔曼方程,我们从价值函数的概念出发。价值函数 V(s)V(s)V(s) 给出从状态 sss 出发并随后遵循最优策略时的期望累积回报。该方程具有递归性,即把某一状态的价值与后续状态的价值联系起来。
1. 定义价值函数
价值函数 V(s) 表示智能体从状态 sss 出发并遵循最优策略所能获得的期望总回报。数学上可表示为:
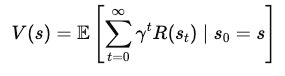
其中:
- s 为当前状态,
- γ 为折扣因子(介于 0 和 1 之间),用于控制未来奖励的重要性,
- R(st) 为每个时间步 t 所获得的奖励。
2. 拆分未来回报
为了用即时奖励和未来状态的价值来表示 V(s),我们将第一个奖励从所有未来奖励的求和中分离出来:
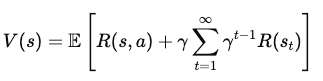
其中:
- R(s, a) 为在状态 s 下采取动作 a 所获得的即时奖励,
- γ Σ (γ(t1)) R(st) 表示未来奖励的折扣求和。
3. 引入下一状态的价值
现在加入智能体在状态 s 下采取动作 a 后到达的下一状态 s' 的价值,得到:
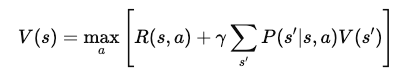
其中:
- P(s' | s, a) 表示从状态 s 采取动作 a 后转移到状态 s' 的概率,
- maxa 表示选择使期望回报最大的动作 a。
4. 最终的贝尔曼方程
简化后,价值函数 V(s) 的贝尔曼方程变为:
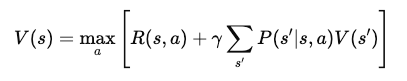
该最终形式将状态的价值分解为两个部分:即时奖励与下一状态的期望价值。借助这种递归结构,算法可以迭代计算或近似 V(s),从而随着时间推移找到最优策略。
示例与应用
让我们通过一个简单的网格世界示例来说明:
设想一个智能体试图在网格上到达目标并避开障碍。智能体可向上、下、左、右移动,并为每一步获得相应奖励。若到达目标,则获得更高奖励。利用贝尔曼方程,我们可以通过评估即时奖励与未来状态价值来计算网格上各状态的价值。
对于马尔可夫决策过程(MDP),贝尔曼方程有助于找到最优策略。若我们有一个小型 MDP,例如一个智能体需选择最快路线的配送问题,我们对每个状态-动作对应用该方程。如此便可计算出能最大化总期望回报的最佳动作。
进阶主题:Q-learning 中的贝尔曼方程
本节将探讨贝尔曼方程在以下进阶方法中的应用:
- 价值迭代
- 时序差分(Temporal-Difference)学习。
这些技术通过不断更新价值估计,帮助智能体即使在复杂环境中也能学得最优动作。理解这些进阶主题是掌握强化学习的关键。
价值迭代
价值迭代是一种使用贝尔曼方程迭代更新价值函数的方法。其目标是在每个状态上找到最优价值,以便智能体据此确定最佳动作。
在价值迭代中,智能体基于可能的未来状态及其奖励来更新各状态的价值。该过程反复进行,直到数值收敛到稳定解。价值迭代的收敛性确保在给定足够时间的前提下,它将找到最优策略。
时序差分学习
TD 学习是另一种利用贝尔曼方程的方法,但有一处关键差异——它不需要环境模型。
它根据智能体实际收集到的经验来更新价值估计,因此在环境未知时更具实用性。TD 学习弥合了依赖完整回合的蒙特卡洛方法与需要完整模型的动态规划之间的差距。
应用与使用场景
贝尔曼方程的应用远不止于理论模型。在需要决策与优化的真实世界场景中,它发挥着关键作用。本节将探讨贝尔曼方程如何支撑这些应用。
游戏中的强化学习
在 Atari 等经典游戏环境中,贝尔曼方程帮助优化智能体动作以取得最高得分。该方程通过评估每个动作的期望回报来指导智能体选择最佳操作。
现实案例包括使用深度强化学习算法(如深度 Q 网络,DQN)借助贝尔曼方程提升游戏 AI 的表现。这些方法已被用于训练在多种游戏中超越人类玩家的智能体,展现了强化学习的强大威力。
机器人与导航
在机器人领域,贝尔曼方程帮助机器作出移动与导航决策。机器人利用它评估不同路径,并选择能最大化未来回报的那条路径,例如用最短时间或最少能耗到达目标。
换句话说,机器人使用贝尔曼方程来基于当前状态预测结果,并据此规划下一步行动。该决策过程对于在动态环境中穿越迷宫或避开障碍至关重要。
结语
贝尔曼方程在智能系统的研发中具有基础性地位——尤其是在强化学习与人工智能的其他领域。它为系统在动态环境中学习、适应与优化行动的算法提供了基石,从而在不确定环境中实现更高效、更有效的求解。
以下资源可助您继续学习:


20 世纪 50 年代初,富有远见的数学家和计算机科学家 Richard Bellman 着手破解不确定环境中的决策复杂性。出于对高效求解方法的需求,他提出了革命性的动态规划理念,将错综复杂的问题分解为可管理的子问题。
在探索这一方法的过程中,Bellman 提出了后来被称为贝尔曼方程的理论: 一种根据潜在的未来状态及其相关奖励来评估在给定状态下决策价值的数学表达式。 他的开创性工作最终汇集于 1957 年出版的著作 Dynamic Programming(动态规划),为最优化与控制理论奠定了理论基础,并为人工智能与强化学习的发展铺平了道路。
如今,Bellman 的思想持续塑造着机器如何学习并适应其环境,在数学与计算机科学领域留下了深远影响。在强化学习中,贝尔曼方程对于理解智能体如何与环境交互至关重要,是求解马尔可夫决策过程(MDP)中各类问题的基础。
本文将探讨这一方程是什么、与贝尔曼最优性方程的比较、其在强化学习中的用法等内容。
什么是贝尔曼方程?
贝尔曼方程是一种用于决策与强化学习的递归公式。它表明处于某一状态的价值取决于所获得的奖励以及未来状态的价值。
简单来说,贝尔曼方程将复杂问题分解为更小的步骤,从而更易求解。当结果取决于一系列动作时,该方程有助于找到最佳决策方式。
从数学上,贝尔曼方程写作:
其中:
该求和将每个可能的下一个状态的价值与到达该状态的概率相乘,从而有效地刻画了期望的未来回报。
贝尔曼方程 vs. 贝尔曼最优性方程
贝尔曼方程根据采取动作所获得的奖励以及未来状态的期望价值来计算某一状态的价值。它是评估智能体在环境中遵循某一策略时该策略优劣的关键组成部分。该方程考察所有可能的动作与结果,帮助确定处于某一状态的价值。
相比之下,贝尔曼最优性方程用于在目标是寻找最佳(“最优”)策略时。
它并非仅根据某一特定策略来评估状态的价值,而是通过考虑所有可能的动作与策略来寻找可达到的最大价值。最优性方程通过在每个状态下对所有可用动作取最大期望回报来实现这一点。由此,它告诉我们在每个状态中若以最佳方式行动,所能获得的最高可能价值。
换言之,这两类方程的主要区别在于关注点不同。
标准的贝尔曼方程通过估计遵循某一策略的期望价值来评估该策略的有效性。另一方面,贝尔曼最优性方程旨在通过识别每个状态中能带来最大发电长回报的动作来寻找全局最优策略。
TLDR:标准贝尔曼方程用于策略评估,而最优性方程用于策略改进与控制。
贝尔曼最优性方程对于求解控制问题至关重要,其目标是在最大化回报的前提下选择最佳的动作序列。在此类问题中,智能体既要最大化即时回报,也要兼顾未来回报。
最优性方程提供了一种系统化的方法来评估并选择能带来最高长期回报的动作,从而帮助找到最优策略。它是诸如Q-learning 与价值迭代等算法的核心,这些算法用于训练强化学习智能体以尽可能最佳的方式行动。
强化学习中的贝尔曼方程
贝尔曼方程是强化学习的核心组成部分。它通过将复杂任务拆分为更小的步骤,帮助智能体学会如何做出最佳决策。
具体而言,贝尔曼方程使智能体能够计算不同状态与动作的价值,从而指导其选择最大化回报的最佳路径。
因此,在强化学习中,贝尔曼方程用于评估与改进策略,确保智能体在积累经验的过程中做出更佳决策。
在 Q-learning 中的作用
Q-learning 是一种流行的强化学习算法。该算法利用贝尔曼方程来估计状态-动作对的价值,即 Q 值。这些数值告诉智能体:在给定状态下采取某一动作并随后遵循最优策略,将会多有回报。
Q-learning 的贝尔曼最优性方程在每个动作上寻找最大期望价值,帮助智能体识别能最大化长期回报的最佳行动。
例如,在一个分幕式强化学习问题中,设想一个智能体在网格世界中导航。当它到达某一状态时,会使用以下方程来更新该状态-动作对的 Q 值:
其中:
该方程根据即时奖励与最大期望未来回报来更新 Q 值。通过反复应用,智能体逐步逼近最优 Q 值,并据此确定最大化长期回报的最佳行动。
用于策略评估的贝尔曼方程
贝尔曼方程也用于通过估计价值函数来评估策略。在该语境下,它计算智能体从特定状态出发、遵循给定策略时的期望长期回报。这有助于判断策略的有效性,即展示智能体可期望获得的平均回报。
策略迭代算法利用这种评估来改进策略。它先估计某一策略的价值函数,然后基于该价值更新策略以选择更优动作。该过程反复进行,直到策略收敛到最优策略,此时已无法进一步改进。
贝尔曼方程的推导
本节将从第一性原理出发,逐步拆解贝尔曼方程。随后我们将探讨奖励与转移如何构建价值函数,从而引导智能体选择最佳动作。
逐步推导
要推导贝尔曼方程,我们从价值函数的概念出发。价值函数 V(s)V(s)V(s) 给出从状态 sss 出发并随后遵循最优策略时的期望累积回报。该方程具有递归性,即把某一状态的价值与后续状态的价值联系起来。
1. 定义价值函数
价值函数 V(s) 表示智能体从状态 sss 出发并遵循最优策略所能获得的期望总回报。数学上可表示为:
其中:
2. 拆分未来回报
为了用即时奖励和未来状态的价值来表示 V(s),我们将第一个奖励从所有未来奖励的求和中分离出来:
其中:
3. 引入下一状态的价值
现在加入智能体在状态 s 下采取动作 a 后到达的下一状态 s' 的价值,得到:
其中:
4. 最终的贝尔曼方程
简化后,价值函数 V(s) 的贝尔曼方程变为:
该最终形式将状态的价值分解为两个部分:即时奖励与下一状态的期望价值。借助这种递归结构,算法可以迭代计算或近似 V(s),从而随着时间推移找到最优策略。
示例与应用
让我们通过一个简单的网格世界示例来说明:
设想一个智能体试图在网格上到达目标并避开障碍。智能体可向上、下、左、右移动,并为每一步获得相应奖励。若到达目标,则获得更高奖励。利用贝尔曼方程,我们可以通过评估即时奖励与未来状态价值来计算网格上各状态的价值。
对于马尔可夫决策过程(MDP),贝尔曼方程有助于找到最优策略。若我们有一个小型 MDP,例如一个智能体需选择最快路线的配送问题,我们对每个状态-动作对应用该方程。如此便可计算出能最大化总期望回报的最佳动作。
进阶主题:Q-learning 中的贝尔曼方程
本节将探讨贝尔曼方程在以下进阶方法中的应用:
这些技术通过不断更新价值估计,帮助智能体即使在复杂环境中也能学得最优动作。理解这些进阶主题是掌握强化学习的关键。
价值迭代
价值迭代是一种使用贝尔曼方程迭代更新价值函数的方法。其目标是在每个状态上找到最优价值,以便智能体据此确定最佳动作。
在价值迭代中,智能体基于可能的未来状态及其奖励来更新各状态的价值。该过程反复进行,直到数值收敛到稳定解。价值迭代的收敛性确保在给定足够时间的前提下,它将找到最优策略。
时序差分学习
TD 学习是另一种利用贝尔曼方程的方法,但有一处关键差异——它不需要环境模型。
它根据智能体实际收集到的经验来更新价值估计,因此在环境未知时更具实用性。TD 学习弥合了依赖完整回合的蒙特卡洛方法与需要完整模型的动态规划之间的差距。
应用与使用场景
贝尔曼方程的应用远不止于理论模型。在需要决策与优化的真实世界场景中,它发挥着关键作用。本节将探讨贝尔曼方程如何支撑这些应用。
游戏中的强化学习
在 Atari 等经典游戏环境中,贝尔曼方程帮助优化智能体动作以取得最高得分。该方程通过评估每个动作的期望回报来指导智能体选择最佳操作。
现实案例包括使用深度强化学习算法(如深度 Q 网络,DQN)借助贝尔曼方程提升游戏 AI 的表现。这些方法已被用于训练在多种游戏中超越人类玩家的智能体,展现了强化学习的强大威力。
机器人与导航
在机器人领域,贝尔曼方程帮助机器作出移动与导航决策。机器人利用它评估不同路径,并选择能最大化未来回报的那条路径,例如用最短时间或最少能耗到达目标。
换句话说,机器人使用贝尔曼方程来基于当前状态预测结果,并据此规划下一步行动。该决策过程对于在动态环境中穿越迷宫或避开障碍至关重要。
结语
贝尔曼方程在智能系统的研发中具有基础性地位——尤其是在强化学习与人工智能的其他领域。它为系统在动态环境中学习、适应与优化行动的算法提供了基石,从而在不确定环境中实现更高效、更有效的求解。
以下资源可助您继续学习: