Pada awal 1950-an, Richard Bellman, seorang matematikawan dan ilmuwan komputer visioner, memulai perjalanan untuk mengurai kompleksitas pengambilan keputusan dalam lingkungan yang tidak pasti. Didorong oleh kebutuhan akan metode pemecahan masalah yang efisien, ia memperkenalkan konsep revolusioner pemrograman dinamis, yang memecah masalah rumit menjadi submasalah yang dapat dikelola.
Saat mengeksplorasi pendekatan ini, Bellman merumuskan apa yang kemudian dikenal sebagai Persamaan Bellman: sebuah ekspresi matematis yang mengevaluasi nilai suatu keputusan dalam keadaan tertentu berdasarkan potensi keadaan masa depan dan imbalan yang terkait dengannya. Karya terobosannya berpuncak pada penerbitan bukunya tahun 1957, Dynamic Programming, yang meletakkan dasar teoretis bagi teori optimisasi dan kendali sekaligus membuka jalan bagi kemajuan dalam kecerdasan buatan dan reinforcement learning.
Saat ini, gagasan Bellman terus membentuk cara mesin belajar dan beradaptasi dengan lingkungannya, meninggalkan warisan yang langgeng dalam matematika dan ilmu komputer. Dalam reinforcement learning, Persamaan Bellman sangat penting untuk memahami bagaimana agen berinteraksi dengan sekelilingnya, sehingga menjadi esensial untuk menyelesaikan berbagai masalah dalam Markov Decision Processes (MDP).
Dalam artikel ini, kita akan membahas apa itu persamaan tersebut, bagaimana perbandingannya dengan Persamaan Optimalitas Bellman, bagaimana penggunaannya dalam reinforcement learning, dan lainnya.
Apa itu Persamaan Bellman?
Persamaan Bellman adalah formula rekursif yang digunakan dalam pengambilan keputusan dan reinforcement learning. Persamaan ini menunjukkan bagaimana nilai berada dalam keadaan tertentu bergantung pada imbalan yang diterima dan nilai keadaan masa depan.
Secara sederhana, Persamaan Bellman memecah masalah kompleks menjadi langkah-langkah yang lebih kecil, sehingga lebih mudah diselesaikan. Persamaan ini membantu menemukan cara terbaik untuk mengambil keputusan ketika hasil bergantung pada rangkaian tindakan.
Secara matematis, Persamaan Bellman ditulis sebagai:
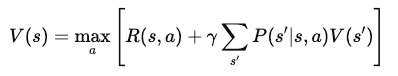
Dengan:
- V(s): Nilai keadaan sss, yang merepresentasikan imbalan jangka panjang dari berada pada keadaan tersebut.
- R(s,a): Imbalan langsung yang diterima saat mengambil tindakan aaa pada keadaan sss.
- γ: Faktor diskonto (antara 0 dan 1) yang menentukan pentingnya imbalan masa depan dibandingkan imbalan langsung.
- P(s′∣s,a) Probabilitas bertransisi ke keadaan s′ dari keadaan sss dengan mengambil tindakan a.
- maxa: Tindakan optimal yang memaksimalkan nilai harapan dari imbalan masa depan.
Jumlah ini mengalikan nilai setiap kemungkinan keadaan berikutnya dengan probabilitas mencapainya, sehingga secara efektif menangkap imbalan masa depan yang diharapkan.
Persamaan Bellman vs. Persamaan Optimalitas Bellman
Persamaan Bellman menghitung nilai suatu keadaan berdasarkan imbalan dari mengambil tindakan dan nilai harapan dari keadaan masa depan. Ini adalah bagian kunci dalam mengevaluasi seberapa baik suatu kebijakan ketika diikuti oleh agen dalam suatu lingkungan. Persamaan ini melihat semua kemungkinan tindakan dan hasilnya serta membantu menentukan nilai berada pada keadaan tertentu.
Sebaliknya, Persamaan Optimalitas Bellman digunakan saat tujuannya adalah menemukan kebijakan yang terbaik atau "optimal".
Alih-alih hanya mengevaluasi nilai suatu keadaan berdasarkan kebijakan tertentu, persamaan ini mencari nilai maksimum yang dapat dicapai dengan mempertimbangkan semua kemungkinan tindakan dan kebijakan. Persamaan Optimalitas Bellman melakukannya dengan mengambil imbalan harapan maksimum atas semua tindakan yang tersedia di setiap keadaan. Dengan cara ini, persamaan tersebut memberi tahu kita nilai tertinggi yang dapat diperoleh dari setiap keadaan jika kita bertindak sebaik mungkin.
Dengan kata lain, perbedaan utama antara kedua persamaan tersebut terletak pada fokusnya.
Persamaan Bellman standar mengevaluasi efektivitas suatu kebijakan dengan memperkirakan nilai harapan saat mengikutinya. Di sisi lain, Persamaan Optimalitas Bellman bertujuan menemukan kebijakan terbaik secara keseluruhan dengan mengidentifikasi tindakan yang memberikan imbalan jangka panjang maksimum di setiap keadaan.
TLDR: Persamaan Bellman standar digunakan untuk evaluasi kebijakan, sedangkan persamaan optimalitas digunakan untuk peningkatan kebijakan dan kendali.
Persamaan Optimalitas Bellman sangat penting untuk menyelesaikan masalah kendali, di mana tujuannya adalah memilih urutan tindakan terbaik untuk memaksimalkan imbalan. Dalam masalah ini, agen harus membuat keputusan yang tidak hanya memaksimalkan imbalan langsung tetapi juga mempertimbangkan imbalan masa depan.
Persamaan optimalitas menyediakan cara untuk secara sistematis mengevaluasi dan memilih tindakan yang menghasilkan imbalan jangka panjang tertinggi, membantu menemukan kebijakan optimal. Ini merupakan bagian sentral dari algoritma seperti Q-learning dan value iteration, yang digunakan dalam reinforcement learning untuk melatih agen bertindak seoptimal mungkin.
Persamaan Bellman dalam Reinforcement Learning
Persamaan Bellman adalah bagian inti dari reinforcement learning. Persamaan ini membantu agen belajar bagaimana membuat keputusan terbaik dengan memecah tugas kompleks menjadi langkah-langkah yang lebih kecil.
Secara khusus, Persamaan Bellman memungkinkan agen menghitung nilai berbagai keadaan dan tindakan, yang menuntun mereka memilih jalur terbaik untuk memaksimalkan imbalan.
Dengan demikian, dalam reinforcement learning, Persamaan Bellman digunakan untuk mengevaluasi dan meningkatkan kebijakan, memastikan agen membuat keputusan yang lebih baik seiring bertambahnya pengalaman.
Peran dalam Q-Learning
Q-learning adalah algoritma reinforcement learning yang populer. Algoritma ini memanfaatkan Persamaan Bellman untuk memperkirakan nilai pasangan keadaan-tindakan, yang dikenal sebagai nilai Q. Nilai-nilai ini memberi tahu agen seberapa menguntungkan mengambil tindakan tertentu dalam keadaan tertentu dan kemudian mengikuti kebijakan terbaik setelahnya.
Persamaan Optimalitas Bellman untuk Q-learning mencari nilai harapan maksimum untuk setiap tindakan, membantu agen mengidentifikasi langkah terbaik untuk memaksimalkan imbalan jangka panjang.
Sebagai contoh, dalam masalah reinforcement learning episodik, bayangkan seorang agen menavigasi dunia kisi. Saat mencapai suatu keadaan, agen memperbarui nilai Q untuk pasangan keadaan-tindakan tersebut menggunakan persamaan:
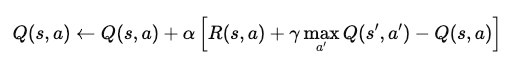
Dengan:
- Q(s,a): Nilai Q untuk mengambil tindakan a pada keadaan s.
- α: Laju pembelajaran, yang menentukan seberapa besar informasi baru menimpa nilai Q lama.
- R(s,a): Imbalan langsung yang diterima setelah mengambil tindakan a pada keadaan s.
- γ: Faktor diskonto, yang menimbang imbalan masa depan relatif terhadap imbalan langsung.
- maxa′Q(s′,a′): Nilai Q maksimum untuk keadaan berikutnya s′, di seluruh kemungkinan tindakan a′.
Persamaan ini memperbarui nilai Q berdasarkan imbalan langsung dan imbalan masa depan maksimum yang diharapkan. Melalui penerapan berulang, agen belajar untuk mendekati nilai Q optimal dan dapat menentukan tindakan terbaik untuk memaksimalkan imbalan jangka panjang.
Persamaan Bellman untuk evaluasi kebijakan
Persamaan Bellman juga digunakan untuk mengevaluasi kebijakan dengan memperkirakan fungsi nilai. Dalam konteks ini, persamaan menghitung imbalan jangka panjang yang diharapkan ketika agen mengikuti kebijakan tertentu dari suatu keadaan spesifik. Ini membantu menentukan seberapa efektif suatu kebijakan dengan menunjukkan imbalan rata-rata yang dapat diharapkan agen.
Algoritma iterasi kebijakan menggunakan evaluasi ini untuk meningkatkan kebijakan. Proses dimulai dengan memperkirakan fungsi nilai untuk suatu kebijakan lalu memperbarui kebijakan agar memilih tindakan yang lebih baik berdasarkan nilai tersebut. Proses ini diulang hingga kebijakan konvergen ke kebijakan optimal, pada titik itu tidak ada peningkatan lebih lanjut yang dapat dilakukan.
Turunan Persamaan Bellman
Pada bagian ini, kita akan menguraikan Persamaan Bellman selangkah demi selangkah, mulai dari prinsip pertama. Kita kemudian akan melihat bagaimana imbalan dan transisi membentuk fungsi nilai, menuntun agen dalam memilih tindakan terbaik.
Turunan langkah demi langkah
Untuk menurunkan Persamaan Bellman, kita mulai dari konsep fungsi nilai. Fungsi nilai, V(s)V(s)V(s), memberikan imbalan kumulatif yang diharapkan untuk memulai pada keadaan sss dan kemudian mengikuti kebijakan optimal. Persamaan ini bersifat rekursif, artinya mengaitkan nilai suatu keadaan dengan nilai keadaan-keadaan berikutnya.
1. Definisikan fungsi nilai
Fungsi nilai V(s) merepresentasikan total imbalan yang diharapkan yang akan diterima agen dengan memulai pada keadaan sss dan mengikuti kebijakan optimal. Secara matematis, ini dapat dinyatakan sebagai:
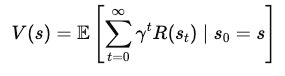
Dengan:
- s adalah keadaan saat ini,
- γ adalah faktor diskonto (antara 0 dan 1), yang mengontrol pentingnya imbalan masa depan,
- R(st) adalah imbalan yang diterima pada setiap langkah waktu t.
2. Menguraikan imbalan masa depan
Untuk mengekspresikan V(s) dalam bentuk imbalan langsung dan nilai keadaan masa depan, kita pisahkan imbalan pertama dari jumlah seluruh imbalan masa depan:
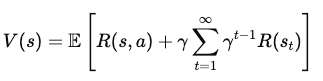
Dengan:
- R(s, a) adalah imbalan langsung yang diperoleh dengan mengambil tindakan a pada keadaan s,
- γ Σ (γ(t1)) R(st) merepresentasikan jumlah terdiskonto dari imbalan masa depan.
3. Menggabungkan nilai keadaan berikutnya
Sekarang kita tambahkan nilai keadaan berikutnya, s', yang dicapai agen setelah mengambil tindakan a pada keadaan s. Ini menghasilkan persamaan:
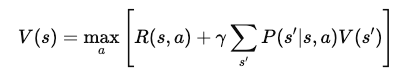
Dengan:
- P(s' | s, a) adalah probabilitas bertransisi ke keadaan s' dari keadaan s setelah mengambil tindakan a,
- maxa merepresentasikan pemilihan tindakan a yang memaksimalkan imbalan yang diharapkan.
4. Persamaan Bellman final
Setelah disederhanakan, Persamaan Bellman untuk fungsi nilai V(s) menjadi:
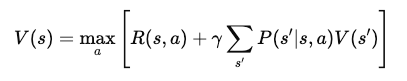
Bentuk final Persamaan Bellman ini menguraikan nilai suatu keadaan menjadi dua komponen: imbalan langsung dan nilai harapan dari keadaan berikutnya. Struktur rekursif ini memungkinkan algoritma menghitung atau mendekati V(s) secara iteratif, yang membantu menemukan kebijakan optimal dari waktu ke waktu.
Contoh dan penerapan
Mari kita telusuri sebuah contoh dengan dunia kisi sederhana:
Bayangkan seorang agen mencoba mencapai tujuan pada sebuah kisi sambil menghindari rintangan. Agen bergerak ke atas, bawah, kiri, atau kanan dan mendapatkan imbalan untuk setiap gerakan. Jika mencapai tujuan, agen mendapat imbalan lebih tinggi. Dengan menggunakan Persamaan Bellman, kita dapat menghitung nilai untuk setiap keadaan pada kisi dengan mengevaluasi imbalan langsung dan nilai keadaan masa depan.
Untuk Markov Decision Processes (MDP), Persamaan Bellman membantu menemukan kebijakan optimal. Jika kita memiliki MDP kecil, seperti masalah pengantaran di mana agen harus memilih rute tercepat, kita menerapkan persamaan pada setiap pasangan keadaan-tindakan. Dengan demikian, kita dapat menghitung tindakan terbaik yang memaksimalkan total imbalan yang diharapkan.
Topik Lanjutan: Persamaan Bellman dalam Q-Learning
Pada bagian ini, kita membahas bagaimana Persamaan Bellman diterapkan dalam metode lanjutan seperti:
- Value iteration
- Temporal-Difference learning.
Teknik-teknik ini membantu agen mempelajari tindakan optimal dengan memperbarui estimasi nilai, bahkan dalam lingkungan yang kompleks. Memahami topik-topik lanjutan ini adalah kunci untuk menguasai reinforcement learning.
Value iteration
Value iteration adalah metode yang menggunakan Persamaan Bellman untuk memperbarui fungsi nilai secara iteratif. Tujuannya adalah menemukan nilai optimal untuk setiap keadaan agar agen dapat menentukan tindakan terbaik.
Dalam value iteration, agen memperbarui nilai setiap keadaan berdasarkan kemungkinan keadaan masa depan dan imbalannya. Proses ini diulang hingga nilai-nilai tersebut konvergen ke solusi yang stabil. Sifat konvergensi value iteration memastikan bahwa, diberi waktu yang cukup, metode ini akan menemukan kebijakan optimal.
Pembelajaran temporal-difference
TD learning adalah pendekatan lain yang menggunakan Persamaan Bellman tetapi berbeda dalam satu hal kunci—metode ini tidak memerlukan model lingkungan.
Sebaliknya, pendekatan ini memperbarui estimasi nilai berdasarkan pengalaman nyata yang dikumpulkan agen. Hal ini membuatnya lebih praktis ketika lingkungan tidak diketahui. TD learning menjembatani kesenjangan antara metode Monte Carlo, yang mengandalkan episode lengkap, dan pemrograman dinamis, yang memerlukan model penuh.
Aplikasi dan Use Case
Persamaan Bellman memiliki berbagai aplikasi di luar model teoretis. Persamaan ini memainkan peran penting dalam skenario dunia nyata yang membutuhkan pengambilan keputusan dan optimisasi. Bagian ini membahas bagaimana Persamaan Bellman mendukung aplikasi-aplikasi tersebut.
Reinforcement learning dalam gim
Dalam lingkungan gim klasik seperti Atari, Persamaan Bellman membantu mengoptimalkan tindakan agen untuk meraih skor tertinggi. Persamaan ini menuntun agen memilih langkah terbaik dengan mengevaluasi imbalan yang diharapkan untuk setiap tindakan.
Contoh dunia nyata mencakup penggunaan algoritma deep reinforcement learning, seperti Deep Q-Network (DQN), yang menggunakan Persamaan Bellman untuk meningkatkan AI gim. Metode-metode ini telah digunakan untuk melatih agen yang melampaui pemain manusia dalam berbagai gim, menunjukkan kekuatan reinforcement learning.
Robotika dan navigasi
Dalam robotika, Persamaan Bellman membantu mesin membuat keputusan tentang pergerakan dan navigasi. Robot menggunakannya untuk mengevaluasi berbagai jalur dan memilih yang memaksimalkan imbalan masa depan, seperti mencapai tujuan dalam waktu tersingkat atau dengan energi paling sedikit.
Dengan kata lain, robot menggunakan Persamaan Bellman untuk membantu mereka memprediksi hasil berdasarkan keadaan saat ini dan merencanakan langkah berikutnya. Proses pengambilan keputusan ini penting untuk bernavigasi melalui labirin atau menghindari rintangan dalam lingkungan dinamis.
Kesimpulan
Persamaan Bellman bersifat fundamental dalam pengembangan sistem cerdas—khususnya dalam reinforcement learning dan bidang kecerdasan buatan lainnya. Persamaan ini menjadi dasar bagi algoritma yang memungkinkan sistem belajar, beradaptasi, dan mengoptimalkan tindakannya dalam lingkungan dinamis, yang mengarah pada pemecahan masalah yang lebih efisien dan efektif dalam keadaan tidak pasti.
Berikut beberapa sumber untuk melanjutkan pembelajaran Anda:


 David Woods · 13 min

 Dario Radečić · 15 min

 Hugo Bowne-Anderson · 13 min


Pada awal 1950-an, Richard Bellman, seorang matematikawan dan ilmuwan komputer visioner, memulai perjalanan untuk mengurai kompleksitas pengambilan keputusan dalam lingkungan yang tidak pasti. Didorong oleh kebutuhan akan metode pemecahan masalah yang efisien, ia memperkenalkan konsep revolusioner pemrograman dinamis, yang memecah masalah rumit menjadi submasalah yang dapat dikelola.
Saat mengeksplorasi pendekatan ini, Bellman merumuskan apa yang kemudian dikenal sebagai Persamaan Bellman: sebuah ekspresi matematis yang mengevaluasi nilai suatu keputusan dalam keadaan tertentu berdasarkan potensi keadaan masa depan dan imbalan yang terkait dengannya. Karya terobosannya berpuncak pada penerbitan bukunya tahun 1957, Dynamic Programming, yang meletakkan dasar teoretis bagi teori optimisasi dan kendali sekaligus membuka jalan bagi kemajuan dalam kecerdasan buatan dan reinforcement learning.
Saat ini, gagasan Bellman terus membentuk cara mesin belajar dan beradaptasi dengan lingkungannya, meninggalkan warisan yang langgeng dalam matematika dan ilmu komputer. Dalam reinforcement learning, Persamaan Bellman sangat penting untuk memahami bagaimana agen berinteraksi dengan sekelilingnya, sehingga menjadi esensial untuk menyelesaikan berbagai masalah dalam Markov Decision Processes (MDP).
Dalam artikel ini, kita akan membahas apa itu persamaan tersebut, bagaimana perbandingannya dengan Persamaan Optimalitas Bellman, bagaimana penggunaannya dalam reinforcement learning, dan lainnya.
Apa itu Persamaan Bellman?
Persamaan Bellman adalah formula rekursif yang digunakan dalam pengambilan keputusan dan reinforcement learning. Persamaan ini menunjukkan bagaimana nilai berada dalam keadaan tertentu bergantung pada imbalan yang diterima dan nilai keadaan masa depan.
Secara sederhana, Persamaan Bellman memecah masalah kompleks menjadi langkah-langkah yang lebih kecil, sehingga lebih mudah diselesaikan. Persamaan ini membantu menemukan cara terbaik untuk mengambil keputusan ketika hasil bergantung pada rangkaian tindakan.
Secara matematis, Persamaan Bellman ditulis sebagai:
Dengan:
Jumlah ini mengalikan nilai setiap kemungkinan keadaan berikutnya dengan probabilitas mencapainya, sehingga secara efektif menangkap imbalan masa depan yang diharapkan.
Persamaan Bellman vs. Persamaan Optimalitas Bellman
Persamaan Bellman menghitung nilai suatu keadaan berdasarkan imbalan dari mengambil tindakan dan nilai harapan dari keadaan masa depan. Ini adalah bagian kunci dalam mengevaluasi seberapa baik suatu kebijakan ketika diikuti oleh agen dalam suatu lingkungan. Persamaan ini melihat semua kemungkinan tindakan dan hasilnya serta membantu menentukan nilai berada pada keadaan tertentu.
Sebaliknya, Persamaan Optimalitas Bellman digunakan saat tujuannya adalah menemukan kebijakan yang terbaik atau "optimal".
Alih-alih hanya mengevaluasi nilai suatu keadaan berdasarkan kebijakan tertentu, persamaan ini mencari nilai maksimum yang dapat dicapai dengan mempertimbangkan semua kemungkinan tindakan dan kebijakan. Persamaan Optimalitas Bellman melakukannya dengan mengambil imbalan harapan maksimum atas semua tindakan yang tersedia di setiap keadaan. Dengan cara ini, persamaan tersebut memberi tahu kita nilai tertinggi yang dapat diperoleh dari setiap keadaan jika kita bertindak sebaik mungkin.
Dengan kata lain, perbedaan utama antara kedua persamaan tersebut terletak pada fokusnya.
Persamaan Bellman standar mengevaluasi efektivitas suatu kebijakan dengan memperkirakan nilai harapan saat mengikutinya. Di sisi lain, Persamaan Optimalitas Bellman bertujuan menemukan kebijakan terbaik secara keseluruhan dengan mengidentifikasi tindakan yang memberikan imbalan jangka panjang maksimum di setiap keadaan.
TLDR: Persamaan Bellman standar digunakan untuk evaluasi kebijakan, sedangkan persamaan optimalitas digunakan untuk peningkatan kebijakan dan kendali.
Persamaan Optimalitas Bellman sangat penting untuk menyelesaikan masalah kendali, di mana tujuannya adalah memilih urutan tindakan terbaik untuk memaksimalkan imbalan. Dalam masalah ini, agen harus membuat keputusan yang tidak hanya memaksimalkan imbalan langsung tetapi juga mempertimbangkan imbalan masa depan.
Persamaan optimalitas menyediakan cara untuk secara sistematis mengevaluasi dan memilih tindakan yang menghasilkan imbalan jangka panjang tertinggi, membantu menemukan kebijakan optimal. Ini merupakan bagian sentral dari algoritma seperti Q-learning dan value iteration, yang digunakan dalam reinforcement learning untuk melatih agen bertindak seoptimal mungkin.
Persamaan Bellman dalam Reinforcement Learning
Persamaan Bellman adalah bagian inti dari reinforcement learning. Persamaan ini membantu agen belajar bagaimana membuat keputusan terbaik dengan memecah tugas kompleks menjadi langkah-langkah yang lebih kecil.
Secara khusus, Persamaan Bellman memungkinkan agen menghitung nilai berbagai keadaan dan tindakan, yang menuntun mereka memilih jalur terbaik untuk memaksimalkan imbalan.
Dengan demikian, dalam reinforcement learning, Persamaan Bellman digunakan untuk mengevaluasi dan meningkatkan kebijakan, memastikan agen membuat keputusan yang lebih baik seiring bertambahnya pengalaman.
Peran dalam Q-Learning
Q-learning adalah algoritma reinforcement learning yang populer. Algoritma ini memanfaatkan Persamaan Bellman untuk memperkirakan nilai pasangan keadaan-tindakan, yang dikenal sebagai nilai Q. Nilai-nilai ini memberi tahu agen seberapa menguntungkan mengambil tindakan tertentu dalam keadaan tertentu dan kemudian mengikuti kebijakan terbaik setelahnya.
Persamaan Optimalitas Bellman untuk Q-learning mencari nilai harapan maksimum untuk setiap tindakan, membantu agen mengidentifikasi langkah terbaik untuk memaksimalkan imbalan jangka panjang.
Sebagai contoh, dalam masalah reinforcement learning episodik, bayangkan seorang agen menavigasi dunia kisi. Saat mencapai suatu keadaan, agen memperbarui nilai Q untuk pasangan keadaan-tindakan tersebut menggunakan persamaan:
Dengan:
Persamaan ini memperbarui nilai Q berdasarkan imbalan langsung dan imbalan masa depan maksimum yang diharapkan. Melalui penerapan berulang, agen belajar untuk mendekati nilai Q optimal dan dapat menentukan tindakan terbaik untuk memaksimalkan imbalan jangka panjang.
Persamaan Bellman untuk evaluasi kebijakan
Persamaan Bellman juga digunakan untuk mengevaluasi kebijakan dengan memperkirakan fungsi nilai. Dalam konteks ini, persamaan menghitung imbalan jangka panjang yang diharapkan ketika agen mengikuti kebijakan tertentu dari suatu keadaan spesifik. Ini membantu menentukan seberapa efektif suatu kebijakan dengan menunjukkan imbalan rata-rata yang dapat diharapkan agen.
Algoritma iterasi kebijakan menggunakan evaluasi ini untuk meningkatkan kebijakan. Proses dimulai dengan memperkirakan fungsi nilai untuk suatu kebijakan lalu memperbarui kebijakan agar memilih tindakan yang lebih baik berdasarkan nilai tersebut. Proses ini diulang hingga kebijakan konvergen ke kebijakan optimal, pada titik itu tidak ada peningkatan lebih lanjut yang dapat dilakukan.
Turunan Persamaan Bellman
Pada bagian ini, kita akan menguraikan Persamaan Bellman selangkah demi selangkah, mulai dari prinsip pertama. Kita kemudian akan melihat bagaimana imbalan dan transisi membentuk fungsi nilai, menuntun agen dalam memilih tindakan terbaik.
Turunan langkah demi langkah
Untuk menurunkan Persamaan Bellman, kita mulai dari konsep fungsi nilai. Fungsi nilai, V(s)V(s)V(s), memberikan imbalan kumulatif yang diharapkan untuk memulai pada keadaan sss dan kemudian mengikuti kebijakan optimal. Persamaan ini bersifat rekursif, artinya mengaitkan nilai suatu keadaan dengan nilai keadaan-keadaan berikutnya.
1. Definisikan fungsi nilai
Fungsi nilai V(s) merepresentasikan total imbalan yang diharapkan yang akan diterima agen dengan memulai pada keadaan sss dan mengikuti kebijakan optimal. Secara matematis, ini dapat dinyatakan sebagai:
Dengan:
2. Menguraikan imbalan masa depan
Untuk mengekspresikan V(s) dalam bentuk imbalan langsung dan nilai keadaan masa depan, kita pisahkan imbalan pertama dari jumlah seluruh imbalan masa depan:
Dengan:
3. Menggabungkan nilai keadaan berikutnya
Sekarang kita tambahkan nilai keadaan berikutnya, s', yang dicapai agen setelah mengambil tindakan a pada keadaan s. Ini menghasilkan persamaan:
Dengan:
4. Persamaan Bellman final
Setelah disederhanakan, Persamaan Bellman untuk fungsi nilai V(s) menjadi:
Bentuk final Persamaan Bellman ini menguraikan nilai suatu keadaan menjadi dua komponen: imbalan langsung dan nilai harapan dari keadaan berikutnya. Struktur rekursif ini memungkinkan algoritma menghitung atau mendekati V(s) secara iteratif, yang membantu menemukan kebijakan optimal dari waktu ke waktu.
Contoh dan penerapan
Mari kita telusuri sebuah contoh dengan dunia kisi sederhana:
Bayangkan seorang agen mencoba mencapai tujuan pada sebuah kisi sambil menghindari rintangan. Agen bergerak ke atas, bawah, kiri, atau kanan dan mendapatkan imbalan untuk setiap gerakan. Jika mencapai tujuan, agen mendapat imbalan lebih tinggi. Dengan menggunakan Persamaan Bellman, kita dapat menghitung nilai untuk setiap keadaan pada kisi dengan mengevaluasi imbalan langsung dan nilai keadaan masa depan.
Untuk Markov Decision Processes (MDP), Persamaan Bellman membantu menemukan kebijakan optimal. Jika kita memiliki MDP kecil, seperti masalah pengantaran di mana agen harus memilih rute tercepat, kita menerapkan persamaan pada setiap pasangan keadaan-tindakan. Dengan demikian, kita dapat menghitung tindakan terbaik yang memaksimalkan total imbalan yang diharapkan.
Topik Lanjutan: Persamaan Bellman dalam Q-Learning
Pada bagian ini, kita membahas bagaimana Persamaan Bellman diterapkan dalam metode lanjutan seperti:
Teknik-teknik ini membantu agen mempelajari tindakan optimal dengan memperbarui estimasi nilai, bahkan dalam lingkungan yang kompleks. Memahami topik-topik lanjutan ini adalah kunci untuk menguasai reinforcement learning.
Value iteration
Value iteration adalah metode yang menggunakan Persamaan Bellman untuk memperbarui fungsi nilai secara iteratif. Tujuannya adalah menemukan nilai optimal untuk setiap keadaan agar agen dapat menentukan tindakan terbaik.
Dalam value iteration, agen memperbarui nilai setiap keadaan berdasarkan kemungkinan keadaan masa depan dan imbalannya. Proses ini diulang hingga nilai-nilai tersebut konvergen ke solusi yang stabil. Sifat konvergensi value iteration memastikan bahwa, diberi waktu yang cukup, metode ini akan menemukan kebijakan optimal.
Pembelajaran temporal-difference
TD learning adalah pendekatan lain yang menggunakan Persamaan Bellman tetapi berbeda dalam satu hal kunci—metode ini tidak memerlukan model lingkungan.
Sebaliknya, pendekatan ini memperbarui estimasi nilai berdasarkan pengalaman nyata yang dikumpulkan agen. Hal ini membuatnya lebih praktis ketika lingkungan tidak diketahui. TD learning menjembatani kesenjangan antara metode Monte Carlo, yang mengandalkan episode lengkap, dan pemrograman dinamis, yang memerlukan model penuh.
Aplikasi dan Use Case
Persamaan Bellman memiliki berbagai aplikasi di luar model teoretis. Persamaan ini memainkan peran penting dalam skenario dunia nyata yang membutuhkan pengambilan keputusan dan optimisasi. Bagian ini membahas bagaimana Persamaan Bellman mendukung aplikasi-aplikasi tersebut.
Reinforcement learning dalam gim
Dalam lingkungan gim klasik seperti Atari, Persamaan Bellman membantu mengoptimalkan tindakan agen untuk meraih skor tertinggi. Persamaan ini menuntun agen memilih langkah terbaik dengan mengevaluasi imbalan yang diharapkan untuk setiap tindakan.
Contoh dunia nyata mencakup penggunaan algoritma deep reinforcement learning, seperti Deep Q-Network (DQN), yang menggunakan Persamaan Bellman untuk meningkatkan AI gim. Metode-metode ini telah digunakan untuk melatih agen yang melampaui pemain manusia dalam berbagai gim, menunjukkan kekuatan reinforcement learning.
Robotika dan navigasi
Dalam robotika, Persamaan Bellman membantu mesin membuat keputusan tentang pergerakan dan navigasi. Robot menggunakannya untuk mengevaluasi berbagai jalur dan memilih yang memaksimalkan imbalan masa depan, seperti mencapai tujuan dalam waktu tersingkat atau dengan energi paling sedikit.
Dengan kata lain, robot menggunakan Persamaan Bellman untuk membantu mereka memprediksi hasil berdasarkan keadaan saat ini dan merencanakan langkah berikutnya. Proses pengambilan keputusan ini penting untuk bernavigasi melalui labirin atau menghindari rintangan dalam lingkungan dinamis.
Kesimpulan
Persamaan Bellman bersifat fundamental dalam pengembangan sistem cerdas—khususnya dalam reinforcement learning dan bidang kecerdasan buatan lainnya. Persamaan ini menjadi dasar bagi algoritma yang memungkinkan sistem belajar, beradaptasi, dan mengoptimalkan tindakannya dalam lingkungan dinamis, yang mengarah pada pemecahan masalah yang lebih efisien dan efektif dalam keadaan tidak pasti.
Berikut beberapa sumber untuk melanjutkan pembelajaran Anda: