Begin jaren vijftig begon Richard Bellman, een visionaire wiskundige en informaticus, aan een zoektocht om de complexiteit van besluitvorming in onzekere omgevingen te ontrafelen. Gedreven door de behoefte aan efficiënte oplossingsmethoden introduceerde hij het baanbrekende concept van dynamische programmering, waarbij ingewikkelde problemen worden opgedeeld in behapbare deelproblemen.
Terwijl hij deze aanpak verkende, formuleerde Bellman wat later bekend zou worden als de Bellman-vergelijking: een wiskundige uitdrukking die de waarde van een beslissing in een gegeven toestand evalueert op basis van de mogelijke toekomstige toestanden en de bijbehorende beloningen. Zijn baanbrekende werk culmineerde in de publicatie van zijn boek uit 1957, Dynamic Programming, dat de theoretische basis legde voor optimalisatie- en regeltheorie en de weg vrijmaakte voor vooruitgang in kunstmatige intelligentie en reinforcement learning.
Vandaag de dag blijven Bellmans ideeën vormgeven hoe machines leren en zich aanpassen aan hun omgeving, met een blijvende erfenis in de wiskunde en informatica. In reinforcement learning is de Bellman-vergelijking cruciaal om te begrijpen hoe agenten met hun omgeving interageren en is ze essentieel voor het oplossen van uiteenlopende problemen in Markov-beslissingsprocessen (MDP’s).
In dit artikel bekijken we wat de vergelijking is, hoe ze zich verhoudt tot de Bellman-optimaliteitsvergelijking, hoe ze wordt gebruikt in reinforcement learning en meer.
Wat is de Bellman-vergelijking?
De Bellman-vergelijking is een recursieve formule die wordt gebruikt in besluitvorming en reinforcement learning. Ze laat zien hoe de waarde van het verkeren in een bepaalde toestand afhangt van de ontvangen beloningen en de waarde van toekomstige toestanden.
Simpel gezegd, de Bellman-vergelijking breekt een complex probleem op in kleinere stappen, waardoor het makkelijker op te lossen is. De vergelijking helpt de beste manier te vinden om beslissingen te nemen wanneer uitkomsten afhangen van een reeks acties.
Wiskundig wordt de Bellman-vergelijking geschreven als:
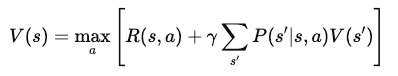
Waarbij:
- V(s): De waarde van toestand sss, die de langetermijnbeloning van het verkeren in die toestand weergeeft.
- R(s,a): De directe beloning voor het uitvoeren van actie aaa in toestand sss.
- γ: De discontovoet (tussen 0 en 1) die bepaalt hoe zwaar toekomstige beloningen wegen ten opzichte van directe beloningen.
- P(s′∣s,a) De kans om naar toestand s′ over te gaan vanuit toestand sss door actie a te nemen.
- maxa: De optimale actie die de verwachte waarde van toekomstige beloningen maximaliseert.
Deze som vermenigvuldigt de waarde van elke mogelijke volgende toestand met de kans om die toestand te bereiken, en vangt zo de verwachte toekomstige beloningen.
Bellman-vergelijking vs. Bellman-optimaliteitsvergelijking
De Bellman-vergelijking berekent de waarde van een toestand op basis van de beloningen van acties en de verwachte waarde van toekomstige toestanden. Het is een essentieel onderdeel om te beoordelen hoe goed een beleid is wanneer een agent het in een omgeving volgt. De vergelijking bekijkt alle mogelijke acties en uitkomsten en helpt de waarde te bepalen van het verkeren in een bepaalde toestand.
Daarentegen wordt de Bellman-optimaliteitsvergelijking gebruikt wanneer het doel is om het beste of "optimale" beleid te vinden.
In plaats van alleen de waarde van een toestand te evalueren op basis van een specifiek beleid, zoekt ze de maximale waarde die haalbaar is door alle mogelijke acties en beleidsopties te overwegen. De Bellman-optimaliteitsvergelijking doet dit door de maximale verwachte beloning te nemen over alle beschikbare acties in elke toestand. Zo vertelt ze ons de hoogst mogelijke waarde die we uit elke toestand kunnen halen als we op de best mogelijke manier handelen.
Met andere woorden, het belangrijkste verschil tussen de twee vergelijkingen is hun focus.
De standaard Bellman-vergelijking evalueert de effectiviteit van een beleid door de verwachte waarde van het volgen ervan te schatten. De Bellman-optimaliteitsvergelijking daarentegen is gericht op het vinden van het beste beleid in het algemeen door de actie te identificeren die in elke toestand de maximale langetermijnbeloning oplevert.
TL;DR: De standaard Bellman-vergelijking wordt gebruikt voor beleidsevaluatie, terwijl de optimaliteitsvergelijking wordt gebruikt voor beleidsverbetering en -sturing.
De Bellman-optimaliteitsvergelijking is essentieel voor het oplossen van sturingsproblemen, waarbij het doel is om de beste reeks acties te kiezen om beloningen te maximaliseren. In deze problemen moeten agenten beslissingen nemen die niet alleen directe beloningen maximaliseren, maar ook toekomstige beloningen meenemen.
De optimaliteitsvergelijking biedt een manier om systematisch acties te evalueren en te kiezen die leiden tot de hoogst mogelijke langetermijnbeloning, en helpt zo het optimale beleid te vinden. Ze vormt een centraal onderdeel van algoritmen zoals Q-learning en waarde-iteratie, die in reinforcement learning worden gebruikt om agenten te trainen om zo goed mogelijk te handelen.
Bellman-vergelijking in Reinforcement Learning
De Bellman-vergelijking is een kernonderdeel van reinforcement learning. Ze helpt agenten de beste beslissingen te leren nemen door complexe taken op te splitsen in kleinere stappen.
Concreet stelt de Bellman-vergelijking agenten in staat de waarde van verschillende toestanden en acties te berekenen, wat hen helpt bij het kiezen van het beste pad om beloningen te maximaliseren.
Dus, in reinforcement learning wordt de Bellman-vergelijking gebruikt om beleidsopties te evalueren en te verbeteren, zodat agenten betere beslissingen nemen naarmate ze ervaring opdoen.
Rol in Q-learning
Q-learning is een populair reinforcement learning-algoritme. Het algoritme gebruikt de Bellman-vergelijking om de waarde van toestand-actieparen te schatten, de zogeheten Q-waarden. Deze waarden vertellen de agent hoe belonend het is om een bepaalde actie in een gegeven toestand te ondernemen en daarna het beste beleid te volgen.
De Bellman-optimaliteitsvergelijking voor Q-learning vindt de maximale verwachte waarde voor elke actie, waardoor agenten de beste zetten kunnen identificeren om hun langetermijnbeloningen te maximaliseren.
Stel bijvoorbeeld in een episodisch reinforcement learning-probleem dat een agent door een rasterwereld navigeert. Wanneer hij een toestand bereikt, werkt de agent zijn Q-waarde voor dat toestand-actie-paar bij met de vergelijking:
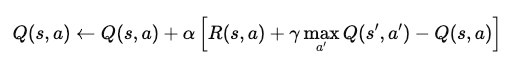
Waarbij:
- Q(s,a): De Q-waarde voor het uitvoeren van actie a in toestand s.
- α: De leersnelheid, die bepaalt in hoeverre nieuwe informatie de oude Q-waarde overschrijft.
- R(s,a): De directe beloning na het uitvoeren van actie a in toestand s.
- γ: De discontovoet, die toekomstige beloningen weegt ten opzichte van directe beloningen.
- maxa′Q(s′,a′): De maximale Q-waarde voor de volgende toestand s′, over alle mogelijke acties a′.
Deze vergelijking werkt de Q-waarde bij op basis van de directe beloning en de maximaal verwachte toekomstige beloningen. Door herhaalde toepassing leert de agent de optimale Q-waarden te benaderen en kan hij de beste acties bepalen om langetermijnbeloningen te maximaliseren.
Bellman-vergelijking voor beleidsevaluatie
De Bellman-vergelijking wordt ook gebruikt om beleidsopties te evalueren door waardefuncties te schatten. In deze context berekent ze de verwachte langetermijnbeloning wanneer een agent een gegeven beleid vanuit een specifieke toestand volgt. Dit helpt te bepalen hoe effectief een beleid is door te laten zien welke gemiddelde beloning de agent kan verwachten.
Het policy-iteratie-algoritme gebruikt deze evaluatie om beleidsopties te verbeteren. Het begint met het schatten van de waardefunctie voor een beleid en werkt vervolgens het beleid bij om betere acties te kiezen op basis van deze waarde. Dit proces wordt herhaald totdat het beleid convergeert naar het optimale beleid, waarna geen verdere verbeteringen mogelijk zijn.
Afleiding van de Bellman-vergelijking
In deze sectie lopen we de Bellman-vergelijking stap voor stap door, beginnend bij de eerste principes. We verkennen vervolgens hoe beloningen en transities waardefuncties opbouwen, die agenten sturen bij het kiezen van de beste acties.
Stap-voor-stap afleiding
Om de Bellman-vergelijking af te leiden, beginnen we met het concept van een waardefunctie. De waardefunctie, V(s)V(s)V(s), geeft de verwachte cumulatieve beloning voor het starten in een toestand sss en vervolgens het optimale beleid te volgen. Deze vergelijking is recursief, wat betekent dat ze de waarde van een toestand relateert aan de waarde van daaropvolgende toestanden.
1. Definieer de waardefunctie
De waardefunctie V(s) vertegenwoordigt de totale verwachte beloning die een agent zal ontvangen vanaf het starten in toestand sss en het volgen van het optimale beleid. Wiskundig kan ze worden uitgedrukt als:
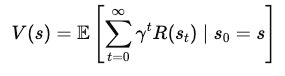
Waarbij:
- s de huidige toestand is,
- γ de discontovoet (tussen 0 en 1) is, die de belangrijkheid van toekomstige beloningen bepaalt,
- R(st) de beloning is die op elk tijdstip t wordt ontvangen.
2. Toekomstige beloningen uitsplitsen
Om V(s) uit te drukken in termen van directe beloningen en de waarde van toekomstige toestanden, scheiden we de eerste beloning van de som van alle toekomstige beloningen:
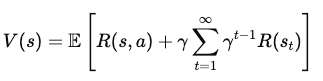
Waarbij:
- R(s, a) de directe beloning is die wordt verkregen door actie a te ondernemen in toestand s,
- γ Σ (γ(t1)) R(st) de verdisconteerde som van toekomstige beloningen voorstelt.
3. Neem de waarde van de volgende toestand op
We voegen nu de waarde toe van de volgende toestand, s', die de agent bereikt na het uitvoeren van actie a in toestand s. Dit leidt tot de vergelijking:
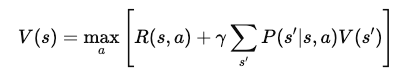
Waarbij:
- P(s' | s, a) de kans is om naar toestand s' over te gaan vanuit toestand s na het uitvoeren van actie a,
- maxa staat voor de keuze van de actie a die de verwachte beloning maximaliseert.
4. De uiteindelijke Bellman-vergelijking
Na vereenvoudiging wordt de Bellman-vergelijking voor de waardefunctie V(s) als volgt:
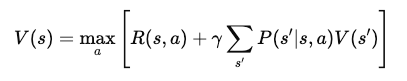
Deze uiteindelijke vorm van de Bellman-vergelijking ontleedt de waarde van een toestand in twee componenten: de directe beloning en de verwachte waarde van de volgende toestand. Deze recursieve structuur stelt algoritmen in staat om V(s) iteratief te berekenen of te benaderen, wat helpt om in de loop van de tijd optimale beleidsopties te vinden.
Voorbeelden en toepassingen
Laten we een voorbeeld doornemen met een eenvoudige rasterwereld:
Stel je een agent voor die een doel probeert te bereiken op een raster terwijl hij obstakels vermijdt. De agent beweegt omhoog, omlaag, links of rechts en krijgt beloningen voor elke zet. Als hij het doel bereikt, krijgt hij een hogere beloning. Met behulp van de Bellman-vergelijking kunnen we de waarde voor elke toestand op het raster berekenen door de directe beloningen en de waarden van toekomstige toestanden te evalueren.
Voor Markov-beslissingsprocessen (MDP’s) helpt de Bellman-vergelijking om het optimale beleid te vinden. Als we een klein MDP hebben, zoals een bezorgprobleem waarbij een agent de snelste route moet kiezen, passen we de vergelijking toe op elk toestand-actie-paar. Zo kunnen we de beste acties berekenen die de totale verwachte beloning maximaliseren.
Geavanceerde onderwerpen: Bellman-vergelijking in Q-learning
In deze sectie bekijken we hoe de Bellman-vergelijking wordt toegepast in geavanceerde methoden zoals:
- Waarde-iteratie
- Temporal-Difference learning.
Deze technieken helpen agenten optimale acties te leren door waarde-inschattingen bij te werken, zelfs in complexe omgevingen. Het begrijpen van deze geavanceerde onderwerpen is de sleutel tot het beheersen van reinforcement learning.
Waarde-iteratie
Waarde-iteratie is een methode die de Bellman-vergelijking gebruikt om waardefuncties iteratief bij te werken. Het doel is om de optimale waarde voor elke toestand te vinden, zodat de agent de beste acties kan bepalen.
Bij waarde-iteratie werkt de agent de waarde van elke toestand bij op basis van mogelijke toekomstige toestanden en hun beloningen. Dit proces wordt herhaald totdat de waarden naar een stabiele oplossing convergeren. De convergentie-eigenschappen van waarde-iteratie zorgen ervoor dat, mits voldoende tijd, het optimale beleid wordt gevonden.
Temporal-difference learning
TD-learning is een andere aanpak die de Bellman-vergelijking gebruikt, maar verschilt op een belangrijk punt: er is geen model van de omgeving nodig.
In plaats daarvan werkt het waarde-inschattingen bij op basis van daadwerkelijke ervaringen die de agent opdoet. Dit maakt het praktischer wanneer de omgeving onbekend is. TD-learning slaat een brug tussen Monte Carlo-methoden, die vertrouwen op volledige episodes, en dynamische programmering, die een volledig model nodig heeft.
Toepassingen en use-cases
De Bellman-vergelijking kent een breed scala aan toepassingen buiten theoretische modellen. Ze speelt een cruciale rol in praktijksituaties waar besluitvorming en optimalisatie nodig zijn. In deze sectie verkennen we hoe de Bellman-vergelijking deze toepassingen ondersteunt.
Reinforcement learning in games
In klassieke game-omgevingen zoals Atari helpt de Bellman-vergelijking de acties van een agent te optimaliseren om de hoogste score te behalen. De vergelijking begeleidt de agent bij het selecteren van de beste zetten door de verwachte beloningen voor elke actie te evalueren.
Praktijkvoorbeelden zijn deep reinforcement learning-algoritmen, zoals Deep Q-Networks (DQN’s), die de Bellman-vergelijking gebruiken om game-AI te verbeteren. Met deze methoden zijn agenten getraind die menselijke spelers in diverse games overtreffen, wat de kracht van reinforcement learning aantoont.
Robotica en navigatie
In de robotica helpt de Bellman-vergelijking machines bij het nemen van beslissingen over beweging en navigatie. Robots gebruiken haar om verschillende paden te evalueren en het pad te kiezen dat toekomstige beloningen maximaliseert, zoals het snelst een doel bereiken of met de minste energie.
Met andere woorden, robots gebruiken de Bellman-vergelijking om uitkomsten te voorspellen op basis van hun huidige toestand en hun volgende zetten dienovereenkomstig te plannen. Dit besluitvormingsproces is cruciaal voor het navigeren door een doolhof of het vermijden van obstakels in dynamische omgevingen.
Conclusie
De Bellman-vergelijking is fundamenteel bij het ontwikkelen van intelligente systemen – vooral in reinforcement learning en andere gebieden van kunstmatige intelligentie. Ze vormt de basis voor algoritmen die systemen in staat stellen te leren, zich aan te passen en hun acties te optimaliseren in dynamische omgevingen, wat leidt tot efficiënter en effectiever probleemoplossen in onzekere situaties.
Hier zijn enkele bronnen om verder te leren:



 Adel Nehme · 15 min
Begin jaren vijftig begon Richard Bellman, een visionaire wiskundige en informaticus, aan een zoektocht om de complexiteit van besluitvorming in onzekere omgevingen te ontrafelen. Gedreven door de behoefte aan efficiënte oplossingsmethoden introduceerde hij het baanbrekende concept van dynamische programmering, waarbij ingewikkelde problemen worden opgedeeld in behapbare deelproblemen.
Terwijl hij deze aanpak verkende, formuleerde Bellman wat later bekend zou worden als de Bellman-vergelijking: een wiskundige uitdrukking die de waarde van een beslissing in een gegeven toestand evalueert op basis van de mogelijke toekomstige toestanden en de bijbehorende beloningen. Zijn baanbrekende werk culmineerde in de publicatie van zijn boek uit 1957, Dynamic Programming, dat de theoretische basis legde voor optimalisatie- en regeltheorie en de weg vrijmaakte voor vooruitgang in kunstmatige intelligentie en reinforcement learning.
Vandaag de dag blijven Bellmans ideeën vormgeven hoe machines leren en zich aanpassen aan hun omgeving, met een blijvende erfenis in de wiskunde en informatica. In reinforcement learning is de Bellman-vergelijking cruciaal om te begrijpen hoe agenten met hun omgeving interageren en is ze essentieel voor het oplossen van uiteenlopende problemen in Markov-beslissingsprocessen (MDP’s).
In dit artikel bekijken we wat de vergelijking is, hoe ze zich verhoudt tot de Bellman-optimaliteitsvergelijking, hoe ze wordt gebruikt in reinforcement learning en meer.
Wat is de Bellman-vergelijking?
De Bellman-vergelijking is een recursieve formule die wordt gebruikt in besluitvorming en reinforcement learning. Ze laat zien hoe de waarde van het verkeren in een bepaalde toestand afhangt van de ontvangen beloningen en de waarde van toekomstige toestanden.
Simpel gezegd, de Bellman-vergelijking breekt een complex probleem op in kleinere stappen, waardoor het makkelijker op te lossen is. De vergelijking helpt de beste manier te vinden om beslissingen te nemen wanneer uitkomsten afhangen van een reeks acties.
Wiskundig wordt de Bellman-vergelijking geschreven als:
Waarbij:
Deze som vermenigvuldigt de waarde van elke mogelijke volgende toestand met de kans om die toestand te bereiken, en vangt zo de verwachte toekomstige beloningen.
Bellman-vergelijking vs. Bellman-optimaliteitsvergelijking
De Bellman-vergelijking berekent de waarde van een toestand op basis van de beloningen van acties en de verwachte waarde van toekomstige toestanden. Het is een essentieel onderdeel om te beoordelen hoe goed een beleid is wanneer een agent het in een omgeving volgt. De vergelijking bekijkt alle mogelijke acties en uitkomsten en helpt de waarde te bepalen van het verkeren in een bepaalde toestand.
Daarentegen wordt de Bellman-optimaliteitsvergelijking gebruikt wanneer het doel is om het beste of "optimale" beleid te vinden.
In plaats van alleen de waarde van een toestand te evalueren op basis van een specifiek beleid, zoekt ze de maximale waarde die haalbaar is door alle mogelijke acties en beleidsopties te overwegen. De Bellman-optimaliteitsvergelijking doet dit door de maximale verwachte beloning te nemen over alle beschikbare acties in elke toestand. Zo vertelt ze ons de hoogst mogelijke waarde die we uit elke toestand kunnen halen als we op de best mogelijke manier handelen.
Met andere woorden, het belangrijkste verschil tussen de twee vergelijkingen is hun focus.
De standaard Bellman-vergelijking evalueert de effectiviteit van een beleid door de verwachte waarde van het volgen ervan te schatten. De Bellman-optimaliteitsvergelijking daarentegen is gericht op het vinden van het beste beleid in het algemeen door de actie te identificeren die in elke toestand de maximale langetermijnbeloning oplevert.
TL;DR: De standaard Bellman-vergelijking wordt gebruikt voor beleidsevaluatie, terwijl de optimaliteitsvergelijking wordt gebruikt voor beleidsverbetering en -sturing.
De Bellman-optimaliteitsvergelijking is essentieel voor het oplossen van sturingsproblemen, waarbij het doel is om de beste reeks acties te kiezen om beloningen te maximaliseren. In deze problemen moeten agenten beslissingen nemen die niet alleen directe beloningen maximaliseren, maar ook toekomstige beloningen meenemen.
De optimaliteitsvergelijking biedt een manier om systematisch acties te evalueren en te kiezen die leiden tot de hoogst mogelijke langetermijnbeloning, en helpt zo het optimale beleid te vinden. Ze vormt een centraal onderdeel van algoritmen zoals Q-learning en waarde-iteratie, die in reinforcement learning worden gebruikt om agenten te trainen om zo goed mogelijk te handelen.
Bellman-vergelijking in Reinforcement Learning
De Bellman-vergelijking is een kernonderdeel van reinforcement learning. Ze helpt agenten de beste beslissingen te leren nemen door complexe taken op te splitsen in kleinere stappen.
Concreet stelt de Bellman-vergelijking agenten in staat de waarde van verschillende toestanden en acties te berekenen, wat hen helpt bij het kiezen van het beste pad om beloningen te maximaliseren.
Dus, in reinforcement learning wordt de Bellman-vergelijking gebruikt om beleidsopties te evalueren en te verbeteren, zodat agenten betere beslissingen nemen naarmate ze ervaring opdoen.
Rol in Q-learning
Q-learning is een populair reinforcement learning-algoritme. Het algoritme gebruikt de Bellman-vergelijking om de waarde van toestand-actieparen te schatten, de zogeheten Q-waarden. Deze waarden vertellen de agent hoe belonend het is om een bepaalde actie in een gegeven toestand te ondernemen en daarna het beste beleid te volgen.
De Bellman-optimaliteitsvergelijking voor Q-learning vindt de maximale verwachte waarde voor elke actie, waardoor agenten de beste zetten kunnen identificeren om hun langetermijnbeloningen te maximaliseren.
Stel bijvoorbeeld in een episodisch reinforcement learning-probleem dat een agent door een rasterwereld navigeert. Wanneer hij een toestand bereikt, werkt de agent zijn Q-waarde voor dat toestand-actie-paar bij met de vergelijking:
Waarbij:
Deze vergelijking werkt de Q-waarde bij op basis van de directe beloning en de maximaal verwachte toekomstige beloningen. Door herhaalde toepassing leert de agent de optimale Q-waarden te benaderen en kan hij de beste acties bepalen om langetermijnbeloningen te maximaliseren.
Bellman-vergelijking voor beleidsevaluatie
De Bellman-vergelijking wordt ook gebruikt om beleidsopties te evalueren door waardefuncties te schatten. In deze context berekent ze de verwachte langetermijnbeloning wanneer een agent een gegeven beleid vanuit een specifieke toestand volgt. Dit helpt te bepalen hoe effectief een beleid is door te laten zien welke gemiddelde beloning de agent kan verwachten.
Het policy-iteratie-algoritme gebruikt deze evaluatie om beleidsopties te verbeteren. Het begint met het schatten van de waardefunctie voor een beleid en werkt vervolgens het beleid bij om betere acties te kiezen op basis van deze waarde. Dit proces wordt herhaald totdat het beleid convergeert naar het optimale beleid, waarna geen verdere verbeteringen mogelijk zijn.
Afleiding van de Bellman-vergelijking
In deze sectie lopen we de Bellman-vergelijking stap voor stap door, beginnend bij de eerste principes. We verkennen vervolgens hoe beloningen en transities waardefuncties opbouwen, die agenten sturen bij het kiezen van de beste acties.
Stap-voor-stap afleiding
Om de Bellman-vergelijking af te leiden, beginnen we met het concept van een waardefunctie. De waardefunctie, V(s)V(s)V(s), geeft de verwachte cumulatieve beloning voor het starten in een toestand sss en vervolgens het optimale beleid te volgen. Deze vergelijking is recursief, wat betekent dat ze de waarde van een toestand relateert aan de waarde van daaropvolgende toestanden.
1. Definieer de waardefunctie
De waardefunctie V(s) vertegenwoordigt de totale verwachte beloning die een agent zal ontvangen vanaf het starten in toestand sss en het volgen van het optimale beleid. Wiskundig kan ze worden uitgedrukt als:
Waarbij:
2. Toekomstige beloningen uitsplitsen
Om V(s) uit te drukken in termen van directe beloningen en de waarde van toekomstige toestanden, scheiden we de eerste beloning van de som van alle toekomstige beloningen:
Waarbij:
3. Neem de waarde van de volgende toestand op
We voegen nu de waarde toe van de volgende toestand, s', die de agent bereikt na het uitvoeren van actie a in toestand s. Dit leidt tot de vergelijking:
Waarbij:
4. De uiteindelijke Bellman-vergelijking
Na vereenvoudiging wordt de Bellman-vergelijking voor de waardefunctie V(s) als volgt:
Deze uiteindelijke vorm van de Bellman-vergelijking ontleedt de waarde van een toestand in twee componenten: de directe beloning en de verwachte waarde van de volgende toestand. Deze recursieve structuur stelt algoritmen in staat om V(s) iteratief te berekenen of te benaderen, wat helpt om in de loop van de tijd optimale beleidsopties te vinden.
Voorbeelden en toepassingen
Laten we een voorbeeld doornemen met een eenvoudige rasterwereld:
Stel je een agent voor die een doel probeert te bereiken op een raster terwijl hij obstakels vermijdt. De agent beweegt omhoog, omlaag, links of rechts en krijgt beloningen voor elke zet. Als hij het doel bereikt, krijgt hij een hogere beloning. Met behulp van de Bellman-vergelijking kunnen we de waarde voor elke toestand op het raster berekenen door de directe beloningen en de waarden van toekomstige toestanden te evalueren.
Voor Markov-beslissingsprocessen (MDP’s) helpt de Bellman-vergelijking om het optimale beleid te vinden. Als we een klein MDP hebben, zoals een bezorgprobleem waarbij een agent de snelste route moet kiezen, passen we de vergelijking toe op elk toestand-actie-paar. Zo kunnen we de beste acties berekenen die de totale verwachte beloning maximaliseren.
Geavanceerde onderwerpen: Bellman-vergelijking in Q-learning
In deze sectie bekijken we hoe de Bellman-vergelijking wordt toegepast in geavanceerde methoden zoals:
Deze technieken helpen agenten optimale acties te leren door waarde-inschattingen bij te werken, zelfs in complexe omgevingen. Het begrijpen van deze geavanceerde onderwerpen is de sleutel tot het beheersen van reinforcement learning.
Waarde-iteratie
Waarde-iteratie is een methode die de Bellman-vergelijking gebruikt om waardefuncties iteratief bij te werken. Het doel is om de optimale waarde voor elke toestand te vinden, zodat de agent de beste acties kan bepalen.
Bij waarde-iteratie werkt de agent de waarde van elke toestand bij op basis van mogelijke toekomstige toestanden en hun beloningen. Dit proces wordt herhaald totdat de waarden naar een stabiele oplossing convergeren. De convergentie-eigenschappen van waarde-iteratie zorgen ervoor dat, mits voldoende tijd, het optimale beleid wordt gevonden.
Temporal-difference learning
TD-learning is een andere aanpak die de Bellman-vergelijking gebruikt, maar verschilt op een belangrijk punt: er is geen model van de omgeving nodig.
In plaats daarvan werkt het waarde-inschattingen bij op basis van daadwerkelijke ervaringen die de agent opdoet. Dit maakt het praktischer wanneer de omgeving onbekend is. TD-learning slaat een brug tussen Monte Carlo-methoden, die vertrouwen op volledige episodes, en dynamische programmering, die een volledig model nodig heeft.
Toepassingen en use-cases
De Bellman-vergelijking kent een breed scala aan toepassingen buiten theoretische modellen. Ze speelt een cruciale rol in praktijksituaties waar besluitvorming en optimalisatie nodig zijn. In deze sectie verkennen we hoe de Bellman-vergelijking deze toepassingen ondersteunt.
Reinforcement learning in games
In klassieke game-omgevingen zoals Atari helpt de Bellman-vergelijking de acties van een agent te optimaliseren om de hoogste score te behalen. De vergelijking begeleidt de agent bij het selecteren van de beste zetten door de verwachte beloningen voor elke actie te evalueren.
Praktijkvoorbeelden zijn deep reinforcement learning-algoritmen, zoals Deep Q-Networks (DQN’s), die de Bellman-vergelijking gebruiken om game-AI te verbeteren. Met deze methoden zijn agenten getraind die menselijke spelers in diverse games overtreffen, wat de kracht van reinforcement learning aantoont.
Robotica en navigatie
In de robotica helpt de Bellman-vergelijking machines bij het nemen van beslissingen over beweging en navigatie. Robots gebruiken haar om verschillende paden te evalueren en het pad te kiezen dat toekomstige beloningen maximaliseert, zoals het snelst een doel bereiken of met de minste energie.
Met andere woorden, robots gebruiken de Bellman-vergelijking om uitkomsten te voorspellen op basis van hun huidige toestand en hun volgende zetten dienovereenkomstig te plannen. Dit besluitvormingsproces is cruciaal voor het navigeren door een doolhof of het vermijden van obstakels in dynamische omgevingen.
Conclusie
De Bellman-vergelijking is fundamenteel bij het ontwikkelen van intelligente systemen – vooral in reinforcement learning en andere gebieden van kunstmatige intelligentie. Ze vormt de basis voor algoritmen die systemen in staat stellen te leren, zich aan te passen en hun acties te optimaliseren in dynamische omgevingen, wat leidt tot efficiënter en effectiever probleemoplossen in onzekere situaties.
Hier zijn enkele bronnen om verder te leren: