Vào đầu những năm 1950, Richard Bellman, một nhà toán học và khoa học máy tính có tầm nhìn, đã bắt đầu hành trình giải mã sự phức tạp của việc ra quyết định trong các môi trường bất định. Thúc đẩy bởi nhu cầu về các phương pháp giải quyết vấn đề hiệu quả, ông đã giới thiệu khái niệm mang tính cách mạng là lập trình động, chia nhỏ các bài toán phức tạp thành các bài toán con có thể quản lý được.
Khi khám phá cách tiếp cận này, Bellman đã xây dựng nên thứ sau này được biết đến là Phương trình Bellman: một biểu thức toán học đánh giá giá trị của một quyết định tại một trạng thái nhất định dựa trên các trạng thái tương lai tiềm năng và phần thưởng đi kèm. Công trình đột phá của ông đ culminated trong cuốn sách xuất bản năm 1957, Dynamic Programming, đặt nền tảng lý thuyết cho tối ưu hóa và lý thuyết điều khiển, đồng thời mở đường cho những tiến bộ trong trí tuệ nhân tạo và học tăng cường.
Ngày nay, những ý tưởng của Bellman tiếp tục định hình cách máy móc học hỏi và thích nghi với môi trường của chúng, để lại di sản bền vững trong toán học và khoa học máy tính. Trong học tăng cường, Phương trình Bellman đóng vai trò quan trọng trong việc hiểu cách các tác tử tương tác với môi trường xung quanh, trở thành nền tảng để giải các bài toán trong Quy trình Quyết định Markov (MDP).
Trong bài viết này, chúng ta sẽ khám phá phương trình là gì, so sánh với Phương trình Tối ưu Bellman, cách nó được dùng trong học tăng cường, và hơn thế nữa.
Phương trình Bellman là gì?
Phương trình Bellman là một công thức đệ quy dùng trong ra quyết định và học tăng cường. Nó cho thấy giá trị của việc ở trong một trạng thái nhất định phụ thuộc vào phần thưởng nhận được và giá trị của các trạng thái tương lai như thế nào.
Nói đơn giản, Phương trình Bellman chia nhỏ một vấn đề phức tạp thành các bước nhỏ hơn, giúp dễ giải quyết hơn. Phương trình này giúp tìm cách tốt nhất để ra quyết định khi kết quả phụ thuộc vào một chuỗi hành động.
Về mặt toán học, Phương trình Bellman được viết như sau:
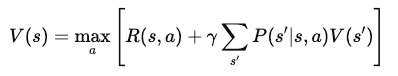
Trong đó:
- V(s): Giá trị của trạng thái sss, đại diện cho phần thưởng dài hạn khi ở trạng thái đó.
- R(s,a): Phần thưởng tức thời nhận được khi thực hiện hành động aaa tại trạng thái sss.
- γ: Hệ số chiết khấu (giữa 0 và 1) xác định mức độ quan trọng của phần thưởng tương lai so với phần thưởng tức thời.
- P(s′∣s,a) Xác suất chuyển sang trạng thái s′ từ trạng thái sss bằng cách thực hiện hành động a.
- maxa: Hành động tối ưu tối đa hóa giá trị kỳ vọng của phần thưởng tương lai.
Tổng này nhân giá trị của mỗi trạng thái tiếp theo có thể xảy ra với xác suất đạt đến trạng thái đó, từ đó phản ánh phần thưởng tương lai kỳ vọng.
Phương trình Bellman so với Phương trình Tối ưu Bellman
Phương trình Bellman tính giá trị của một trạng thái dựa trên phần thưởng từ việc thực hiện hành động và giá trị kỳ vọng của các trạng thái tương lai. Đây là phần then chốt trong việc đánh giá mức độ tốt của một chính sách khi một tác tử làm theo chính sách đó trong môi trường. Phương trình xem xét tất cả các hành động và kết quả có thể, giúp xác định giá trị của việc ở trong một trạng thái nhất định.
Ngược lại, Phương trình Tối ưu Bellman được dùng khi mục tiêu là tìm chính sách tốt nhất hay "tối ưu".
Thay vì chỉ đánh giá giá trị của một trạng thái dựa trên một chính sách cụ thể, nó tìm giá trị lớn nhất có thể đạt được bằng cách xét tất cả các hành động và chính sách khả dĩ. Phương trình Tối ưu Bellman làm điều này bằng cách lấy phần thưởng kỳ vọng lớn nhất trên tất cả hành động khả dụng tại mỗi trạng thái. Bằng cách này, nó cho chúng ta biết giá trị cao nhất có thể đạt được từ mỗi trạng thái nếu hành động theo cách tốt nhất có thể.
Nói cách khác, khác biệt chính giữa hai phương trình là trọng tâm của chúng.
Phương trình Bellman tiêu chuẩn đánh giá hiệu quả của một chính sách bằng cách ước lượng giá trị kỳ vọng khi làm theo nó. Trong khi đó, Phương trình Tối ưu Bellman nhằm tìm chính sách tốt nhất tổng thể bằng cách xác định hành động mang lại phần thưởng dài hạn tối đa ở mỗi trạng thái.
Tóm lược: Phương trình Bellman tiêu chuẩn dùng để đánh giá chính sách, còn phương trình tối ưu dùng để cải thiện chính sách và điều khiển.
Phương trình Tối ưu Bellman rất cần thiết để giải các bài toán điều khiển, nơi mục tiêu là chọn chuỗi hành động tốt nhất nhằm tối đa hóa phần thưởng. Trong các bài toán này, tác tử phải đưa ra quyết định không chỉ tối đa hóa phần thưởng tức thời mà còn tính đến phần thưởng tương lai.
Phương trình tối ưu cung cấp cách tiếp cận có hệ thống để đánh giá và chọn các hành động dẫn đến phần thưởng dài hạn cao nhất, giúp tìm được chính sách tối ưu. Nó là phần trọng tâm của các thuật toán như Q-learning và lặp giá trị, được dùng trong học tăng cường để huấn luyện tác tử hành động tốt nhất có thể.
Phương trình Bellman trong Học tăng cường
Phương trình Bellman là phần cốt lõi của học tăng cường. Nó giúp các tác tử học cách đưa ra quyết định tốt nhất bằng cách chia nhỏ các tác vụ phức tạp thành những bước nhỏ hơn.
Cụ thể, Phương trình Bellman cho phép tác tử tính toán giá trị của các trạng thái và hành động khác nhau, từ đó định hướng chọn con đường tối ưu để tối đa hóa phần thưởng.
Vì vậy, trong học tăng cường, Phương trình Bellman được dùng để đánh giá và cải thiện chính sách, giúp tác tử ra quyết định tốt hơn khi tích lũy kinh nghiệm.
Vai trò trong Q-Learning
Q-learning là một thuật toán học tăng cường phổ biến. Thuật toán tận dụng Phương trình Bellman để ước lượng giá trị của các cặp trạng thái - hành động, gọi là Q-value. Các giá trị này cho tác tử biết mức phần thưởng khi thực hiện một hành động nhất định tại một trạng thái cho trước và sau đó làm theo chính sách tốt nhất.
Phương trình Tối ưu Bellman cho Q-learning tìm giá trị kỳ vọng tối đa cho mỗi hành động, giúp tác tử xác định nước đi tốt nhất để tối đa hóa phần thưởng dài hạn.
Ví dụ, trong một bài toán học tăng cường dạng chuỗi tập (episodic), hãy tưởng tượng một tác tử di chuyển trong một lưới. Khi nó đến một trạng thái, tác tử cập nhật Q-value cho cặp trạng thái - hành động đó bằng phương trình:
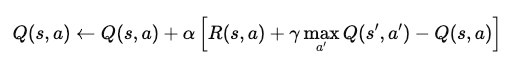
Trong đó:
- Q(s,a): Q-value cho việc thực hiện hành động a tại trạng thái s.
- α: Tốc độ học, xác định mức độ thông tin mới ghi đè lên Q-value cũ.
- R(s,a): Phần thưởng tức thời nhận được sau khi thực hiện hành động a tại trạng thái s.
- γ: Hệ số chiết khấu, dùng để cân phần thưởng tương lai so với phần thưởng tức thời.
- maxa′Q(s′,a′): Q-value lớn nhất cho trạng thái tiếp theo s′, trên tất cả hành động khả dĩ a′.
Phương trình này cập nhật Q-value dựa trên phần thưởng tức thời và phần thưởng tương lai kỳ vọng tối đa. Qua lặp lại nhiều lần, tác tử học xấp xỉ các Q-value tối ưu và có thể xác định các hành động tốt nhất để tối đa hóa phần thưởng dài hạn.
Phương trình Bellman cho đánh giá chính sách
Phương trình Bellman cũng được dùng để đánh giá chính sách bằng cách ước lượng các hàm giá trị. Trong bối cảnh này, nó tính phần thưởng dài hạn kỳ vọng khi một tác tử làm theo một chính sách nhất định từ một trạng thái cụ thể. Điều này giúp xác định hiệu quả của chính sách bằng cách cho thấy mức phần thưởng trung bình tác tử có thể kỳ vọng.
Thuật toán lặp chính sách sử dụng việc đánh giá này để cải thiện chính sách. Nó bắt đầu bằng việc ước lượng hàm giá trị cho một chính sách rồi cập nhật chính sách để chọn các hành động tốt hơn dựa trên giá trị đó. Quá trình này lặp lại cho đến khi chính sách hội tụ về chính sách tối ưu, tại thời điểm đó sẽ không thể cải thiện thêm nữa.
Suy diễn Phương trình Bellman
Trong phần này, chúng ta sẽ phân tích Phương trình Bellman từng bước, bắt đầu từ những nguyên lý đầu tiên. Sau đó, chúng ta sẽ khám phá cách phần thưởng và chuyển trạng thái xây dựng nên các hàm giá trị, định hướng tác tử chọn hành động tốt nhất.
Suy diễn từng bước
Để suy diễn Phương trình Bellman, ta bắt đầu với khái niệm hàm giá trị. Hàm giá trị, V(s)V(s)V(s), cho phần thưởng tích lũy kỳ vọng khi bắt đầu ở trạng thái sss và sau đó làm theo một chính sách tối ưu. Phương trình này mang tính đệ quy, nghĩa là nó liên hệ giá trị của một trạng thái với giá trị của các trạng thái kế tiếp.
1. Định nghĩa hàm giá trị
Hàm giá trị V(s) biểu thị tổng phần thưởng kỳ vọng mà một tác tử sẽ nhận được khi bắt đầu ở trạng thái sss và làm theo chính sách tối ưu. Về mặt toán học, có thể biểu diễn như sau:
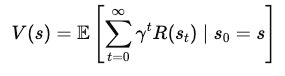
Trong đó:
- s là trạng thái hiện tại,
- γ là hệ số chiết khấu (giữa 0 và 1), điều khiển tầm quan trọng của phần thưởng tương lai,
- R(st) là phần thưởng nhận được tại mỗi bước thời gian t.
2. Tách phần thưởng tương lai
Để biểu diễn V(s) theo phần thưởng tức thời và giá trị của các trạng thái tương lai, ta tách phần thưởng đầu tiên ra khỏi tổng các phần thưởng tương lai:
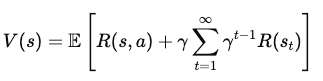
Trong đó:
- R(s, a) là phần thưởng tức thời thu được khi thực hiện hành động a tại trạng thái s,
- γ Σ (γ(t1)) R(st) biểu diễn tổng chiết khấu của các phần thưởng tương lai.
3. Bổ sung giá trị trạng thái kế tiếp
Giờ ta thêm giá trị của trạng thái kế tiếp, s', mà tác tử đạt tới sau khi thực hiện hành động a tại trạng thái s. Điều này dẫn đến phương trình:
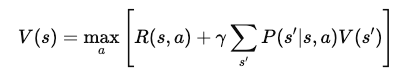
Trong đó:
- P(s' | s, a) là xác suất chuyển sang trạng thái s' từ trạng thái s sau khi thực hiện hành động a,
- maxa biểu thị việc chọn hành động a để tối đa hóa phần thưởng kỳ vọng.
4. Phương trình Bellman cuối cùng
Sau khi rút gọn, Phương trình Bellman cho hàm giá trị V(s) trở thành:
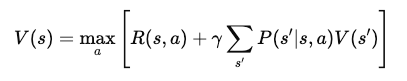
Dạng cuối cùng này của Phương trình Bellman phân rã giá trị của một trạng thái thành hai thành phần: phần thưởng tức thời và giá trị kỳ vọng của trạng thái kế tiếp. Cấu trúc đệ quy này cho phép các thuật toán tính toán hoặc xấp xỉ V(s) một cách lặp, giúp tìm ra các chính sách tối ưu theo thời gian.
Ví dụ và ứng dụng
Hãy cùng đi qua một ví dụ với thế giới lưới đơn giản:
Hãy tưởng tượng một tác tử cố gắng đến đích trên một lưới trong khi tránh chướng ngại vật. Tác tử di chuyển lên, xuống, trái, hoặc phải và nhận phần thưởng cho mỗi bước đi. Nếu đến đích, nó nhận phần thưởng cao hơn. Dùng Phương trình Bellman, ta có thể tính giá trị cho mỗi trạng thái trên lưới bằng cách đánh giá phần thưởng tức thời và giá trị các trạng thái tương lai.
Đối với Quy trình Quyết định Markov (MDP), Phương trình Bellman giúp tìm chính sách tối ưu. Nếu ta có một MDP nhỏ, như bài toán giao hàng nơi tác tử phải chọn tuyến nhanh nhất, ta áp dụng phương trình cho từng cặp trạng thái - hành động. Bằng cách đó, ta có thể tính các hành động tốt nhất để tối đa hóa tổng phần thưởng kỳ vọng.
Chủ đề nâng cao: Phương trình Bellman trong Q-Learning
Trong phần này, chúng ta khám phá cách Phương trình Bellman được áp dụng trong các phương pháp nâng cao như:
- Lặp giá trị
- Học sai khác theo thời gian (Temporal-Difference).
Các kỹ thuật này giúp tác tử học các hành động tối ưu bằng cách cập nhật các ước lượng giá trị, ngay cả trong môi trường phức tạp. Hiểu các chủ đề nâng cao này là chìa khóa để làm chủ học tăng cường.
Lặp giá trị
Lặp giá trị là một phương pháp sử dụng Phương trình Bellman để cập nhật các hàm giá trị một cách lặp. Mục tiêu là tìm giá trị tối ưu cho mỗi trạng thái để tác tử có thể xác định các hành động tốt nhất.
Trong lặp giá trị, tác tử cập nhật giá trị của mỗi trạng thái dựa trên các trạng thái tương lai có thể và phần thưởng của chúng. Quá trình này lặp lại cho đến khi các giá trị hội tụ về nghiệm ổn định. Tính chất hội tụ của lặp giá trị đảm bảo rằng, nếu đủ thời gian, nó sẽ tìm được chính sách tối ưu.
Học sai khác theo thời gian
TD learning là một cách tiếp cận khác cũng sử dụng Phương trình Bellman nhưng khác biệt quan trọng ở chỗ — nó không cần mô hình của môi trường.
Thay vào đó, nó cập nhật các ước lượng giá trị dựa trên trải nghiệm thực tế mà tác tử thu thập được. Điều này làm cho nó thực tiễn hơn khi môi trường chưa biết. TD learning bắc cầu giữa các phương pháp Monte Carlo, vốn dựa vào các tập đầy đủ, và lập trình động, vốn cần mô hình đầy đủ.
Ứng dụng và Trường hợp sử dụng
Phương trình Bellman có phạm vi ứng dụng rộng rãi vượt ra ngoài các mô hình lý thuyết. Nó đóng vai trò quan trọng trong các tình huống thực tế cần ra quyết định và tối ưu hóa. Phần này khám phá cách Phương trình Bellman hỗ trợ các ứng dụng đó.
Học tăng cường trong trò chơi
Trong các môi trường chơi game kinh điển như Atari, Phương trình Bellman giúp tối ưu hóa hành động của tác tử để đạt điểm cao nhất. Phương trình định hướng tác tử chọn nước đi tốt nhất bằng cách đánh giá phần thưởng kỳ vọng cho mỗi hành động.
Các ví dụ thực tế bao gồm việc sử dụng các thuật toán học tăng cường sâu như Deep Q-Networks (DQN), tận dụng Phương trình Bellman để cải thiện AI trong game. Những phương pháp này đã được dùng để huấn luyện tác tử vượt trội hơn người chơi trong nhiều trò, cho thấy sức mạnh của học tăng cường.
Robot và định hướng dẫn đường
Trong lĩnh vực robot, Phương trình Bellman giúp máy móc đưa ra quyết định về di chuyển và dẫn đường. Robot dùng nó để đánh giá các lộ trình khác nhau và chọn lộ trình tối đa hóa phần thưởng tương lai, chẳng hạn như đến đích trong thời gian ngắn nhất hoặc tốn ít năng lượng nhất.
Nói cách khác, robot sử dụng phương trình Bellman để giúp dự đoán kết quả dựa trên trạng thái hiện tại và lên kế hoạch bước đi tiếp theo tương ứng. Quy trình ra quyết định này rất quan trọng để vượt mê cung hoặc tránh chướng ngại vật trong môi trường động.
Kết luận
Phương trình Bellman là nền tảng trong phát triển các hệ thống thông minh – đặc biệt trong học tăng cường và các lĩnh vực khác của trí tuệ nhân tạo. Nó là cơ sở cho các thuật toán cho phép hệ thống học hỏi, thích nghi và tối ưu hóa hành động trong môi trường động, dẫn đến việc giải quyết vấn đề hiệu quả hơn trong các bối cảnh bất định.
Dưới đây là một số tài nguyên để bạn tiếp tục học:


 Matt Crabtree · 10 min
Vào đầu những năm 1950, Richard Bellman, một nhà toán học và khoa học máy tính có tầm nhìn, đã bắt đầu hành trình giải mã sự phức tạp của việc ra quyết định trong các môi trường bất định. Thúc đẩy bởi nhu cầu về các phương pháp giải quyết vấn đề hiệu quả, ông đã giới thiệu khái niệm mang tính cách mạng là lập trình động, chia nhỏ các bài toán phức tạp thành các bài toán con có thể quản lý được.
Khi khám phá cách tiếp cận này, Bellman đã xây dựng nên thứ sau này được biết đến là Phương trình Bellman: một biểu thức toán học đánh giá giá trị của một quyết định tại một trạng thái nhất định dựa trên các trạng thái tương lai tiềm năng và phần thưởng đi kèm. Công trình đột phá của ông đ culminated trong cuốn sách xuất bản năm 1957, Dynamic Programming, đặt nền tảng lý thuyết cho tối ưu hóa và lý thuyết điều khiển, đồng thời mở đường cho những tiến bộ trong trí tuệ nhân tạo và học tăng cường.
Ngày nay, những ý tưởng của Bellman tiếp tục định hình cách máy móc học hỏi và thích nghi với môi trường của chúng, để lại di sản bền vững trong toán học và khoa học máy tính. Trong học tăng cường, Phương trình Bellman đóng vai trò quan trọng trong việc hiểu cách các tác tử tương tác với môi trường xung quanh, trở thành nền tảng để giải các bài toán trong Quy trình Quyết định Markov (MDP).
Trong bài viết này, chúng ta sẽ khám phá phương trình là gì, so sánh với Phương trình Tối ưu Bellman, cách nó được dùng trong học tăng cường, và hơn thế nữa.
Phương trình Bellman là gì?
Phương trình Bellman là một công thức đệ quy dùng trong ra quyết định và học tăng cường. Nó cho thấy giá trị của việc ở trong một trạng thái nhất định phụ thuộc vào phần thưởng nhận được và giá trị của các trạng thái tương lai như thế nào.
Nói đơn giản, Phương trình Bellman chia nhỏ một vấn đề phức tạp thành các bước nhỏ hơn, giúp dễ giải quyết hơn. Phương trình này giúp tìm cách tốt nhất để ra quyết định khi kết quả phụ thuộc vào một chuỗi hành động.
Về mặt toán học, Phương trình Bellman được viết như sau:
Trong đó:
Tổng này nhân giá trị của mỗi trạng thái tiếp theo có thể xảy ra với xác suất đạt đến trạng thái đó, từ đó phản ánh phần thưởng tương lai kỳ vọng.
Phương trình Bellman so với Phương trình Tối ưu Bellman
Phương trình Bellman tính giá trị của một trạng thái dựa trên phần thưởng từ việc thực hiện hành động và giá trị kỳ vọng của các trạng thái tương lai. Đây là phần then chốt trong việc đánh giá mức độ tốt của một chính sách khi một tác tử làm theo chính sách đó trong môi trường. Phương trình xem xét tất cả các hành động và kết quả có thể, giúp xác định giá trị của việc ở trong một trạng thái nhất định.
Ngược lại, Phương trình Tối ưu Bellman được dùng khi mục tiêu là tìm chính sách tốt nhất hay "tối ưu".
Thay vì chỉ đánh giá giá trị của một trạng thái dựa trên một chính sách cụ thể, nó tìm giá trị lớn nhất có thể đạt được bằng cách xét tất cả các hành động và chính sách khả dĩ. Phương trình Tối ưu Bellman làm điều này bằng cách lấy phần thưởng kỳ vọng lớn nhất trên tất cả hành động khả dụng tại mỗi trạng thái. Bằng cách này, nó cho chúng ta biết giá trị cao nhất có thể đạt được từ mỗi trạng thái nếu hành động theo cách tốt nhất có thể.
Nói cách khác, khác biệt chính giữa hai phương trình là trọng tâm của chúng.
Phương trình Bellman tiêu chuẩn đánh giá hiệu quả của một chính sách bằng cách ước lượng giá trị kỳ vọng khi làm theo nó. Trong khi đó, Phương trình Tối ưu Bellman nhằm tìm chính sách tốt nhất tổng thể bằng cách xác định hành động mang lại phần thưởng dài hạn tối đa ở mỗi trạng thái.
Tóm lược: Phương trình Bellman tiêu chuẩn dùng để đánh giá chính sách, còn phương trình tối ưu dùng để cải thiện chính sách và điều khiển.
Phương trình Tối ưu Bellman rất cần thiết để giải các bài toán điều khiển, nơi mục tiêu là chọn chuỗi hành động tốt nhất nhằm tối đa hóa phần thưởng. Trong các bài toán này, tác tử phải đưa ra quyết định không chỉ tối đa hóa phần thưởng tức thời mà còn tính đến phần thưởng tương lai.
Phương trình tối ưu cung cấp cách tiếp cận có hệ thống để đánh giá và chọn các hành động dẫn đến phần thưởng dài hạn cao nhất, giúp tìm được chính sách tối ưu. Nó là phần trọng tâm của các thuật toán như Q-learning và lặp giá trị, được dùng trong học tăng cường để huấn luyện tác tử hành động tốt nhất có thể.
Phương trình Bellman trong Học tăng cường
Phương trình Bellman là phần cốt lõi của học tăng cường. Nó giúp các tác tử học cách đưa ra quyết định tốt nhất bằng cách chia nhỏ các tác vụ phức tạp thành những bước nhỏ hơn.
Cụ thể, Phương trình Bellman cho phép tác tử tính toán giá trị của các trạng thái và hành động khác nhau, từ đó định hướng chọn con đường tối ưu để tối đa hóa phần thưởng.
Vì vậy, trong học tăng cường, Phương trình Bellman được dùng để đánh giá và cải thiện chính sách, giúp tác tử ra quyết định tốt hơn khi tích lũy kinh nghiệm.
Vai trò trong Q-Learning
Q-learning là một thuật toán học tăng cường phổ biến. Thuật toán tận dụng Phương trình Bellman để ước lượng giá trị của các cặp trạng thái - hành động, gọi là Q-value. Các giá trị này cho tác tử biết mức phần thưởng khi thực hiện một hành động nhất định tại một trạng thái cho trước và sau đó làm theo chính sách tốt nhất.
Phương trình Tối ưu Bellman cho Q-learning tìm giá trị kỳ vọng tối đa cho mỗi hành động, giúp tác tử xác định nước đi tốt nhất để tối đa hóa phần thưởng dài hạn.
Ví dụ, trong một bài toán học tăng cường dạng chuỗi tập (episodic), hãy tưởng tượng một tác tử di chuyển trong một lưới. Khi nó đến một trạng thái, tác tử cập nhật Q-value cho cặp trạng thái - hành động đó bằng phương trình:
Trong đó:
Phương trình này cập nhật Q-value dựa trên phần thưởng tức thời và phần thưởng tương lai kỳ vọng tối đa. Qua lặp lại nhiều lần, tác tử học xấp xỉ các Q-value tối ưu và có thể xác định các hành động tốt nhất để tối đa hóa phần thưởng dài hạn.
Phương trình Bellman cho đánh giá chính sách
Phương trình Bellman cũng được dùng để đánh giá chính sách bằng cách ước lượng các hàm giá trị. Trong bối cảnh này, nó tính phần thưởng dài hạn kỳ vọng khi một tác tử làm theo một chính sách nhất định từ một trạng thái cụ thể. Điều này giúp xác định hiệu quả của chính sách bằng cách cho thấy mức phần thưởng trung bình tác tử có thể kỳ vọng.
Thuật toán lặp chính sách sử dụng việc đánh giá này để cải thiện chính sách. Nó bắt đầu bằng việc ước lượng hàm giá trị cho một chính sách rồi cập nhật chính sách để chọn các hành động tốt hơn dựa trên giá trị đó. Quá trình này lặp lại cho đến khi chính sách hội tụ về chính sách tối ưu, tại thời điểm đó sẽ không thể cải thiện thêm nữa.
Suy diễn Phương trình Bellman
Trong phần này, chúng ta sẽ phân tích Phương trình Bellman từng bước, bắt đầu từ những nguyên lý đầu tiên. Sau đó, chúng ta sẽ khám phá cách phần thưởng và chuyển trạng thái xây dựng nên các hàm giá trị, định hướng tác tử chọn hành động tốt nhất.
Suy diễn từng bước
Để suy diễn Phương trình Bellman, ta bắt đầu với khái niệm hàm giá trị. Hàm giá trị, V(s)V(s)V(s), cho phần thưởng tích lũy kỳ vọng khi bắt đầu ở trạng thái sss và sau đó làm theo một chính sách tối ưu. Phương trình này mang tính đệ quy, nghĩa là nó liên hệ giá trị của một trạng thái với giá trị của các trạng thái kế tiếp.
1. Định nghĩa hàm giá trị
Hàm giá trị V(s) biểu thị tổng phần thưởng kỳ vọng mà một tác tử sẽ nhận được khi bắt đầu ở trạng thái sss và làm theo chính sách tối ưu. Về mặt toán học, có thể biểu diễn như sau:
Trong đó:
2. Tách phần thưởng tương lai
Để biểu diễn V(s) theo phần thưởng tức thời và giá trị của các trạng thái tương lai, ta tách phần thưởng đầu tiên ra khỏi tổng các phần thưởng tương lai:
Trong đó:
3. Bổ sung giá trị trạng thái kế tiếp
Giờ ta thêm giá trị của trạng thái kế tiếp, s', mà tác tử đạt tới sau khi thực hiện hành động a tại trạng thái s. Điều này dẫn đến phương trình:
Trong đó:
4. Phương trình Bellman cuối cùng
Sau khi rút gọn, Phương trình Bellman cho hàm giá trị V(s) trở thành:
Dạng cuối cùng này của Phương trình Bellman phân rã giá trị của một trạng thái thành hai thành phần: phần thưởng tức thời và giá trị kỳ vọng của trạng thái kế tiếp. Cấu trúc đệ quy này cho phép các thuật toán tính toán hoặc xấp xỉ V(s) một cách lặp, giúp tìm ra các chính sách tối ưu theo thời gian.
Ví dụ và ứng dụng
Hãy cùng đi qua một ví dụ với thế giới lưới đơn giản:
Hãy tưởng tượng một tác tử cố gắng đến đích trên một lưới trong khi tránh chướng ngại vật. Tác tử di chuyển lên, xuống, trái, hoặc phải và nhận phần thưởng cho mỗi bước đi. Nếu đến đích, nó nhận phần thưởng cao hơn. Dùng Phương trình Bellman, ta có thể tính giá trị cho mỗi trạng thái trên lưới bằng cách đánh giá phần thưởng tức thời và giá trị các trạng thái tương lai.
Đối với Quy trình Quyết định Markov (MDP), Phương trình Bellman giúp tìm chính sách tối ưu. Nếu ta có một MDP nhỏ, như bài toán giao hàng nơi tác tử phải chọn tuyến nhanh nhất, ta áp dụng phương trình cho từng cặp trạng thái - hành động. Bằng cách đó, ta có thể tính các hành động tốt nhất để tối đa hóa tổng phần thưởng kỳ vọng.
Chủ đề nâng cao: Phương trình Bellman trong Q-Learning
Trong phần này, chúng ta khám phá cách Phương trình Bellman được áp dụng trong các phương pháp nâng cao như:
Các kỹ thuật này giúp tác tử học các hành động tối ưu bằng cách cập nhật các ước lượng giá trị, ngay cả trong môi trường phức tạp. Hiểu các chủ đề nâng cao này là chìa khóa để làm chủ học tăng cường.
Lặp giá trị
Lặp giá trị là một phương pháp sử dụng Phương trình Bellman để cập nhật các hàm giá trị một cách lặp. Mục tiêu là tìm giá trị tối ưu cho mỗi trạng thái để tác tử có thể xác định các hành động tốt nhất.
Trong lặp giá trị, tác tử cập nhật giá trị của mỗi trạng thái dựa trên các trạng thái tương lai có thể và phần thưởng của chúng. Quá trình này lặp lại cho đến khi các giá trị hội tụ về nghiệm ổn định. Tính chất hội tụ của lặp giá trị đảm bảo rằng, nếu đủ thời gian, nó sẽ tìm được chính sách tối ưu.
Học sai khác theo thời gian
TD learning là một cách tiếp cận khác cũng sử dụng Phương trình Bellman nhưng khác biệt quan trọng ở chỗ — nó không cần mô hình của môi trường.
Thay vào đó, nó cập nhật các ước lượng giá trị dựa trên trải nghiệm thực tế mà tác tử thu thập được. Điều này làm cho nó thực tiễn hơn khi môi trường chưa biết. TD learning bắc cầu giữa các phương pháp Monte Carlo, vốn dựa vào các tập đầy đủ, và lập trình động, vốn cần mô hình đầy đủ.
Ứng dụng và Trường hợp sử dụng
Phương trình Bellman có phạm vi ứng dụng rộng rãi vượt ra ngoài các mô hình lý thuyết. Nó đóng vai trò quan trọng trong các tình huống thực tế cần ra quyết định và tối ưu hóa. Phần này khám phá cách Phương trình Bellman hỗ trợ các ứng dụng đó.
Học tăng cường trong trò chơi
Trong các môi trường chơi game kinh điển như Atari, Phương trình Bellman giúp tối ưu hóa hành động của tác tử để đạt điểm cao nhất. Phương trình định hướng tác tử chọn nước đi tốt nhất bằng cách đánh giá phần thưởng kỳ vọng cho mỗi hành động.
Các ví dụ thực tế bao gồm việc sử dụng các thuật toán học tăng cường sâu như Deep Q-Networks (DQN), tận dụng Phương trình Bellman để cải thiện AI trong game. Những phương pháp này đã được dùng để huấn luyện tác tử vượt trội hơn người chơi trong nhiều trò, cho thấy sức mạnh của học tăng cường.
Robot và định hướng dẫn đường
Trong lĩnh vực robot, Phương trình Bellman giúp máy móc đưa ra quyết định về di chuyển và dẫn đường. Robot dùng nó để đánh giá các lộ trình khác nhau và chọn lộ trình tối đa hóa phần thưởng tương lai, chẳng hạn như đến đích trong thời gian ngắn nhất hoặc tốn ít năng lượng nhất.
Nói cách khác, robot sử dụng phương trình Bellman để giúp dự đoán kết quả dựa trên trạng thái hiện tại và lên kế hoạch bước đi tiếp theo tương ứng. Quy trình ra quyết định này rất quan trọng để vượt mê cung hoặc tránh chướng ngại vật trong môi trường động.
Kết luận
Phương trình Bellman là nền tảng trong phát triển các hệ thống thông minh – đặc biệt trong học tăng cường và các lĩnh vực khác của trí tuệ nhân tạo. Nó là cơ sở cho các thuật toán cho phép hệ thống học hỏi, thích nghi và tối ưu hóa hành động trong môi trường động, dẫn đến việc giải quyết vấn đề hiệu quả hơn trong các bối cảnh bất định.
Dưới đây là một số tài nguyên để bạn tiếp tục học: