1950’lerin başında, vizyoner bir matematikçi ve bilgisayar bilimci olan Richard Bellman, belirsiz ortamlarda karar verme süreçlerinin karmaşıklığını çözmek için bir yolculuğa çıktı. Verimli problem çözme yöntemlerine duyulan ihtiyaçtan hareketle, karmaşık problemleri yönetilebilir alt problemlere bölen devrim niteliğinde bir yaklaşım olan dinamik programlama kavramını ortaya koydu.
Bu yaklaşımı incelerken Bellman, daha sonra Bellman Denklemi olarak anılacak olanı formüle etti: belirli bir durumda verilen bir kararın değerini, olası gelecekteki durumlar ve onlarla ilişkili ödüller temelinde değerlendiren matematiksel bir ifade. Öncü çalışması, 1957 tarihli Dynamic Programming adlı kitabının yayımlanmasıyla doruğa ulaştı; bu eser, optimizasyon ve kontrol kuramının teorik temelini atarken yapay zekâ ve pekiştirmeli öğrenme alanındaki gelişmelerin de önünü açtı.
Günümüzde Bellman’ın fikirleri, makinelerin çevrelerine nasıl uyum sağladığını ve öğrendiğini şekillendirmeye devam ederek matematik ve bilgisayar bilimlerinde kalıcı bir miras bırakmaktadır. Pekiştirmeli öğrenmede Bellman Denklemi, ajanların çevreleriyle nasıl etkileşime girdiğini anlamada kritik öneme sahiptir ve Markov Karar Süreçleri (MDP’ler) kapsamındaki çeşitli sorunları çözmede temel bir rol oynar.
Bu yazıda, denklemin ne olduğunu, Bellman Optimalite Denklemi ile nasıl karşılaştırıldığını, pekiştirmeli öğrenmede nasıl kullanıldığını ve daha fazlasını inceleyeceğiz.
Bellman Denklemi nedir?
Bellman Denklemi, karar verme ve pekiştirmeli öğrenmede kullanılan özyinelemeli bir formüldür. Belirli bir durumda bulunmanın değerinin, alınan ödüllere ve gelecekteki durumların değerine nasıl bağlı olduğunu gösterir.
Basitçe söylemek gerekirse, Bellman Denklemi karmaşık bir problemi daha küçük adımlara ayırarak çözmeyi kolaylaştırır. Sonuçların bir dizi eyleme bağlı olduğu durumlarda en iyi karar verme yolunu bulmaya yardımcı olur.
Matematiksel olarak Bellman Denklemi şu şekilde yazılır:
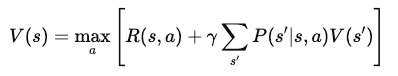
Burada:
- V(s): s durumunun değeri; bu, o durumda bulunmanın uzun vadeli ödülünü temsil eder.
- R(s,a): s durumunda a eylemini yapmaya karşılık alınan anlık ödül.
- γ: Gelecekteki ödüllerin, anlık ödüllere kıyasla önemini belirleyen indirim (iskonto) faktörü (0 ile 1 arasında).
- P(s′∣s,a): s durumunda a eylemini yaparak s′ durumuna geçiş olasılığı.
- maxa: Beklenen gelecekteki ödüllerin değerini ençoklayan (maksimize eden) en iyi eylem.
Bu toplam, her olası bir sonraki durumun değerini o duruma ulaşma olasılığıyla çarpar; böylece beklenen gelecekteki ödülleri etkili bir şekilde yakalar.
Bellman Denklemi ve Bellman Optimalite Denklemi
Bellman Denklemi, bir durumda bulunmanın değerini, eylemlerden elde edilen ödüller ve gelecekteki durumların beklenen değeri üzerinden hesaplar. Bir ajanın bir ortamda bir politikayı izlediğinde o politikanın ne kadar iyi olduğunu değerlendirmede kilit bir bileşendir. Denklem, tüm olası eylem ve sonuçları ele alarak belirli bir durumda bulunmanın değerini belirlemeye yardımcı olur.
Buna karşılık, Bellman Optimalite Denklemi hedefin en iyi, yani "optimal" politikayı bulmak olduğu durumda kullanılır.
Belirli bir politikaya göre bir durumun değerini yalnızca değerlendirmek yerine, tüm olası eylem ve politikaları dikkate alarak ulaşılabilecek en büyük değeri bulur. Bellman Optimalite Denklemi bunu, her durumda mevcut tüm eylemler üzerinden beklenen ödülün maksimumunu alarak yapar. Böylece, her durumdan en iyi şekilde hareket edersek elde edebileceğimiz en yüksek değeri verir.
Başka bir deyişle, iki denklem arasındaki temel fark odak noktalarıdır.
Standart Bellman Denklemi, bir politikayı izlediğinizde beklenen değeri tahmin ederek o politikanın etkinliğini değerlendirir. Öte yandan Bellman Optimalite Denklemi, her durumda uzun vadeli ödülü maksimum yapan eylemi bularak genel anlamda en iyi politikayı belirlemeyi amaçlar.
Kısaca: Standart Bellman Denklemi politika değerlendirme için, optimalite denklemi ise politika iyileştirme ve kontrol için kullanılır.
Bellman Optimalite Denklemi, ödülleri ençoklamak için en iyi eylem dizisini seçmenin amaçlandığı kontrol problemlerinin çözümünde esastır. Bu tür problemlerde ajanlar, hem anlık ödülleri ençoklayacak hem de gelecekteki ödülleri dikkate alacak kararlar vermelidir.
Optimalite denklemi, en yüksek uzun vadeli ödüle götüren eylemleri sistematik olarak değerlendirme ve seçme yolu sağlar; böylece optimal politikayı bulmaya yardımcı olur. Bu denklem, Q-learning ve değer yinelemesi gibi algoritmaların merkezinde yer alır; bu algoritmalar, pekiştirmeli öğrenmede ajanları mümkün olan en iyi şekilde hareket etmeleri için eğitmekte kullanılır.
Pekiştirmeli Öğrenmede Bellman Denklemi
Bellman Denklemi, pekiştirmeli öğrenmenin çekirdek bir parçasıdır. Karmaşık görevleri daha küçük adımlara bölerek ajanların en iyi kararları nasıl vereceğini öğrenmesine yardımcı olur.
Özellikle, Bellman Denklemi, ajanların farklı durum ve eylemlerin değerini hesaplamasını sağlar; bu da ödülleri ençoklamak için en iyi yolu seçmelerine rehberlik eder.
Dolayısıyla, pekiştirmeli öğrenmede Bellman Denklemi, politikaları değerlendirmek ve iyileştirmek için kullanılır; böylece ajanlar deneyim kazandıkça daha iyi kararlar verir.
Q-Learning içindeki rolü
Q-learning, popüler bir pekiştirmeli öğrenme algoritmasıdır. Algoritma, durum-eylem çiftlerinin değerini (Q-değerleri) tahmin etmek için Bellman Denklemi’nden yararlanır. Bu değerler, ajana belirli bir durumda belirli bir eylemi yapmanın ne kadar ödüllendirici olacağını ve ardından en iyi politikayı izlemenin getirisini söyler.
Q-learning için Bellman Optimalite Denklemi, her eylem için beklenen maksimum değeri bulur; bu da ajanların uzun vadeli ödüllerini ençoklayacak en iyi hamleleri belirlemesine yardımcı olur.
Örneğin, epizodik bir pekiştirmeli öğrenme probleminde, bir ızgara dünyasında gezinmeye çalışan bir ajan hayal edin. Bir duruma ulaştığında, ajan ilgili durum-eylem çifti için Q-değerini şu denklemi kullanarak günceller:
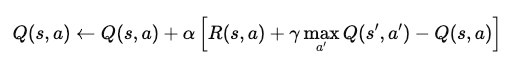
Burada:
- Q(s,a): s durumunda a eylemini yapmanın Q-değeri.
- α: Öğrenme oranı; yeni bilginin eski Q-değeri üzerindeki baskınlığını belirler.
- R(s,a): s durumunda a eylemini takiben alınan anlık ödül.
- γ: İndirim faktörü; gelecekteki ödülleri anlık ödüllere göre ne ölçüde tartacağımızı belirler.
- maxa′Q(s′,a′): Bir sonraki s′ durumu için, olası tüm a′ eylemleri arasında maksimum Q-değeri.
Bu denklem, Q-değerini anlık ödül ve beklenen en yüksek gelecekteki ödüller temelinde günceller. Tekrarlı uygulama yoluyla, ajan optimal Q-değerlerini yaklaşık olarak öğrenir ve uzun vadeli ödülleri ençoklayacak en iyi eylemleri belirleyebilir.
Politika değerlendirme için Bellman Denklemi
Bellman Denklemi, değer fonksiyonlarını tahmin ederek politikaları değerlendirmede de kullanılır. Bu bağlamda, bir ajanın belirli bir durumdan başlayarak verilen bir politikayı izlediğinde beklenen uzun vadeli ödülü hesaplar. Bu, ajanın ortalama olarak bekleyebileceği ödülü göstererek bir politikanın ne kadar etkili olduğunu belirlemeye yardımcı olur.
Politika yinelemesi (policy iteration) algoritması, bu değerlendirmeyi kullanarak politikaları iyileştirir. Önce bir politika için değer fonksiyonu tahmin edilir, ardından bu değere dayanarak daha iyi eylemler seçmek üzere politika güncellenir. Bu süreç, politika optimal olana yakınsayana kadar tekrarlanır; bu noktada daha fazla iyileştirme yapılamaz.
Bellman Denkleminin Türetilmesi
Bu bölümde, Bellman Denklemini ilk ilkelerden başlayarak adım adım ele alacağız. Ardından, ödüller ve geçişlerin değer fonksiyonlarını nasıl oluşturduğunu ve ajanların en iyi eylemleri seçmesine nasıl rehberlik ettiğini inceleyeceğiz.
Adım adım türetim
Bellman Denklemini türetmek için değer fonksiyonu kavramıyla başlarız. Değer fonksiyonu, V(s)V(s)V(s), s durumundan başlayıp sonrasında optimal bir politikayı izleyerek beklenen kümülatif ödülü verir. Bu denklem özyinelemelidir; yani bir durumun değerini, onu izleyen durumların değerleriyle ilişkilendirir.
1. Değer fonksiyonunu tanımlayın
Değer fonksiyonu V(s), bir ajanın s durumundan başlayarak optimal politikayı izlediğinde alacağı toplam beklenen ödülü temsil eder. Matematiksel olarak şöyle ifade edilebilir:
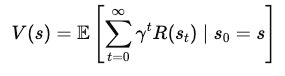
Burada:
- s mevcut durumdur,
- γ indirim (iskonto) faktörüdür (0 ile 1 arasında) ve gelecekteki ödüllerin önemini kontrol eder,
- R(st) her bir t zaman adımında alınan ödüldür.
2. Gelecekteki ödülleri açımlama
V(s) ’i anlık ödüller ve gelecekteki durumların değeri cinsinden ifade etmek için, ilk ödülü tüm gelecekteki ödüllerin toplamından ayırırız:
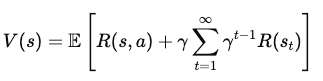
Burada:
- R(s, a), s durumunda a eylemini yaparak elde edilen anlık ödüldür,
- γ Σ (γ(t1)) R(st), gelecekteki ödüllerin iskonto edilmiş toplamını temsil eder.
3. Sonraki durum değerini dahil edin
Şimdi, ajan s durumunda a eylemini gerçekleştirdikten sonra ulaştığı s' bir sonraki durumunun değerini ekleriz. Bu, şu denkleme yol açar:
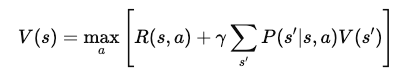
Burada:
- P(s' | s, a), s durumundan s' durumuna, a eylemi sonrasında geçiş olasılığıdır,
- maxa, beklenen ödülü ençoklayan a eyleminin seçimini temsil eder.
4. Nihai Bellman Denklemi
Basitleştirdikten sonra, değer fonksiyonu V(s) için Bellman Denklemi şu hale gelir:
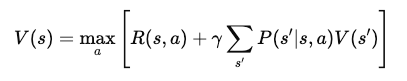
Bu nihai biçim, bir durumun değerini iki bileşene ayırır: anlık ödül ve bir sonraki durumun beklenen değeri. Bu özyinelemeli yapı, algoritmaların V(s) ’i yinelemeli olarak hesaplamasını veya yaklaşık olarak bulmasını sağlar; bu da zaman içinde optimal politikaların bulunmasına yardımcı olur.
Örnekler ve uygulamalar
Basit bir ızgara dünyası üzerinden bir örnek inceleyelim:
Bir ajanın, engellerden kaçınarak ızgarada bir hedefe ulaşmaya çalıştığını düşünün. Ajan yukarı, aşağı, sola veya sağa hareket eder ve her hamle için ödüller alır. Hedefe ulaştığında daha yüksek bir ödül kazanır. Bellman Denklemini kullanarak, anlık ödülleri ve gelecekteki durum değerlerini değerlendirerek ızgaradaki her durum için değeri hesaplayabiliriz.
Markov Karar Süreçleri (MDP’ler) için Bellman Denklemi, optimal politikayı bulmaya yardımcı olur. Bir teslimat problemini andıran ve ajanın en hızlı rotayı seçmesi gereken küçük bir MDP’miz olduğunu varsayalım; denklemi her durum-eylem çiftine uygularız. Böyle yaparak toplam beklenen ödülü ençoklayacak en iyi eylemleri hesaplayabiliriz.
İleri Konular: Q-Learning’de Bellman Denklemi
Bu bölümde Bellman Denkleminin şu ileri yöntemlerde nasıl uygulandığını inceliyoruz:
- Değer yinelemesi (value iteration)
- Zamansal-Fark (Temporal-Difference) öğrenme.
Bu teknikler, karmaşık ortamlarda bile değer tahminlerini güncelleyerek ajanların optimal eylemleri öğrenmesine yardımcı olur. Bu ileri konuları anlamak, pekiştirmeli öğrenmede ustalaşmanın anahtarıdır.
Değer yinelemesi
Değer yinelemesi, değer fonksiyonlarını yinelemeli olarak güncellemek için Bellman Denklemini kullanan bir yöntemdir. Amaç, her durum için optimal değeri bulmaktır; böylece ajan en iyi eylemleri belirleyebilir.
Değer yinelemesinde, ajan her bir durumun değerini olası gelecekteki durumlar ve onların ödüllerine dayanarak günceller. Bu süreç, değerler kararlı bir çözüme yakınsayana kadar tekrarlanır. Değer yinelemesinin yakınsama özellikleri, yeterli süre verildiğinde optimal politikayı bulacağından emin olmamızı sağlar.
Zamansal-fark öğrenme
TD öğrenme, Bellman Denklemini kullanan ancak önemli bir açıdan farklılaşan başka bir yaklaşımdır — çevrenin bir modeline ihtiyaç duymaz.
Bunun yerine, değer tahminlerini ajanın topladığı gerçek deneyimlere dayanarak günceller. Bu da çevrenin bilinmediği durumlarda daha pratik olmasını sağlar. TD öğrenme, tam bölümler (epizodlar) gerektiren Monte Carlo yöntemleri ile tam bir model gerektiren dinamik programlama arasındaki boşluğu doldurur.
Uygulamalar ve Kullanım Senaryoları
Bellman Denklemi, teorik modellerin ötesinde geniş bir uygulama yelpazesine sahiptir. Karar verme ve optimizasyonun gerekli olduğu gerçek dünya senaryolarında kritik bir rol oynar. Bu bölüm, Bellman Denkleminin bu uygulamaları nasıl desteklediğini inceler.
Oyunlarda pekiştirmeli öğrenme
Atari gibi klasik oyun ortamlarında Bellman Denklemi, ajanın en yüksek skoru elde etmek için eylemlerini optimize etmesine yardımcı olur. Denklem, her eylem için beklenen ödülleri değerlendirerek ajanın en iyi hamleleri seçmesine rehberlik eder.
Gerçek dünya örnekleri arasında, Bellman Denklemini kullanan Derin Pekiştirmeli Öğrenme algoritmaları (ör. Deep Q-Networks, DQN’ler) ile oyun yapay zekâsının iyileştirilmesi yer alır. Bu yöntemlerle, çeşitli oyunlarda insan oyuncuları geride bırakan ajanlar eğitilmiştir; bu da pekiştirmeli öğrenmenin gücünü göstermektedir.
Robotik ve gezinme
Robotikte Bellman Denklemi, makinelerin hareket ve gezinme konusunda karar vermesine yardımcı olur. Robotlar, farklı yolları değerlendirerek, en kısa sürede veya en az enerjiyle hedefe ulaşmak gibi gelecekteki ödülleri ençoklayacak olanı seçmek için bu denklemi kullanır.
Başka bir deyişle, robotlar mevcut durumlarına dayanarak sonuçları öngörmek ve buna göre bir sonraki hamlelerini planlamak için Bellman denklemini kullanır. Bu karar verme süreci, bir labirentte gezinmekten dinamik ortamlarda engellerden kaçınmaya kadar kritik öneme sahiptir.
Sonuç
Bellman Denklemi, akıllı sistemlerin geliştirilmesinde – özellikle pekiştirmeli öğrenme ve yapay zekânın diğer alanlarında – temel bir unsurdur. Dinamik ortamlarda sistemlerin öğrenmesini, uyum sağlamasını ve eylemlerini optimize etmesini sağlayan algoritmaların temelini oluşturur; bu da belirsiz ortamlarda daha verimli ve etkili problem çözümüne yol açar.
Öğrenmeye devam etmek için bazı kaynaklar:


 Dario Radečić · 15 min

 Abid Ali Awan · 14 min

 Adel Nehme


1950’lerin başında, vizyoner bir matematikçi ve bilgisayar bilimci olan Richard Bellman, belirsiz ortamlarda karar verme süreçlerinin karmaşıklığını çözmek için bir yolculuğa çıktı. Verimli problem çözme yöntemlerine duyulan ihtiyaçtan hareketle, karmaşık problemleri yönetilebilir alt problemlere bölen devrim niteliğinde bir yaklaşım olan dinamik programlama kavramını ortaya koydu.
Bu yaklaşımı incelerken Bellman, daha sonra Bellman Denklemi olarak anılacak olanı formüle etti: belirli bir durumda verilen bir kararın değerini, olası gelecekteki durumlar ve onlarla ilişkili ödüller temelinde değerlendiren matematiksel bir ifade. Öncü çalışması, 1957 tarihli Dynamic Programming adlı kitabının yayımlanmasıyla doruğa ulaştı; bu eser, optimizasyon ve kontrol kuramının teorik temelini atarken yapay zekâ ve pekiştirmeli öğrenme alanındaki gelişmelerin de önünü açtı.
Günümüzde Bellman’ın fikirleri, makinelerin çevrelerine nasıl uyum sağladığını ve öğrendiğini şekillendirmeye devam ederek matematik ve bilgisayar bilimlerinde kalıcı bir miras bırakmaktadır. Pekiştirmeli öğrenmede Bellman Denklemi, ajanların çevreleriyle nasıl etkileşime girdiğini anlamada kritik öneme sahiptir ve Markov Karar Süreçleri (MDP’ler) kapsamındaki çeşitli sorunları çözmede temel bir rol oynar.
Bu yazıda, denklemin ne olduğunu, Bellman Optimalite Denklemi ile nasıl karşılaştırıldığını, pekiştirmeli öğrenmede nasıl kullanıldığını ve daha fazlasını inceleyeceğiz.
Bellman Denklemi nedir?
Bellman Denklemi, karar verme ve pekiştirmeli öğrenmede kullanılan özyinelemeli bir formüldür. Belirli bir durumda bulunmanın değerinin, alınan ödüllere ve gelecekteki durumların değerine nasıl bağlı olduğunu gösterir.
Basitçe söylemek gerekirse, Bellman Denklemi karmaşık bir problemi daha küçük adımlara ayırarak çözmeyi kolaylaştırır. Sonuçların bir dizi eyleme bağlı olduğu durumlarda en iyi karar verme yolunu bulmaya yardımcı olur.
Matematiksel olarak Bellman Denklemi şu şekilde yazılır:
Burada:
Bu toplam, her olası bir sonraki durumun değerini o duruma ulaşma olasılığıyla çarpar; böylece beklenen gelecekteki ödülleri etkili bir şekilde yakalar.
Bellman Denklemi ve Bellman Optimalite Denklemi
Bellman Denklemi, bir durumda bulunmanın değerini, eylemlerden elde edilen ödüller ve gelecekteki durumların beklenen değeri üzerinden hesaplar. Bir ajanın bir ortamda bir politikayı izlediğinde o politikanın ne kadar iyi olduğunu değerlendirmede kilit bir bileşendir. Denklem, tüm olası eylem ve sonuçları ele alarak belirli bir durumda bulunmanın değerini belirlemeye yardımcı olur.
Buna karşılık, Bellman Optimalite Denklemi hedefin en iyi, yani "optimal" politikayı bulmak olduğu durumda kullanılır.
Belirli bir politikaya göre bir durumun değerini yalnızca değerlendirmek yerine, tüm olası eylem ve politikaları dikkate alarak ulaşılabilecek en büyük değeri bulur. Bellman Optimalite Denklemi bunu, her durumda mevcut tüm eylemler üzerinden beklenen ödülün maksimumunu alarak yapar. Böylece, her durumdan en iyi şekilde hareket edersek elde edebileceğimiz en yüksek değeri verir.
Başka bir deyişle, iki denklem arasındaki temel fark odak noktalarıdır.
Standart Bellman Denklemi, bir politikayı izlediğinizde beklenen değeri tahmin ederek o politikanın etkinliğini değerlendirir. Öte yandan Bellman Optimalite Denklemi, her durumda uzun vadeli ödülü maksimum yapan eylemi bularak genel anlamda en iyi politikayı belirlemeyi amaçlar.
Kısaca: Standart Bellman Denklemi politika değerlendirme için, optimalite denklemi ise politika iyileştirme ve kontrol için kullanılır.
Bellman Optimalite Denklemi, ödülleri ençoklamak için en iyi eylem dizisini seçmenin amaçlandığı kontrol problemlerinin çözümünde esastır. Bu tür problemlerde ajanlar, hem anlık ödülleri ençoklayacak hem de gelecekteki ödülleri dikkate alacak kararlar vermelidir.
Optimalite denklemi, en yüksek uzun vadeli ödüle götüren eylemleri sistematik olarak değerlendirme ve seçme yolu sağlar; böylece optimal politikayı bulmaya yardımcı olur. Bu denklem, Q-learning ve değer yinelemesi gibi algoritmaların merkezinde yer alır; bu algoritmalar, pekiştirmeli öğrenmede ajanları mümkün olan en iyi şekilde hareket etmeleri için eğitmekte kullanılır.
Pekiştirmeli Öğrenmede Bellman Denklemi
Bellman Denklemi, pekiştirmeli öğrenmenin çekirdek bir parçasıdır. Karmaşık görevleri daha küçük adımlara bölerek ajanların en iyi kararları nasıl vereceğini öğrenmesine yardımcı olur.
Özellikle, Bellman Denklemi, ajanların farklı durum ve eylemlerin değerini hesaplamasını sağlar; bu da ödülleri ençoklamak için en iyi yolu seçmelerine rehberlik eder.
Dolayısıyla, pekiştirmeli öğrenmede Bellman Denklemi, politikaları değerlendirmek ve iyileştirmek için kullanılır; böylece ajanlar deneyim kazandıkça daha iyi kararlar verir.
Q-Learning içindeki rolü
Q-learning, popüler bir pekiştirmeli öğrenme algoritmasıdır. Algoritma, durum-eylem çiftlerinin değerini (Q-değerleri) tahmin etmek için Bellman Denklemi’nden yararlanır. Bu değerler, ajana belirli bir durumda belirli bir eylemi yapmanın ne kadar ödüllendirici olacağını ve ardından en iyi politikayı izlemenin getirisini söyler.
Q-learning için Bellman Optimalite Denklemi, her eylem için beklenen maksimum değeri bulur; bu da ajanların uzun vadeli ödüllerini ençoklayacak en iyi hamleleri belirlemesine yardımcı olur.
Örneğin, epizodik bir pekiştirmeli öğrenme probleminde, bir ızgara dünyasında gezinmeye çalışan bir ajan hayal edin. Bir duruma ulaştığında, ajan ilgili durum-eylem çifti için Q-değerini şu denklemi kullanarak günceller:
Burada:
Bu denklem, Q-değerini anlık ödül ve beklenen en yüksek gelecekteki ödüller temelinde günceller. Tekrarlı uygulama yoluyla, ajan optimal Q-değerlerini yaklaşık olarak öğrenir ve uzun vadeli ödülleri ençoklayacak en iyi eylemleri belirleyebilir.
Politika değerlendirme için Bellman Denklemi
Bellman Denklemi, değer fonksiyonlarını tahmin ederek politikaları değerlendirmede de kullanılır. Bu bağlamda, bir ajanın belirli bir durumdan başlayarak verilen bir politikayı izlediğinde beklenen uzun vadeli ödülü hesaplar. Bu, ajanın ortalama olarak bekleyebileceği ödülü göstererek bir politikanın ne kadar etkili olduğunu belirlemeye yardımcı olur.
Politika yinelemesi (policy iteration) algoritması, bu değerlendirmeyi kullanarak politikaları iyileştirir. Önce bir politika için değer fonksiyonu tahmin edilir, ardından bu değere dayanarak daha iyi eylemler seçmek üzere politika güncellenir. Bu süreç, politika optimal olana yakınsayana kadar tekrarlanır; bu noktada daha fazla iyileştirme yapılamaz.
Bellman Denkleminin Türetilmesi
Bu bölümde, Bellman Denklemini ilk ilkelerden başlayarak adım adım ele alacağız. Ardından, ödüller ve geçişlerin değer fonksiyonlarını nasıl oluşturduğunu ve ajanların en iyi eylemleri seçmesine nasıl rehberlik ettiğini inceleyeceğiz.
Adım adım türetim
Bellman Denklemini türetmek için değer fonksiyonu kavramıyla başlarız. Değer fonksiyonu, V(s)V(s)V(s), s durumundan başlayıp sonrasında optimal bir politikayı izleyerek beklenen kümülatif ödülü verir. Bu denklem özyinelemelidir; yani bir durumun değerini, onu izleyen durumların değerleriyle ilişkilendirir.
1. Değer fonksiyonunu tanımlayın
Değer fonksiyonu V(s), bir ajanın s durumundan başlayarak optimal politikayı izlediğinde alacağı toplam beklenen ödülü temsil eder. Matematiksel olarak şöyle ifade edilebilir:
Burada:
2. Gelecekteki ödülleri açımlama
V(s) ’i anlık ödüller ve gelecekteki durumların değeri cinsinden ifade etmek için, ilk ödülü tüm gelecekteki ödüllerin toplamından ayırırız:
Burada:
3. Sonraki durum değerini dahil edin
Şimdi, ajan s durumunda a eylemini gerçekleştirdikten sonra ulaştığı s' bir sonraki durumunun değerini ekleriz. Bu, şu denkleme yol açar:
Burada:
4. Nihai Bellman Denklemi
Basitleştirdikten sonra, değer fonksiyonu V(s) için Bellman Denklemi şu hale gelir:
Bu nihai biçim, bir durumun değerini iki bileşene ayırır: anlık ödül ve bir sonraki durumun beklenen değeri. Bu özyinelemeli yapı, algoritmaların V(s) ’i yinelemeli olarak hesaplamasını veya yaklaşık olarak bulmasını sağlar; bu da zaman içinde optimal politikaların bulunmasına yardımcı olur.
Örnekler ve uygulamalar
Basit bir ızgara dünyası üzerinden bir örnek inceleyelim:
Bir ajanın, engellerden kaçınarak ızgarada bir hedefe ulaşmaya çalıştığını düşünün. Ajan yukarı, aşağı, sola veya sağa hareket eder ve her hamle için ödüller alır. Hedefe ulaştığında daha yüksek bir ödül kazanır. Bellman Denklemini kullanarak, anlık ödülleri ve gelecekteki durum değerlerini değerlendirerek ızgaradaki her durum için değeri hesaplayabiliriz.
Markov Karar Süreçleri (MDP’ler) için Bellman Denklemi, optimal politikayı bulmaya yardımcı olur. Bir teslimat problemini andıran ve ajanın en hızlı rotayı seçmesi gereken küçük bir MDP’miz olduğunu varsayalım; denklemi her durum-eylem çiftine uygularız. Böyle yaparak toplam beklenen ödülü ençoklayacak en iyi eylemleri hesaplayabiliriz.
İleri Konular: Q-Learning’de Bellman Denklemi
Bu bölümde Bellman Denkleminin şu ileri yöntemlerde nasıl uygulandığını inceliyoruz:
Bu teknikler, karmaşık ortamlarda bile değer tahminlerini güncelleyerek ajanların optimal eylemleri öğrenmesine yardımcı olur. Bu ileri konuları anlamak, pekiştirmeli öğrenmede ustalaşmanın anahtarıdır.
Değer yinelemesi
Değer yinelemesi, değer fonksiyonlarını yinelemeli olarak güncellemek için Bellman Denklemini kullanan bir yöntemdir. Amaç, her durum için optimal değeri bulmaktır; böylece ajan en iyi eylemleri belirleyebilir.
Değer yinelemesinde, ajan her bir durumun değerini olası gelecekteki durumlar ve onların ödüllerine dayanarak günceller. Bu süreç, değerler kararlı bir çözüme yakınsayana kadar tekrarlanır. Değer yinelemesinin yakınsama özellikleri, yeterli süre verildiğinde optimal politikayı bulacağından emin olmamızı sağlar.
Zamansal-fark öğrenme
TD öğrenme, Bellman Denklemini kullanan ancak önemli bir açıdan farklılaşan başka bir yaklaşımdır — çevrenin bir modeline ihtiyaç duymaz.
Bunun yerine, değer tahminlerini ajanın topladığı gerçek deneyimlere dayanarak günceller. Bu da çevrenin bilinmediği durumlarda daha pratik olmasını sağlar. TD öğrenme, tam bölümler (epizodlar) gerektiren Monte Carlo yöntemleri ile tam bir model gerektiren dinamik programlama arasındaki boşluğu doldurur.
Uygulamalar ve Kullanım Senaryoları
Bellman Denklemi, teorik modellerin ötesinde geniş bir uygulama yelpazesine sahiptir. Karar verme ve optimizasyonun gerekli olduğu gerçek dünya senaryolarında kritik bir rol oynar. Bu bölüm, Bellman Denkleminin bu uygulamaları nasıl desteklediğini inceler.
Oyunlarda pekiştirmeli öğrenme
Atari gibi klasik oyun ortamlarında Bellman Denklemi, ajanın en yüksek skoru elde etmek için eylemlerini optimize etmesine yardımcı olur. Denklem, her eylem için beklenen ödülleri değerlendirerek ajanın en iyi hamleleri seçmesine rehberlik eder.
Gerçek dünya örnekleri arasında, Bellman Denklemini kullanan Derin Pekiştirmeli Öğrenme algoritmaları (ör. Deep Q-Networks, DQN’ler) ile oyun yapay zekâsının iyileştirilmesi yer alır. Bu yöntemlerle, çeşitli oyunlarda insan oyuncuları geride bırakan ajanlar eğitilmiştir; bu da pekiştirmeli öğrenmenin gücünü göstermektedir.
Robotik ve gezinme
Robotikte Bellman Denklemi, makinelerin hareket ve gezinme konusunda karar vermesine yardımcı olur. Robotlar, farklı yolları değerlendirerek, en kısa sürede veya en az enerjiyle hedefe ulaşmak gibi gelecekteki ödülleri ençoklayacak olanı seçmek için bu denklemi kullanır.
Başka bir deyişle, robotlar mevcut durumlarına dayanarak sonuçları öngörmek ve buna göre bir sonraki hamlelerini planlamak için Bellman denklemini kullanır. Bu karar verme süreci, bir labirentte gezinmekten dinamik ortamlarda engellerden kaçınmaya kadar kritik öneme sahiptir.
Sonuç
Bellman Denklemi, akıllı sistemlerin geliştirilmesinde – özellikle pekiştirmeli öğrenme ve yapay zekânın diğer alanlarında – temel bir unsurdur. Dinamik ortamlarda sistemlerin öğrenmesini, uyum sağlamasını ve eylemlerini optimize etmesini sağlayan algoritmaların temelini oluşturur; bu da belirsiz ortamlarda daha verimli ve etkili problem çözümüne yol açar.
Öğrenmeye devam etmek için bazı kaynaklar: