
{count, plural, one {कोर्स} other {कोर्स}}
एंड-टू-एंड मशीन लर्निंग
{hours} घंटा
16.9K
1950 के शुरुआती दशक में, रिचर्ड बेलमैन—एक दूरदर्शी गणितज्ञ और कंप्यूटर वैज्ञानिक—ने अनिश्चित परिवेशों में निर्णय-निर्धारण की जटिलताओं को सुलझाने की यात्रा शुरू की। कुशल समस्या-समाधान विधियों की आवश्यकता से प्रेरित होकर, उन्होंने डायनेमिक प्रोग्रामिंग की क्रांतिकारी अवधारणा प्रस्तुत की, जो जटिल समस्याओं को छोटे-छोटे उपसमस्याओं में विभाजित करती है।
इस दृष्टिकोण की पड़ताल करते हुए, बेलमैन ने वह सूत्रबद्ध किया जिसे आगे चलकर बेलमैन समीकरण के रूप में जाना गया: एक गणितीय अभिव्यक्ति जो किसी दी गई अवस्था में निर्णय के मूल्य को संभावित भविष्य की अवस्थाओं और उनसे जुड़े प्रतिफलों के आधार पर आँकती है। उनका यह अग्रणी कार्य 1957 की पुस्तक Dynamic Programming के प्रकाशन में परिणत हुआ, जिसने अनुकूलन और नियंत्रण सिद्धांत के लिए सैद्धांतिक आधार रखा तथा कृत्रिम बुद्धिमत्ता और रिइन्फोर्समेंट लर्निंग में प्रगति का मार्ग प्रशस्त किया।
आज, बेलमैन के विचार इस बात को आकार देते रहते हैं कि मशीनें अपने परिवेश से कैसे सीखती और अनुकूलित होती हैं, जिससे गणित और कंप्यूटर विज्ञान पर एक स्थायी प्रभाव पड़ा है। रिइन्फोर्समेंट लर्निंग में, बेलमैन समीकरण एजेंटों और उनके परिवेश के अंतःक्रिया को समझने में अत्यंत महत्वपूर्ण है और मार्कोव निर्णय प्रक्रियाओं (MDPs) में अनेक समस्याओं के समाधान के लिए आवश्यक है।
इस लेख में, हम देखेंगे कि यह समीकरण क्या है, यह बेलमैन ऑपटिमैलिटी समीकरण से कैसे भिन्न है, रिइन्फोर्समेंट लर्निंग में इसका उपयोग कैसे होता है, और भी बहुत कुछ।
बेलमैन समीकरण निर्णय-निर्धारण और रिइन्फोर्समेंट लर्निंग में प्रयुक्त एक पुनरावर्ती (recursive) सूत्र है। यह दर्शाता है कि किसी अवस्था में होने का मूल्य तत्काल प्रतिफल और भविष्य की अवस्थाओं के मूल्यों पर निर्भर करता है।
सरल शब्दों में, बेलमैन समीकरण किसी जटिल समस्या को छोटे-छोटे चरणों में बाँट देता है, जिससे उसे हल करना आसान हो जाता है। यह ऐसे समय में सर्वोत्तम निर्णय-क्रम खोजने में मदद करता है जब परिणाम कई क्रियाओं की श्रृंखला पर निर्भर करते हैं।
गणितीय रूप से, बेलमैन समीकरण इस प्रकार लिखा जाता है:
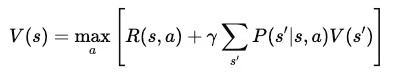
जहाँ:
यह योग प्रत्येक संभावित अगली अवस्था के मूल्य को उस अवस्था तक पहुँचने की प्रायिकता से गुणा करता है, और इस प्रकार अपेक्षित भविष्य के प्रतिफलों को समाहित करता है।
बेलमैन समीकरण किसी अवस्था के मूल्य की गणना उन क्रियाओं से मिलने वाले प्रतिफलों और भविष्य की अवस्थाओं के अपेक्षित मूल्यों के आधार पर करता है। यह इस बात का मूल्यांकन करने में महत्वपूर्ण है कि किसी परिवेश में एजेंट द्वारा अपनाई गई नीति कितनी अच्छी है। यह समीकरण सभी संभावित क्रियाओं और परिणामों पर नज़र डालता है और बताता है कि किसी निश्चित अवस्था में होने का मूल्य क्या है।
इसके विपरीत, बेलमैन ऑपटिमैलिटी समीकरण तब उपयोग होता है जब लक्ष्य सर्वोत्तम या "ऑप्टिमल" नीति खोजना होता है।
किसी विशिष्ट नीति के आधार पर केवल अवस्था के मूल्य का आकलन करने के बजाय, यह सभी संभावित क्रियाओं और नीतियों पर विचार करके प्राप्त होने वाले अधिकतम मूल्य को ढूँढता है। बेलमैन ऑपटिमैलिटी समीकरण ऐसा प्रत्येक अवस्था में उपलब्ध सभी क्रियाओं पर अधिकतम अपेक्षित प्रतिफल लेकर करता है। इस प्रकार, यह बताता है कि यदि हम सर्वोत्तम तरीके से कार्य करें, तो प्रत्येक अवस्था से हमें अधिकतम संभव मूल्य क्या मिल सकता है।
अन्य शब्दों में, दोनों समीकरणों के बीच मुख्य अंतर उनके फोकस में है।
मानक बेलमैन समीकरण किसी नीति का मूल्यांकन उसके अनुसरण से मिलने वाले अपेक्षित मूल्य का अनुमान लगाकर करता है। दूसरी ओर, बेलमैन ऑपटिमैलिटी समीकरण हर अवस्था में वह क्रिया पहचानकर, जो अधिकतम दीर्घकालिक प्रतिफल देती है, समग्र रूप से सर्वोत्तम नीति खोजने का लक्ष्य रखता है।
TLDR: मानक बेलमैन समीकरण नीति-मूल्यांकन के लिए इस्तेमाल होता है, जबकि ऑपटिमैलिटी समीकरण नीति-सुधार और नियंत्रण के लिए।
बेलमैन ऑपटिमैलिटी समीकरण नियंत्रण समस्याओं के समाधान में अनिवार्य है, जहाँ उद्देश्य प्रतिफलों को अधिकतम करने के लिए क्रियाओं के सर्वोत्तम क्रम का चयन करना होता है। इन समस्याओं में, एजेंटों को तत्काल प्रतिफलों के साथ-साथ भविष्य के प्रतिफलों पर भी विचार करते हुए निर्णय लेने होते हैं।
ऑपटिमैलिटी समीकरण उच्चतम दीर्घकालिक प्रतिफल तक ले जाने वाली क्रियाओं का सुव्यवस्थित मूल्यांकन और चयन करने का तरीका प्रदान करता है, जिससे इष्टतम नीति खोजने में सहायता मिलती है। यह Q-learning और वैल्यू इटरेशन जैसे एल्गोरिद्मों का केंद्रीय भाग है, जिनका उपयोग रिइन्फोर्समेंट लर्निंग में एजेंटों को सर्वोत्तम तरीके से कार्य करने के लिए प्रशिक्षित करने में किया जाता है।
बेलमैन समीकरण रिइन्फोर्समेंट लर्निंग का मूल घटक है। यह जटिल कार्यों को छोटे-छोटे चरणों में बाँटकर एजेंटों को सर्वोत्तम निर्णय लेना सिखाता है।
विशेष रूप से, बेलमैन समीकरण एजेंटों को विभिन्न अवस्थाओं और क्रियाओं के मूल्य की गणना करने में सक्षम बनाता है, जो उन्हें प्रतिफल अधिकतम करने के लिए सर्वोत्तम मार्ग चुनने में मार्गदर्शन देता है।
इस प्रकार, रिइन्फोर्समेंट लर्निंग में बेलमैन समीकरण नीतियों का मूल्यांकन और सुधार करने में उपयोग होता है, जिससे एजेंट अनुभव के साथ बेहतर निर्णय लेना सीखते जाते हैं।
Q-learning एक लोकप्रिय रिइन्फोर्समेंट लर्निंग एल्गोरिद्म है। यह एल्गोरिद्म बेलमैन समीकरण का उपयोग अवस्था-क्रिया युग्मों के मूल्यों—यानी Q-मूल्यों—का आकलन करने के लिए करता है। ये मान एजेंट को बताते हैं कि किसी दी गई अवस्था में कोई विशेष क्रिया करना और उसके बाद सर्वोत्तम नीति का पालन करना कितना लाभदायक होगा।
Q-learning के लिए बेलमैन ऑपटिमैलिटी समीकरण प्रत्येक क्रिया के लिए अधिकतम अपेक्षित मूल्य खोजता है, जिससे एजेंट दीर्घकालिक प्रतिफलों को अधिकतम करने के लिए सर्वोत्तम कदमों की पहचान कर सकें।
उदाहरण के लिए, एक एपिसोडिक रिइन्फोर्समेंट लर्निंग समस्या में, मान लें कि एक एजेंट ग्रिड-वर्ल्ड में नेविगेट कर रहा है। किसी अवस्था पर पहुँचने पर, एजेंट उस अवस्था-क्रिया युग्म के Q-मूल्य को निम्न समीकरण से अद्यतन करता है:
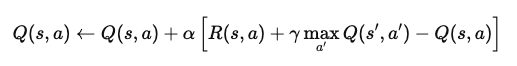
जहाँ:
यह समीकरण तत्काल प्रतिफल और अधिकतम अपेक्षित भविष्य के प्रतिफलों के आधार पर Q-मूल्य को अपडेट करता है। बार-बार लागू करने से एजेंट इष्टतम Q-मूल्यों का सन्निकटन सीखता है और दीर्घकालिक प्रतिफल अधिकतम करने हेतु सर्वोत्तम क्रियाएँ निर्धारित कर पाता है।
बेलमैन समीकरण का उपयोग वैल्यू फंक्शनों का अनुमान लगाकर नीतियों का मूल्यांकन करने के लिए भी किया जाता है। इस संदर्भ में, यह किसी विशिष्ट अवस्था से दी गई नीति का पालन करने पर मिलने वाले अपेक्षित दीर्घकालिक प्रतिफल की गणना करता है। इससे यह निर्धारित करने में मदद मिलती है कि कोई नीति कितनी प्रभावी है, क्योंकि यह दर्शाता है कि औसतन एजेंट क्या प्रतिफल अपेक्षित कर सकता है।
पॉलिसी इटरेशन एल्गोरिद्म इस मूल्यांकन का उपयोग नीतियों को सुधारने के लिए करता है। यह किसी नीति के लिए वैल्यू फंक्शन का अनुमान लगाने से शुरू होता है और फिर इसी मूल्य के आधार पर बेहतर क्रियाएँ चुनने हेतु नीति को अपडेट करता है। यह प्रक्रिया तब तक दोहरती है जब तक नीति इष्टतम पर अभिसरित न हो जाए, जिस बिंदु पर आगे सुधार संभव नहीं रह जाता।
इस खंड में, हम बेलमैन समीकरण को प्रथम सिद्धांतों से चरण-दर-चरण समझेंगे। फिर देखेंगे कि प्रतिफल और ट्रांज़िशन कैसे वैल्यू फंक्शनों का निर्माण करते हैं और एजेंटों को सर्वोत्तम क्रियाएँ चुनने में मार्गदर्शन देते हैं।
बेलमैन समीकरण निकालने के लिए, हम वैल्यू फंक्शन की अवधारणा से शुरू करते हैं। वैल्यू फंक्शन V(s)V(s)V(s) वह अपेक्षित संचयी प्रतिफल देता है जो अवस्था sss से शुरू कर आगे इष्टतम नीति का पालन करने पर मिलता है। यह समीकरण पुनरावर्ती है—अर्थात यह किसी अवस्था के मूल्य को आगे की अवस्थाओं के मूल्य से जोड़ता है।
वैल्यू फंक्शन V(s) उस कुल अपेक्षित प्रतिफल का प्रतिनिधित्व करता है जो एजेंट को अवस्था sss से शुरू कर इष्टतम नीति का पालन करने पर मिलेगा। गणितीय रूप से, इसे इस प्रकार व्यक्त किया जा सकता है:
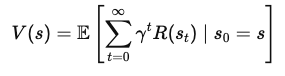
जहाँ:
तत्काल प्रतिफल और भविष्य की अवस्थाओं के मूल्य के रूप में V(s) को व्यक्त करने के लिए, हम पहले प्रतिफल को शेष सभी भविष्य के प्रतिफलों के योग से अलग करते हैं:
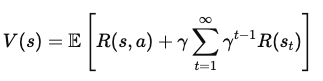
जहाँ:
अब हम अगली अवस्था s' का मूल्य जोड़ते हैं, जहाँ एजेंट अवस्था s में क्रिया a करने के बाद पहुँचता है। इससे निम्न समीकरण प्राप्त होता है:
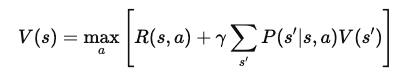
जहाँ:
सरलीकरण के बाद, वैल्यू फंक्शन V(s) के लिए बेलमैन समीकरण इस प्रकार बनता है:
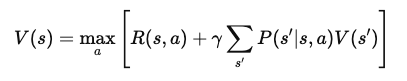
इस अंतिम रूप में बेलमैन समीकरण किसी अवस्था के मूल्य को दो घटकों में विघटित करता है: तत्काल प्रतिफल और अगली अवस्था के अपेक्षित मूल्य। यह पुनरावर्ती संरचना एल्गोरिद्मों को V(s) को क्रमिक रूप से संगणित या सन्निकटित करने देती है, जिससे समय के साथ इष्टतम नीतियों का पता लगाने में सहायता मिलती है।
आइए एक सरल ग्रिड-वर्ल्ड के उदाहरण से गुजरते हैं:
मान लें कि एक एजेंट अवरोधों से बचते हुए ग्रिड पर किसी लक्ष्य तक पहुँचना चाहता है। एजेंट ऊपर, नीचे, बाएँ या दाएँ चलता है और हर चाल पर प्रतिफल पाता है। लक्ष्य तक पहुँचने पर उसे अधिक प्रतिफल मिलता है। बेलमैन समीकरण का उपयोग करके, हम तत्काल प्रतिफलों और भविष्य की अवस्थाओं के मूल्यों का आकलन कर ग्रिड की प्रत्येक अवस्था का मूल्य निकाल सकते हैं।
मार्कोव निर्णय प्रक्रियाओं (MDPs) के लिए, बेलमैन समीकरण इष्टतम नीति ढूँढने में मदद करता है। यदि हमारे पास एक छोटा MDP हो—जैसे एक डिलीवरी समस्या, जिसमें एजेंट को सबसे तेज़ मार्ग चुनना हो—तो हम प्रत्येक अवस्था-क्रिया युग्म पर यह समीकरण लागू करते हैं। ऐसा करने पर, हम कुल अपेक्षित प्रतिफल को अधिकतम करने वाली सर्वोत्तम क्रियाओं की गणना कर सकते हैं।
इस खंड में, हम देखते हैं कि बेलमैन समीकरण का उपयोग निम्न उन्नत तरीकों में कैसे होता है:
ये तकनीकें जटिल परिवेशों में भी वैल्यू अनुमानों को अपडेट करके एजेंटों को इष्टतम क्रियाएँ सीखने में मदद करती हैं। इन उन्नत विषयों को समझना रिइन्फोर्समेंट लर्निंग में निपुणता पाने की कुंजी है।
वैल्यू इटरेशन एक विधि है जो बेलमैन समीकरण का उपयोग करके वैल्यू फंक्शनों को क्रमिक रूप से अद्यतन करती है। लक्ष्य प्रत्येक अवस्था के लिए इष्टतम मूल्य खोजना है ताकि एजेंट सर्वोत्तम क्रियाएँ निर्धारित कर सके।
वैल्यू इटरेशन में एजेंट संभावित भविष्य की अवस्थाओं और उनके प्रतिफलों के आधार पर प्रत्येक अवस्था का मूल्य अपडेट करता है। यह प्रक्रिया तब तक दोहरती है जब तक मूल्य स्थिर समाधान पर अभिसरित न हो जाएँ। वैल्यू इटरेशन के अभिसरण गुण यह सुनिश्चित करते हैं कि पर्याप्त समय मिलने पर यह इष्टतम नीति खोज लेगा।
TD लर्निंग एक अन्य तरीका है जो बेलमैन समीकरण का उपयोग करता है, पर एक महत्वपूर्ण भिन्नता के साथ—इसे परिवेश के मॉडल की आवश्यकता नहीं होती।
इसके बजाय, यह एजेंट द्वारा एकत्र किए गए वास्तविक अनुभवों के आधार पर वैल्यू अनुमानों को अपडेट करता है। इससे तब यह अधिक व्यावहारिक हो जाता है जब परिवेश अज्ञात हो। TD लर्निंग पूर्ण एपिसोड पर निर्भर मॉन्टे कार्लो विधियों और पूर्ण मॉडल की आवश्यकता वाली डायनेमिक प्रोग्रामिंग के बीच की खाई को पाटता है।
बेलमैन समीकरण का उपयोग सैद्धांतिक मॉडलों से कहीं आगे तक फैला है। यह वास्तविक जीवन की उन परिस्थितियों में अहम भूमिका निभाता है जहाँ निर्णय-निर्धारण और अनुकूलन आवश्यक होते हैं। इस खंड में देखते हैं कि बेलमैन समीकरण इन अनुप्रयोगों को कैसे सहारा देता है।
Atari जैसे क्लासिक गेमिंग परिवेशों में, बेलमैन समीकरण एजेंट की क्रियाओं को इस प्रकार अनुकूलित करने में मदद करता है कि सर्वोच्च स्कोर प्राप्त हो सके। यह समीकरण प्रत्येक क्रिया के अपेक्षित प्रतिफलों का आकलन करके एजेंट को सर्वोत्तम चालें चुनने में मार्गदर्शन देता है।
व्यावहारिक उदाहरणों में Deep Q-Networks (DQNs) जैसे गहन रिइन्फोर्समेंट लर्निंग एल्गोरिद्म शामिल हैं, जो बेलमैन समीकरण का उपयोग करके गेम AI में सुधार करते हैं। इन तरीकों से विभिन्न गेम्स में ऐसे एजेंट प्रशिक्षित किए गए हैं जो मानव खिलाड़ियों से बेहतर प्रदर्शन करते हैं—जो रिइन्फोर्समेंट लर्निंग की शक्ति को दर्शाता है।
रोबोटिक्स में, बेलमैन समीकरण मशीनों को गमन और नेविगेशन पर निर्णय लेने में मदद करता है। रोबोट विभिन्न पथों का मूल्यांकन करते हैं और वह पथ चुनते हैं जो भविष्य के प्रतिफलों—जैसे सबसे कम समय या न्यूनतम ऊर्जा में लक्ष्य तक पहुँचना—को अधिकतम करे।
दूसरे शब्दों में, रोबोट बेलमैन समीकरण का उपयोग अपनी वर्तमान अवस्था के आधार पर परिणामों का अनुमान लगाने और उसके अनुसार अगली चालें योजनाबद्ध करने के लिए करते हैं। गतिशील परिवेशों में भूलभुलैया से मार्ग निकालना या बाधाओं से बचना—ऐसे कार्यों के लिए यह निर्णय-निर्धारण प्रक्रिया बेहद महत्वपूर्ण होती है।
बेलमैन समीकरण बुद्धिमान प्रणालियों के विकास में—विशेष रूप से रिइन्फोर्समेंट लर्निंग और कृत्रिम बुद्धिमत्ता के अन्य क्षेत्रों में—मौलिक है। यही उन एल्गोरिद्मों का आधार है जो प्रणालियों को गतिशील परिवेशों में सीखने, अनुकूल होने और अपनी क्रियाओं को अनुकूलित करने में सक्षम बनाते हैं, जिससे अनिश्चित परिस्थितियों में समस्याओं के अधिक कुशल और प्रभावी समाधान संभव होते हैं।
अपनी सीख को आगे बढ़ाने के लिए ये संसाधन देखें:
शीर्ष DataCamp कोर्स
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {लर्निंग पाथ} other {लर्निंग पाथ}}