
Corso
Machine Learning end-to-end
4 ore
16.9K
All’inizio degli anni ’50, Richard Bellman, matematico e informatico visionario, intraprese un percorso per svelare le complessità del decision making in ambienti incerti. Spinto dall’esigenza di metodi di problem solving efficienti, introdusse il concetto rivoluzionario di programmazione dinamica, che scompone problemi intricati in sottoproblemi gestibili.
Esplorando questo approccio, Bellman formulò quella che in seguito sarebbe stata conosciuta come Equazione di Bellman: un’espressione matematica che valuta il valore di una decisione in uno stato dato in base ai potenziali stati futuri e alle relative ricompense. Il suo lavoro pionieristico culminò con la pubblicazione del libro del 1957, Dynamic Programming, che pose le basi teoriche per l’ottimizzazione e la teoria del controllo, aprendo al contempo la strada ai progressi nell’intelligenza artificiale e nel reinforcement learning.
Oggi le idee di Bellman continuano a plasmare il modo in cui le macchine apprendono e si adattano ai loro ambienti, lasciando un’eredità duratura in matematica e informatica. Nel reinforcement learning, l’Equazione di Bellman è fondamentale per capire come gli agenti interagiscono con l’ambiente, ed è quindi essenziale per risolvere vari problemi nei Processi di Decisione di Markov (MDP).
In questo articolo vedremo cos’è l’equazione, come si confronta con l’Equazione di Bellman per l’ottimalità, come viene usata nel reinforcement learning e altro ancora.
L’Equazione di Bellman è una formula ricorsiva usata nel decision making e nel reinforcement learning. Mostra come il valore di trovarsi in un certo stato dipenda dalle ricompense ricevute e dal valore degli stati futuri.
In parole semplici, l’Equazione di Bellman scompone un problema complesso in passi più piccoli, rendendolo più facile da risolvere. L’equazione aiuta a trovare il modo migliore di prendere decisioni quando gli esiti dipendono da una serie di azioni.
Matematicamente, l’Equazione di Bellman si scrive così:
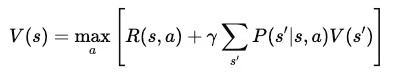
Dove:
Questa somma moltiplica il valore di ciascun possibile stato successivo per la probabilità di raggiungerlo, catturando di fatto le ricompense future attese.
L’Equazione di Bellman calcola il valore di uno stato in base alle ricompense derivanti dalle azioni e al valore atteso degli stati futuri. È una parte fondamentale della valutazione di quanto sia buona una policy quando un agente la segue in un ambiente. L’equazione considera tutte le possibili azioni ed esiti e aiuta a determinare il valore di trovarsi in un determinato stato.
Al contrario, l’Equazione di Bellman per l’ottimalità si usa quando l’obiettivo è trovare la policy migliore o "ottimale".
Invece di limitarsi a valutare il valore di uno stato in base a una specifica policy, trova il valore massimo ottenibile considerando tutte le possibili azioni e policy. L’Equazione di Bellman per l’ottimalità lo fa prendendo la ricompensa attesa massima su tutte le azioni disponibili in ciascuno stato. In questo modo, ci dice il valore più alto che possiamo ottenere da ogni stato se agiamo nel modo migliore possibile.
In altre parole, la differenza principale tra le due equazioni sta nel loro focus.
L’Equazione di Bellman standard valuta l’efficacia di una policy stimando il valore atteso del suo seguito. L’Equazione di Bellman per l’ottimalità, invece, mira a trovare la policy migliore in assoluto identificando l’azione che fornisce la ricompensa a lungo termine massima in ciascuno stato.
TL;DR: L’Equazione di Bellman standard si usa per la valutazione delle policy, mentre l’equazione di ottimalità si usa per il miglioramento delle policy e il controllo.
L’Equazione di Bellman per l’ottimalità è essenziale per risolvere problemi di controllo, in cui l’obiettivo è scegliere la sequenza di azioni migliore per massimizzare le ricompense. In questi problemi, gli agenti devono prendere decisioni che massimizzino le ricompense immediate e considerino quelle future.
L’equazione di ottimalità fornisce un modo per valutare e scegliere in modo sistematico le azioni che portano alla ricompensa a lungo termine più alta, aiutando a trovare la policy ottimale. È una parte centrale di algoritmi come il Q-learning e l’iterazione sui valori, utilizzati nel reinforcement learning per addestrare gli agenti ad agire nel modo migliore possibile.
L’Equazione di Bellman è una parte centrale del reinforcement learning. Aiuta gli agenti a imparare come prendere le decisioni migliori scomponendo compiti complessi in passi più piccoli.
In particolare, l’Equazione di Bellman consente agli agenti di calcolare il valore di diversi stati e azioni, guidandoli nella scelta del percorso migliore per massimizzare le ricompense.
Quindi, nel reinforcement learning, l’Equazione di Bellman viene usata per valutare e migliorare le policy, assicurando che gli agenti prendano decisioni sempre migliori man mano che acquisiscono esperienza.
Il Q-learning è un algoritmo popolare di reinforcement learning. L’algoritmo sfrutta l’Equazione di Bellman per stimare il valore delle coppie stato-azione, note come Q-value. Questi valori dicono all’agente quanto sarà gratificante eseguire una certa azione in un dato stato e seguire poi la policy migliore.
L’Equazione di Bellman per l’ottimalità applicata al Q-learning trova il valore atteso massimo per ciascuna azione, aiutando gli agenti a identificare le mosse migliori per massimizzare le ricompense a lungo termine.
Per esempio, in un problema episodico di reinforcement learning, immagina un agente che si muove in un mondo a griglia. Quando raggiunge uno stato, l’agente aggiorna il suo Q-value per quella coppia stato-azione usando l’equazione:
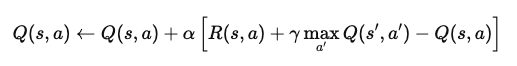
Dove:
Questa equazione aggiorna il Q-value in base alla ricompensa immediata e al massimo delle ricompense future attese. Con l’applicazione ripetuta, l’agente impara ad approssimare i Q-value ottimali e può determinare le azioni migliori per massimizzare le ricompense a lungo termine.
L’Equazione di Bellman è usata anche per valutare le policy stimando le funzioni di valore. In questo contesto, calcola la ricompensa attesa a lungo termine quando un agente segue una data policy a partire da uno stato specifico. Questo aiuta a determinare l’efficacia di una policy mostrando la ricompensa media che l’agente può aspettarsi.
L’algoritmo di iterazione delle policy usa questa valutazione per migliorarle. Inizia stimando la funzione di valore per una policy e poi aggiorna la policy per scegliere azioni migliori sulla base di tale valore. Questo processo si ripete finché la policy converge a quella ottimale, punto in cui non sono possibili ulteriori miglioramenti.
In questa sezione, scomporremo l’Equazione di Bellman passo dopo passo, partendo dai primi principi. Vedremo poi come ricompense e transizioni costruiscono le funzioni di valore, guidando gli agenti nella scelta delle azioni migliori.
Per derivare l’Equazione di Bellman, partiamo dal concetto di funzione di valore. La funzione di valore, V(s)V(s)V(s), fornisce la ricompensa cumulativa attesa iniziando in uno stato sss e seguendo poi una policy ottimale. Questa equazione è ricorsiva, nel senso che mette in relazione il valore di uno stato con il valore degli stati successivi.
La funzione di valore V(s) rappresenta la ricompensa totale attesa che un agente riceverà iniziando nello stato sss e seguendo la policy ottimale. Matematicamente, si può esprimere come:
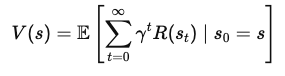
Dove:
Per esprimere V(s) in termini di ricompense immediate e valore degli stati futuri, separiamo la prima ricompensa dalla somma di tutte le ricompense future:
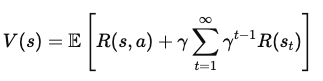
Dove:
Ora aggiungiamo il valore dello stato successivo, s', che l’agente raggiunge dopo aver eseguito l’azione a nello stato s. Questo porta all’equazione:
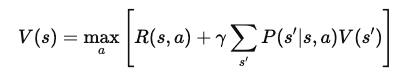
Dove:
Dopo la semplificazione, l’Equazione di Bellman per la funzione di valore V(s) diventa:
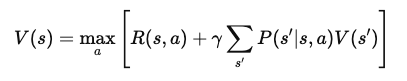
Questa forma finale dell’Equazione di Bellman scompone il valore di uno stato in due componenti: la ricompensa immediata e il valore atteso dello stato successivo. Questa struttura ricorsiva consente agli algoritmi di calcolare o approssimare V(s) in modo iterativo, aiutando a trovare policy ottimali nel tempo.
Vediamo un esempio con un semplice mondo a griglia:
Immagina un agente che cerca di raggiungere un obiettivo su una griglia evitando ostacoli. L’agente si muove in su, giù, a sinistra o a destra e ottiene ricompense per ogni mossa. Se raggiunge l’obiettivo, ottiene una ricompensa più alta. Usando l’Equazione di Bellman, possiamo calcolare il valore di ciascuno stato sulla griglia valutando le ricompense immediate e i valori degli stati futuri.
Per i Processi di Decisione di Markov (MDP), l’Equazione di Bellman aiuta a trovare la policy ottimale. Se abbiamo un MDP piccolo, come un problema di consegna in cui un agente deve scegliere il percorso più veloce, applichiamo l’equazione a ciascuna coppia stato-azione. In questo modo, possiamo calcolare le azioni migliori che massimizzano la ricompensa totale attesa.
In questa sezione, esploriamo come l’Equazione di Bellman venga applicata in metodi avanzati come:
Queste tecniche aiutano gli agenti a imparare azioni ottimali aggiornando le stime di valore, anche in ambienti complessi. Capire questi argomenti avanzati è fondamentale per padroneggiare il reinforcement learning.
L’iterazione sui valori è un metodo che utilizza l’Equazione di Bellman per aggiornare iterativamente le funzioni di valore. L’obiettivo è trovare il valore ottimale per ciascuno stato, in modo che l’agente possa determinare le azioni migliori.
Nell’iterazione sui valori, l’agente aggiorna il valore di ciascuno stato in base ai possibili stati futuri e alle loro ricompense. Questo processo si ripete finché i valori non convergono a una soluzione stabile. Le proprietà di convergenza dell’iterazione sui valori garantiscono che, dato tempo sufficiente, troverà la policy ottimale.
Il TD learning è un altro approccio che usa l’Equazione di Bellman ma differisce in un aspetto chiave: non ha bisogno di un modello dell’ambiente.
Al contrario, aggiorna le stime di valore in base alle esperienze reali raccolte dall’agente. Questo lo rende più pratico quando l’ambiente è sconosciuto. Il TD learning colma il divario tra i metodi Monte Carlo, che si basano su episodi completi, e la programmazione dinamica, che richiede un modello completo.
L’Equazione di Bellman ha un’ampia gamma di applicazioni oltre i modelli teorici. Svolge un ruolo cruciale in scenari reali in cui sono necessari decision making e ottimizzazione. Questa sezione esplora come l’Equazione di Bellman supporti queste applicazioni.
Nei contesti di gioco classici come Atari, l’Equazione di Bellman aiuta a ottimizzare le azioni di un agente per ottenere il punteggio più alto. L’equazione guida l’agente nella selezione delle mosse migliori valutando le ricompense attese per ciascuna azione.
Esempi reali includono l’uso di algoritmi di deep reinforcement learning, come le Deep Q-Network (DQN), che usano l’Equazione di Bellman per migliorare l’IA di gioco. Questi metodi sono stati impiegati per addestrare agenti che superano i giocatori umani in vari giochi, mostrando la potenza del reinforcement learning.
In robotica, l’Equazione di Bellman aiuta le macchine a prendere decisioni sul movimento e la navigazione. I robot la usano per valutare percorsi diversi e scegliere quello che massimizza le ricompense future, come raggiungere un obiettivo nel minor tempo o con il minor dispendio di energia.
In altre parole, i robot usano l’Equazione di Bellman per prevedere gli esiti in base al loro stato attuale e pianificare di conseguenza le mosse successive. Questo processo decisionale è fondamentale per attraversare un labirinto o evitare ostacoli in ambienti dinamici.
L’Equazione di Bellman è fondamentale per lo sviluppo di sistemi intelligenti, in particolare nel reinforcement learning e in altre aree dell’intelligenza artificiale. Costituisce la base degli algoritmi che permettono ai sistemi di apprendere, adattarsi e ottimizzare le proprie azioni in ambienti dinamici, portando a un problem solving più efficiente ed efficace in contesti incerti.
Ecco alcune risorse per continuare ad approfondire:
I migliori corsi DataCamp
Corso
Corso
Programma
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



