
Weiter zum Inhalt

Bernoulli-Verteilung: Der komplette Guide mit Beispielen

Entdecke, wie die Bernoulli-Verteilung binäre Ergebnisse erfasst – von Münzwürfen bis zu Kundenprognosen.
Aktualisiert 18. Sept. 2026  · 11 Min. lesen

Mit KI erkunden

ChatGPTClaudePerplexity

Die Bernoulli-Verteilung ist ein grundlegendes Konzept in Statistik und Data Science. Benannt nach dem Schweizer Mathematiker Jakob Bernoulli, spielt sie in der Wahrscheinlichkeitstheorie eine zentrale Rolle und dient als Baustein für komplexere statistische Modelle – von der Vorhersage des Kundenverhaltens bis zur Entwicklung von Machine-Learning-Algorithmen.

Zum Einstieg empfiehlt sich unser Kurs Introduction to Statistics als Auffrischung zu Wahrscheinlichkeitsverteilungen. Außerdem lohnt sich der Kurs Foundations of Probability in Python, um Probleme mit zwei möglichen Ergebnissen zu bearbeiten und mit der scipy-Bibliothek zu üben. Eine weitere gute Option ist unser Kurs Statistical Thinking in Python (Part 1), der dir zeigt, wie du eigene Python-Funktionen für Bernoulli-Experimente schreibst.  

Was ist eine Bernoulli-Verteilung?

Eine Bernoulli-Verteilung ist eine diskrete Wahrscheinlichkeitsverteilung für eine Zufallsvariable mit genau zwei möglichen Ergebnissen. Diese werden typischerweise als "Erfolg" und "Misserfolg" bezeichnet oder numerisch als 1 und 0 dargestellt.

Bernoulli-Experimente

Starten wir mit Bernoulli-Experimenten. Ein Bernoulli-Experiment ist ein Zufallsexperiment mit genau zwei möglichen Ausgängen. Klassische Beispiele sind:

  • Münzwurf (Kopf oder Zahl)
  • Beantworten einer Wahr/Falsch-Frage
  • Vorhersage, ob ein Kunde kauft (kaufen oder nicht kaufen)

Jedes Bernoulli-Experiment ist unabhängig, das heißt, das Ergebnis eines Versuchs beeinflusst die Erfolgswahrscheinlichkeit in späteren Versuchen nicht.

Bernoulli-Verteilungen

Eine Bernoulli-Verteilung beschreibt die Erfolgswahrscheinlichkeit in einem einzelnen Bernoulli-Experiment. Sie wird durch genau einen Parameter p charakterisiert, der die Erfolgswahrscheinlichkeit angibt. Die Misserfolgswahrscheinlichkeit ist entsprechend 1 - p. Mathematisch lässt sich eine Bernoulli-Verteilung wie folgt ausdrücken, wobei X die Zufallsvariable für das Ergebnis des Bernoulli-Experiments ist.

Um zu zeigen, wie sich Bernoulli-Verteilungen mit unterschiedlichen Erfolgswahrscheinlichkeiten verändern, vergleichen wir drei Beispiele.
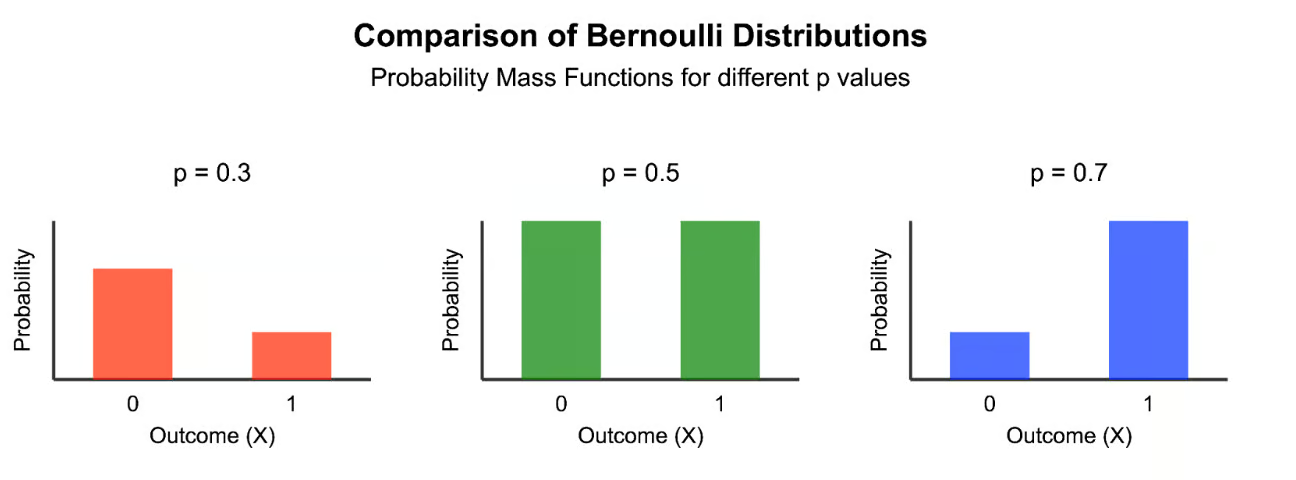
Comparison of Bernoulli distributions for different values of p

Vergleich von Bernoulli-Verteilungen für verschiedene p-Werte. Abbildung: Autorin/Autor. 

Hier zeigt jedes Diagramm eine andere Bernoulli-Verteilung. 

  • Links: p = 0,3 (30 % Erfolgswahrscheinlichkeit)
  • Mitte: p = 0,5 (50 % Erfolgswahrscheinlichkeit)
  • Rechts: p = 0,7 (70 % Erfolgswahrscheinlichkeit)

Wie zu sehen ist, hat die Wahrscheinlichkeitsfunktion einer Bernoulli-Verteilung immer zwei Balken: einen für die Misserfolgswahrscheinlichkeit (X = 0) und einen für die Erfolgswahrscheinlichkeit (X = 1). Die Höhe dieser Balken hängt vom Wert von p ab, die Summe beträgt jedoch immer 1.

Eigenschaften von Bernoulli-Verteilungen

Schauen wir uns die zentralen Merkmale an, die die Bernoulli-Verteilung auszeichnen.

Binäre Ergebnisse

Das auffälligste Merkmal der Bernoulli-Verteilung ist ihre binäre Natur. Jeder Versuch kann nur eines von zwei möglichen Ergebnissen liefern:

  1. Erfolg (meist als 1 gekennzeichnet)
  2. Misserfolg (meist als 0 gekennzeichnet)

Diese binäre Eigenschaft macht Bernoulli-Verteilungen besonders nützlich, wenn es um Ja/Nein-, Wahr/Falsch- oder Erfolg/Misserfolg-Ergebnisse geht. Wichtige Vorteile in Data Science und Machine Learning sind:

  • Einfaches Modellieren: Binäre Ausgänge erlauben eine direkte Modellierung von Wahrscheinlichkeiten und Quoten.
  • Leichte Interpretation: Ergebnisse lassen sich oft einfach als Wahrscheinlichkeiten oder Anteile deuten.
  • Vielseitigkeit: Viele komplexe Szenarien lassen sich in eine Folge binärer Entscheidungen zerlegen.
  • Basis für komplexere Verteilungen: Bernoulli-Experimente sind die Grundlage z. B. der Binomialverteilung, die Erfolge über mehrere Versuche zählt, und der Geometrischen Verteilung, die die Anzahl der Versuche bis zum ersten Erfolg angibt.

Erwartungswert und Varianz

Der Erwartungswert (μ) und die Varianz ²) einer Bernoulli-Verteilung hängen direkt von der Erfolgswahrscheinlichkeit p ab.

Erwartungswert

Der Erwartungswert ist gleich der Erfolgswahrscheinlichkeit. Das heißt: Wiederholst du ein Bernoulli-Experiment sehr oft, konvergiert der Durchschnitt der Ergebnisse gegen p.

Varianz

Die Varianz lautet: σ² = p(1 - p). Sie ist maximal bei p = 0,5 und nimmt ab, wenn sich p 0 oder 1 nähert. Diese Beziehung liefert Einblicke in die Streuung der Daten und die Unsicherheit der Ergebnisse. Hinsichtlich der Streuung bedeutet die Varianz bei einer Bernoulli-Verteilung:

  • Vorhersagbarkeit: Eine geringe Varianz (wenn p nahe 0 oder 1 liegt) deutet auf besser vorhersehbare Ergebnisse hin, eine hohe Varianz (wenn p nahe 0,5 liegt) auf mehr Unsicherheit.
  • Informationsgehalt: Je näher p an 0,5 liegt, desto mehr Information liefert jeder Versuch, da die Ergebnisse weniger vorhersehbar sind.
  • Stichprobendesign: Die Varianz beeinflusst Stichprobengrößen in Experimenten. Höhere Varianz erfordert meist größere Stichproben für dieselbe Präzision.
  • Risikobewertung: In Bereichen wie Finanzen oder Versicherung kann die Varianz als Maß für Risiko bzw. Volatilität interpretiert werden.

Symmetrie und Asymmetrie

Die Form einer Bernoulli-Verteilung hängt vom Wert von p ab:

  • Bei p = 0,5 ist die Verteilung symmetrisch. Ein Beispiel ist der faire Münzwurf, bei dem Erfolg und Misserfolg gleich wahrscheinlich sind.
  • Bei p ≠ 0,5 ist die Verteilung asymmetrisch. Je näher p an 0 oder 1 liegt, desto stärker die Asymmetrie.

Die Symmetrie bzw. Asymmetrie beeinflusst die Interpretation auf mehrere Arten:

  • Erwartungsmanagement: Bei Symmetrie ist kein Ergebnis wahrscheinlicher – hilfreich für Entscheidungen ohne vorgegebene Präferenz, etwa in fairen Spielen.
  • Bias-Erkennung: Beobachtete Asymmetrie trotz erwarteter Symmetrie kann auf Verzerrungen im Prozess oder in der Messung hinweisen.
  • Schwellenwahl: In Klassifikationsaufgaben kann die Symmetrie/Asymmetrie die Wahl geeigneter Schwellenwerte beeinflussen.
  • Modellauswahl: Der Grad der Asymmetrie kann die Wahl statistischer Modelle oder ML-Algorithmen steuern.
  • Sampling-Strategien: Bei starker Asymmetrie (p sehr nahe 0 oder 1) können spezielle Stichprobenverfahren nötig sein, um seltene Ereignisse angemessen zu erfassen.

Praxisanwendungen von Bernoulli-Verteilungen

Bernoulli-Verteilungen werden in vielen Bereichen eingesetzt, besonders in Data Science und Statistik. Hier einige typische Anwendungen:

Binäre Klassifikation im Machine Learning

Im Machine Learning spielen Bernoulli-Verteilungen bei binären Klassifikationsproblemen eine Schlüsselrolle. Dabei werden Daten einer von zwei Klassen zugeordnet. Beispiele:

  • Spam-Erkennung in E-Mails (Spam oder Nicht-Spam)
  • Betrugserkennung bei Transaktionen (betrügerisch oder legitim)
  • Krankheitsdiagnosen anhand von Symptomen (vorhanden oder nicht vorhanden)

Algorithmen, die Bernoulli-Verteilungen für binäre Klassifikation nutzen, sind u. a.:

  1. Logistische Regression: Die logistische Regression nimmt an, dass der binäre Ausgang Bernoulli-verteilt ist. Sie modelliert die Erfolgswahrscheinlichkeit über die Logit-Funktion, die Inverse der logistischen Funktion. Das Ergebnis lässt sich als Bernoulli-Wahrscheinlichkeit interpretieren. Lies unsere Tutorials Understanding Logistic Regression in Python und Logistic Regression in R für die Details.
  2. Bernoulli Naive Bayes: Dieser Klassifikator basiert auf Naive Bayes und eignet sich besonders für Dokumentklassifikation mit binären Merkmalen (Wort vorhanden oder nicht).

Werde ein ML-Wissenschaftler

Bilde dich in Python weiter, um ein/e Wissenschaftler/in für maschinelles Lernen zu werden.
Kostenloses Lernen Beginnen

Hypothesentests

Bernoulli-Verteilungen sind grundlegend für Hypothesentests, insbesondere bei Anteilen oder Erfolgsraten. Häufige Anwendungen sind:

  • A/B-Tests im Marketing: Vergleich der Erfolgsraten zweier Marketingstrategien. Mehr zu A/B-Tests erfährst du in unserem Kurs Customer Analytics and A/B Testing in Python sowie im A/B Testing in R Code-Along.
  • Qualitätskontrolle: Prüfen, ob die Fehlerrate in einem Fertigungsprozess einen Grenzwert überschreitet.
  • Medizinische Studien: Beurteilung der Wirksamkeit einer neuen Behandlung im Vergleich zu Placebo.

In solchen Szenarien setzt die Nullhypothese oft einen konkreten Wert für die Erfolgswahrscheinlichkeit p an, während die Alternativhypothese diese Annahme anhand der beobachteten Daten in Frage stellt.

Simulation und Modellierung

Bernoulli-Verteilungen sind in Simulationen und probabilistischer Modellierung äußerst nützlich, vor allem bei binären Ergebnissen. Sie werden eingesetzt in:

  • Monte-Carlo-Simulationen: Modellierung komplexer Systeme mit vielen binären Entscheidungspunkten. Mehr dazu im Tutorial Introduction to Monte Carlo Methods.
  • Risikobewertung: Einschätzung von Erfolgs- oder Ausfallwahrscheinlichkeiten in Geschäftsszenarien.
  • Populationsgenetik: Modellierung der Vererbung von Merkmalen in genetischen Studien.

Durch das Ziehen zufälliger Stichproben aus einer Bernoulli-Verteilung können Forschende und Data Scientists realistische Simulationen komplexer Systeme und Prozesse erstellen.

Leistungsaspekte

Bei der Arbeit mit Bernoulli-Verteilungen in Datenanalyse und Machine Learning solltest du einige Leistungsaspekte beachten:

Umgang mit unausgeglichenen Daten

In vielen realen Szenarien ist die Erfolgswahrscheinlichkeit p ungleich 0,5 – Datensätze sind also unausgeglichen. Das kann ML-Modelle zugunsten der Mehrheitsklasse verzerren. Mögliche Strategien:

  1. Oversampling der Minderheitsklasse: Verfahren wie SMOTE (Synthetic Minority Oversampling Technique) erzeugen synthetische Beispiele.
  2. Undersampling der Mehrheitsklasse: Zufälliges Entfernen von Instanzen aus der Mehrheitsklasse.
  3. Anpassen der Klassen-Gewichte: Der Minderheitsklasse beim Training mehr Gewicht geben.
  4. Ensemble-Methoden nutzen: Verfahren wie Random Forests oder Gradient Boosting kommen oft besser mit unausgeglichenen Daten zurecht. Lies unser Tutorial What is Boosting, um mehr über Boosting und Ensembles zu erfahren.
  5. Geeignete Metriken wählen: Accuracy allein ist irreführend. Nutze z. B. F1-Score, Precision, Recall oder AUC-ROC.

Recheneffizienz

Bernoulli-Verteilungen sind recheneffizient, besonders bei großen Datensätzen in binären Klassifikationsaufgaben. Dennoch gilt es Folgendes zu beachten:

  1. Vektorisierung: Setze bei Bernoulli-basierten Algorithmen auf vektorisierte Operationen (z. B. NumPy in Python) für bessere Performance.
  2. Sparsamkeit: In der Textklassifikation mit Bernoulli Naive Bayes reduzieren Sparse-Matrizen Speicherbedarf und Rechenzeit deutlich.
  3. Trade-offs der Modellkomplexität: Komplexere Modelle liefern evtl. etwas bessere Ergebnisse, rechtfertigen aber nicht immer die höheren Kosten. Finde die Balance zwischen Genauigkeit und Laufzeit.

Häufige Missverständnisse

Um Bernoulli-Verteilungen wirklich zu verstehen, sollten wir einige Missverständnisse ausräumen:

Falsche Interpretation der Erfolgswahrscheinlichkeit

Ein verbreiteter Irrtum ist, anzunehmen, die Erfolgswahrscheinlichkeit p sei immer 0,5. Tatsächlich kann p jeden Wert zwischen 0 und 1 annehmen. Der konkrete Wert hängt vom betrachteten Prozess ab.

Zum Beispiel:

  • Beim fairen Münzwurf ist p = 0,5.
  • Bei einem gezinkten Würfel, bei dem eine 6 als Erfolg gilt, könnte p 1/4 sein.
  • In der Qualitätskontrolle mit 1 % Ausschuss ist p für einen "Defekt"-Ausgang 0,01.

Eine präzise Schätzung von p aus Daten ist entscheidend für valide Inferenz und Modelle. Oft bedeutet das: eine repräsentative Stichprobe erheben und den Erfolgsanteil berechnen.

Bernoulli vs. Binomialverteilung

Bernoulli- und Binomialverteilungen werden manchmal verwechselt. Sie sind verwandt, aber verschieden:

  • Eine Bernoulli-Verteilung modelliert einen einzelnen Versuch mit zwei möglichen Ausgängen.
  • Eine Binomialverteilung modelliert die Anzahl der Erfolge in einer festen Zahl unabhängiger Bernoulli-Versuche.

Mit anderen Worten: Eine Binomialverteilung ist die Summe mehrerer unabhängiger Bernoulli-Verteilungen. Wenn du z. B. eine Münze 10-mal wirfst und die Anzahl der Köpfe zählst, ist das eine Binomialverteilung. Jeder einzelne Wurf folgt jedoch einer Bernoulli-Verteilung. Lass uns das visuell vergleichen:
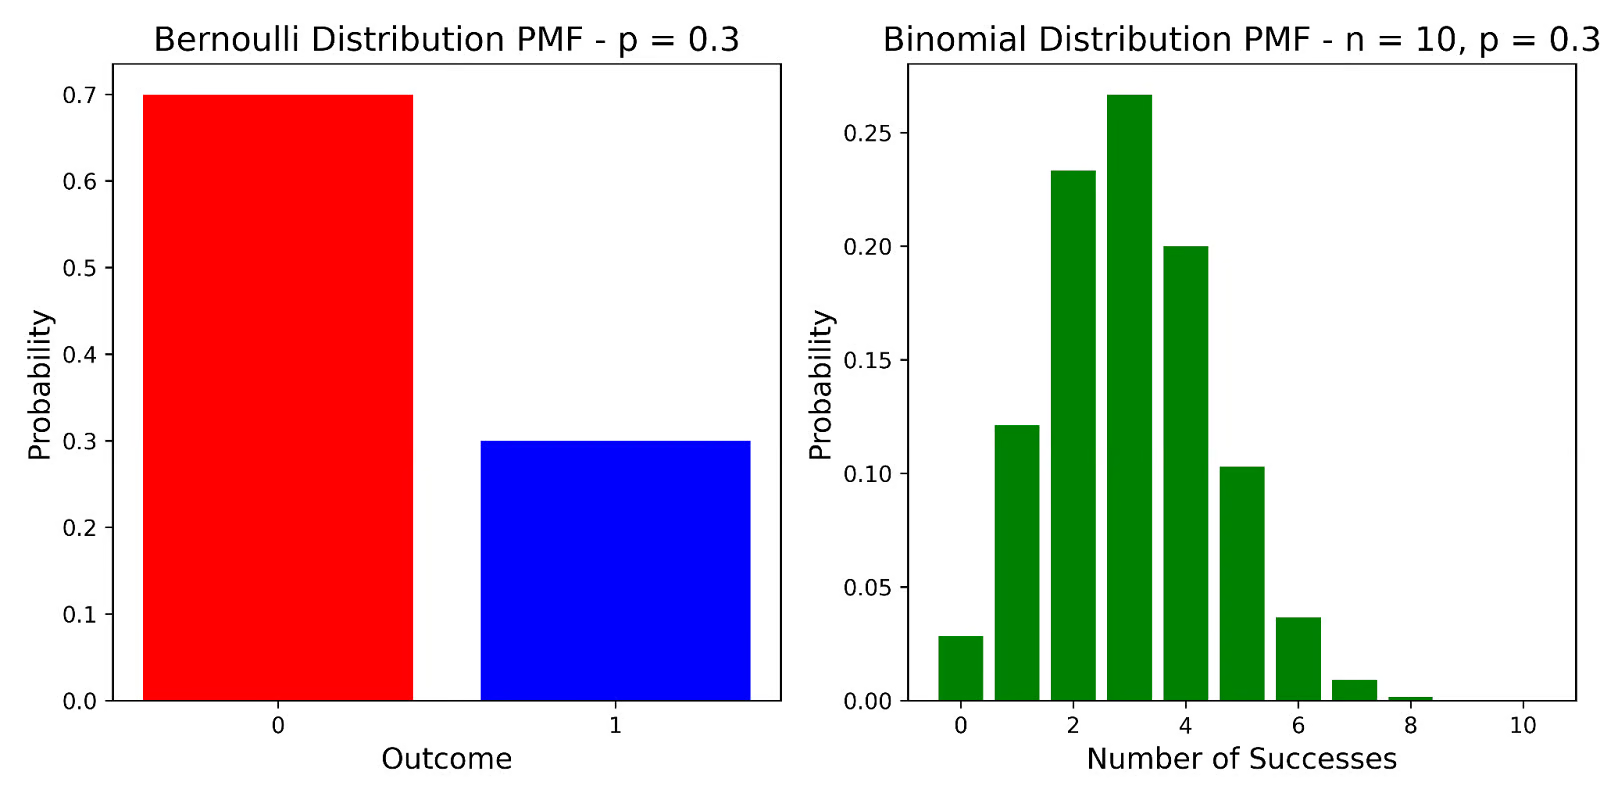
Bernoulli distribution versus binomial distribution

Bernoulli-Verteilung versus Binomialverteilung. Abbildung: Autorin/Autor.

Der Vergleich zeigt den grundlegenden Unterschied:

  • Die Bernoulli-Verteilung (links) steht für einen einzelnen Versuch mit zwei Ergebnissen: 0 (Misserfolg) oder 1 (Erfolg). Im Beispiel mit p = 0,3 sehen wir 70 % Misserfolg und 30 % Erfolg.
  • Die Binomialverteilung (rechts) beschreibt die Anzahl der Erfolge in mehreren Versuchen (hier 10). Sie zeigt die Wahrscheinlichkeit für jede mögliche Erfolgsanzahl von 0 bis 10. Ihre Form hängt sowohl von n (Zahl der Versuche) als auch von p (Erfolgswahrscheinlichkeit je Versuch) ab.

Während eine Bernoulli-Verteilung stets genau zwei mögliche Ergebnisse hat, kann eine Binomialverteilung n+1 mögliche Ausgänge haben, wobei n die Anzahl der Versuche ist.

Alternativen zur Bernoulli-Verteilung

So verbreitet sie ist: In manchen Fällen sind andere Verteilungen passender. Zwei häufige Alternativen:

Binomialverteilung

Die Binomialverteilung ist sinnvoll, wenn es um mehrere Versuche statt eines einzelnen Ereignisses geht. Sie wird genutzt, wenn dich die Anzahl der Erfolge über mehrere Anläufe hinweg interessiert – nicht nur das eine Ergebnis.

Geometrische Verteilung

Die Geometrische Verteilung kommt ins Spiel, wenn es darum geht, wie viele Versuche bis zum ersten Erfolg nötig sind. Sie wird häufig verwendet, wenn die Wartezeit bzw. Anzahl der Versuche bis zum Erfolg im Fokus steht.

Fazit

Bernoulli-Verteilungen sind die Grundlage vieler statistischer Konzepte und unverzichtbar in Data Science. Ihre einfache binäre Struktur und die breite Anwendung in Machine Learning, Hypothesentests und Simulation machen sie zu einem Schlüsselwerkzeug für die Analyse und Modellierung binärer Ergebnisse.

Die wichtigsten Punkte:

  1. Bernoulli-Verteilungen modellieren einzelne Versuche mit zwei möglichen Ergebnissen.
  2. Die Erfolgswahrscheinlichkeit p ist der zentrale Parameter.
  3. Es gibt zahlreiche Anwendungen in binärer Klassifikation, Hypothesentests und Simulationen.
  4. Das Verständnis ihrer Eigenschaften und typischer Irrtümer ist wichtig für den effektiven Einsatz.
  5. Je nach Szenario sind Alternativen wie Binomial- oder Geometrische Verteilung passender.

Wenn du diese Konzepte in bestimmten Programmiersprachen anwenden willst, bieten unsere Kurse Introduction to Statistics in Python und Introduction to Statistics in R praxisnahe Lernpfade. Für fortgeschrittene Themen baut der Kurs Mixture Models in R auf diesen Grundlagen auf und führt in komplexere statistische Modellierung ein. Und mit dem Skill Track Machine Learning in Production in Python hebst du deine ML-Kompetenzen auf Produktionsniveau und beginnst, anspruchsvolle Modelle auszurollen. 

Fähigkeiten im Bereich Machine Learning aufbauen

Bringe deine Fähigkeiten im maschinellen Lernen auf Produktionsniveau.

Vinod Chugani's photo
Author
Vinod Chugani
LinkedIn

Vinod Chugani startete seine Karriere in Tokio als jüngster Head of Hedge Fund Sales Desk bei JPMorgan und stellte später bei Lehman Brothers einen individuellen Verkaufsrekord auf, baute danach ein Elektronikvertriebsunternehmen in 30 Ländern auf über 100 Mio. SG$ Umsatz aus und wechselte anschließend in die Datenwelt. Als Economics-Absolvent der Duke University und Alumni der NYC Data Science Academy war er einer von drei Stipendiaten unter mehr als 100 Bewerbenden für Hugo Bowne-Andersons Kurs "Building AI Applications" auf Maven. Heute schreibt er für DataCamp, KDnuggets, Machine Learning Mastery und Statology über Themen von Statistik bis agentischer KI und coacht Datenprofis an der NYC Data Science Academy mit über 1.000 Eins-zu-eins-Sessions.


Häufig gestellte Fragen

Was ist eine Bernoulli-Verteilung?

Eine Bernoulli-Verteilung ist eine diskrete Wahrscheinlichkeitsverteilung für eine Zufallsvariable mit nur zwei möglichen Ergebnissen: Erfolg (meist als 1 gekennzeichnet) oder Misserfolg (meist als 0 gekennzeichnet). Sie wird durch einen einzigen Parameter p charakterisiert, der die Erfolgswahrscheinlichkeit angibt.

Worin unterscheiden sich Bernoulli- und Binomialverteilung?

Eine Bernoulli-Verteilung modelliert einen einzelnen Versuch mit zwei möglichen Ergebnissen, während eine Binomialverteilung die Anzahl der Erfolge in einer festen Zahl unabhängiger Bernoulli-Versuche modelliert. Du kannst dir die Binomialverteilung als Summe mehrerer Bernoulli-Verteilungen vorstellen.

Können Bernoulli-Verteilungen für Hypothesentests genutzt werden?

Ja, Bernoulli-Verteilungen werden häufig in Hypothesentests eingesetzt, insbesondere bei Anteilen oder Erfolgsraten. Sie sind besonders nützlich in A/B-Tests, bei denen die Erfolgsraten zweier Strategien oder Behandlungen verglichen werden.

Wie hängen Bernoulli-Verteilungen mit Odds und Log-Odds zusammen?

Die Quoten (odds) für Erfolg in einem Bernoulli-Versuch sind p/(1-p), wobei p die Erfolgswahrscheinlichkeit ist. Die Log-Odds, auch Logit-Funktion genannt, sind der natürliche Logarithmus dieser Quoten. Diese Konzepte werden häufig in der Logistischen Regression und anderen Analysen verwendet.

Wie schätze ich den Parameter p einer Bernoulli-Verteilung aus Daten?

Die gebräuchlichste Methode zur Schätzung von p ist die Maximum-Likelihood-Schätzung (MLE). Für eine Bernoulli-Verteilung entspricht die MLE von p einfach dem Erfolgsanteil in der Stichprobe. Beobachtest du z. B. 7 Erfolge in 10 Versuchen, beträgt deine Schätzung für p 0,7.

Themen
Datenwissenschaft
Datenanalyse

Lerne mit DataCamp

Kurs

Mischungsmodelle in R

4 Std.
5.2K
Lerne Mischungsmodelle kennen: ein praktischer und formaler statistischer Rahmen für probabilistisches Clustering und Klassifizierung.
Details anzeigenRight Arrow
Kurs Starten
Mehr anzeigenRight Arrow