Pular para o conteúdo principal

Distribuição de Bernoulli: um guia completo com exemplos

Descubra como a distribuição de Bernoulli representa resultados binários e é aplicada de lançamentos de moeda a previsões de clientes.
Atualizado 17 de set. de 2026  · 11 min lido

Explorar com IA

ChatGPTClaudePerplexity

A distribuição de Bernoulli é um conceito fundamental em estatística e ciência de dados. Batizada em homenagem ao matemático suíço Jacob Bernoulli, ela é importante na teoria da probabilidade e serve de base para modelos estatísticos mais complexos — de prever o comportamento de clientes a desenvolver algoritmos de machine learning.

Para começar, veja nosso curso Introduction to Statistics para relembrar distribuições de probabilidade. Considere também o curso Foundations of Probability in Python para estudar problemas com dois resultados possíveis e praticar com a biblioteca scipy. Nosso curso Statistical Thinking in Python (Part 1) também é uma ótima opção, pois você vai aprender a escrever suas próprias funções em Python para executar ensaios de Bernoulli.  

O que é uma distribuição de Bernoulli?

Uma distribuição de Bernoulli é uma distribuição de probabilidade discreta que modela uma variável aleatória com apenas dois resultados possíveis. Esses resultados são tipicamente rotulados como "sucesso" e "fracasso", ou representados numericamente por 1 e 0.

Ensaios de Bernoulli

Vamos começar pelos ensaios de Bernoulli. Um ensaio de Bernoulli é um experimento aleatório com exatamente dois resultados possíveis. Exemplos clássicos incluem:

  • Lançar uma moeda (cara ou coroa)
  • Responder uma questão de verdadeiro/falso
  • Determinar se um cliente fará uma compra (comprar ou não comprar)

Cada ensaio de Bernoulli é independente, ou seja, o resultado de um ensaio não afeta a probabilidade de sucesso nos ensaios seguintes.

Distribuições de Bernoulli

Uma distribuição de Bernoulli descreve a probabilidade de sucesso em um único ensaio de Bernoulli. Ela é caracterizada por um único parâmetro, p, que representa a probabilidade de sucesso. A probabilidade de fracasso, consequentemente, é 1 - p. Matematicamente, podemos expressar uma distribuição de Bernoulli assim, onde X é a variável aleatória que representa o resultado do ensaio de Bernoulli.

Para ilustrar como as distribuições de Bernoulli mudam com diferentes probabilidades de sucesso, vamos comparar três exemplos.
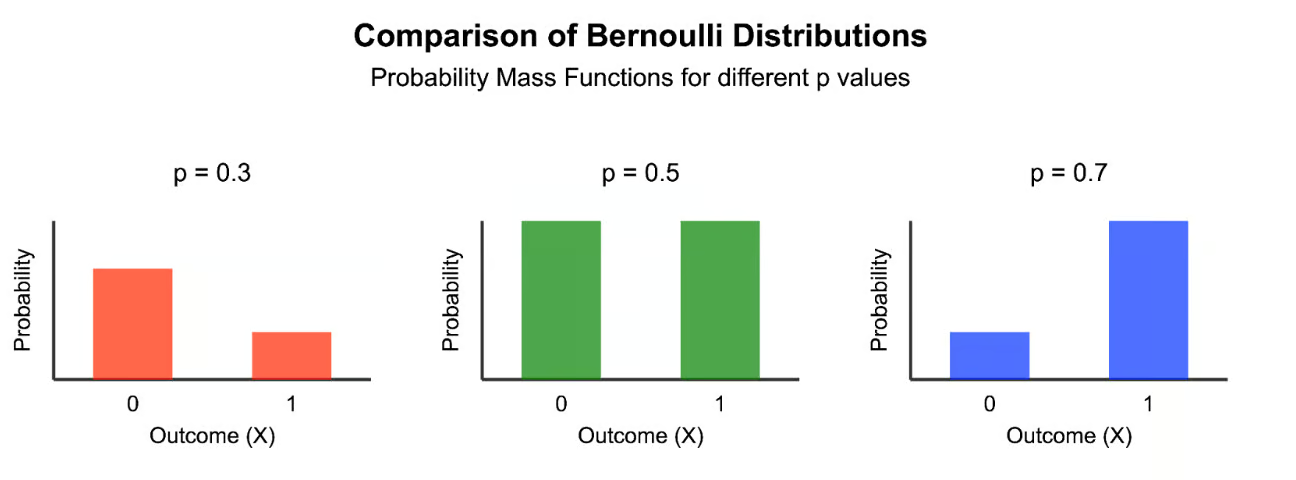
Comparação de distribuições de Bernoulli para diferentes valores de p

Comparação de distribuições de Bernoulli para diferentes valores de p. Imagem do autor. 

Aqui, cada gráfico mostra uma distribuição de Bernoulli diferente. 

  • Esquerda: p = 0,3 (30% de chance de sucesso)
  • Centro: p = 0,5 (50% de chance de sucesso)
  • Direita: p = 0,7 (70% de chance de sucesso)

Como podemos ver, a função massa de probabilidade de uma distribuição de Bernoulli sempre tem duas barras: uma para a probabilidade de fracasso (X = 0) e outra para a probabilidade de sucesso (X = 1). A altura dessas barras muda conforme o valor de p, mas elas sempre somam 1.

Propriedades das distribuições de Bernoulli

Vamos explorar as principais características que definem a distribuição de Bernoulli.

Resultados binários

A característica mais marcante de uma distribuição de Bernoulli é sua natureza binária. Cada ensaio pode resultar em apenas um de dois resultados possíveis:

  1. Sucesso (geralmente indicado por 1)
  2. Fracasso (geralmente indicado por 0)

Essa propriedade binária torna as distribuições de Bernoulli especialmente úteis quando nos interessamos por resultados do tipo sim/não, verdadeiro/falso ou sucesso/fracasso. Alguns benefícios de usar distribuições de Bernoulli em ciência de dados e machine learning:

  • Simplicidade na modelagem: Resultados binários permitem modelar probabilidades e chances de forma direta.
  • Facilidade de interpretação: Os resultados costumam ser facilmente interpretados como probabilidades ou proporções.
  • Versatilidade: Muitos cenários complexos podem ser decompostos em uma série de decisões ou resultados binários.
  • Base para distribuições mais complexas: Ensaios de Bernoulli são a base de outras distribuições importantes, como a binomial, que conta sucessos em múltiplos ensaios de Bernoulli, e a geométrica, que registra o número de ensaios até o primeiro sucesso.

Média e variância

A média (μ) e a variância ²) de uma distribuição de Bernoulli estão diretamente relacionadas à probabilidade de sucesso, p.

Média

A média é igual à probabilidade de sucesso. Isso implica que, se você repetir um ensaio de Bernoulli muitas vezes, o resultado médio vai convergir para p.

Variância

A variância é dada por: σ² = p(1 - p). A variância atinge seu máximo quando p = 0,5 e diminui à medida que p se aproxima de 0 ou 1. Essa relação fornece insights sobre a dispersão dos dados e a incerteza associada aos resultados. Em termos de dispersão, a variância em uma distribuição de Bernoulli indica:

  • Previsibilidade: Variância baixa (quando p está próximo de 0 ou 1) indica resultados mais previsíveis, enquanto variância alta (quando p está perto de 0,5) sugere maior incerteza.
  • Conteúdo informacional: Quanto mais próximo p estiver de 0,5, mais informação cada ensaio fornece, pois os resultados são menos previsíveis.
  • Considerações de amostragem: A variância orienta decisões de tamanho de amostra no desenho experimental. Variância mais alta geralmente exige amostras maiores para alcançar o mesmo nível de precisão nas estimativas.
  • Avaliação de risco: Em áreas como finanças ou seguros, a variância pode ser interpretada como medida de risco ou volatilidade.

Simetria e assimetria

O formato de uma distribuição de Bernoulli depende do valor de p:

  • Quando p = 0,5, a distribuição é simétrica. Um exemplo é o lançamento de uma moeda justa, em que as probabilidades de sucesso e fracasso são iguais.
  • Quando p ≠ 0,5, a distribuição se torna assimétrica. À medida que p se aproxima de 0 ou 1, a assimetria aumenta.

A simetria ou assimetria da distribuição afeta a interpretação de várias maneiras:

  • Definição de expectativas: Em uma distribuição simétrica, nenhum resultado é mais provável, o que pode orientar decisões em contextos sem viés para um dos lados, como em jogos justos.
  • Detecção de viés: Assimetria em resultados observados quando se espera simetria pode indicar viés no processo ou na medição.
  • Definição de limiares: Em tarefas de classificação, a simetria ou assimetria pode orientar a escolha de limiares de classificação.
  • Seleção de modelos: O grau de assimetria pode influenciar a escolha de modelos estatísticos ou algoritmos de machine learning.
  • Estratégias de amostragem: Em casos altamente assimétricos (p muito próximo de 0 ou 1), pode ser necessário usar técnicas especiais de amostragem para representar adequadamente eventos raros.

Aplicações práticas das distribuições de Bernoulli

Distribuições de Bernoulli são amplamente usadas em várias áreas, especialmente em ciência de dados e estatística. Vamos ver algumas aplicações comuns:

Classificação binária em machine learning

Em machine learning, distribuições de Bernoulli têm papel central em problemas de classificação binária — quando precisamos categorizar dados em uma de duas classes. Exemplos incluem:

  • Detecção de spam em e-mails (spam ou não spam)
  • Detecção de fraude em transações financeiras (fraudulenta ou legítima)
  • Diagnóstico de doenças com base em sintomas (presente ou ausente)

Algoritmos que aproveitam distribuições de Bernoulli para classificação binária incluem:

  1. Regressão logística: A regressão logística assume que o desfecho binário segue uma distribuição de Bernoulli. Ela modela a probabilidade do resultado usando a função logit, que é o inverso da função logística. O output pode ser interpretado como uma probabilidade Bernoulli. Leia nossos tutoriais Understanding Logistic Regression in Python e Logistic Regression in R para aprender os detalhes.
  2. Bernoulli Naive Bayes: Classificador baseado no algoritmo Naive Bayes, especialmente indicado para classificação de documentos quando as features são binárias (presença ou ausência de palavras).

Torne-se um cientista de ML

Aperfeiçoe suas habilidades em Python para se tornar um cientista de aprendizado de máquina.
Comece a Aprender De Graça

Testes de hipótese

Distribuições de Bernoulli são fundamentais em testes de hipótese, especialmente ao lidar com proporções ou taxas de sucesso. Aplicações comuns incluem:

  • Testes A/B em marketing: Comparar as taxas de sucesso de duas estratégias de marketing. Saiba mais sobre A/B testing com nosso curso Customer Analytics and A/B Testing in Python e também nosso code-along A/B Testing in R.
  • Controle de qualidade: Verificar se a taxa de defeitos em um processo de manufatura excede um determinado limite.
  • Ensaios clínicos: Avaliar a eficácia de um novo tratamento em comparação com placebo.

Nesses cenários, a hipótese nula costuma assumir um valor específico para a probabilidade de sucesso p, e a hipótese alternativa desafia essa suposição com base nos dados observados.

Simulação e modelagem

Distribuições de Bernoulli são úteis em simulações e modelagem probabilística, especialmente para cenários com resultados binários. Elas são usadas em:

  • Simulações de Monte Carlo: Modelar sistemas complexos com muitos pontos de decisão binária. Aprenda mais com nosso tutorial Introduction to Monte Carlo Methods.
  • Análise de risco: Avaliar a probabilidade de sucesso ou fracasso em cenários de negócios.
  • Genética de populações: Modelar a herança de características em estudos genéticos.

Ao gerar amostras aleatórias de uma distribuição de Bernoulli, pesquisadores e cientistas de dados conseguem criar simulações realistas de sistemas e processos complexos.

Considerações de desempenho

Ao trabalhar com distribuições de Bernoulli em análise de dados e machine learning, vale ter em mente algumas considerações de desempenho:

Tratando dados desbalanceados

Em muitos cenários reais, a probabilidade de sucesso p em uma distribuição de Bernoulli não é 0,5, levando a conjuntos de dados desbalanceados. Esse desbalanceamento pode desafiar algoritmos de machine learning, enviesando-os para a classe majoritária. Estratégias para lidar com isso incluem:

  1. Oversampling da classe minoritária: Técnicas como SMOTE (Synthetic Minority Oversampling Technique) geram amostras sintéticas da classe minoritária.
  2. Undersampling da classe majoritária: Remover aleatoriamente instâncias da classe majoritária para balancear o dataset.
  3. Ajuste de pesos de classe: Dar mais importância à classe minoritária durante o treino do modelo.
  4. Uso de métodos de ensemble: Técnicas como Random Forests ou Gradient Boosting costumam lidar melhor com dados desbalanceados do que modelos únicos. Leia nosso tutorial What is Boosting para aprender tudo sobre boosting e métodos de ensemble de forma geral.
  5. Escolha de métricas de avaliação adequadas: Acurácia sozinha pode ser enganosa em conjuntos desbalanceados. Considere métricas como F1-score, precisão, recall ou área sob a curva ROC.

Eficiência computacional

Distribuições de Bernoulli são eficientes computacionalmente, especialmente em grandes volumes de dados para tarefas de classificação binária. Ainda assim, há pontos de atenção:

  1. Vetorização: Ao implementar algoritmos baseados em Bernoulli, use operações vetorizadas (por exemplo, NumPy em Python) para ganhar performance.
  2. Esparsidade: Em classificação de texto com o classificador Bernoulli Naive Bayes, aproveitar representações de matrizes esparsas reduz significativamente uso de memória e tempo de computação.
  3. Trade-offs de complexidade do modelo: Embora modelos mais complexos possam oferecer ganho marginal de performance, o custo computacional nem sempre se justifica. Busque o equilíbrio entre acurácia e tempo de processamento.

Equívocos comuns

Para entender bem as distribuições de Bernoulli, é importante esclarecer alguns equívocos frequentes:

Interpretar mal a probabilidade de sucesso

Um erro comum é supor que a probabilidade de sucesso p em uma distribuição de Bernoulli é sempre 0,5. Na prática, p pode assumir qualquer valor entre 0 e 1, inclusive. O valor de p depende do cenário ou processo modelado.

Por exemplo:

  • No lançamento de uma moeda justa, p = 0,5.
  • Em um dado viciado, considerando sucesso sair 6, p pode ser 1/4.
  • Em um processo de controle de qualidade com taxa de defeito de 1%, p seria 0,01 para o desfecho "defeito".

Estimar p com precisão a partir dos dados é crucial para uma boa inferência estatística e modelagem. Isso geralmente envolve coletar uma amostra representativa e calcular a proporção de sucessos.

Bernoulli vs. distribuição binomial

Distribuições de Bernoulli às vezes são confundidas com distribuições Binomiais. Embora relacionadas, são distintas:

  • Uma distribuição de Bernoulli modela um único ensaio com dois resultados possíveis.
  • Uma distribuição binomial modela o número de sucessos em um número fixo de ensaios de Bernoulli independentes.

Em outras palavras, uma distribuição binomial é a soma de múltiplas distribuições de Bernoulli independentes. Por exemplo, se você lança uma moeda 10 vezes e conta quantas caras saem, isso é uma distribuição binomial. Cada lançamento individual, porém, segue uma distribuição de Bernoulli. Vamos compará-las visualmente:
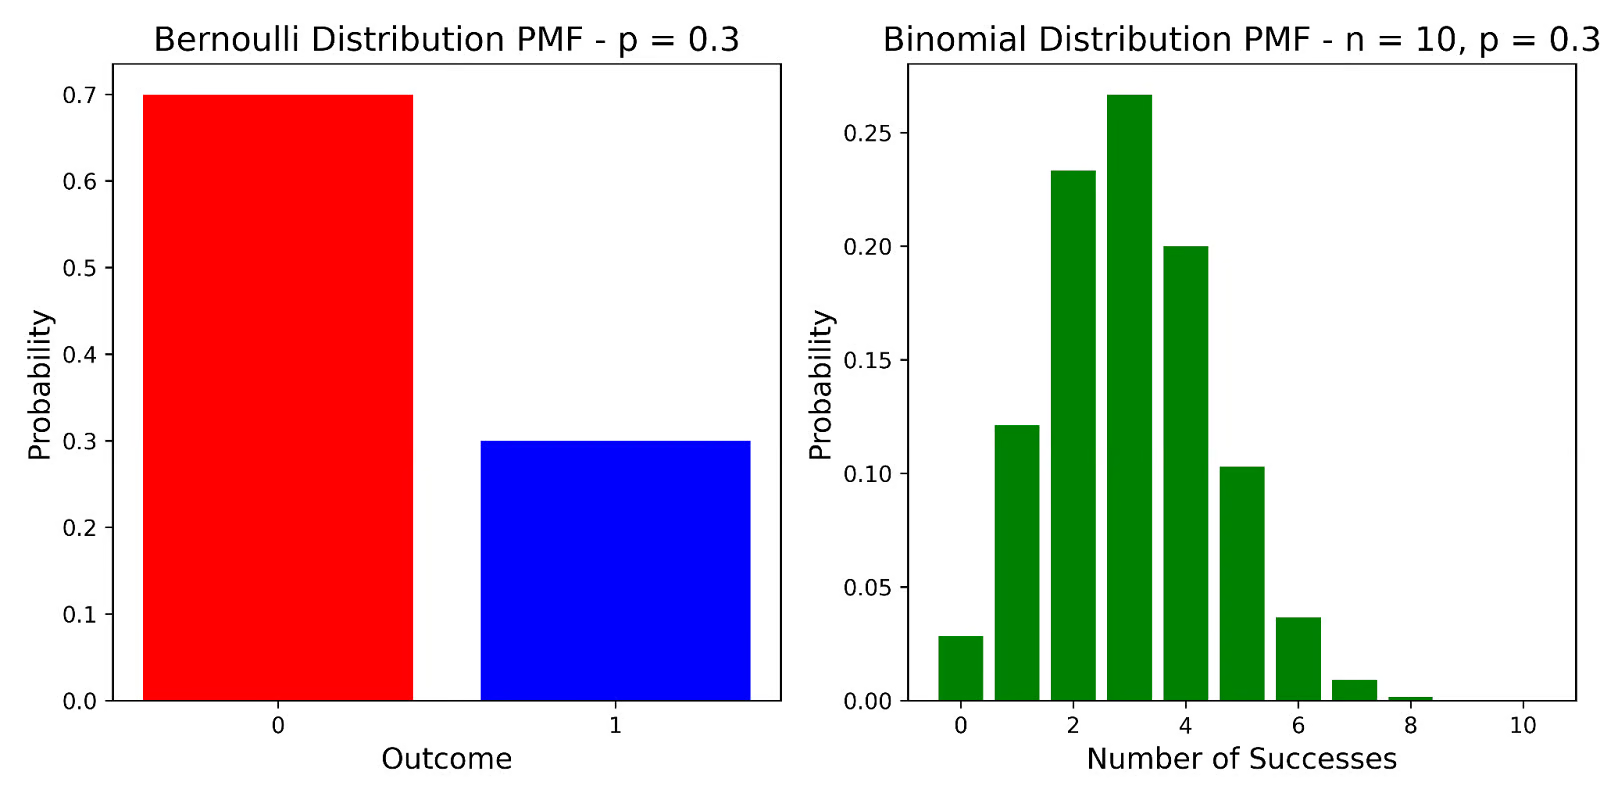
Distribuição de Bernoulli versus distribuição binomial

Distribuição de Bernoulli versus distribuição binomial. Imagem do autor.

Essa comparação mostra claramente a diferença fundamental entre as duas distribuições:

  • A distribuição de Bernoulli (à esquerda) representa um único ensaio com apenas dois resultados possíveis: 0 (fracasso) ou 1 (sucesso). Neste exemplo, com p = 0,3, temos 70% de chance de fracasso e 30% de chance de sucesso.
  • A distribuição binomial (à direita) representa o número de sucessos em múltiplos ensaios (neste caso, 10 ensaios). Ela mostra a probabilidade de obter cada número possível de sucessos, de 0 a 10. O formato dessa distribuição é determinado tanto por n (o número de ensaios) quanto por p (a probabilidade de sucesso em cada ensaio).

Enquanto uma distribuição de Bernoulli sempre tem exatamente dois resultados possíveis, uma distribuição binomial pode ter n+1 resultados possíveis, onde n é o número de ensaios.

Alternativas às distribuições de Bernoulli

Embora amplamente utilizadas, há cenários em que distribuições alternativas podem ser mais adequadas. Veja duas opções comuns:

Distribuição binomial

A distribuição binomial é útil quando você está lidando com múltiplos ensaios, e não um único evento. Essa alternativa é indicada quando o interesse está no número de sucessos em várias tentativas, e não apenas em um único resultado.

Distribuição geométrica

A distribuição geométrica entra em cena quando o interesse é saber quantas tentativas serão necessárias até o primeiro sucesso. É aplicada em situações em que o foco é o tempo de espera ou o número de tentativas até o sucesso acontecer.

Conclusão

Distribuições de Bernoulli são a base de muitos conceitos estatísticos e componentes essenciais em ciência de dados. Sua natureza binária simples, somada às diversas aplicações em machine learning, testes de hipótese e simulação, faz delas um pilar para analisar e modelar resultados binários.

Resumo dos aprendizados:

  1. Distribuições de Bernoulli modelam ensaios únicos com dois resultados possíveis.
  2. A probabilidade de sucesso p é o parâmetro-chave que define a distribuição.
  3. Elas têm muitas aplicações em classificação binária, testes de hipótese e simulações.
  4. Entender suas propriedades e equívocos comuns é útil para aplicar com eficácia.
  5. Embora poderosas, alternativas como as distribuições binomial e geométrica podem ser mais adequadas em certos cenários.

Se você quer aplicar esses conceitos em linguagens específicas, nossos cursos Introduction to Statistics in Python e Introduction to Statistics in R oferecem uma experiência prática e mão na massa. E, se já estiver pronto para avançar, o curso Mixture Models in R aprofunda esses fundamentos para explorar técnicas mais complexas de modelagem estatística. Por fim, veja nossa trilha de habilidades Machine Learning in Production in Python para levar suas habilidades de machine learning ao nível de produção e começar a implantar modelos avançados. 

Desenvolver habilidades de aprendizado de máquina

Eleve suas habilidades de aprendizado de máquina ao nível de produção.

Vinod Chugani's photo
Author
Vinod Chugani
LinkedIn

Vinod Chugani começou a carreira em Tóquio como o mais jovem Head do Hedge Fund Sales Desk do JPMorgan e, depois, bateu um recorde individual de vendas no Lehman Brothers, em seguida construiu um negócio de distribuição de eletrônicos em 30 países que superou SG$ 100 milhões em receita antes de migrar para dados. Formado em economia por Duke e ex-aluno da NYC Data Science Academy, foi um dos três bolsistas selecionados entre mais de 100 candidatos para o curso Building AI Applications, do Hugo Bowne-Anderson, na Maven. Hoje, escreve para a DataCamp, KDnuggets, Machine Learning Mastery e Statology sobre temas que vão de estatística a IA agente e mentora profissionais de dados na NYC Data Science Academy, com mais de 1.000 sessões individuais no currículo.


Perguntas frequentes

O que é uma distribuição de Bernoulli?

Uma distribuição de Bernoulli é uma distribuição de probabilidade discreta para uma variável aleatória que tem apenas dois resultados possíveis: sucesso (geralmente indicado por 1) ou fracasso (geralmente indicado por 0). Ela é caracterizada por um único parâmetro p, que representa a probabilidade de sucesso.

Qual é a diferença entre uma distribuição de Bernoulli e uma Binomial?

Uma distribuição de Bernoulli modela um único ensaio com dois resultados possíveis, enquanto uma distribuição Binomial modela o número de sucessos em um número fixo de ensaios de Bernoulli independentes. Você pode pensar na distribuição Binomial como a soma de múltiplas distribuições de Bernoulli.

Distribuições de Bernoulli podem ser usadas em testes de hipótese?

Sim, distribuições de Bernoulli são comumente usadas em testes de hipótese, especialmente em cenários que envolvem proporções ou taxas de sucesso. Elas são particularmente úteis em testes A/B, quando você compara as taxas de sucesso de duas estratégias ou tratamentos.

Como distribuições de Bernoulli se relacionam com odds e log-odds?

As odds (chances) de sucesso em um ensaio de Bernoulli são p/(1-p), onde p é a probabilidade de sucesso. O log-odds, também conhecido como função logit, é o logaritmo natural das odds. Esses conceitos são comuns em regressão logística e outras análises estatísticas.

Como posso estimar o parâmetro p de uma distribuição de Bernoulli a partir de dados?

O método mais comum para estimar p é a estimação por máxima verossimilhança (MLE). Para uma distribuição de Bernoulli, o MLE de p é simplesmente a proporção de sucessos na sua amostra. Por exemplo, se você observar 7 sucessos em 10 ensaios, sua estimativa de p será 0,7.

Tópicos
Ciência de dados
Data Analysis

Aprenda com a DataCamp

Curso

Modelos de Mistura em R

4 h
5.2K
Aprenda modelos de mistura, um framework estatístico formal para agrupamento e classificação probabilísticos.
Ver detalhesRight Arrow
Iniciar Curso
Ver maisRight Arrow
Relacionado
Artificial Intelligence Concept Art

blog

Guia de casos de uso em data science

Conheça casos de uso em data science e descubra como aplicar data science em diferentes setores para impulsionar crescimento e a tomada de decisões.
Elena Kosourova's photo

Elena Kosourova

15 min

blog

Como criar um excelente portfólio de ciência de dados (com exemplos)

Aqui está nosso guia essencial sobre as características de um excelente portfólio de ciência de dados e por que criar um pode aumentar suas perspectivas de carreira.
Adel Nehme's photo

Adel Nehme

13 min

blog

O que é análise de dados? Um guia especializado com exemplos

Explore o mundo da análise de dados com nosso guia abrangente. Saiba mais sobre sua importância, processo, tipos, técnicas, ferramentas e as principais carreiras em 2023
Matt Crabtree's photo

Matt Crabtree

10 min

blog

11 técnicas de visualização de dados para cada caso de uso com exemplos

Descubra as análises, técnicas e ferramentas mais populares para dominar a arte do assistente de visualização de dados
Javier Canales Luna's photo

Javier Canales Luna

12 min

multiple linear regression

Tutorial

Regressão linear múltipla no R: Tutorial com exemplos

Uma visão geral completa para entender as regressões lineares múltiplas no R por meio de exemplos.
Zoumana Keita 's photo

Zoumana Keita

12 min

Tutorial
Entendendo a assimetria e a curtose e como traçá-las

Um guia visual abrangente sobre assimetria/curtose e como elas afetam as distribuições e, por fim, seu projeto de ciência de dados.
Ver MaisVer Mais