

परिकल्पना परीक्षण
बर्नौली डिस्ट्रीब्यूशन्स परिकल्पना परीक्षण में बुनियादी होते हैं, खासकर जब अनुपातों या सफलता दरों से निपटना हो। सामान्य उपयोग शामिल हैं:
- मार्केटिंग में A/B परीक्षण: दो अलग-अलग मार्केटिंग रणनीतियों की सफलता दरों की तुलना करना। हमारे Customer Analytics and A/B Testing in Python कोर्स और A/B Testing in R कोड-अलॉन्ग के साथ A/B परीक्षण के बारे में और जानें।
- गुणवत्ता नियंत्रण: यह जांचना कि विनिर्माण प्रक्रिया में दोष दर किसी निर्धारित सीमा से अधिक तो नहीं है।
- चिकित्सीय परीक्षण: किसी नए उपचार की प्रभावशीलता को प्लेसीबो के मुकाबले परखना।
इन परिदृश्यों में, शून्य परिकल्पना अक्सर सफलता की प्रायिकता p के लिए एक विशिष्ट मान मानती है, और वैकल्पिक परिकल्पना देखे गए डेटा के आधार पर इस मान्यता को चुनौती देती है।
सिमुलेशन और मॉडलिंग
बर्नौली डिस्ट्रीब्यूशन्स सिमुलेशन और प्रायिकता-आधारित मॉडलिंग में काम के होते हैं, विशेषकर उन परिदृश्यों के लिए जहां परिणाम बाइनरी होते हैं। इनका उपयोग यहां होता है:
- मोंटे कार्लो सिमुलेशन्स: कई बाइनरी निर्णय बिंदुओं वाले जटिल सिस्टम्स का मॉडलिंग करना। हमारे Introduction to Monte Carlo Methods ट्यूटोरियल के साथ और जानें।
- जोखिम विश्लेषण: व्यवसायिक परिदृश्यों में सफलता या असफलता की प्रायिकता का आकलन करना।
- जनसंख्या आनुवंशिकी: आनुवंशिक अध्ययनों में गुणों की विरासत का मॉडलिंग करना।
बर्नौली डिस्ट्रीब्यूशन से रैंडम सैंपल्स उत्पन्न करके, शोधकर्ता और डेटा वैज्ञानिक जटिल सिस्टम्स और प्रक्रियाओं के यथार्थपरक सिमुलेशन बना सकते हैं।
प्रदर्शन संबंधी विचार
डेटा विश्लेषण और मशीन लर्निंग में बर्नौली डिस्ट्रीब्यूशन्स के साथ काम करते समय कई प्रदर्शन संबंधी बातों का ध्यान रखना चाहिए:
असंतुलित डेटा को संभालना
कई वास्तविक-जीवन परिदृश्यों में, बर्नौली डिस्ट्रीब्यूशन में सफलता की प्रायिकता p 0.5 नहीं होती, जिससे असंतुलित डेटासेट बनते हैं। यह असंतुलन मशीन लर्निंग एल्गोरिदम के लिए चुनौतियां पैदा कर सकता है, जो संभावित रूप से उन्हें बहुलता वर्ग की ओर पक्षपाती कर सकता है। इससे निपटने की रणनीतियां शामिल हैं:
- माइनॉरिटी क्लास का ओवरसैंपलिंग: SMOTE (Synthetic Minority Oversampling Technique) जैसी तकनीकों से माइनॉरिटी क्लास के कृत्रिम सैंपल जनरेट किए जा सकते हैं।
- मेजॉरिटी क्लास का अंडरसैंपलिंग: डेटासेट को संतुलित करने के लिए मेजॉरिटी क्लास से रैंडम रूप से उदाहरण हटाना।
- क्लास वेट्स समायोजित करना: मॉडल प्रशिक्षण के दौरान माइनॉरिटी क्लास को अधिक महत्व देना।
- एंसेंबल विधियों का उपयोग: Random Forests या Gradient Boosting जैसी तकनीकें अक्सर एकल मॉडलों की तुलना में असंतुलित डेटा को बेहतर तरीके से संभालती हैं। बूस्टिंग और सामान्य रूप से एंसेंबल विधियों के बारे में सब कुछ जानने के लिए हमारा What is Boosting ट्यूटोरियल पढ़ें।
- उपयुक्त मूल्यांकन मेट्रिक्स का चयन: केवल सटीकता (accuracy) असंतुलित डेटासेट्स के लिए भ्रामक हो सकती है। F1-स्कोर, प्रिसिजन, रिकॉल, या ROC कर्व के नीचे का क्षेत्र (AUC) जैसे मेट्रिक्स पर विचार करें।
कम्प्यूटेशनल दक्षता
बर्नौली डिस्ट्रीब्यूशन्स कम्प्यूटेशनल रूप से कुशल होते हैं, खासकर बाइनरी वर्गीकरण कार्यों में बड़े डेटासेट्स के लिए। फिर भी, कुछ बातों का ध्यान रखें:
- वेक्टराइज़ेशन: बर्नौली-आधारित एल्गोरिदम लागू करते समय बेहतर प्रदर्शन के लिए वेक्टराइज़्ड ऑपरेशन्स (जैसे Python में NumPy) का उपयोग करें।
- स्पार्सिटी: बर्नौली नैव बेयज़ के साथ टेक्स्ट वर्गीकरण कार्यों में, स्पार्स मैट्रिक्स प्रतिनिधित्वों का लाभ उठाने से मेमोरी उपयोग और गणना समय में उल्लेखनीय कमी आ सकती है।
- मॉडल जटिलता में समझौते: जहां अधिक जटिल मॉडल थोड़ा बेहतर प्रदर्शन दे सकते हैं, वहां कम्प्यूटेशनल लागत हमेशा सीमांत सुधार को सही नहीं ठहराती। मॉडल शुद्धता और प्रोसेसिंग समय के बीच संतुलन पर विचार करें।
सामान्य भ्रांतियां
बर्नौली डिस्ट्रीब्यूशन्स को पूरी तरह समझने के लिए, कुछ सामान्य भ्रांतियों को संबोधित करना महत्वपूर्ण है:
सफलता की प्रायिकता की गलत व्याख्या
एक सामान्य भ्रांति यह मान लेना है कि बर्नौली डिस्ट्रीब्यूशन में सफलता की प्रायिकता p हमेशा 0.5 होती है। वास्तव में, p 0 और 1 के बीच कोई भी मान ले सकता है, दोनों सहित। p का मान उस विशिष्ट परिदृश्य या प्रक्रिया पर निर्भर करता है जिसका मॉडलिंग किया जा रहा है।
उदाहरण के लिए:
- निष्पक्ष सिक्का उछाल में, p = 0.5।
- लोडेड पासे में जहां 6 आना सफलता माना जाता है, p 1/4 हो सकता है।
- गुणवत्ता नियंत्रण प्रक्रिया में जहां दोष दर 1% है, "दोष" परिणाम के लिए p 0.01 होगा।
डेटा से p का सटीक अनुमान लगाना उचित सांख्यिकीय निष्कर्ष और मॉडलिंग के लिए महत्वपूर्ण है। इसमें अक्सर एक प्रतिनिधि नमूना एकत्रित करना और सफलताओं के अनुपात की गणना करना शामिल होता है।
बर्नौली बनाम बाइनोमियल डिस्ट्रीब्यूशन
बर्नौली डिस्ट्रीब्यूशन्स को कभी-कभी बाइनोमियल डिस्ट्रीब्यूशन्स के साथ भ्रमित किया जाता है। हालांकि संबंधित हैं, वे अलग हैं:
- बर्नौली डिस्ट्रीब्यूशन दो संभव परिणामों वाले एकल ट्रायल को मॉडल करता है।
- बाइनोमियल डिस्ट्रीब्यूशन स्वतंत्र बर्नौली ट्रायल्स की एक निश्चित संख्या में सफलताओं की संख्या को मॉडल करता है।
दूसरे शब्दों में, बाइनोमियल डिस्ट्रीब्यूशन कई स्वतंत्र बर्नौली डिस्ट्रीब्यूशन्स का योग है। उदाहरण के लिए, यदि आप सिक्का 10 बार उछालते हैं और हेड्स की संख्या गिनते हैं, तो वह बाइनोमियल डिस्ट्रीब्यूशन है। हालांकि, प्रत्येक व्यक्तिगत उछाल बर्नौली डिस्ट्रीब्यूशन का अनुसरण करता है। आइए इन्हें दृश्य रूप से तुलना करें:
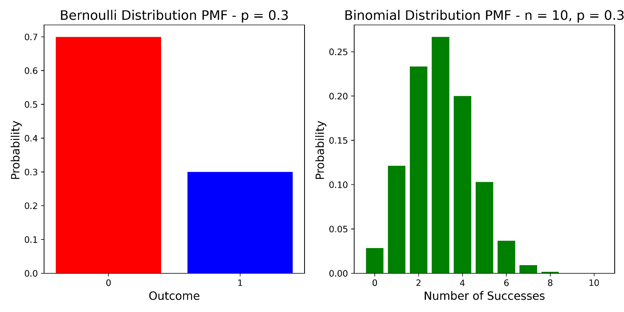
बर्नौली डिस्ट्रीब्यूशन बनाम बाइनोमियल डिस्ट्रीब्यूशन। चित्र: लेखक द्वारा।
यह तुलना इन दो डिस्ट्रीब्यूशन्स के बीच का मौलिक अंतर स्पष्ट रूप से दिखाती है:
- बर्नौली डिस्ट्रीब्यूशन (बाएं) एकल ट्रायल का प्रतिनिधित्व करता है जिसमें केवल दो संभावित परिणाम होते हैं: 0 (असफलता) या 1 (सफलता)। इस उदाहरण में, p = 0.3 होने पर, 70% असफलता और 30% सफलता की संभावना दिखती है।
- बाइनोमियल डिस्ट्रीब्यूशन (दाएं) कई ट्रायल्स (यहां 10 ट्रायल्स) में सफलताओं की संख्या का प्रतिनिधित्व करता है। यह 0 से 10 तक संभावित सफलताओं की प्रत्येक संख्या को प्राप्त करने की प्रायिकता दिखाता है। इस डिस्ट्रीब्यूशन का आकार n (ट्रायल्स की संख्या) और p (प्रत्येक ट्रायल में सफलता की प्रायिकता) दोनों से निर्धारित होता है।
जहां बर्नौली डिस्ट्रीब्यूशन में हमेशा ठीक दो संभावित परिणाम होते हैं, वहीं बाइनोमियल डिस्ट्रीब्यूशन में n+1 संभावित परिणाम हो सकते हैं, जहां n ट्रायल्स की संख्या है।
बर्नौली डिस्ट्रीब्यूशन के विकल्प
हालांकि बर्नौली डिस्ट्रीब्यूशन्स का व्यापक उपयोग होता है, कुछ स्थितियों में वैकल्पिक डिस्ट्रीब्यूशन्स अधिक उपयुक्त हो सकते हैं। आइए दो सामान्य विकल्पों को देखें:
बाइनोमियल डिस्ट्रीब्यूशन
जब आप एकल घटना के बजाय कई ट्रायल्स से निपट रहे हों, तो बाइनोमियल डिस्ट्रीब्यूशन उपयोगी होता है। जब आप एक परिणाम के बजाय कई प्रयासों में सफलताओं की संख्या में रुचि रखते हैं, तब इस विकल्प पर विचार किया जाता है।
ज्योमेट्रिक डिस्ट्रीब्यूशन
ज्योमेट्रिक डिस्ट्रीब्यूशन तब काम आता है जब आपकी रुचि यह जानने में हो कि पहली सफलता प्राप्त करने में कितने प्रयास लगेंगे। इसका उपयोग अक्सर उन स्थितियों में किया जाता है जहां ध्यान सफलता होने से पहले प्रतीक्षा समय या प्रयासों की संख्या पर केंद्रित होता है।
निष्कर्ष
बर्नौली डिस्ट्रीब्यूशन्स कई सांख्यिकीय अवधारणाओं की नींव बनाते हैं और डेटा विज्ञान के आवश्यक घटक हैं। उनका सरल बाइनरी स्वभाव, मशीन लर्निंग, परिकल्पना परीक्षण और सिमुलेशन में व्यापक उपयोग के साथ मिलकर, बाइनरी परिणामों के विश्लेषण और मॉडलिंग के लिए इन्हें एक प्रमुख ढांचा बनाता है।
मुख्य सारांश:
- बर्नौली डिस्ट्रीब्यूशन्स दो संभावित परिणामों वाले एकल ट्रायल्स को मॉडल करते हैं।
- सफलता की प्रायिकता p वह प्रमुख पैरामीटर है जो वितरण को परिभाषित करता है।
- इनका बाइनरी वर्गीकरण, परिकल्पना परीक्षण और सिमुलेशन्स में व्यापक उपयोग है।
- इनके गुणों और सामान्य भ्रांतियों को समझना प्रभावी अनुप्रयोग के लिए उपयोगी है।
- जहां उपयुक्त हो, बाइनोमियल और ज्योमेट्रिक जैसे विकल्प अधिक अनुकूल हो सकते हैं।
यदि आप इन अवधारणाओं को विशिष्ट प्रोग्रामिंग परिवेशों में लागू करने में रुचि रखते हैं, तो हमारे Introduction to Statistics in Python और Introduction to Statistics in R कोर्स व्यावहारिक, हाथ-से-सीखने के अनुभव प्रदान करते हैं। और यदि आप अधिक उन्नत विषयों को देखना चाहते हैं, तो Mixture Models in R कोर्स इन बुनियादी अवधारणाओं पर आधारित होकर अधिक जटिल सांख्यिकीय मॉडलिंग तकनीकों का अन्वेषण करता है। अंत में, अपने मशीन लर्निंग कौशल को प्रोडक्शन स्तर तक ले जाने और उन्नत मॉडलों को डिप्लॉय करना शुरू करने के लिए हमारे Machine Learning in Production in Python स्किल ट्रैक पर नज़र डालें.

विनोद चुगानी ने टोक्यो में जेपीमॉर्गन के सबसे कम उम्र के हेज फंड सेल्स डेस्क हेड के रूप में अपना करियर शुरू किया और बाद में लेहमन ब्रदर्स में व्यक्तिगत बिक्री का रिकॉर्ड बनाया, फिर 30 देशों में फैला एक इलेक्ट्रॉनिक्स डिस्ट्रीब्यूशन व्यवसाय बनाया, जिसकी आय SG$100 मिलियन से आगे बढ़ी, इसके बाद उन्होंने डेटा की ओर रुख किया। ड्यूक में अर्थशास्त्र के स्नातक और NYC डेटा साइंस अकादमी के पूर्व छात्र, वे मेवन पर ह्यूगो बोव्न-एंडरसन के Building AI Applications कोर्स के लिए 100+ आवेदनों में से तीन छात्रवृत्ति प्राप्तकर्ताओं में से एक थे। आज, वे DataCamp, KDnuggets, Machine Learning Mastery, और Statology के लिए सांख्यिकी से लेकर एजेंटिक एआई तक के विषयों पर लिखते हैं, और NYC डेटा साइंस अकादमी में डेटा प्रोफेशनलों को मेंटर करते हैं, उनके नाम पर 1,000 से अधिक एक-से-एक सत्र हैं।
अक्सर पूछे जाने वाले प्रश्न
बर्नौली डिस्ट्रीब्यूशन क्या है?
बर्नौली डिस्ट्रीब्यूशन एक डिस्क्रीट प्रायिकता वितरण है, जिसमें रैंडम वैरिएबल के केवल दो संभावित परिणाम होते हैं: सफलता (आमतौर पर 1) या असफलता (आमतौर पर 0)। यह एक ही पैरामीटर p से वर्णित होता है, जो सफलता की प्रायिकता को दर्शाता है।
बर्नौली और बाइनोमियल डिस्ट्रीब्यूशन में क्या अंतर है?
बर्नौली डिस्ट्रीब्यूशन एकल ट्रायल को मॉडल करता है जिसमें दो संभव परिणाम होते हैं, जबकि बाइनोमियल डिस्ट्रीब्यूशन स्वतंत्र बर्नौली ट्रायल्स की एक निश्चित संख्या में सफलताओं की संख्या को मॉडल करता है। आप बाइनोमियल डिस्ट्रीब्यूशन को कई बर्नौली डिस्ट्रीब्यूशन्स के योग के रूप में समझ सकते हैं।
क्या बर्नौली डिस्ट्रीब्यूशन्स का उपयोग परिकल्पना परीक्षण में किया जा सकता है?
हाँ, बर्नौली डिस्ट्रीब्यूशन्स का उपयोग परिकल्पना परीक्षण में आमतौर पर किया जाता है, खासकर अनुपातों या सफलता दरों वाले परिदृश्यों में। ये विशेष रूप से A/B परीक्षण में उपयोगी हैं, जहां आप दो अलग-अलग रणनीतियों या ट्रीटमेंट्स की सफलता दरों की तुलना करते हैं।
बर्नौली डिस्ट्रीब्यूशन्स का ऑड्स और लॉग-ऑड्स से क्या संबंध है?
बर्नौली ट्रायल में सफलता के ऑड्स p/(1-p) होते हैं, जहां p सफलता की प्रायिकता है। लॉग-ऑड्स, जिसे लॉजिट फ़ंक्शन भी कहा जाता है, ऑड्स का नैचुरल लॉगरिदम होता है। इन अवधारणाओं का उपयोग लॉजिस्टिक रिग्रेशन और अन्य सांख्यिकीय विश्लेषणों में आम है।
डेटा से बर्नौली डिस्ट्रीब्यूशन के p पैरामीटर का अनुमान कैसे लगाऊं?
p का अनुमान लगाने की सबसे सामान्य विधि मैक्सिमम लाइकलीहुड एस्टीमेशन (MLE) है। बर्नौली डिस्ट्रीब्यूशन के लिए, p का MLE आपके सैंपल में सफलताओं का अनुपात होता है। उदाहरण के लिए, यदि आप 10 ट्रायल्स में 7 सफलताएं देखते हैं, तो p का आपका अनुमान 0.7 होगा।
बर्नौली डिस्ट्रीब्यूशन सांख्यिकी और डेटा विज्ञान में एक मौलिक अवधारणा है। स्विस गणितज्ञ जैकब बर्नौली के नाम पर रखा गया यह वितरण प्रायिकता सिद्धांत में महत्वपूर्ण है और अधिक जटिल सांख्यिकीय मॉडलों के लिए आधार का काम करता है—ग्राहक व्यवहार का पूर्वानुमान लगाने से लेकर मशीन लर्निंग एल्गोरिदम विकसित करने तक।
शुरू करने के लिए, प्रायिकता वितरणों पर ताज़गी के लिए हमारे Introduction to Statistics कोर्स पर विचार करें। साथ ही, दो संभावित परिणामों वाली समस्याओं का अध्ययन करने और
scipyलाइब्रेरी के साथ अभ्यास करने के लिए हमारा Foundations of Probability in Python कोर्स भी देखें। हमारा Statistical Thinking in Python (Part 1) कोर्स एक और बेहतरीन विकल्प है क्योंकि यह आपको बर्नौली ट्रायल्स करने के लिए अपने स्वयं के Python फ़ंक्शन लिखना सिखाएगा.बर्नौली डिस्ट्रीब्यूशन क्या है?
बर्नौली डिस्ट्रीब्यूशन एक डिस्क्रीट प्रायिकता वितरण है जो ऐसे रैंडम वैरिएबल को मॉडल करता है जिसके केवल दो संभावित परिणाम होते हैं। इन परिणामों को आमतौर पर "सफलता" और "असफलता" कहा जाता है, या संख्यात्मक रूप में 1 और 0 से दर्शाया जाता है।
बर्नौली ट्रायल्स
आइए बर्नौली ट्रायल्स से शुरू करें। एक बर्नौली ट्रायल एक रैंडम प्रयोग है जिसमें ठीक दो संभावित परिणाम होते हैं। क्लासिक उदाहरण:
प्रत्येक बर्नौली ट्रायल स्वतंत्र होता है, यानी एक ट्रायल का परिणाम आगे के ट्रायल्स में सफलता की प्रायिकता को प्रभावित नहीं करता।
बर्नौली डिस्ट्रीब्यूशन्स
एक बर्नौली डिस्ट्रीब्यूशन एकल बर्नौली ट्रायल में सफलता की प्रायिकता का वर्णन करता है। यह एक ही पैरामीटर p द्वारा वर्णित होता है, जो सफलता की प्रायिकता को दर्शाता है। असफलता की प्रायिकता इसके परिणामस्वरूप 1 - p होती है। गणितीय रूप से, हम बर्नौली डिस्ट्रीब्यूशन को इस प्रकार व्यक्त कर सकते हैं, जिसमें X बर्नौली ट्रायल के परिणाम का प्रतिनिधित्व करने वाला रैंडम वैरिएबल है।
सफलता की अलग-अलग प्रायिकताओं के साथ बर्नौली डिस्ट्रीब्यूशन्स कैसे बदलते हैं, इसे समझने के लिए तीन उदाहरणों की तुलना करें।
p के अलग-अलग मानों के लिए बर्नौली डिस्ट्रीब्यूशन्स की तुलना। चित्र: लेखक द्वारा.
यहां, प्रत्येक ग्राफ एक अलग बर्नौली डिस्ट्रीब्यूशन दिखाता है।
जैसा कि हम देख सकते हैं, बर्नौली डिस्ट्रीब्यूशन का प्रायिकता मास फ़ंक्शन हमेशा दो बार्स वाला होता है: एक असफलता की प्रायिकता (X = 0) के लिए और एक सफलता की प्रायिकता (X = 1) के लिए। इन बार्स की ऊंचाई p के मान के आधार पर बदलती है, लेकिन इनका योग हमेशा 1 होता है।
बर्नौली डिस्ट्रीब्यूशन्स के गुण
आइए उन मुख्य विशेषताओं का अन्वेषण करें जो बर्नौली डिस्ट्रीब्यूशन को परिभाषित करती हैं।
बाइनरी परिणाम
बर्नौली डिस्ट्रीब्यूशन की सबसे विशिष्ट विशेषता इसका बाइनरी स्वभाव है। प्रत्येक ट्रायल का परिणाम केवल दो संभावित परिणामों में से एक हो सकता है:
यह बाइनरी विशेषता बर्नौली डिस्ट्रीब्यूशन्स को विशेष रूप से उपयोगी बनाती है जब हम हां/ना, सत्य/असत्य, या सफलता/असफलता के परिणामों में रुचि रखते हैं। डेटा विज्ञान और मशीन लर्निंग में बर्नौली डिस्ट्रीब्यूशन्स के कुछ प्रमुख लाभ:
मीन और वैरिएंस
बर्नौली डिस्ट्रीब्यूशन का मीन (μ) और वैरिएंस (σ²) सफलता की प्रायिकता p से सीधे संबंधित होते हैं।
मीन
मीन सफलता की प्रायिकता के बराबर होता है। इसका आशय है कि यदि आप बर्नौली ट्रायल को कई बार दोहराते हैं, तो औसत परिणाम p के करीब अभिसरित होगा।
वैरिएंस
वैरिएंस इस प्रकार दी जाती है: σ² = p(1 - p)। वैरिएंस p = 0.5 पर अधिकतम होती है और जैसे-जैसे p 0 या 1 के निकट आता है, घटती जाती है। यह संबंध डेटा के फैलाव और परिणामों से जुड़ी अनिश्चितता के बारे में अंतर्दृष्टि देता है। डेटा फैलाव के संदर्भ में, बर्नौली डिस्ट्रीब्यूशन में वैरिएंस इंगित करती है:
सममिति और विषममिति
बर्नौली डिस्ट्रीब्यूशन का आकार p के मान पर निर्भर करता है:
वितरण की सममिति या विषममिति कई तरीकों से व्याख्या को प्रभावित करती है:
बर्नौली डिस्ट्रीब्यूशन्स के व्यावहारिक उपयोग
बर्नौली डिस्ट्रीब्यूशन्स का विभिन्न क्षेत्रों में व्यापक उपयोग है, विशेष रूप से डेटा विज्ञान और सांख्यिकी में। आइए कुछ सामान्य अनुप्रयोगों को देखें:
मशीन लर्निंग में बाइनरी वर्गीकरण
मशीन लर्निंग में, बर्नौली डिस्ट्रीब्यूशन्स बाइनरी क्लासिफिकेशन समस्याओं में केंद्रीय भूमिका निभाते हैं। ये ऐसे परिदृश्य हैं जहां हमें डेटा को दो में से किसी एक वर्ग में वर्गीकृत करना होता है। उदाहरण शामिल हैं:
बाइनरी वर्गीकरण के लिए बर्नौली डिस्ट्रीब्यूशन्स का लाभ उठाने वाले एल्गोरिदम शामिल हैं: