
Cours
La loi de Bernoulli est un concept fondamental en statistique et en data science. Baptisée d'après le mathématicien suisse Jacob Bernoulli, elle occupe une place centrale en théorie des probabilités et sert de base à des modèles statistiques plus complexes — de la prédiction du comportement client au développement d'algorithmes d'apprentissage automatique.
Pour démarrer, consultez notre cours Introduction to Statistics pour revoir les lois de probabilité. Découvrez également notre cours Foundations of Probability in Python pour étudier des problèmes à deux issues et pratiquer avec la bibliothèque scipy. Notre cours Statistical Thinking in Python (Part 1) est une autre excellente option : vous y apprendrez à écrire vos propres fonctions Python pour réaliser des épreuves de Bernoulli.
Qu'est-ce qu'une loi de Bernoulli ?
Une loi de Bernoulli est une loi de probabilité discrète qui modélise une variable aléatoire à deux issues possibles uniquement. Ces issues sont généralement qualifiées de « succès » et « échec », ou représentées numériquement par 1 et 0.
Épreuves de Bernoulli
Commençons par les épreuves de Bernoulli. Une épreuve de Bernoulli est une expérience aléatoire avec exactement deux issues possibles. Exemples classiques :
- Lancer une pièce (pile ou face)
- Répondre à une question vrai/faux
- Déterminer si un client effectuera un achat (achète ou n'achète pas)
Chaque épreuve de Bernoulli est indépendante, c'est-à-dire que l'issue d'une épreuve n'affecte pas la probabilité de succès des suivantes.
Lois de Bernoulli
Une loi de Bernoulli décrit la probabilité de succès lors d'une épreuve unique de Bernoulli. Elle est caractérisée par un seul paramètre, p, qui représente la probabilité de succès. La probabilité d'échec est donc 1 - p. Mathématiquement, on peut exprimer une loi de Bernoulli comme suit, où X est la variable aléatoire représentant l'issue de l'épreuve.

Pour illustrer comment la loi de Bernoulli varie avec différentes probabilités de succès, comparons trois exemples.
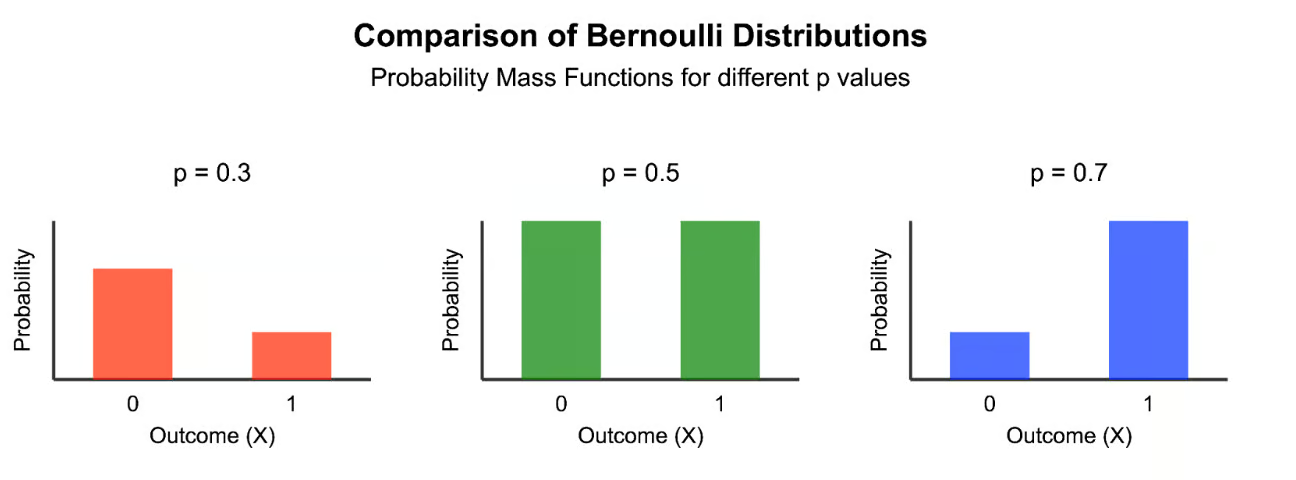
Comparaison de lois de Bernoulli pour différentes valeurs de p. Image par l'auteur.
Ici, chaque graphique montre une loi de Bernoulli différente.
- À gauche : p = 0,3 (30 % de chances de succès)
- Au centre : p = 0,5 (50 % de chances de succès)
- À droite : p = 0,7 (70 % de chances de succès)
Comme on le voit, la fonction de masse de probabilité d'une loi de Bernoulli comporte toujours deux barres : une pour la probabilité d'échec (X = 0) et une pour la probabilité de succès (X = 1). La hauteur de ces barres varie selon la valeur de p, mais leur somme vaut toujours 1.
Propriétés des lois de Bernoulli
Explorons les caractéristiques clés qui définissent la loi de Bernoulli.
Issues binaires
La particularité la plus marquante d'une loi de Bernoulli est sa nature binaire. Chaque épreuve ne peut aboutir qu'à l'une de deux issues :
- Succès (généralement noté 1)
- Échec (généralement noté 0)
Cette propriété binaire rend les lois de Bernoulli particulièrement utiles lorsque l'on s'intéresse à des issues oui/non, vrai/faux ou succès/échec. Voici quelques avantages clés de leur utilisation en data science et en apprentissage automatique :
- Modélisation simple : des issues binaires permettent de modéliser simplement probabilités et cotes.
- Facilité d'interprétation : les résultats s'interprètent aisément en probabilités ou en proportions.
- Polyvalence : de nombreux scénarios complexes se décomposent en une suite de décisions ou d'issues binaires.
- Base de lois plus complexes : les épreuves de Bernoulli fondent d'autres lois majeures, comme la loi binomiale (qui compte les succès sur plusieurs épreuves) ou la loi géométrique (qui mesure le nombre d'épreuves jusqu'au premier succès).
Moyenne et variance
La moyenne (μ) et la variance (σ²) d'une loi de Bernoulli sont directement liées à la probabilité de succès, p.
Moyenne
La moyenne est égale à la probabilité de succès. Autrement dit, si vous répétez une épreuve de Bernoulli un grand nombre de fois, la moyenne des issues converge vers p.
Variance
La variance est donnée par : σ² = p(1 - p). Elle est maximale lorsque p = 0,5 et diminue à mesure que p se rapproche de 0 ou de 1. Cette relation éclaire la dispersion des données et l'incertitude associée aux issues. En termes de dispersion, la variance dans une loi de Bernoulli signifie :
- Prévisibilité : une faible variance (quand p est proche de 0 ou 1) indique des issues plus prévisibles, tandis qu'une variance élevée (quand p est proche de 0,5) suggère plus d'incertitude.
- Contenu informationnel : plus p est proche de 0,5, plus chaque épreuve apporte d'information, car les issues sont moins prévisibles.
- Considérations d'échantillonnage : la variance guide les décisions de taille d'échantillon en plan d'expériences. Une variance plus élevée nécessite souvent des échantillons plus grands pour une précision équivalente.
- Évaluation du risque : en finance ou en assurance, la variance peut se lire comme une mesure de risque ou de volatilité.
Symétrie et asymétrie
La forme d'une loi de Bernoulli dépend de la valeur de p :
- Quand p = 0,5, la distribution est symétrique. Exemple : une pièce équilibrée, où les probabilités de succès et d'échec sont égales.
- Quand p ≠ 0,5, la distribution devient asymétrique. Plus p tend vers 0 ou 1, plus l'asymétrie augmente.
Cette symétrie ou asymétrie influence l'interprétation de plusieurs manières :
- Fixation des attentes : dans une distribution symétrique, aucune issue n'est plus probable, ce qui éclaire la décision lorsqu'aucun biais n'existe, par exemple dans un jeu équitable.
- Détection de biais : une asymétrie observée là où l'on attend de la symétrie peut révéler un biais de procédé ou de mesure.
- Choix de seuils : en classification, la symétrie ou l'asymétrie peut guider le choix des seuils de décision.
- Sélection de modèles : le degré d'asymétrie peut influencer le choix des modèles statistiques ou des algorithmes d'apprentissage.
- Stratégies d'échantillonnage : dans les cas très asymétriques (p très proche de 0 ou 1), des techniques d'échantillonnage spécifiques peuvent être nécessaires pour bien représenter les événements rares.
Applications pratiques des lois de Bernoulli
Les lois de Bernoulli sont largement utilisées, notamment en data science et en statistique. Voici quelques applications courantes :
Classification binaire en apprentissage automatique
En apprentissage automatique, les lois de Bernoulli jouent un rôle central dans les problèmes de classification binaire, où il faut attribuer chaque observation à l'une de deux classes. Exemples :
- Détection de spam dans les e-mails (spam ou non spam)
- Détection de fraude dans les transactions financières (frauduleuse ou légitime)
- Diagnostic de maladie à partir de symptômes (présente ou absente)
Des algorithmes qui s'appuient sur des lois de Bernoulli pour la classification binaire incluent :
- Régression logistique : la régression logistique suppose que l'issue binaire suit une loi de Bernoulli. Elle modélise la probabilité de l'issue via la fonction logit, inverse de la fonction logistique. La sortie s'interprète comme une probabilité de Bernoulli. Lisez nos tutoriels Understanding Logistic Regression in Python et Logistic Regression in R pour en connaître les détails.
- Bernoulli Naive Bayes : ce classifieur, basé sur l'algorithme Naive Bayes, convient particulièrement à la classification de documents avec des caractéristiques binaires (présence ou absence d'un mot).
Devenez un scientifique ML
Tests d'hypothèses
Les lois de Bernoulli sont essentielles dans les tests d'hypothèses, en particulier lorsqu'il s'agit de proportions ou de taux de succès. Applications fréquentes :
- A/B testing en marketing : comparer les taux de succès de deux stratégies marketing. Approfondissez l'A/B testing avec notre cours Customer Analytics and A/B Testing in Python et notre code-along A/B Testing in R.
- Contrôle qualité : tester si le taux de défauts d'un processus de fabrication dépasse un certain seuil.
- Essais médicaux : évaluer l'efficacité d'un nouveau traitement par rapport à un placebo.
Dans ces contextes, l'hypothèse nulle pose souvent une valeur précise pour la probabilité de succès p, et l'hypothèse alternative remet en cause cette valeur au vu des données observées.
Simulation et modélisation
Les lois de Bernoulli sont très utiles en simulation et en modélisation probabiliste, surtout pour des issues binaires. Elles servent notamment à :
- Simulations de Monte Carlo : modéliser des systèmes complexes comportant de nombreux points de décision binaires. Voir notre tutoriel Introduction to Monte Carlo Methods.
- Analyse de risque : évaluer la probabilité de succès ou d'échec dans des scénarios business.
- Génétique des populations : modéliser l'hérédité de caractères dans des études génétiques.
En générant des échantillons aléatoires suivant une loi de Bernoulli, chercheurs et data scientists peuvent simuler de manière réaliste des systèmes et processus complexes.
Points de performance à considérer
Lorsque vous travaillez avec des lois de Bernoulli en analyse de données et en apprentissage automatique, gardez à l'esprit plusieurs aspects de performance :
Gérer des données déséquilibrées
Dans de nombreux cas réels, la probabilité de succès p n'est pas 0,5, ce qui entraîne des jeux de données déséquilibrés. Cet équilibre rompu peut poser des défis aux algorithmes, en les biaisant vers la classe majoritaire. Parmi les stratégies pour y remédier :
- Suréchantillonnage de la classe minoritaire : utiliser des techniques comme SMOTE (Synthetic Minority Oversampling Technique) pour générer des exemples synthétiques.
- Sous-échantillonnage de la classe majoritaire : retirer aléatoirement des instances de la classe majoritaire pour rééquilibrer.
- Ajustement des pondérations de classes : accorder plus d'importance à la classe minoritaire lors de l'entraînement.
- Méthodes d'ensemble : des techniques comme les Random Forests ou le Gradient Boosting gèrent souvent mieux le déséquilibre que des modèles uniques. Lisez notre tutoriel What is Boosting pour tout savoir sur le boosting et les méthodes d'ensemble.
- Choisir des métriques adaptées : l'accuracy seule peut être trompeuse sur des données déséquilibrées. Privilégiez F1-score, précision, rappel ou l'aire sous la courbe ROC.
Efficacité computationnelle
Les lois de Bernoulli sont efficaces à calculer, notamment sur de grands jeux de données en classification binaire. Quelques points d'attention toutefois :
- Vectorisation : implémentez des opérations vectorisées (par ex., NumPy en Python) pour de meilleures performances.
- Parcimonie : en classification de textes avec Bernoulli Naive Bayes, exploitez des matrices creuses pour réduire fortement la mémoire et le temps de calcul.
- Compromis complexité/performance : des modèles plus complexes peuvent offrir un léger gain, mais le coût de calcul ne le justifie pas toujours. Évaluez l'équilibre entre précision et temps de traitement.
Idées reçues fréquentes
Pour bien maîtriser les lois de Bernoulli, levons quelques idées reçues :
Mauvaise interprétation de la probabilité de succès
Une confusion répandue consiste à supposer que la probabilité de succès p vaut toujours 0,5. En réalité, p peut prendre toute valeur entre 0 et 1, bornes comprises. Sa valeur dépend du scénario ou du processus modélisé.
Par exemple :
- Pour une pièce équilibrée, p = 0,5.
- Pour un dé pipé où obtenir un 6 est un succès, p peut être 1/4.
- Dans un contrôle qualité avec 1 % de défauts, p vaut 0,01 pour l'issue « défaut ».
Estimer correctement p à partir des données est crucial pour une inférence et une modélisation pertinentes. Cela implique souvent de collecter un échantillon représentatif et de calculer la proportion de succès.
Bernoulli vs. loi binomiale
On confond parfois la loi de Bernoulli avec la loi binomiale. Elles sont liées mais distinctes :
- Une loi de Bernoulli modélise une épreuve unique à deux issues.
- Une loi binomiale modélise le nombre de succès sur un nombre fixe d'épreuves de Bernoulli indépendantes.
Autrement dit, une loi binomiale est la somme de plusieurs lois de Bernoulli indépendantes. Par exemple, si vous lancez une pièce 10 fois et comptez le nombre de faces, vous avez une loi binomiale. Chaque lancer individuel suit en revanche une loi de Bernoulli. Comparons-les visuellement :
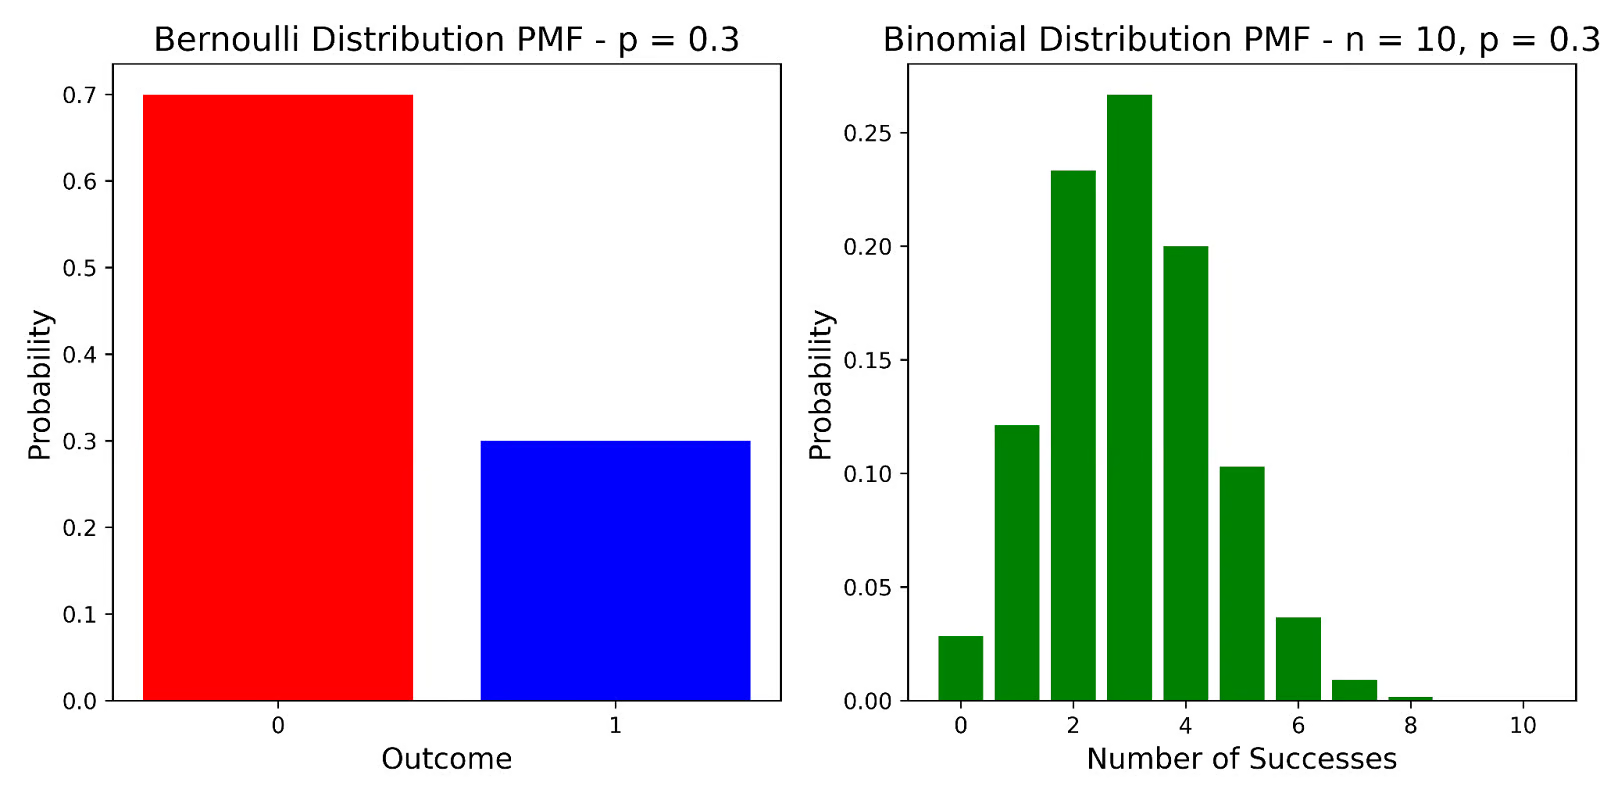
Loi de Bernoulli versus loi binomiale. Image par l'auteur.
Cette comparaison met clairement en évidence la différence fondamentale entre ces deux lois :
- La loi de Bernoulli (à gauche) représente une épreuve unique avec seulement deux issues possibles : 0 (échec) ou 1 (succès). Dans cet exemple, avec p = 0,3, on observe 70 % d'échec et 30 % de succès.
- La loi binomiale (à droite) représente le nombre de succès sur plusieurs épreuves (ici, 10). Elle donne la probabilité d'obtenir chaque nombre possible de succès, de 0 à 10. La forme de cette distribution dépend à la fois de n (le nombre d'épreuves) et de p (la probabilité de succès à chaque épreuve).
Alors qu'une loi de Bernoulli a toujours exactement deux issues possibles, une loi binomiale peut en avoir n+1, où n est le nombre d'épreuves.
Alternatives à la loi de Bernoulli
Bien que les lois de Bernoulli soient très répandues, certains cas appellent des lois alternatives plus adaptées. Voici deux alternatives courantes :
Loi binomiale
La loi binomiale convient lorsque vous traitez plusieurs épreuves plutôt qu'un seul événement. On l'utilise lorsque l'intérêt porte sur le nombre de succès au fil de plusieurs tentatives, plutôt que sur une issue unique.
Loi géométrique
La loi géométrique intervient lorsque l'on s'intéresse au nombre de tentatives nécessaires jusqu'au premier succès. Elle s'applique souvent lorsque l'attention se porte sur le temps d'attente ou le nombre d'essais avant réussite.
Conclusion
Les lois de Bernoulli sont le socle de nombreux concepts statistiques et des composants essentiels en data science. Leur simplicité binaire, alliée à des applications étendues en apprentissage automatique, en tests d'hypothèses et en simulation, en fait un cadre clé pour analyser et modéliser des issues binaires.
À retenir :
- Les lois de Bernoulli modélisent des épreuves uniques à deux issues.
- La probabilité de succès p est le paramètre clé qui définit la distribution.
- Elles s'appliquent largement à la classification binaire, aux tests d'hypothèses et aux simulations.
- Comprendre leurs propriétés et les idées reçues permet de mieux les utiliser.
- Selon les cas, des alternatives comme les lois binomiale et géométrique sont plus appropriées.
Si vous souhaitez mettre ces notions en pratique dans des environnements de programmation, nos cours Introduction to Statistics in Python et Introduction to Statistics in R offrent des expériences d'apprentissage concrètes. Et pour aller plus loin, le cours Mixture Models in R approfondit ces fondements pour explorer des techniques de modélisation statistique plus avancées. Enfin, découvrez notre parcours Machine Learning in Production in Python pour porter vos compétences en machine learning jusqu'à la mise en production et déployer des modèles avancés.
Renforcer les compétences en matière d'apprentissage automatique
Vinod Chugani a débuté sa carrière à Tokyo comme plus jeune responsable du desk ventes hedge funds de JPMorgan, puis a signé un record de ventes individuel chez Lehman Brothers, avant de développer une activité de distribution d’électronique présente dans 30 pays, dépassant les 100 millions SG$ de chiffre d’affaires, puis de se tourner vers la data. Diplômé en économie de Duke et ancien élève de la NYC Data Science Academy, il a fait partie des trois lauréats de bourse sur plus de 100 candidatures pour le cours Building AI Applications de Hugo Bowne-Anderson sur Maven. Aujourd’hui, il écrit pour DataCamp, KDnuggets, Machine Learning Mastery et Statology, sur des sujets allant des statistiques à l’IA agentique, et accompagne des professionnels de la data à la NYC Data Science Academy, avec plus de 1 000 séances individuelles à son actif.
Questions fréquentes
Qu'est-ce qu'une loi de Bernoulli ?
Une loi de Bernoulli est une loi de probabilité discrète pour une variable aléatoire qui n'a que deux issues possibles : succès (généralement noté 1) ou échec (généralement noté 0). Elle est caractérisée par un seul paramètre p, qui représente la probabilité de succès.
Quelle est la différence entre une loi de Bernoulli et une loi binomiale ?
Une loi de Bernoulli modélise une épreuve unique à deux issues, tandis qu'une loi binomiale modélise le nombre de succès sur un nombre fixe d'épreuves de Bernoulli indépendantes. On peut voir la loi binomiale comme la somme de plusieurs lois de Bernoulli.
Peut-on utiliser les lois de Bernoulli pour des tests d'hypothèses ?
Oui, les lois de Bernoulli sont couramment utilisées dans les tests d'hypothèses, en particulier pour des scénarios impliquant des proportions ou des taux de succès. Elles sont très utiles en A/B testing, où l'on compare les taux de succès de deux stratégies ou traitements.
Quel est le lien entre lois de Bernoulli, cotes et log-cotes ?
Les cotes (odds) de succès dans une épreuve de Bernoulli sont p/(1-p), où p est la probabilité de succès. Le log-odds, ou fonction logit, est le logarithme naturel des cotes. Ces notions sont couramment utilisées en régression logistique et dans d'autres analyses statistiques.
Comment estimer le paramètre p d'une loi de Bernoulli à partir de données ?
La méthode la plus courante pour estimer p est le maximum de vraisemblance (MLE). Pour une loi de Bernoulli, l'estimateur du MLE de p est simplement la proportion de succès dans votre échantillon. Par exemple, si vous observez 7 succès sur 10 épreuves, votre estimation de p est 0,7.
