
Lewati ke konten utama

Distribusi Bernoulli: Panduan Lengkap dengan Contoh

Pelajari bagaimana distribusi Bernoulli menangkap hasil biner dan diterapkan dari lempar koin hingga prediksi pelanggan.
Diperbarui 28 Sep 2026  · 11 mnt Baca

Jelajahi bersama AI

ChatGPTClaudePerplexity

Distribusi Bernoulli adalah konsep fundamental dalam statistika dan data science. Dinamai dari matematikawan Swiss Jacob Bernoulli, distribusi ini penting dalam teori probabilitas dan menjadi landasan bagi model statistik yang lebih kompleks—mulai dari memprediksi perilaku pelanggan hingga mengembangkan algoritma machine learning.

Saat memulai, pertimbangkan kursus Introduction to Statistics kami untuk penyegaran tentang distribusi probabilitas. Selain itu, lihat juga kursus Foundations of Probability in Python untuk mempelajari masalah dengan dua kemungkinan hasil dan berlatih dengan pustaka scipy. Kursus Statistical Thinking in Python (Part 1) juga merupakan opsi yang sangat baik karena akan mengajarkan Anda menulis fungsi Python sendiri untuk melakukan uji Bernoulli.  

Apa itu Distribusi Bernoulli?

Distribusi Bernoulli adalah distribusi probabilitas diskrit yang memodelkan variabel acak dengan hanya dua kemungkinan hasil. Hasil ini biasanya dilabeli sebagai "sukses" dan "gagal," atau direpresentasikan secara numerik sebagai 1 dan 0.

Uji Bernoulli

Mari mulai dengan uji Bernoulli. Uji Bernoulli adalah percobaan acak dengan tepat dua kemungkinan hasil. Contoh klasik meliputi:

  • Melempar koin (angka atau gambar)
  • Menjawab pertanyaan benar/salah
  • Menentukan apakah pelanggan akan melakukan pembelian (beli atau tidak beli)

Setiap uji Bernoulli bersifat independen, artinya hasil satu uji tidak memengaruhi probabilitas sukses pada uji berikutnya.

Distribusi Bernoulli

Distribusi Bernoulli menggambarkan probabilitas sukses dalam satu uji Bernoulli. Distribusi ini dicirikan oleh satu parameter, p, yang merepresentasikan probabilitas sukses. Probabilitas gagal karenanya adalah 1 - p. Secara matematis, kita dapat mengekspresikan distribusi Bernoulli sebagai berikut, di mana X adalah variabel acak yang merepresentasikan hasil uji Bernoulli.

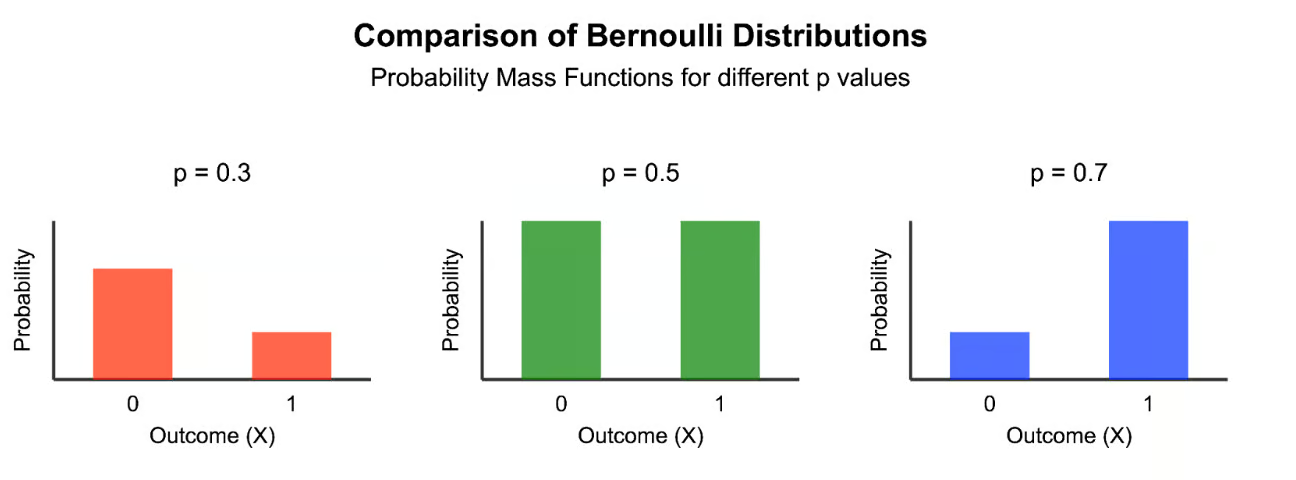
Untuk mengilustrasikan bagaimana distribusi Bernoulli berubah dengan probabilitas sukses yang berbeda, mari bandingkan tiga contoh.
Comparison of Bernoulli distributions for different values of p

Perbandingan distribusi Bernoulli untuk nilai p yang berbeda. Gambar oleh Penulis. 

Di sini, setiap grafik menunjukkan distribusi Bernoulli yang berbeda. 

  • Kiri: p = 0,3 (peluang sukses 30%)
  • Tengah: p = 0,5 (peluang sukses 50%)
  • Kanan: p = 0,7 (peluang sukses 70%)

Seperti yang terlihat, fungsi massa probabilitas dari distribusi Bernoulli selalu memiliki dua batang: satu untuk probabilitas gagal (X = 0) dan satu untuk probabilitas sukses (X = 1). Tinggi batang-batang ini berubah berdasarkan nilai p, tetapi jumlahnya selalu 1.

Sifat-Sifat Distribusi Bernoulli

Mari telusuri karakteristik kunci yang mendefinisikan distribusi Bernoulli.

Hasil biner

Ciri paling khas dari distribusi Bernoulli adalah sifat binernya. Setiap uji hanya dapat menghasilkan satu dari dua kemungkinan hasil:

  1. Sukses (biasanya dinyatakan sebagai 1)
  2. Gagal (biasanya dinyatakan sebagai 0)

Sifat biner ini membuat distribusi Bernoulli sangat berguna saat kita tertarik pada hasil ya/tidak, benar/salah, atau sukses/gagal. Berikut beberapa keunggulan kunci menggunakan distribusi Bernoulli dalam data science dan machine learning:

  • Sederhana dalam Pemodelan: Hasil biner memungkinkan pemodelan probabilitas dan odds yang lugas.
  • Mudah Diinterpretasikan: Hasil sering kali mudah diinterpretasikan sebagai probabilitas atau proporsi.
  • Fleksibel: Banyak skenario kompleks dapat diuraikan menjadi serangkaian keputusan atau hasil biner.
  • Landasan bagi Distribusi yang Lebih Kompleks: Uji Bernoulli menjadi basis bagi distribusi penting lain, seperti distribusi binomial yang menghitung jumlah sukses di banyak uji Bernoulli, dan distribusi geometrik yang melacak jumlah uji Bernoulli hingga sukses pertama.

Rata-rata dan varians

Rata-rata (μ) dan varians (σ²) dari distribusi Bernoulli berhubungan langsung dengan probabilitas sukses, p.

Rata-rata

Rata-rata sama dengan probabilitas sukses. Ini menyiratkan bahwa jika Anda mengulangi uji Bernoulli berkali-kali, hasil rata-ratanya akan konvergen ke p.

Varians

Varians diberikan oleh: σ² = p(1 - p). Varians mencapai maksimum saat p = 0,5 dan menurun ketika p mendekati 0 atau 1. Hubungan ini memberikan wawasan tentang sebaran data dan ketidakpastian yang terkait dengan hasil. Dalam hal sebaran data, varians pada distribusi Bernoulli menandakan:

  • Prediktabilitas: Varians rendah (ketika p mendekati 0 atau 1) menunjukkan hasil yang lebih dapat diprediksi, sedangkan varians tinggi (ketika p mendekati 0,5) menunjukkan lebih banyak ketidakpastian.
  • Kandungan Informasi: Semakin dekat p ke 0,5, semakin banyak informasi yang diberikan setiap uji, karena hasilnya kurang dapat diprediksi.
  • Pertimbangan Sampling: Varians memengaruhi keputusan ukuran sampel dalam desain eksperimen. Varians yang lebih tinggi biasanya memerlukan ukuran sampel yang lebih besar untuk mencapai tingkat presisi estimasi yang sama.
  • Penilaian Risiko: Dalam aplikasi seperti keuangan atau asuransi, varians dapat diinterpretasikan sebagai ukuran risiko atau volatilitas.

Simetri dan asimetri

Bentuk distribusi Bernoulli bergantung pada nilai p:

  • Ketika p = 0,5, distribusi bersifat simetris. Salah satu contohnya adalah lempar koin adil, di mana probabilitas sukses dan gagal sama.
  • Ketika p ≠ 0,5, distribusi menjadi asimetris. Saat p mendekati 0 atau 1, tingkat asimetri meningkat.

Simetri atau asimetri distribusi memengaruhi interpretasi dalam beberapa cara:

  • Penetapan Ekspektasi: Dalam distribusi simetris, tidak ada hasil yang lebih mungkin, yang dapat menginformasikan proses pengambilan keputusan tanpa bias terhadap salah satu hasil, seperti dalam permainan yang adil.
  • Deteksi Bias: Asimetri pada hasil yang diamati ketika diharapkan simetri dapat menunjukkan adanya bias dalam proses atau pengukuran.
  • Penentuan Ambang: Dalam tugas klasifikasi, simetri atau asimetri distribusi dapat memengaruhi pemilihan ambang klasifikasi.
  • Pemilihan Model: Derajat asimetri dapat memengaruhi pilihan model statistik atau algoritma machine learning.
  • Strategi Sampling: Dalam kasus yang sangat asimetris (p sangat dekat dengan 0 atau 1), teknik sampling khusus mungkin diperlukan untuk memastikan kejadian langka terwakili dengan baik dalam data.

Aplikasi Praktis Distribusi Bernoulli

Distribusi Bernoulli banyak digunakan di berbagai bidang, khususnya dalam data science dan statistika. Mari telusuri beberapa aplikasi paling umum:

Klasifikasi biner dalam machine learning

Dalam machine learning, distribusi Bernoulli berperan sentral dalam masalah klasifikasi biner. Ini adalah skenario di mana kita perlu mengkategorikan data ke salah satu dari dua kelas. Contohnya meliputi:

  • Deteksi spam pada email (spam atau bukan spam)
  • Deteksi penipuan pada transaksi keuangan (penipuan atau sah)
  • Diagnosis penyakit berdasarkan gejala (ada atau tidak ada)

Algoritma yang memanfaatkan distribusi Bernoulli untuk klasifikasi biner meliputi:

  1. Regresi Logistik: Regresi logistik mengasumsikan bahwa hasil biner mengikuti distribusi Bernoulli. Algoritma ini memodelkan probabilitas hasil menggunakan fungsi logit, yang merupakan kebalikan dari fungsi logistik. Keluaran yang dihasilkan dapat diinterpretasikan sebagai probabilitas Bernoulli. Baca tutorial Understanding Logistic Regression in Python dan Logistic Regression in R kami untuk mempelajari detailnya.
  2. Bernoulli Naive Bayes: Klasifikator ini berbasis algoritma Naive Bayes dan sangat cocok untuk tugas klasifikasi dokumen ketika fitur bersifat biner (keberadaan atau ketiadaan kata).

Pengujian hipotesis

Distribusi Bernoulli bersifat fundamental dalam pengujian hipotesis, khususnya saat berurusan dengan proporsi atau tingkat keberhasilan. Aplikasi umum meliputi:

  • A/B testing dalam Pemasaran: Membandingkan tingkat keberhasilan dari dua strategi pemasaran yang berbeda. Pelajari lebih lanjut tentang A/B testing dengan kursus Customer Analytics and A/B Testing in Python kami dan juga code-along A/B Testing in R.
  • Pengendalian Kualitas: Menguji apakah tingkat cacat dalam proses manufaktur melampaui ambang tertentu.
  • Uji klinis: Menilai kemanjuran pengobatan baru dibandingkan plasebo.

Dalam skenario ini, hipotesis nol sering kali mengasumsikan nilai tertentu untuk probabilitas sukses p, dan hipotesis alternatif menantang asumsi ini berdasarkan data yang diamati.

Simulasi dan pemodelan

Distribusi Bernoulli berguna dalam simulasi dan pemodelan probabilistik, terutama untuk skenario dengan hasil biner. Distribusi ini digunakan dalam:

  • Simulasi Monte Carlo: Memodelkan sistem kompleks dengan banyak titik keputusan biner. Pelajari lebih lanjut dengan tutorial Introduction to Monte Carlo Methods kami.
  • Analisis Risiko: Menilai probabilitas sukses atau gagal dalam skenario bisnis.
  • Genetika Populasi: Memodelkan pewarisan sifat dalam studi genetik.

Dengan menghasilkan sampel acak dari distribusi Bernoulli, peneliti dan data scientist dapat membuat simulasi realistis atas sistem dan proses yang kompleks.

Pertimbangan Kinerja

Saat bekerja dengan distribusi Bernoulli dalam analisis data dan machine learning, ada beberapa pertimbangan kinerja yang perlu diingat:

Menangani data yang tidak seimbang

Dalam banyak skenario dunia nyata, probabilitas sukses p dalam distribusi Bernoulli bukan 0,5, sehingga menghasilkan dataset yang tidak seimbang. Ketidakseimbangan ini dapat menimbulkan tantangan bagi algoritma machine learning, yang berpotensi memihak pada kelas mayoritas. Strategi untuk mengatasinya meliputi:

  1. Oversampling Kelas Minoritas: Teknik seperti SMOTE (Synthetic Minority Oversampling Technique) dapat digunakan untuk menghasilkan sampel sintetis dari kelas minoritas.
  2. Undersampling Kelas Mayoritas: Menghapus secara acak instance dari kelas mayoritas untuk menyeimbangkan dataset.
  3. Menyesuaikan Bobot Kelas: Memberikan bobot lebih besar pada kelas minoritas selama pelatihan model.
  4. Menggunakan Metode Ensemble: Teknik seperti Random Forest atau Gradient Boosting sering kali dapat menangani data tidak seimbang lebih baik daripada model tunggal. Baca tutorial What is Boosting kami untuk mempelajari semua tentang boosting dan metode ensemble secara umum.
  5. Memilih Metrik Evaluasi yang Tepat: Akurasi saja dapat menyesatkan untuk dataset tidak seimbang. Pertimbangkan metrik seperti F1-score, precision, recall, atau area di bawah kurva ROC.

Efisiensi komputasi

Distribusi Bernoulli efisien secara komputasi, terutama untuk dataset besar dalam tugas klasifikasi biner. Namun, tetap ada beberapa hal yang perlu diperhatikan:

  1. Vektorisasi: Saat mengimplementasikan algoritma berbasis Bernoulli, gunakan operasi tervektor (misalnya, NumPy di Python) untuk peningkatan kinerja.
  2. Kerapatan Rendah (Sparsity): Dalam tugas klasifikasi teks menggunakan klasifikator Bernoulli Naive Bayes, memanfaatkan representasi matriks jarang dapat secara signifikan mengurangi penggunaan memori dan waktu komputasi.
  3. Pertukaran Kompleksitas Model: Meskipun model yang lebih kompleks mungkin menawarkan kinerja sedikit lebih baik, biaya komputasinya tidak selalu sebanding dengan peningkatan marjinal tersebut. Pertimbangkan keseimbangan antara akurasi model dan waktu pemrosesan.

Kesalahpahaman Umum

Untuk benar-benar memahami distribusi Bernoulli, penting untuk membahas beberapa kesalahpahaman umum:

Salah menafsirkan probabilitas sukses

Salah satu kesalahpahaman yang sering terjadi adalah mengasumsikan bahwa probabilitas sukses p dalam distribusi Bernoulli selalu 0,5. Pada kenyataannya, p dapat bernilai apa pun antara 0 dan 1, inklusif. Nilai p bergantung pada skenario atau proses spesifik yang dimodelkan.

Sebagai contoh:

  • Pada lempar koin adil, p = 0,5.
  • Pada dadu tidak adil di mana mendapatkan angka 6 dianggap sukses, p bisa 1/4.
  • Dalam proses pengendalian kualitas dengan tingkat cacat 1%, p akan 0,01 untuk hasil "cacat".

Mengestimasi p secara akurat dari data sangat penting untuk inferensi statistik dan pemodelan yang tepat. Ini sering melibatkan pengumpulan sampel yang representatif dan menghitung proporsi sukses.

Distribusi Bernoulli vs. binomial

Distribusi Bernoulli kadang-kadang disamakan dengan distribusi Binomial. Meskipun terkait, keduanya berbeda:

  • Distribusi Bernoulli memodelkan satu uji dengan dua kemungkinan hasil.
  • Distribusi binomial memodelkan jumlah sukses dalam sejumlah uji Bernoulli independen yang tetap.

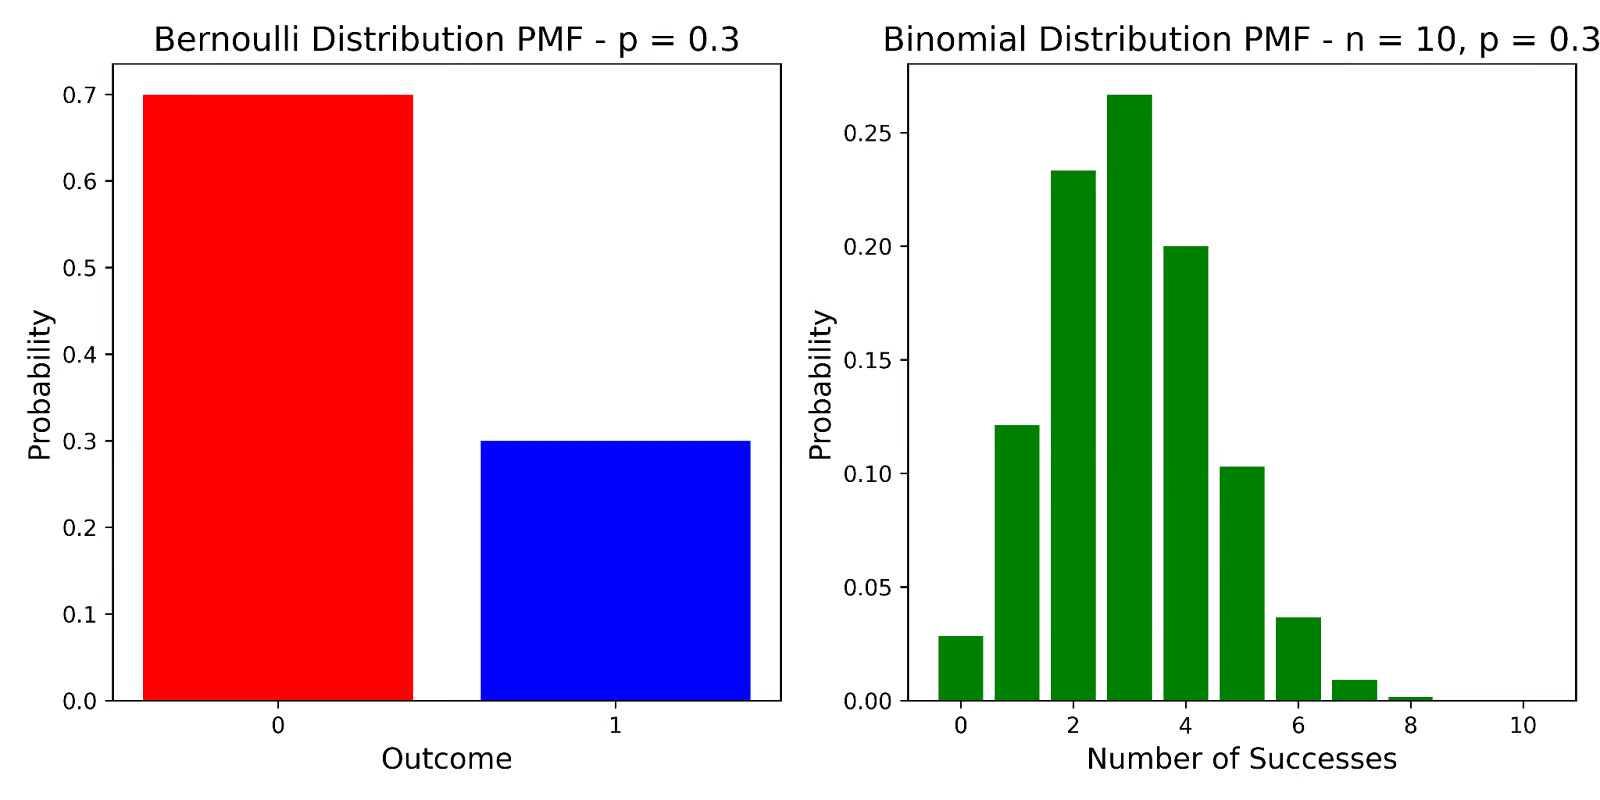
Dengan kata lain, distribusi binomial adalah penjumlahan dari beberapa distribusi Bernoulli independen. Misalnya, jika Anda melempar koin 10 kali dan menghitung jumlah gambar, itu adalah distribusi binomial. Namun, setiap lemparan individu mengikuti distribusi Bernoulli. Mari bandingkan secara visual:
Bernoulli distribution versus binomial distribution

Distribusi Bernoulli versus distribusi binomial. Gambar oleh Penulis.

Perbandingan ini dengan jelas menunjukkan perbedaan mendasar antara kedua distribusi ini:

  • Distribusi Bernoulli (kiri) merepresentasikan satu uji dengan hanya dua kemungkinan hasil: 0 (gagal) atau 1 (sukses). Dalam contoh ini, dengan p = 0,3, kita melihat peluang gagal 70% dan peluang sukses 30%.
  • Distribusi binomial (kanan) merepresentasikan jumlah sukses dalam beberapa uji (dalam hal ini, 10 uji). Distribusi ini menunjukkan probabilitas untuk mendapatkan setiap kemungkinan jumlah sukses, dari 0 hingga 10. Bentuk distribusi ini ditentukan oleh n (jumlah uji) dan p (probabilitas sukses di setiap uji).

Sementara distribusi Bernoulli selalu memiliki tepat dua kemungkinan hasil, distribusi binomial dapat memiliki n+1 kemungkinan hasil, di mana n adalah jumlah uji.

Alternatif untuk Distribusi Bernoulli

Meskipun distribusi Bernoulli banyak digunakan, ada skenario di mana distribusi alternatif mungkin lebih sesuai. Mari telusuri dua alternatif umum:

Distribusi binomial

Distribusi binomial berguna saat Anda berhadapan dengan beberapa uji alih-alih satu kejadian. Alternatif ini sering dipertimbangkan ketika Anda tertarik pada jumlah sukses di beberapa percobaan, bukan hanya satu hasil.

Distribusi geometrik

Distribusi geometrik digunakan ketika Anda tertarik pada berapa banyak percobaan yang diperlukan untuk mencapai sukses pertama. Distribusi ini sering diterapkan pada situasi di mana fokusnya adalah waktu tunggu atau jumlah percobaan sebelum sukses terjadi.

Kesimpulan

Distribusi Bernoulli membentuk fondasi banyak konsep statistik dan merupakan komponen esensial dalam data science. Sifat binernya yang sederhana, dipadukan dengan beragam aplikasi dalam machine learning, pengujian hipotesis, dan simulasi, menjadikannya kerangka utama untuk menganalisis dan memodelkan hasil biner.

Berikut poin-poin pentingnya:

  1. Distribusi Bernoulli memodelkan satu uji dengan dua kemungkinan hasil.
  2. Probabilitas sukses p adalah parameter kunci yang mendefinisikan distribusi.
  3. Distribusi ini memiliki banyak aplikasi dalam klasifikasi biner, pengujian hipotesis, dan simulasi.
  4. Memahami sifat-sifatnya dan kesalahpahaman umum bermanfaat untuk penerapan yang efektif.
  5. Meskipun kuat, alternatif seperti distribusi binomial dan geometrik mungkin lebih sesuai dalam skenario tertentu.

Jika Anda tertarik menerapkan konsep ini dalam lingkungan pemrograman tertentu, kursus Introduction to Statistics in Python dan Introduction to Statistics in R kami menawarkan pengalaman belajar praktis dan langsung. Dan jika Anda siap mempelajari topik yang lebih lanjut, kursus Mixture Models in R membangun konsep dasar ini untuk mengeksplorasi teknik pemodelan statistik yang lebih kompleks. Terakhir, lihat jalur keterampilan Machine Learning in Production in Python kami untuk membawa keterampilan machine learning Anda ke tingkat produksi dan mulai menerapkan model lanjutan. 


Vinod Chugani's photo
Author
Vinod Chugani
LinkedIn

Vinod Chugani memulai kariernya di Tokyo sebagai Kepala Meja Penjualan Hedge Fund termuda di JPMorgan dan kemudian mencetak rekor penjualan individu di Lehman Brothers, lalu membangun bisnis distribusi elektronik di 30 negara dengan pendapatan melampaui SG$100 juta sebelum beralih ke data. Lulusan Ekonomi Duke dan alumni NYC Data Science Academy, ia menjadi salah satu dari tiga penerima beasiswa dari lebih dari 100 pelamar untuk kursus Building AI Applications oleh Hugo Bowne-Anderson di Maven. Saat ini, ia menulis untuk DataCamp, KDnuggets, Machine Learning Mastery, dan Statology tentang topik mulai dari statistika hingga AI agensial, dan membimbing para profesional data di NYC Data Science Academy dengan lebih dari 1.000 sesi tatap muka atas namanya.


Frequently Asked Questions

Apa itu distribusi Bernoulli?

Distribusi Bernoulli adalah distribusi probabilitas diskrit untuk variabel acak yang hanya memiliki dua kemungkinan hasil: sukses (biasanya dinyatakan sebagai 1) atau gagal (biasanya dinyatakan sebagai 0). Distribusi ini dicirikan oleh satu parameter p, yang merepresentasikan probabilitas sukses.

Apa perbedaan antara distribusi Bernoulli dan Binomial?

Distribusi Bernoulli memodelkan satu uji dengan dua kemungkinan hasil, sedangkan distribusi Binomial memodelkan jumlah sukses dalam sejumlah uji Bernoulli independen yang tetap. Anda dapat menganggap distribusi Binomial sebagai penjumlahan dari beberapa distribusi Bernoulli.

Apakah distribusi Bernoulli dapat digunakan untuk pengujian hipotesis?

Ya, distribusi Bernoulli umum digunakan dalam pengujian hipotesis, terutama untuk skenario yang melibatkan proporsi atau tingkat keberhasilan. Distribusi ini sangat berguna dalam A/B testing, di mana Anda membandingkan tingkat keberhasilan dari dua strategi atau perlakuan yang berbeda.

Bagaimana hubungan distribusi Bernoulli dengan odds dan log-odds?

Odds keberhasilan dalam uji Bernoulli adalah p/(1-p), di mana p adalah probabilitas sukses. Log-odds, juga dikenal sebagai fungsi logit, adalah logaritma natural dari odds. Konsep-konsep ini umum digunakan dalam regresi logistik dan analisis statistik lainnya.

Bagaimana saya dapat mengestimasi parameter p dari distribusi Bernoulli menggunakan data?

Metode paling umum untuk mengestimasi p adalah maximum likelihood estimation (MLE). Untuk distribusi Bernoulli, MLE dari p adalah proporsi sukses dalam sampel Anda. Misalnya, jika Anda mengamati 7 sukses dari 10 uji, estimasi p Anda adalah 0,7.

Topik
Data Science
Analisis Data

Learn with DataCamp

Kursus

Model Campuran di R

4 jam
5.2K
Pelajari model campuran: kerangka kerja statistik yang praktis dan formal untuk pengelompokan dan klasifikasi probabilistik.
Lihat DetailRight Arrow
Mulai Kursus
Lihat SelengkapnyaRight Arrow
Terkait

blogs

Tutorial Korelasi di R

Dapatkan pengenalan dasar-dasar korelasi di R: pelajari lebih lanjut tentang koefisien korelasi, matriks korelasi, plotting korelasi, dan sebagainya.
David Woods's photo

David Woods

13 mnt

blogs

Spaghetti Plot dan Jalur Badai

Temukan alasan mengapa Anda sebaiknya (tidak) menggunakan spaghetti plot untuk menyampaikan ketidakpastian jalur prediksi badai serta dampaknya terhadap interpretasi.
Hugo Bowne-Anderson's photo

Hugo Bowne-Anderson

13 mnt

blogs

40 Pertanyaan Wawancara DBMS Teratas di 2026

Kuasai pertanyaan wawancara basis data, dari konsep SQL dasar hingga skenario desain sistem tingkat lanjut. Panduan mendalam ini mencakup semua yang Anda perlukan untuk sukses di wawancara DBMS dan meraih peran berikutnya.
Dario Radečić's photo

Dario Radečić

15 mnt

blogs

12 Alternatif ChatGPT Terbaik yang Bisa Anda Coba pada 2026

Artikel ini menyajikan daftar alternatif ChatGPT yang akan meningkatkan produktivitas Anda.
Javier Canales Luna's photo

Javier Canales Luna

14 mnt

Lihat SelengkapnyaLihat Selengkapnya
