

Hypothesetoetsing
Bernoulli-verdelingen zijn fundamenteel bij hypothesetoetsing, vooral wanneer het om proporties of succespercentages gaat. Veelvoorkomende toepassingen zijn:
- A/B-testen in marketing: Het vergelijken van de succespercentages van twee verschillende marketingstrategieën. Leer meer over A/B-testen met onze cursus Customer Analytics and A/B Testing in Python en ook onze code-along A/B Testing in R.
- Kwaliteitscontrole: Testen of het defectpercentage in een productieproces een bepaalde drempel overschrijdt.
- Medische trials: Beoordelen van de doeltreffendheid van een nieuwe behandeling vergeleken met een placebo.
In deze situaties gaat de nulhypothese vaak uit van een specifieke waarde voor de succeskans p, en de alternatieve hypothese betwist deze aanname op basis van geobserveerde data.
Simulatie en modellering
Bernoulli-verdelingen zijn handig bij simulaties en probabilistische modellering, vooral voor scenario’s met binaire uitkomsten. Ze worden gebruikt in:
- Montecarlo-simulaties: Het modelleren van complexe systemen met veel binaire beslismomenten. Leer meer met onze tutorial Introduction to Monte Carlo Methods.
- Risicoanalyse: Het beoordelen van de kans op succes of falen in zakelijke scenario’s.
- Populatiegenetica: Het modelleren van de overerving van eigenschappen in genetische studies.
Door willekeurige steekproeven te genereren uit een Bernoulli-verdeling kunnen onderzoekers en data scientists realistische simulaties maken van complexe systemen en processen.
Prestatieoverwegingen
Bij het werken met Bernoulli-verdelingen in data-analyse en machine learning zijn er verschillende prestatieaspecten om rekening mee te houden:
Omgaan met ongebalanceerde data
In veel praktijksituaties is de succeskans p in een Bernoulli-verdeling niet 0,5, wat leidt tot ongebalanceerde datasets. Deze onbalans kan uitdagingen opleveren voor machine learning-algoritmen en ze mogelijk bevooroordelen richting de meerderheidsklasse. Strategieën om dit aan te pakken zijn onder andere:
- Oversampling van de minderheidsklasse: Technieken zoals SMOTE (Synthetic Minority Oversampling Technique) kunnen worden gebruikt om synthetische voorbeelden van de minderheidsklasse te genereren.
- Undersampling van de meerderheidsklasse: Willekeurig verwijderen van gevallen uit de meerderheidsklasse om de dataset te balanceren.
- Klasgewichten aanpassen: Tijdens het trainen meer gewicht geven aan de minderheidsklasse.
- Ensemble-methoden gebruiken: Technieken zoals Random Forests of Gradient Boosting kunnen vaak beter omgaan met ongebalanceerde data dan enkele modellen. Lees onze tutorial What is Boosting om alles te leren over boosting en ensemble-methoden in het algemeen.
- Passende evaluatiemetrics kiezen: Alleen nauwkeurigheid kan misleidend zijn bij ongebalanceerde datasets. Overweeg metrics zoals F1-score, precisie, recall of area under the ROC curve.
Rekenefficiëntie
Bernoulli-verdelingen zijn rekenefficiënt, vooral voor grote datasets bij binaire classificatietaken. Er zijn echter nog steeds aandachtspunten:
- Vectorisatie: Gebruik bij de implementatie van Bernoulli-gebaseerde algoritmen gevectoriseerde operaties (bijv. NumPy in Python) voor betere prestaties.
- Sparsity: Bij tekstclassificatie met de Bernoulli Naive Bayes-classifier kan het gebruik van sparse matrix-representaties het geheugen- en rekentijdverbruik aanzienlijk verminderen.
- Afwegingen in modelcomplexiteit: Hoewel complexere modellen soms iets betere prestaties leveren, weegt de rekentijd niet altijd op tegen de marginale verbetering. Zoek de balans tussen modelnauwkeurigheid en verwerkingstijd.
Veelvoorkomende misvattingen
Om Bernoulli-verdelingen goed te begrijpen, is het belangrijk enkele veelvoorkomende misvattingen te bespreken:
De succeskans verkeerd interpreteren
Een vaak voorkomende misvatting is aannemen dat de succeskans p in een Bernoulli-verdeling altijd 0,5 is. In werkelijkheid kan p elke waarde tussen 0 en 1 aannemen, inclusief de grenzen. De waarde van p hangt af van het specifieke scenario of proces dat je modelleert.
Bijvoorbeeld:
- Bij een eerlijke muntworp is p = 0,5.
- Bij een beladen dobbelsteen waar een 6 gooien als succes geldt, kan p 1/4 zijn.
- In een kwaliteitscontroleproces met 1% defecten is p 0,01 voor een "defect"-uitkomst.
Het nauwkeurig schatten van p uit data is cruciaal voor correcte statistische gevolgtrekking en modellering. Dit houdt vaak in dat je een representatieve steekproef verzamelt en de proportie successen berekent.
Bernoulli vs. binomiale verdeling
Bernoulli-verdelingen worden soms verward met binomiale verdelingen. Hoewel verwant, zijn ze verschillend:
- Een Bernoulli-verdeling modelleert één proef met twee mogelijke uitkomsten.
- Een binomiale verdeling modelleert het aantal successen in een vast aantal onafhankelijke Bernoulli-proeven.
Met andere woorden, een binomiale verdeling is de som van meerdere onafhankelijke Bernoulli-verdelingen. Als je bijvoorbeeld een munt 10 keer opgooit en het aantal keer kop telt, is dat een binomiale verdeling. Elke afzonderlijke worp volgt echter een Bernoulli-verdeling. Laten we ze visueel vergelijken:
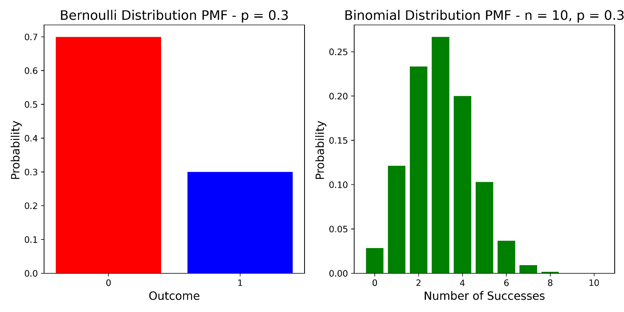
Bernoulli-verdeling versus binomiale verdeling. Afbeelding door auteur.
Deze vergelijking laat duidelijk het fundamentele verschil tussen deze twee verdelingen zien:
- De Bernoulli-verdeling (links) staat voor één proef met slechts twee mogelijke uitkomsten: 0 (falen) of 1 (succes). In dit voorbeeld, met p = 0,3, zien we 70% kans op falen en 30% kans op succes.
- De binomiale verdeling (rechts) staat voor het aantal successen in meerdere proeven (in dit geval 10 proeven). Ze toont de kans op elk mogelijk aantal successen, van 0 tot 10. De vorm van deze verdeling wordt bepaald door zowel n (het aantal proeven) als p (de succeskans per proef).
Terwijl een Bernoulli-verdeling altijd precies twee mogelijke uitkomsten heeft, kan een binomiale verdeling n+1 mogelijke uitkomsten hebben, waarbij n het aantal proeven is.
Alternatieven voor Bernoulli-verdelingen
Hoewel Bernoulli-verdelingen veel worden gebruikt, zijn er situaties waarin alternatieve verdelingen geschikter zijn. Laten we twee veelvoorkomende alternatieven bekijken:
Binomiale verdeling
De binomiale verdeling is nuttig wanneer je met meerdere proeven te maken hebt in plaats van één gebeurtenis. Dit alternatief wordt vaak gekozen als je geïnteresseerd bent in het aantal successen over meerdere pogingen in plaats van slechts één uitkomst.
Geometrische verdeling
De geometrische verdeling komt in beeld wanneer je wilt weten hoeveel pogingen nodig zijn om de eerste succes te behalen. Ze wordt vaak toegepast in situaties waarin de focus ligt op de wachttijd of het aantal pogingen tot succes optreedt.
Conclusie
Bernoulli-verdelingen vormen de basis van veel statistische concepten en zijn essentiële bouwstenen in data science. Hun eenvoudige binaire karakter, gecombineerd met brede toepassingen in machine learning, hypothesetoetsing en simulatie, maakt ze een belangrijk kader voor het analyseren en modelleren van binaire uitkomsten.
Dit zijn de kernpunten:
- Bernoulli-verdelingen modelleren afzonderlijke proeven met twee mogelijke uitkomsten.
- De succeskans p is de sleutelparameter die de verdeling bepaalt.
- Ze hebben veel toepassingen in binaire classificatie, hypothesetoetsing en simulaties.
- Inzicht in hun eigenschappen en veelvoorkomende misvattingen is nuttig voor effectieve toepassing.
- Hoewel krachtig, kunnen alternatieven zoals binomiale en geometrische verdelingen in bepaalde situaties geschikter zijn.
Als je deze concepten wilt toepassen in specifieke programmeeromgevingen, bieden onze cursussen Introduction to Statistics in Python en Introduction to Statistics in R praktische, hands-on leerervaringen. En als je klaar bent voor meer gevorderde onderwerpen, bouwt de cursus Mixture Models in R voort op deze basis om complexere statistische modelleertechnieken te verkennen. Kijk tenslotte naar onze skill track Machine Learning in Production in Python om je machine learning-skills naar productieniveau te tillen en geavanceerde modellen te gaan deployen.

Vinod Chugani begon zijn carrière in Tokio als JPMorgans jongste Head van de Hedge Fund Sales Desk en vestigde later een individueel verkooprecord bij Lehman Brothers, bouwde daarna een elektronicadistributiebedrijf in 30 landen uit tot voorbij SG$100 miljoen omzet en maakte vervolgens de overstap naar data. Als afgestudeerde Economie aan Duke en alumnus van de NYC Data Science Academy was hij een van de drie beursontvangers uit meer dan 100 aanmeldingen voor Hugo Bowne-Andersons Building AI Applications-cursus op Maven. Tegenwoordig schrijft hij voor DataCamp, KDnuggets, Machine Learning Mastery en Statology over onderwerpen van statistiek tot agentische AI, en coacht hij dataprofessionals bij de NYC Data Science Academy met meer dan 1.000 één-op-één-sessies op zijn naam.
Veelgestelde vragen
Wat is een Bernoulli-verdeling?
Een Bernoulli-verdeling is een discrete kansverdeling voor een toevalsvariabele met slechts twee mogelijke uitkomsten: succes (meestal aangeduid als 1) of falen (meestal aangeduid als 0). Ze wordt gekenmerkt door één parameter p, die de succeskans weergeeft.
Wat is het verschil tussen een Bernoulli- en een binomiale verdeling?
Een Bernoulli-verdeling modelleert één proef met twee mogelijke uitkomsten, terwijl een binomiale verdeling het aantal successen modelleert in een vast aantal onafhankelijke Bernoulli-proeven. Je kunt een binomiale verdeling zien als een som van meerdere Bernoulli-verdelingen.
Kunnen Bernoulli-verdelingen worden gebruikt voor hypothesetoetsing?
Ja, Bernoulli-verdelingen worden vaak gebruikt bij hypothesetoetsing, vooral in scenario’s met proporties of succespercentages. Ze zijn bijzonder nuttig bij A/B-testen, waarbij je de succespercentages van twee verschillende strategieën of behandelingen vergelijkt.
Hoe verhouden Bernoulli-verdelingen zich tot odds en log-odds?
De odds (kansverhouding) op succes in een Bernoulli-proef zijn p/(1-p), waarbij p de succeskans is. De log-odds, ook wel de logitfunctie genoemd, is de natuurlijke logaritme van de odds. Deze concepten worden veel gebruikt in logistische regressie en andere statistische analyses.
Hoe kan ik de parameter p van een Bernoulli-verdeling uit data schatten?
De meest gebruikelijke methode om p te schatten is maximum likelihood-schatting (MLE). Voor een Bernoulli-verdeling is de MLE van p simpelweg de proportie successen in je steekproef. Als je bijvoorbeeld 7 successen observeert in 10 proeven, is je schatting van p 0,7.


De Bernoulli-verdeling is een fundamenteel concept in statistiek en data science. Genoemd naar de Zwitserse wiskundige Jacob Bernoulli, is deze verdeling belangrijk in de kansrekening en dient ze als bouwsteen voor complexere statistische modellen—van het voorspellen van klantgedrag tot het ontwikkelen van machine learning-algoritmen.
Als start kun je onze cursus Introduction to Statistics bekijken voor een opfriscursus over kansverdelingen. Bekijk ook onze cursus Foundations of Probability in Python om problemen met twee mogelijke uitkomsten te bestuderen en te oefenen met de
scipy-bibliotheek. Onze cursus Statistical Thinking in Python (Part 1) is een andere goede optie, omdat je daarin leert je eigen Python-functies te schrijven om Bernoulli-proeven uit te voeren.Wat is een Bernoulli-verdeling?
Een Bernoulli-verdeling is een discrete kansverdeling die een toevalsvariabele met slechts twee mogelijke uitkomsten modelleert. Deze uitkomsten worden meestal aangeduid als "succes" en "falen", of ze worden numeriek weergegeven als 1 en 0.
Bernoulli-proeven
Laten we beginnen met Bernoulli-proeven. Een Bernoulli-proef is een willekeurig experiment met precies twee mogelijke uitkomsten. Klassieke voorbeelden zijn:
Elke Bernoulli-proef is onafhankelijk, wat betekent dat de uitkomst van de ene proef de kans op succes in latere proeven niet beïnvloedt.
Bernoulli-verdelingen
Een Bernoulli-verdeling beschrijft de kans op succes in één Bernoulli-proef. Ze wordt gekenmerkt door één parameter, p, die de kans op succes weergeeft. De kans op falen is dus 1 - p. Wiskundig kunnen we een Bernoulli-verdeling als volgt uitdrukken, waarbij X de toevalsvariabele is die de uitkomst van de Bernoulli-proef weergeeft.
Om te laten zien hoe Bernoulli-verdelingen veranderen bij verschillende succeskansen, vergelijken we drie voorbeelden.
Vergelijking van Bernoulli-verdelingen voor verschillende waarden van p. Afbeelding door auteur.
Hier toont elke grafiek een andere Bernoulli-verdeling.
Zoals je ziet heeft de kansmassafunctie van een Bernoulli-verdeling altijd twee balken: één voor de kans op falen (X = 0) en één voor de kans op succes (X = 1). De hoogte van deze balken verandert op basis van de waarde van p, maar samen zijn ze altijd gelijk aan 1.
Eigenschappen van Bernoulli-verdelingen
Laten we de belangrijkste kenmerken verkennen die de Bernoulli-verdeling definiëren.
Binaire uitkomsten
Het meest kenmerkende van een Bernoulli-verdeling is haar binaire aard. Elke proef kan slechts één van twee mogelijke uitkomsten hebben:
Deze binaire eigenschap maakt Bernoulli-verdelingen bijzonder nuttig wanneer we geïnteresseerd zijn in ja/nee-, waar/onwaar- of succes/falen-uitkomsten. Enkele belangrijke voordelen van het gebruik van Bernoulli-verdelingen in data science en machine learning:
Gemiddelde en variantie
Het gemiddelde (μ) en de variantie (σ²) van een Bernoulli-verdeling zijn rechtstreeks gekoppeld aan de succeskans, p.
Gemiddelde
Het gemiddelde is gelijk aan de succeskans. Dit houdt in dat als je een Bernoulli-proef vaak herhaalt, de gemiddelde uitkomst zal convergeren naar p.
Varianties
De variantie wordt gegeven door: σ² = p(1 - p). De variantie is maximaal bij p = 0,5 en neemt af naarmate p dichter bij 0 of 1 komt. Deze relatie geeft inzicht in de spreiding van de data en de onzekerheid rond de uitkomsten. Qua dataspreiding betekent de variantie in een Bernoulli-verdeling:
Symmetrie en asymmetrie
De vorm van een Bernoulli-verdeling hangt af van de waarde van p:
De symmetrie of asymmetrie van de verdeling beïnvloedt de interpretatie op verschillende manieren:
Praktische toepassingen van Bernoulli-verdelingen
Bernoulli-verdelingen worden op grote schaal gebruikt in verschillende vakgebieden, vooral in data science en statistiek. Laten we enkele van de meest voorkomende toepassingen bekijken:
Binaire classificatie in machine learning
In machine learning spelen Bernoulli-verdelingen een centrale rol bij binaire classificatieproblemen. Dit zijn situaties waarin we data in één van twee klassen moeten indelen. Voorbeelden zijn:
Algoritmen die Bernoulli-verdelingen benutten voor binaire classificatie zijn onder meer: