

Test d'ipotesi
Le distribuzioni di Bernoulli sono fondamentali nei test d'ipotesi, in particolare quando si trattano proporzioni o tassi di successo. Applicazioni comuni includono:
- A/B test nel marketing: Confrontare i tassi di successo di due diverse strategie di marketing. Scopri di più sugli A/B test con il nostro corso Customer Analytics and A/B Testing in Python e anche con il nostro code-along A/B Testing in R.
- Controllo qualità: Verificare se il tasso di difetti in un processo produttivo supera una certa soglia.
- Sperimentazioni mediche: Valutare l'efficacia di un nuovo trattamento rispetto a un placebo.
In questi scenari, l'ipotesi nulla spesso assume un valore specifico per la probabilità di successo p, e l'ipotesi alternativa mette in discussione questa assunzione in base ai dati osservati.
Simulazione e modellazione
Le distribuzioni di Bernoulli sono utili nelle simulazioni e nella modellazione probabilistica, soprattutto per scenari con esiti binari. Sono usate in:
- Simulazioni Monte Carlo: Modellare sistemi complessi con molti punti decisionali binari. Approfondisci con il nostro tutorial Introduzione ai metodi Monte Carlo.
- Analisi del rischio: Valutare la probabilità di successo o fallimento in scenari di business.
- Genetica delle popolazioni: Modellare l'ereditarietà dei tratti negli studi genetici.
Generando campioni casuali da una distribuzione di Bernoulli, ricercatori e data scientist possono creare simulazioni realistiche di sistemi e processi complessi.
Considerazioni sulle prestazioni
Quando lavori con distribuzioni di Bernoulli nell'analisi dei dati e nel machine learning, ci sono diverse considerazioni sulle prestazioni da tenere a mente:
Gestire dati sbilanciati
In molti scenari reali, la probabilità di successo p in una distribuzione di Bernoulli non è 0,5, portando a dataset sbilanciati. Questo sbilanciamento può creare difficoltà per gli algoritmi di machine learning, potenzialmente spingendoli verso la classe di maggioranza. Strategie per affrontare il problema includono:
- Oversampling della classe minoritaria: Tecniche come SMOTE (Synthetic Minority Oversampling Technique) possono essere usate per generare campioni sintetici della classe minoritaria.
- Undersampling della classe maggioritaria: Rimuovere casualmente istanze dalla classe maggioritaria per bilanciare il dataset.
- Regolazione dei pesi di classe: Assegnare maggiore importanza alla classe minoritaria durante l'addestramento del modello.
- Uso di metodi ensemble: Tecniche come Random Forest o Gradient Boosting spesso gestiscono meglio i dati sbilanciati rispetto a modelli singoli. Leggi il nostro tutorial Che cos'è il boosting per conoscere il boosting e, più in generale, i metodi ensemble.
- Scelta di metriche di valutazione appropriate: La sola accuracy può essere fuorviante per dataset sbilanciati. Considera metriche come F1-score, precision, recall o area sotto la curva ROC.
Efficienza computazionale
Le distribuzioni di Bernoulli sono efficienti dal punto di vista computazionale, soprattutto per grandi dataset in compiti di classificazione binaria. Tuttavia, ci sono comunque considerazioni da tenere a mente:
- Vettorizzazione: Quando implementi algoritmi basati su Bernoulli, usa operazioni vettorializzate (ad es., NumPy in Python) per migliorare le prestazioni.
- Sparsità: Nei compiti di classificazione del testo con il classificatore Bernoulli Naive Bayes, sfruttare rappresentazioni a matrici sparse può ridurre significativamente l'uso di memoria e i tempi di calcolo.
- Trade-off nella complessità del modello: Sebbene modelli più complessi possano offrire prestazioni leggermente migliori, il costo computazionale potrebbe non giustificare sempre il miglioramento marginale. Valuta il bilanciamento tra accuratezza del modello e tempo di elaborazione.
Falsi miti comuni
Per comprendere a fondo le distribuzioni di Bernoulli, è importante chiarire alcuni fraintendimenti comuni:
Interpretare male la probabilità di successo
Un fraintendimento frequente è presumere che la probabilità di successo p in una distribuzione di Bernoulli sia sempre 0,5. In realtà, p può assumere qualsiasi valore tra 0 e 1, inclusi. Il valore di p dipende dallo specifico scenario o processo modellato.
Per esempio:
- Nel lancio di una moneta equa, p = 0,5.
- In un dado truccato in cui il successo è ottenere un 6, p potrebbe essere 1/4.
- In un processo di controllo qualità in cui il tasso di difetti è dell'1%, p sarebbe 0,01 per un esito "difetto".
Stimare accuratamente p dai dati è cruciale per un'inferenza statistica e una modellazione corrette. Ciò spesso comporta la raccolta di un campione rappresentativo e il calcolo della proporzione di successi.
Bernoulli vs. distribuzione binomiale
Le distribuzioni di Bernoulli vengono talvolta confuse con le distribuzioni binomiali. Pur essendo correlate, sono distinte:
- Una distribuzione di Bernoulli modella una singola prova con due possibili esiti.
- Una distribuzione binomiale modella il numero di successi in un numero fisso di prove di Bernoulli indipendenti.
In altre parole, una distribuzione binomiale è la somma di più distribuzioni di Bernoulli indipendenti. Per esempio, se lanci una moneta 10 volte e conti il numero di teste, quella è una distribuzione binomiale. Ciascun singolo lancio, invece, segue una distribuzione di Bernoulli. Confrontiamole visivamente:
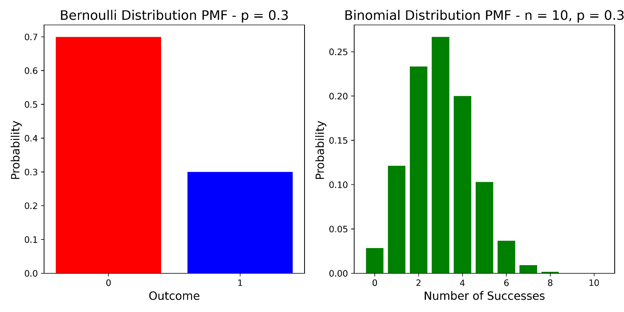
Distribuzione di Bernoulli rispetto alla distribuzione binomiale. Immagine dell'autore.
Questo confronto mostra chiaramente la differenza fondamentale tra queste due distribuzioni:
- La distribuzione di Bernoulli (a sinistra) rappresenta una singola prova con soli due possibili esiti: 0 (fallimento) o 1 (successo). In questo esempio, con p = 0,3, vediamo un 70% di probabilità di fallimento e un 30% di probabilità di successo.
- La distribuzione binomiale (a destra) rappresenta il numero di successi in più prove (in questo caso, 10 prove). Mostra la probabilità di ottenere ciascun possibile numero di successi, da 0 a 10. La forma di questa distribuzione è determinata sia da n (il numero di prove) sia da p (la probabilità di successo in ciascuna prova).
Mentre una distribuzione di Bernoulli ha sempre esattamente due possibili esiti, una distribuzione binomiale può avere n+1 possibili esiti, dove n è il numero di prove.
Alternative alle distribuzioni di Bernoulli
Sebbene le distribuzioni di Bernoulli siano ampiamente utilizzate, esistono scenari in cui distribuzioni alternative potrebbero essere più appropriate. Vediamo due alternative comuni:
Distribuzione binomiale
La distribuzione binomiale è utile quando si hanno a che fare con più prove anziché con un singolo evento. Questa alternativa è spesso considerata quando ti interessa il numero di successi su più tentativi piuttosto che un singolo esito.
Distribuzione geometrica
La distribuzione geometrica entra in gioco quando ti interessa quanti tentativi serviranno per ottenere il primo successo. È spesso applicata in situazioni in cui l'attenzione è sul tempo di attesa o sul numero di tentativi prima che avvenga il successo.
Conclusioni
Le distribuzioni di Bernoulli sono alla base di molti concetti statistici e sono componenti essenziali nella data science. La loro semplice natura binaria, unita alle ampie applicazioni nel machine learning, nei test d'ipotesi e nelle simulazioni, le rende un quadro chiave per analizzare e modellare esiti binari.
Ecco i punti chiave:
- Le distribuzioni di Bernoulli modellano singole prove con due possibili esiti.
- La probabilità di successo p è il parametro chiave che definisce la distribuzione.
- Hanno molte applicazioni nella classificazione binaria, nei test d'ipotesi e nelle simulazioni.
- Comprenderne le proprietà e i fraintendimenti comuni è utile per un'applicazione efficace.
- Pur essendo potenti, in alcuni scenari potrebbero essere più adatte alternative come le distribuzioni binomiale e geometrica.
Se vuoi applicare questi concetti in ambienti di programmazione specifici, i nostri corsi Introduzione alla statistica in Python e Introduzione alla statistica in R offrono esperienze pratiche e operative. E se sei pronto per argomenti più avanzati, il corso Mixture Models in R si basa su questi concetti di base per esplorare tecniche di modellazione statistica più complesse. Infine, dai un'occhiata al nostro percorso di competenze Machine Learning in Production in Python per portare le tue abilità di machine learning a livello di produzione e iniziare a distribuire modelli avanzati.

Vinod Chugani ha iniziato la sua carriera a Tokyo come il più giovane Head dell'Hedge Fund Sales Desk di JPMorgan e in seguito ha stabilito un record personale di vendite a Lehman Brothers, poi ha costruito un'attività di distribuzione di elettronica in 30 paesi superando i 100 milioni di SG$ di fatturato prima di passare ai dati. Laureato in Economia alla Duke e diplomato alla NYC Data Science Academy, è stato uno dei tre beneficiari di borsa di studio su oltre 100 candidati per il corso Building AI Applications di Hugo Bowne-Anderson su Maven. Oggi scrive per DataCamp, KDnuggets, Machine Learning Mastery e Statology su argomenti che vanno dalla statistica all'AI agentica, e fa da mentor a professionisti dei dati alla NYC Data Science Academy con oltre 1.000 sessioni one-to-one all'attivo.
Domande frequenti
Che cos'è una distribuzione di Bernoulli?
Una distribuzione di Bernoulli è una distribuzione di probabilità discreta per una variabile casuale che ha solo due possibili esiti: successo (di solito indicato con 1) o fallimento (di solito indicato con 0). È caratterizzata da un singolo parametro p, che rappresenta la probabilità di successo.
Qual è la differenza tra una distribuzione di Bernoulli e una distribuzione binomiale?
Una distribuzione di Bernoulli modella una singola prova con due possibili esiti, mentre una distribuzione binomiale modella il numero di successi in un numero fisso di prove di Bernoulli indipendenti. Puoi pensare a una distribuzione binomiale come alla somma di più distribuzioni di Bernoulli.
Le distribuzioni di Bernoulli possono essere usate per i test d'ipotesi?
Sì, le distribuzioni di Bernoulli sono comunemente utilizzate nei test d'ipotesi, soprattutto per scenari che coinvolgono proporzioni o tassi di successo. Sono particolarmente utili negli A/B test, dove si confrontano i tassi di successo di due diverse strategie o trattamenti.
Come si collegano le distribuzioni di Bernoulli a odds e log-odds?
Le odds di successo in una prova di Bernoulli sono p/(1-p), dove p è la probabilità di successo. Il log-odds, noto anche come funzione logit, è il logaritmo naturale delle odds. Questi concetti sono comunemente usati nella regressione logistica e in altre analisi statistiche.
Come posso stimare dai dati il parametro p di una distribuzione di Bernoulli?
Il metodo più comune per stimare p è la massima verosimiglianza (MLE). Per una distribuzione di Bernoulli, la MLE di p è semplicemente la proporzione di successi nel tuo campione. Per esempio, se osservi 7 successi su 10 prove, la tua stima di p sarà 0,7.





La distribuzione di Bernoulli è un concetto fondamentale in statistica e data science. Prende il nome dal matematico svizzero Jacob Bernoulli ed è importante nella teoria della probabilità; inoltre funge da mattoncino per modelli statistici più complessi — da tutto ciò che riguarda la previsione del comportamento dei clienti allo sviluppo di algoritmi di machine learning.
Per iniziare, dai un'occhiata al nostro corso Introduzione alla statistica per ripassare le distribuzioni di probabilità. Considera anche il corso Fondamenti di probabilità in Python per studiare problemi con due possibili esiti ed esercitarti con la libreria
scipy. Un'altra ottima opzione è il nostro corso Pensiero statistico in Python (Parte 1), perché ti insegnerà a scrivere funzioni Python per eseguire prove di Bernoulli.Cos'è una distribuzione di Bernoulli?
Una distribuzione di Bernoulli è una distribuzione di probabilità discreta che modella una variabile casuale con soli due possibili esiti. Questi esiti sono in genere etichettati come "successo" e "fallimento", oppure rappresentati numericamente come 1 e 0.
Prove di Bernoulli
Partiamo dalle prove di Bernoulli. Una prova di Bernoulli è un esperimento casuale con esattamente due possibili esiti. Esempi classici includono:
Ogni prova di Bernoulli è indipendente, il che significa che l'esito di una prova non influenza la probabilità di successo nelle prove successive.
Distribuzioni di Bernoulli
Una distribuzione di Bernoulli descrive la probabilità di successo in una singola prova di Bernoulli. È caratterizzata da un solo parametro, p, che rappresenta la probabilità di successo. La probabilità di fallimento è quindi 1 - p. Matematicamente, possiamo esprimere una distribuzione di Bernoulli come segue, dove X è la variabile casuale che rappresenta l'esito della prova di Bernoulli.
Per illustrare come le distribuzioni di Bernoulli cambiano al variare della probabilità di successo, confrontiamo tre esempi.
Confronto tra distribuzioni di Bernoulli per diversi valori di p. Immagine dell'autore.
Qui, ciascun grafico mostra una diversa distribuzione di Bernoulli.
Come possiamo vedere, la funzione di massa di probabilità di una distribuzione di Bernoulli ha sempre due barre: una per la probabilità di fallimento (X = 0) e una per la probabilità di successo (X = 1). L'altezza di queste barre cambia in base al valore di p, ma sommano sempre a 1.
Proprietà delle distribuzioni di Bernoulli
Esploriamo le caratteristiche chiave che definiscono la distribuzione di Bernoulli.
Esiti binari
La caratteristica più distintiva di una distribuzione di Bernoulli è la sua natura binaria. Ogni prova può avere solo uno dei due possibili esiti:
Questa proprietà binaria rende le distribuzioni di Bernoulli particolarmente utili quando ci interessano esiti sì/no, vero/falso o successo/fallimento. Ecco alcuni vantaggi chiave dell'uso delle distribuzioni di Bernoulli in data science e machine learning:
Media e varianza
La media (μ) e la varianza (σ²) di una distribuzione di Bernoulli sono direttamente legate alla probabilità di successo, p.
Media
La media è uguale alla probabilità di successo. Ciò implica che, ripetendo molte volte una prova di Bernoulli, l'esito medio converge a p.
Varianza
La varianza è data da: σ² = p(1 - p). La varianza raggiunge il massimo quando p = 0,5 e diminuisce man mano che p si avvicina a 0 o 1. Questa relazione fornisce indicazioni sulla dispersione dei dati e sull'incertezza associata agli esiti. In termini di dispersione dei dati, la varianza in una distribuzione di Bernoulli indica:
Simmetria e asimmetria
La forma di una distribuzione di Bernoulli dipende dal valore di p:
La simmetria o l'asimmetria della distribuzione influisce sull'interpretazione in vari modi:
Applicazioni pratiche delle distribuzioni di Bernoulli
Le distribuzioni di Bernoulli trovano ampia applicazione in vari campi, in particolare in data science e statistica. Vediamo alcune delle applicazioni più comuni:
Classificazione binaria nel machine learning
Nel machine learning, le distribuzioni di Bernoulli svolgono un ruolo centrale nei problemi di classificazione binaria. Si tratta di scenari in cui dobbiamo categorizzare i dati in una di due classi. Esempi includono:
Gli algoritmi che sfruttano le distribuzioni di Bernoulli per la classificazione binaria includono: