集中趋势是统计学中最重要的概念之一,用于描述数据倾向于聚集的典型值。它提供了一个能够代表整个数据集的单一数值,使大量信息更易于消化并便于比较。
从历史上看,“中心值”的概念经历了数百年的演变。古代学者如希腊人考虑过简单平均数,而在17和18世纪,数学家将均值、中位数和众数形式化为统计工具。20世纪则进一步发展,提出了适用于偏态或易受异常值影响数据的专门度量。如今,集中趋势在社会科学、经济学、工程学以及机器学习等众多领域仍发挥着关键作用。
集中趋势的基本概念
在介绍各种变体之前,让我们先回顾一些术语。若想更系统、更全面地学习这些内容,欢迎报名我们的统计学入门课程。
定义与目的
集中趋势指能够识别数据集中心点的统计量。它作为一个汇总统计量,指示分布中大多数数值倾向聚集的位置。通过给出一个具有代表性的单一值,它简化了原始数据所固有的复杂变异性。
集中趋势的一个关键用途是实现数据集之间的比较。例如,借助集中趋势度量,我们可以比较不同城市的平均收入,从而快速揭示社会经济格局。需要强调的是,集中趋势不同于离散程度度量,后者描述数据围绕中心的分散情况。均值或中位数显示数据中心的位置,而方差和标准差则揭示数据围绕该中心的紧密或松散程度。
在描述性统计中的作用
在描述性统计中,集中趋势被用来高效地概括大型数据集。无论是分析考试成绩、生产时间,还是客户评分,了解“典型值”对于解读趋势都至关重要。
集中趋势与变异性度量密切相关。例如,两个数据集可能具有相同的均值,但分散程度大相径庭,这会影响该均值作为汇总统计量的可靠性。
在现实情境中,集中趋势帮助政策制定者、企业领导者和研究人员基于代表性数值做出决策。零售商可能通过分析平均销量来制定备货策略,而医疗研究人员可能通过考察中位生存时间来评估治疗效果。
数据类型与集中趋势
选择合适的集中趋势度量高度依赖于数据类型。数据大致分为四类:
- 名义数据表示无内在顺序的类别(例如,血型、颜色)。
- 有序数据表示具有排序的等级,但相邻等级间距不恒定(例如,调查评级:差、一般、好)。
- 区间数据具有有序且等距的数值,但没有真正的零点(例如,摄氏温度)。
- 比率数据具有等距与绝对零点(例如,体重、身高、收入)。
以下是各类数据最适合的集中趋势度量:
- 对于名义数据,应使用众数,因为对“红”“蓝”“绿”等类别求平均没有意义。
- 对于有序数据,中位数通常是最佳选择,既尊重等级顺序,又不假定等级差距相等。
- 对于区间与比率数据,均值、中位数或众数都可能合适,取决于分布形态及是否存在异常值。
例如,家庭收入常用中位数来报告,因为收入数据往往被极高收入者拉偏;而对于近似正态分布的人体身高,使用均值则较为合理。
主要的集中趋势度量
集中趋势的三种主要度量是算术平均数、中位数和众数。下面分别加以介绍,并重点关注它们的优势与局限。
算术平均数
算术平均数通常简称为平均数或均值,通过将数据集中所有数值求和后除以观测数得到:
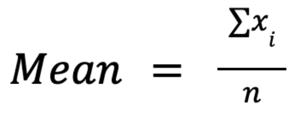
该度量的主要优势在于其数学性质:具有良好的代数可操作性,便于在推断统计、假设检验和回归分析中进行优雅的表述。例如,它可与方差和标准差的计算无缝衔接。
然而,均值对异常值高度敏感:少量极端值就能显著扭曲它,使其在偏态分布中缺乏代表性。例如,在收入数据中,几位亿万富翁就可能将均值显著抬高,远超大多数人的收入水平。
谈到均值,必须区分总体均值(μ)和样本均值(x̄)。前者描述整个总体,后者则基于样本对其进行估计。若要从样本数据对总体作出推断,我们使用称为统计推断的过程。
不宜使用均值的情形包括:分布严重偏态、存在显著异常值,或是有序数据(对等级求平均并无实际意义)。
中位数
中位数表示按从小到大排序后处于中间位置的值。若数值个数为奇数,则为正中间的那个值;若为偶数,则为中间两个值的平均。
计算中位数需要:
- 将数据从小到大排序。
- 确定中间值。
中位数的关键优势在于其对异常值的稳健性:分布两端的极端值不会影响它的取值,因此非常适合用于如收入或房价等偏态数据。
不过,中位数在数学上不如均值便于处理。它在复杂统计公式或建模中作用较小,也不易进行代数运算。
众数
众数是数据集中出现频率最高的数值。与均值和中位数不同,它也可用于名义数据,因此适用范围涵盖不同数据类型。
众数有助于识别高频类别,如最受欢迎的产品颜色或最常见的客户投诉。但它也存在一些局限:
- 在均匀分布中,可能不存在众数。
- 在多峰分布中,可能存在多个众数,增加了解释难度。
- 对于数值型数据,若所有值都唯一,众数的信息量可能很低,甚至没有意义。
频数分布表常用于确定众数。例如,在下方关于苹果颜色的频数分布表中,“绿色”就是众数:
主要度量的比较分析
理解均值、中位数和众数在表现与适用性上的差异对统计分析至关重要。让我们来比较一下:
对异常值与偏度的敏感性
三者之中,均值对异常值最为敏感:一个极端值就可能显著扭曲均值。相比之下,中位数保持稳定,除非有足够多的极端值累积到能够移动中点。众数完全不受异常值影响,因为它只由频数决定。
偏度同样会影响这些度量。在右偏分布(例如收入数据)中,通常是均值高于中位数,而中位数又高于众数。(此处的众数指连续分布中的众数,即概率密度曲线的峰值,假定其存在。)
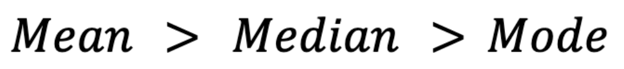
相反,在左偏分布(例如大多数学生得分较高的测试成绩)中,均值低于中位数和众数:
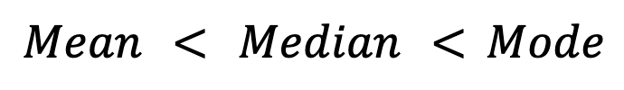
对于对称分布,如正态分布,理想情况下三者应相等:
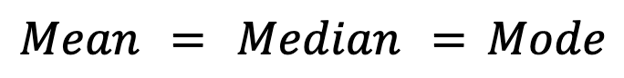
不过在实践中,即便是对称分布也可能因抽样变异而出现小幅偏差。
均值、中位数与众数之间的关系
上一节我们已看到在正态与偏态分布中,均值、中位数与众数的一般关系。总体而言,这三者之间的关系可作为偏度的诊断工具。在实证研究中,统计学家常使用皮尔逊第二偏度系数:
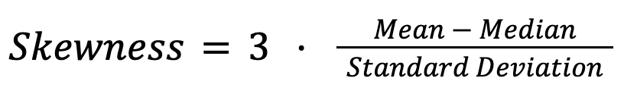
例如,在薪资分布中,均值与中位数之间显著差距往往意味着收入不平等。同样,在住房市场中,中位房价通常比均价更能反映典型成本,因为均价可能被少量极其昂贵的房产拉高。
按数据类型的适用性
不同的集中趋势度量适用于不同的数据类型。下表概述了各度量的最佳用例与局限。
|
数据类型
|
最佳度量
|
备注
|
|
名义
|
众数
|
均值和中位数无意义
|
|
有序
|
中位数、众数
|
由于区间不等,均值常不适用
|
|
区间/比率
|
均值、中位数、众数
|
选择取决于分布形态与异常值
|
由此可见,将统计度量与数据性质相匹配至关重要。
专门的集中趋势度量
除了主要的集中趋势度量外,还有一些针对偏度、异常值和尺度问题的专门替代方法。
截尾均值与温莎化均值
所谓截尾均值,是在计算平均数前,从数据两端各剔除固定比例的极端值。例如,10%截尾均值会删除最低10%和最高10%的数值。
温莎化均值并不直接删除极端值,而是将其替换为最近的保留值。该度量在金融、制造和调查分析等领域很有用,因为这些数据中可能包含罕见但影响巨大的极端值。
两种技术都能降低异常值的影响,在均值的敏感性与中位数的稳健性之间取得平衡,从而兼顾稳健性与数据保留。
几何均值与调和均值
几何均值(geometric mean)通过将所有数据点相乘并取第 n 个根(n 为数据点数量)得到。它特别适用于乘法过程,如增长率、投资回报和生物测量。几何均值的计算公式如下:
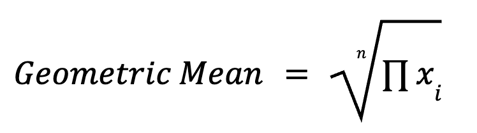
例如,多年平均增长更适合用几何均值而非算术均值来概括。
而调和均值的计算为:
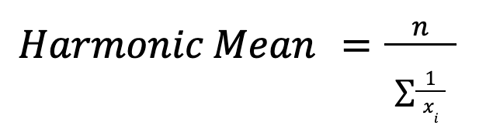
它在对速率进行平均时很有价值,如速度或财务比率。例如,在不同路段上计算平均行驶速度时,调和均值能给出正确的整体速率。
加权均值与三均值
所谓加权均值,是为不同数据点赋予不同的重要性。例如,学生的期末成绩可能会将考试与课程作业按不同权重进行合成。该度量能校正偏差,确保更重要的观测具有更大影响力。
而三均值(trimean)结合了中位数与四分位数:
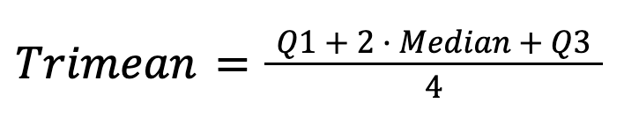
通过将中位数的稳健性与关于数据分布的扩散信息相结合,它能提供稳定且有洞见的集中趋势估计。
若想系统提升统计思维,欢迎报读以下课程:
集中趋势度量的稳健性
稳健性描述的是集中趋势度量在异常值或非正态分布下抵抗扭曲的能力。本章将更深入地探讨这一概念。
崩溃点分析
崩溃点(breakdown point)表示某统计量在结果变得极度不准确前可承受的数据污染程度。例如:
- 均值的崩溃点为0%,因为单个极端异常值就能将其拉偏。
- 中位数的崩溃点为50%,意味着多达一半的数据被污染前,中位数仍可保持稳定。
- 截尾均值具有介于两者之间的崩溃点,因为它在提升稳健性的同时保留了数据效率。
理解崩溃点有助于分析师在可能存在数据污染时选择合适的统计量。
稳健性与效率的权衡
像中位数这样的稳健度量会牺牲部分统计效率,这意味着要达到与不那么稳健(如均值)相同的精度,可能需要更大的样本量。
例如,中位数虽稳健,但在正态分布下效率较低;相反,均值在正态分布下效率高,但对偏态数据敏感。分析师需根据数据特征在稳健性与效率之间取得平衡。
在金融或生物医学研究等领域,由于数据异常常见且风险较大,实践中往往更重视稳健性而非效率。
进阶思考
现代数据的挑战促使集中趋势分析超越传统方法。下面来看看一些进阶主题。
偏度的影响
偏度从根本上影响集中趋势度量的解释。仅报告偏态数据的均值可能具有误导性。为更好反映数据的不对称性,最佳实践建议同时报告均值与中位数。例如,在收入研究中,中位数往往比均值更能呈现“典型”的收入水平。
多峰分布
多峰分布包含多个峰值,每个峰值可能代表不同的子群体。仅依赖均值等单一度量会掩盖关键洞见。
例如,在大学考试成绩中,出现两个峰可能意味着两个学生群体:一类对材料掌握良好,另一类则遇到困难。在这种情况下,报告多个众数或各簇特定的中位数更有助于揭示这些模式。
类别数据的方法
名义与有序数据往往难以用传统数值方式概括。对名义数据来说,众数仍是主要工具。不过,诸如模态类别熵等高级方法可评估类别数据中的多样性与确定性,量化响应在各类别中的集中或分散程度。
对于有序数据,累积百分比或中位等级等技术能够在不假定区间相等的前提下,提供关于集中趋势的更深入洞见。
结语
新兴的计算方法与数据科学技术不断加深我们对集中趋势的理解。即便在复杂的高维数据集中,新方法也能实现更细致的分析。未来在集中趋势领域的研究与发展,或将聚焦于能自动针对偏度或数据污染进行调整的自适应度量,从而进一步提升稳健性与可解释性。
如果您希望提升数据技能,并在 Python 与 R 的统计学基础方面打下更扎实的根基,欢迎考虑以下技能路径,我强烈推荐:


集中趋势是统计学中最重要的概念之一,用于描述数据倾向于聚集的典型值。它提供了一个能够代表整个数据集的单一数值,使大量信息更易于消化并便于比较。
从历史上看,“中心值”的概念经历了数百年的演变。古代学者如希腊人考虑过简单平均数,而在17和18世纪,数学家将均值、中位数和众数形式化为统计工具。20世纪则进一步发展,提出了适用于偏态或易受异常值影响数据的专门度量。如今,集中趋势在社会科学、经济学、工程学以及机器学习等众多领域仍发挥着关键作用。
集中趋势的基本概念
在介绍各种变体之前,让我们先回顾一些术语。若想更系统、更全面地学习这些内容,欢迎报名我们的统计学入门课程。
定义与目的
集中趋势指能够识别数据集中心点的统计量。它作为一个汇总统计量,指示分布中大多数数值倾向聚集的位置。通过给出一个具有代表性的单一值,它简化了原始数据所固有的复杂变异性。
集中趋势的一个关键用途是实现数据集之间的比较。例如,借助集中趋势度量,我们可以比较不同城市的平均收入,从而快速揭示社会经济格局。需要强调的是,集中趋势不同于离散程度度量,后者描述数据围绕中心的分散情况。均值或中位数显示数据中心的位置,而方差和标准差则揭示数据围绕该中心的紧密或松散程度。
在描述性统计中的作用
在描述性统计中,集中趋势被用来高效地概括大型数据集。无论是分析考试成绩、生产时间,还是客户评分,了解“典型值”对于解读趋势都至关重要。
集中趋势与变异性度量密切相关。例如,两个数据集可能具有相同的均值,但分散程度大相径庭,这会影响该均值作为汇总统计量的可靠性。
在现实情境中,集中趋势帮助政策制定者、企业领导者和研究人员基于代表性数值做出决策。零售商可能通过分析平均销量来制定备货策略,而医疗研究人员可能通过考察中位生存时间来评估治疗效果。
数据类型与集中趋势
选择合适的集中趋势度量高度依赖于数据类型。数据大致分为四类:
以下是各类数据最适合的集中趋势度量:
例如,家庭收入常用中位数来报告,因为收入数据往往被极高收入者拉偏;而对于近似正态分布的人体身高,使用均值则较为合理。
主要的集中趋势度量
集中趋势的三种主要度量是算术平均数、中位数和众数。下面分别加以介绍,并重点关注它们的优势与局限。
算术平均数
算术平均数通常简称为平均数或均值,通过将数据集中所有数值求和后除以观测数得到:
该度量的主要优势在于其数学性质:具有良好的代数可操作性,便于在推断统计、假设检验和回归分析中进行优雅的表述。例如,它可与方差和标准差的计算无缝衔接。
然而,均值对异常值高度敏感:少量极端值就能显著扭曲它,使其在偏态分布中缺乏代表性。例如,在收入数据中,几位亿万富翁就可能将均值显著抬高,远超大多数人的收入水平。
谈到均值,必须区分总体均值(μ)和样本均值(x̄)。前者描述整个总体,后者则基于样本对其进行估计。若要从样本数据对总体作出推断,我们使用称为统计推断的过程。
不宜使用均值的情形包括:分布严重偏态、存在显著异常值,或是有序数据(对等级求平均并无实际意义)。
中位数
中位数表示按从小到大排序后处于中间位置的值。若数值个数为奇数,则为正中间的那个值;若为偶数,则为中间两个值的平均。
计算中位数需要:
中位数的关键优势在于其对异常值的稳健性:分布两端的极端值不会影响它的取值,因此非常适合用于如收入或房价等偏态数据。
不过,中位数在数学上不如均值便于处理。它在复杂统计公式或建模中作用较小,也不易进行代数运算。
众数
众数是数据集中出现频率最高的数值。与均值和中位数不同,它也可用于名义数据,因此适用范围涵盖不同数据类型。
众数有助于识别高频类别,如最受欢迎的产品颜色或最常见的客户投诉。但它也存在一些局限:
频数分布表常用于确定众数。例如,在下方关于苹果颜色的频数分布表中,“绿色”就是众数:
苹果颜色
频数
红色
5
绿色
8
黄色
3
主要度量的比较分析
理解均值、中位数和众数在表现与适用性上的差异对统计分析至关重要。让我们来比较一下:
对异常值与偏度的敏感性
三者之中,均值对异常值最为敏感:一个极端值就可能显著扭曲均值。相比之下,中位数保持稳定,除非有足够多的极端值累积到能够移动中点。众数完全不受异常值影响,因为它只由频数决定。
偏度同样会影响这些度量。在右偏分布(例如收入数据)中,通常是均值高于中位数,而中位数又高于众数。(此处的众数指连续分布中的众数,即概率密度曲线的峰值,假定其存在。)
相反,在左偏分布(例如大多数学生得分较高的测试成绩)中,均值低于中位数和众数:
对于对称分布,如正态分布,理想情况下三者应相等:
不过在实践中,即便是对称分布也可能因抽样变异而出现小幅偏差。
均值、中位数与众数之间的关系
上一节我们已看到在正态与偏态分布中,均值、中位数与众数的一般关系。总体而言,这三者之间的关系可作为偏度的诊断工具。在实证研究中,统计学家常使用皮尔逊第二偏度系数:
例如,在薪资分布中,均值与中位数之间显著差距往往意味着收入不平等。同样,在住房市场中,中位房价通常比均价更能反映典型成本,因为均价可能被少量极其昂贵的房产拉高。
按数据类型的适用性
不同的集中趋势度量适用于不同的数据类型。下表概述了各度量的最佳用例与局限。
数据类型
最佳度量
备注
名义
众数
均值和中位数无意义
有序
中位数、众数
由于区间不等,均值常不适用
区间/比率
均值、中位数、众数
选择取决于分布形态与异常值
由此可见,将统计度量与数据性质相匹配至关重要。
专门的集中趋势度量
除了主要的集中趋势度量外,还有一些针对偏度、异常值和尺度问题的专门替代方法。
截尾均值与温莎化均值
所谓截尾均值,是在计算平均数前,从数据两端各剔除固定比例的极端值。例如,10%截尾均值会删除最低10%和最高10%的数值。
温莎化均值并不直接删除极端值,而是将其替换为最近的保留值。该度量在金融、制造和调查分析等领域很有用,因为这些数据中可能包含罕见但影响巨大的极端值。
两种技术都能降低异常值的影响,在均值的敏感性与中位数的稳健性之间取得平衡,从而兼顾稳健性与数据保留。
几何均值与调和均值
几何均值(geometric mean)通过将所有数据点相乘并取第 n 个根(n 为数据点数量)得到。它特别适用于乘法过程,如增长率、投资回报和生物测量。几何均值的计算公式如下:
例如,多年平均增长更适合用几何均值而非算术均值来概括。
而调和均值的计算为:
它在对速率进行平均时很有价值,如速度或财务比率。例如,在不同路段上计算平均行驶速度时,调和均值能给出正确的整体速率。
加权均值与三均值
所谓加权均值,是为不同数据点赋予不同的重要性。例如,学生的期末成绩可能会将考试与课程作业按不同权重进行合成。该度量能校正偏差,确保更重要的观测具有更大影响力。
而三均值(trimean)结合了中位数与四分位数:
通过将中位数的稳健性与关于数据分布的扩散信息相结合,它能提供稳定且有洞见的集中趋势估计。
若想系统提升统计思维,欢迎报读以下课程:
集中趋势度量的稳健性
稳健性描述的是集中趋势度量在异常值或非正态分布下抵抗扭曲的能力。本章将更深入地探讨这一概念。
崩溃点分析
崩溃点(breakdown point)表示某统计量在结果变得极度不准确前可承受的数据污染程度。例如:
理解崩溃点有助于分析师在可能存在数据污染时选择合适的统计量。
稳健性与效率的权衡
像中位数这样的稳健度量会牺牲部分统计效率,这意味着要达到与不那么稳健(如均值)相同的精度,可能需要更大的样本量。
例如,中位数虽稳健,但在正态分布下效率较低;相反,均值在正态分布下效率高,但对偏态数据敏感。分析师需根据数据特征在稳健性与效率之间取得平衡。
在金融或生物医学研究等领域,由于数据异常常见且风险较大,实践中往往更重视稳健性而非效率。
进阶思考
现代数据的挑战促使集中趋势分析超越传统方法。下面来看看一些进阶主题。
偏度的影响
偏度从根本上影响集中趋势度量的解释。仅报告偏态数据的均值可能具有误导性。为更好反映数据的不对称性,最佳实践建议同时报告均值与中位数。例如,在收入研究中,中位数往往比均值更能呈现“典型”的收入水平。
多峰分布
多峰分布包含多个峰值,每个峰值可能代表不同的子群体。仅依赖均值等单一度量会掩盖关键洞见。
例如,在大学考试成绩中,出现两个峰可能意味着两个学生群体:一类对材料掌握良好,另一类则遇到困难。在这种情况下,报告多个众数或各簇特定的中位数更有助于揭示这些模式。
类别数据的方法
名义与有序数据往往难以用传统数值方式概括。对名义数据来说,众数仍是主要工具。不过,诸如模态类别熵等高级方法可评估类别数据中的多样性与确定性,量化响应在各类别中的集中或分散程度。
对于有序数据,累积百分比或中位等级等技术能够在不假定区间相等的前提下,提供关于集中趋势的更深入洞见。
结语
新兴的计算方法与数据科学技术不断加深我们对集中趋势的理解。即便在复杂的高维数据集中,新方法也能实现更细致的分析。未来在集中趋势领域的研究与发展,或将聚焦于能自动针对偏度或数据污染进行调整的自适应度量,从而进一步提升稳健性与可解释性。
如果您希望提升数据技能,并在 Python 与 R 的统计学基础方面打下更扎实的根基,欢迎考虑以下技能路径,我强烈推荐: