课程
Excel 数据分析
3 小时
153.8K
在解读数据时,选择合适的集中趋势度量会直接影响您的分析结果。在最常见的度量中,平均数(mean)和中位数(median)看似简单,却在数据解读中蕴含深远意义。平均数给出的是算术平均,而中位数是在排序后位于正中间的值,使得一半观测在其两侧。那么哪个更可靠?答案通常取决于数据的分布、是否存在离群值,以及您希望传达的故事。
本文将分解平均数与中位数的差异、各自的优缺点,以及在不同场景下如何选择。此外,我还会讨论偏态分布和离群值如何影响这些度量,并提供实用示例与可视化,帮助您理解这些基础概念。我们也会浅尝一些更进阶的思想。
要全面理解平均数与中位数的区别,我们先分别看看它们的定义与关键性质。
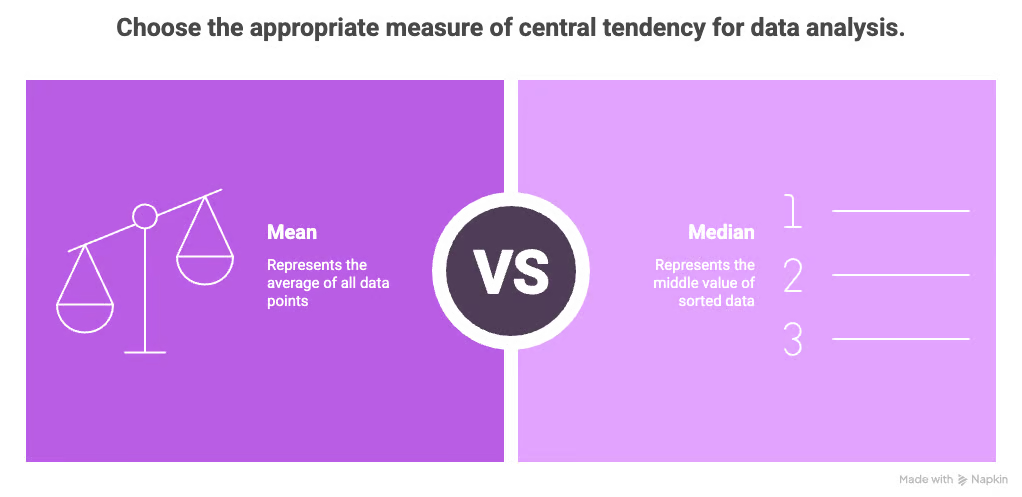
平均数可被视为数据的“平衡点”(或质心)。它考虑了数据集中所有的数据点,并给出一个代表整体平均水平的单一数值。更严格地说,平均数通过将数据集中所有数值相加,再除以数值个数得到。
中位数是在数据排序后处于中间位置的数值。与平均数不同,它对离群值更具鲁棒性,因此在偏态数据中能更好地反映集中趋势。
众数是另一种集中趋势度量,表示数据集中出现频率最高的数值。来看一个例子:
3, 3, 6, 8, 9这里的众数是3,因为它出现了两次,而其他值各出现一次。
读懂定义是一回事,算出来又是另一回事。本节将分步讲解各自的计算方法,并强调它们在计算上的差异。
平均数是一个数据集的算术平均,计算方法如下:
下面用通用公式表示该过程:
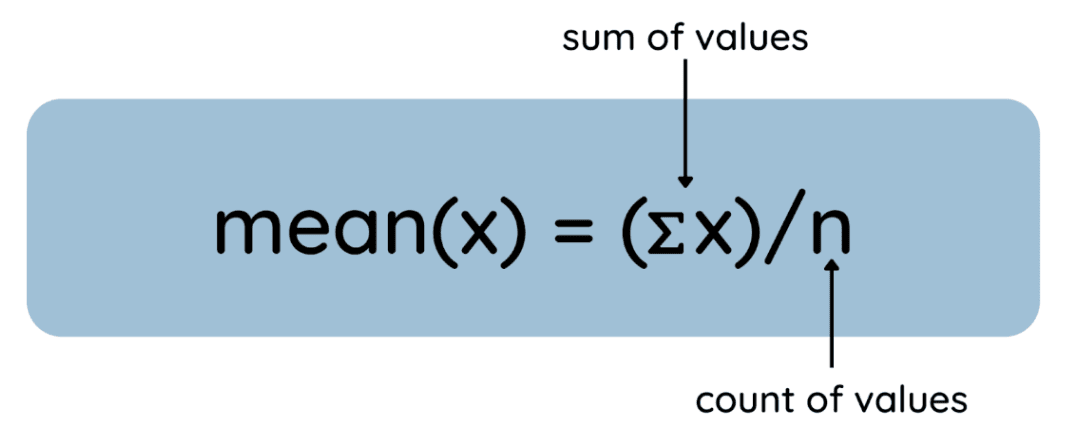
如何求平均数。图片作者自制
举个例子,考虑一组考试分数:
78, 85, 92, 88, 70平均分为82.6。
中位数是把数据按升序排列后位于中间的数值。计算步骤如下:
下面用公式表示这些步骤:
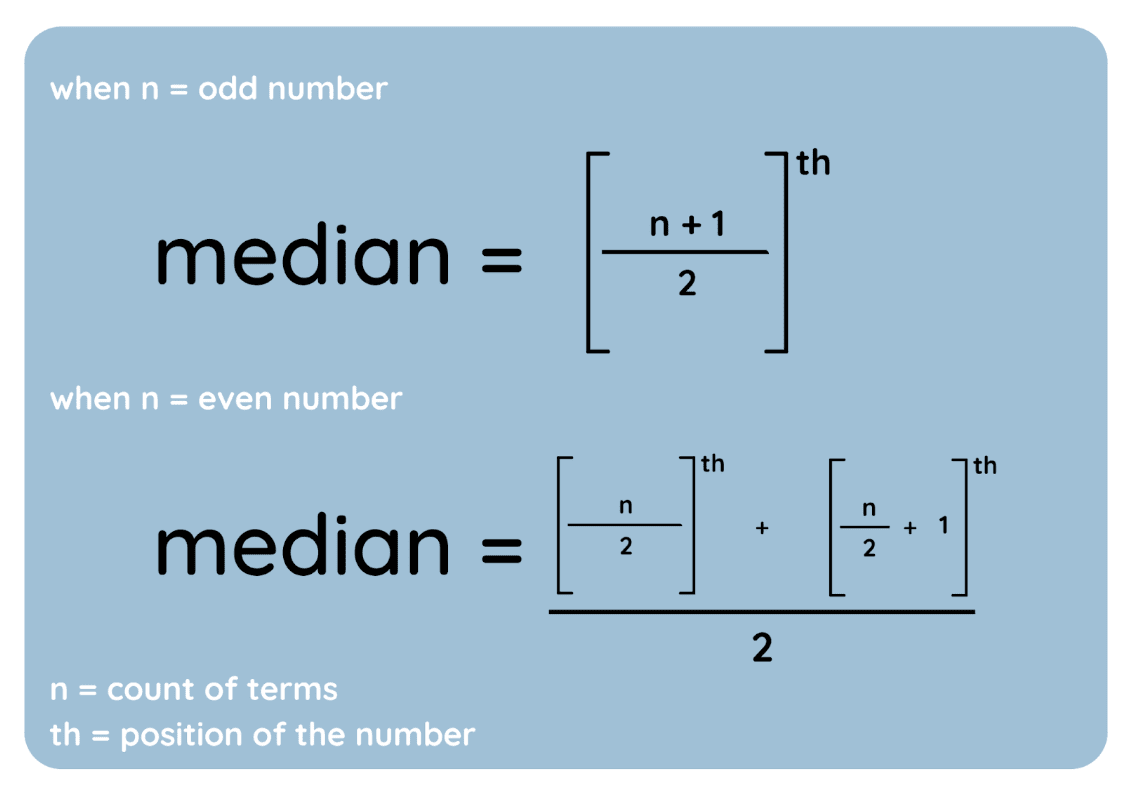
中位数公式。图片作者自制
我还制作了一个可视化图来强调这一过程。
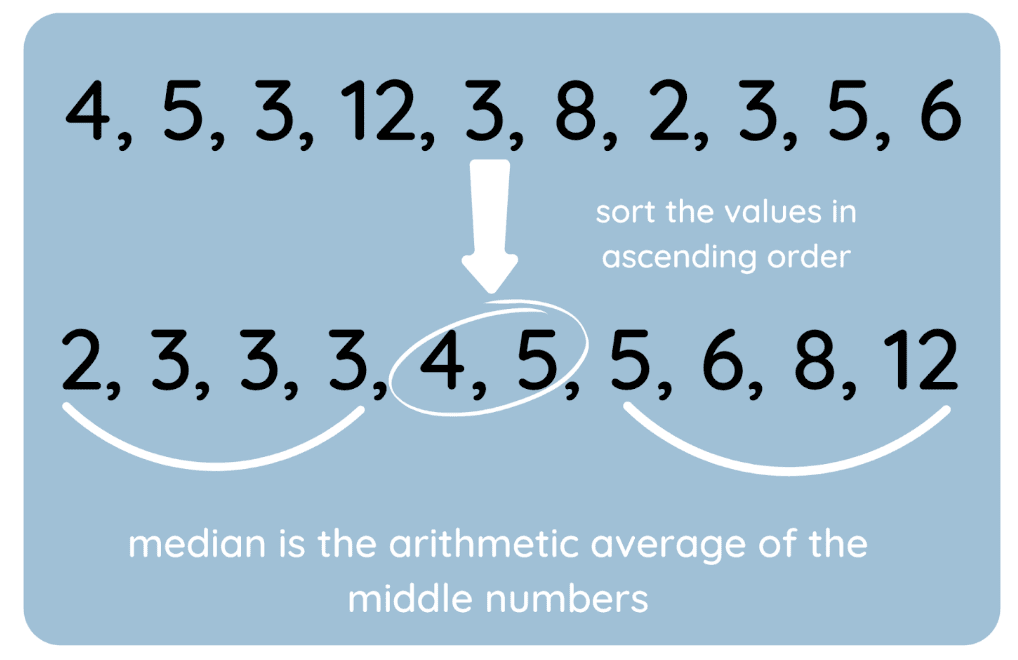
如何求中位数。图片作者自制
下面是一个含奇数个值的数据集示例:
70, 78, 85, 88, 92中位数为85。
再看一个含偶数个值的示例:
70, 78, 85, 88中位数为81.5。
虽然平均数和中位数都描述数据集的中心,但在存在离群值和偏态分布时,它们的表现差异显著。理解这一点对于准确解读数据、避免误导性结论至关重要。
离群值是远高于或远低于其余数据的数值。它们可能强烈影响平均数,但对中位数影响甚微。
来看一组月收入(单位:千):
3, 3.5, 4, 4.5, 5, 6, 50该组数据的平均收入是10.85k,被50k这一极端值严重拉高。
而中位数为4.5k,这更能代表该群体的典型收入水平。
在偏态分布(即非对称分布)中,平均数与中位数对数据的刻画也不同。
例如,在右偏分布(如收入或房价)中,多数数值集中在较低端,少量极端值将尾部拉向右侧。
以收入为例:
30k, 35k, 40k, 45k, 50k, 100k, 200k需要牢记的一点是:在决定使用平均数还是中位数之前,务必检查数据分布。直方图和箱线图等工具有助于可视化偏态并识别离群值。我们稍后会介绍。此外,比较平均数与中位数的差异也是评估偏态的一种方法。
在分析数据时,选择平均数还是中位数取决于数据集的特征以及您希望获得的洞见。下表提供一个快速参考:
| 在以下情况使用平均数 | 在以下情况使用中位数 |
|---|---|
| 数据分布近似正态(对称)。 | 数据高度偏态(如收入、房产价值)。 |
| 离群值很少或与分析无关。 | 存在离群值,纳入后可能扭曲结果。 |
| 需要对每个数据点都敏感的度量,如预测建模或计算总量。 | 希望反映“典型”值,而非数据集的“数学中心”。 |
一个非常实用的建议:先进行数据的可视化分析(如直方图或箱线图),检查是否对称、是否偏态以及是否存在离群值。这将帮助您判断平均数或中位数哪个更适合当前场景。
可视化是理解平均数与中位数在不同数据集上行为的有力工具。它们能清楚展示这两种度量如何响应离群值与偏态,从而支持更好的数据驱动决策。
设想一组以千为单位的小型收入数据:
30, 35, 40, 45, 50, 55, 1000下方条形图演示了单个极端值如何显著影响平均数,而对中位数影响相对较小。本例中,大多数数据集中在 30 到 55 之间,但离群值(1000)会将平均数大幅拉高。
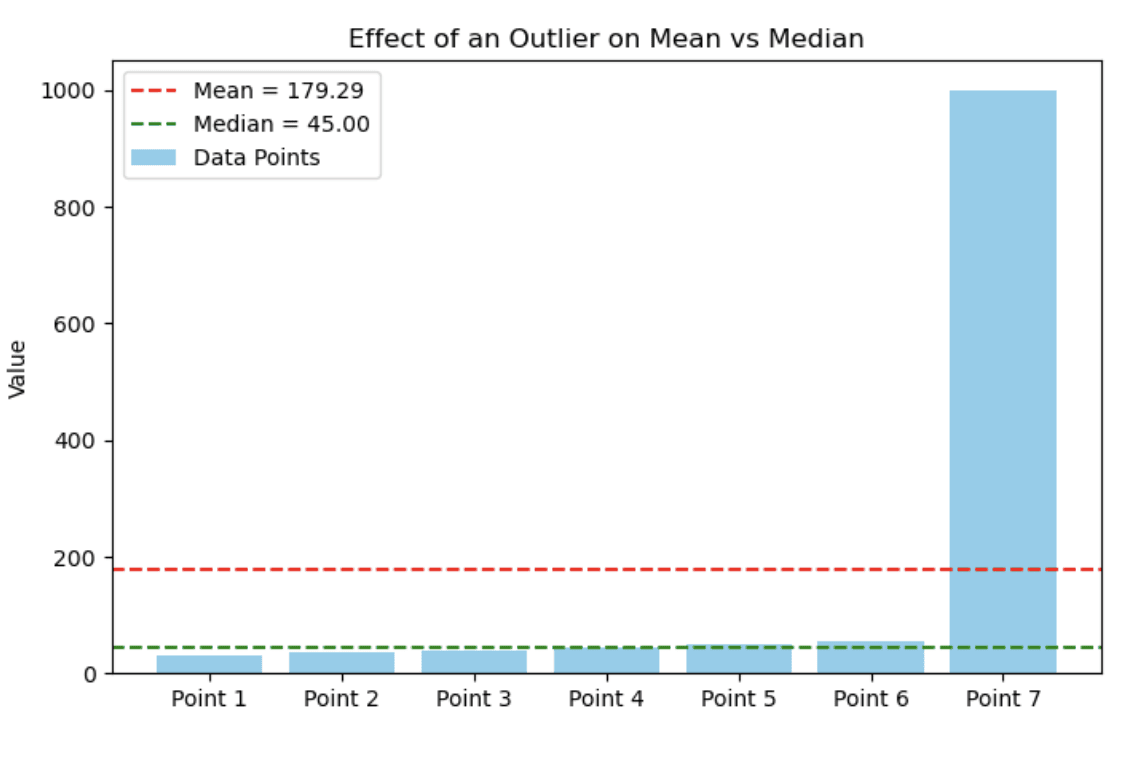
条形图展示离群值对平均数与中位数的影响。图片作者自制
在右偏分布(如收入或房价)中,平均数常被高值的长尾拉动,而中位数更接近“典型”数据点。因此在这类情形下,中位数通常是更合适的集中趋势度量。
下方直方图展示了一个模拟的收入分布,由于偏态,平均数(红色虚线)显著大于中位数(绿色虚线)。
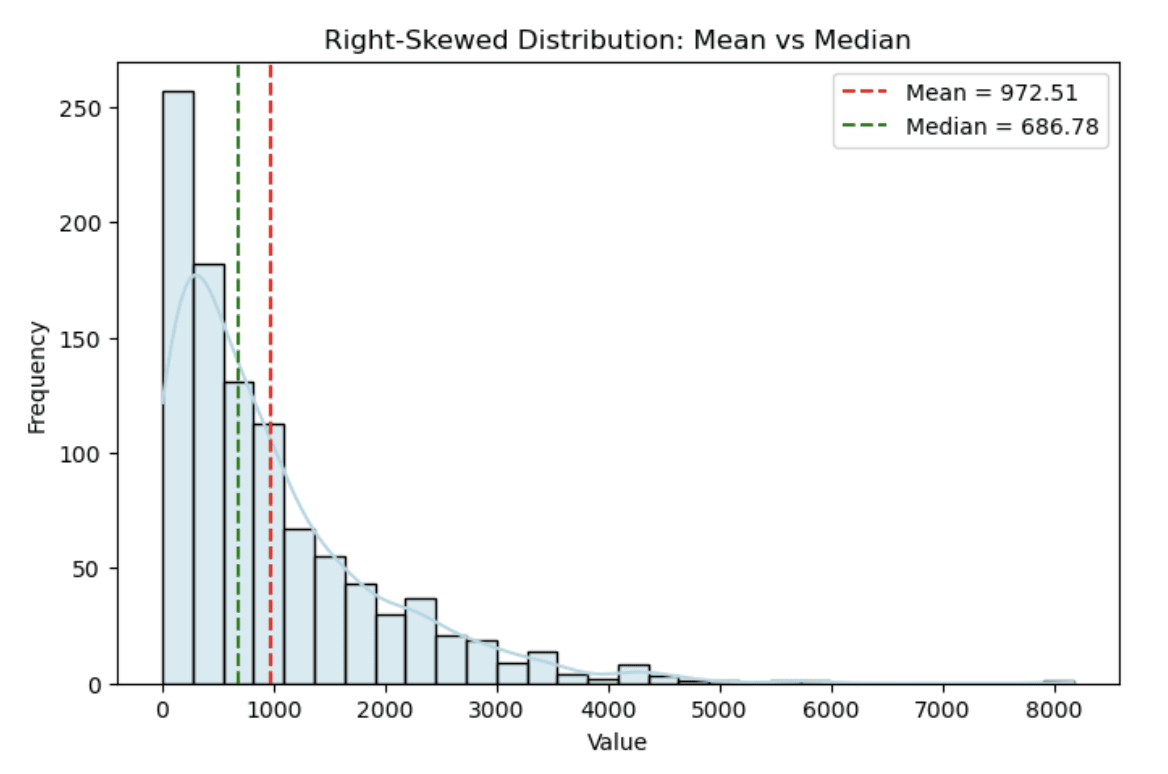
右偏分布直方图。图片作者自制
可以看到右偏如何拉长尾部,从而造成平均数与中位数之间的明显差距。
箱线图是可视化离群值对中位数影响的绝佳方式。下图比较了两个组:一个包含离群值,一个不包含。尽管存在极端值,中位数(箱体内的垂直线)仍相对稳定,但数据的整体范围会被离群值显著拉大。
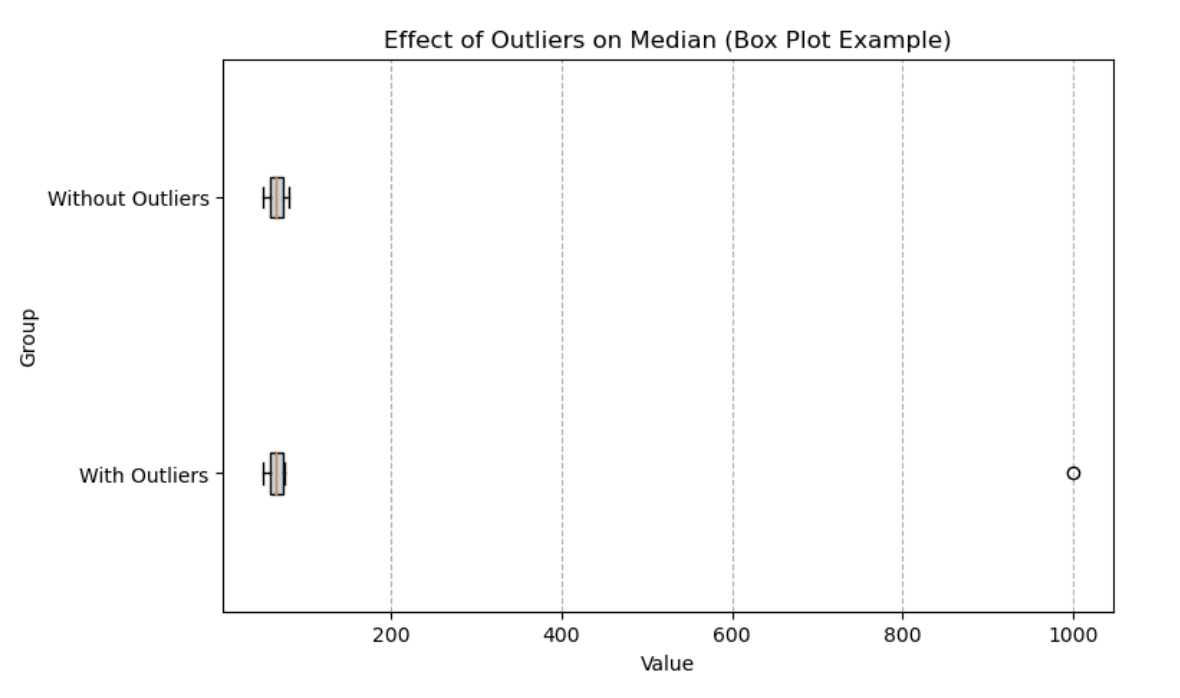
箱线图展示离群值对中位数的影响。图片作者自制
这些可视化强调了平均数与中位数如何对不同数据特性作出响应,有助于明确在何时应选用哪种度量。无论是分析偏态数据、易受离群值影响的数据集,还是进行组间比较,这类可视化都能让复杂关系更易把握。
如果您有兴趣进一步学习,我们现在来看看一些更进阶的概念。
如果您是数据科学家,需要填补数据中的缺失,可能需要选择一种插补方法。您或许会问,使用均值插补与中位数插补在实践中有什么区别?
顾名思义,均值插补用可用数据的平均值替代缺失值,但正如上文所述,它可能被极端值拉偏。中位数插补则用数据集的中间值替代缺失值。
一个有用的经验法则是观察数据的分布。如果数据分布存在偏态、且缺失较多,而您使用了均值插补,那么您可能会改变原有的数据分布!
但也要记住,单值插补(均值或中位数)会缩小方差并削弱变量间关系。若缺失严重,可考虑多重插补或基于模型的插补,以更好地保留不确定性与结构。
在许多参数方法中,平均数(与方差)是核心参数。例如,简单线性回归假设误差围绕某个均值呈正态分布。当您的数据满足正态性假设时,样本均值是自然的估计量,并与参数方法契合良好。
而中位数常用于稳健与非参数场景,在数据偏态或含离群值时尤为常见。许多检验(如 Mann–Whitney 检验)是基于秩的,比较的是分布(在一定假设下常被解读为位置差异),而非均值,它们并不总是在检验中位数差异。
总之,理解平均数与中位数的区分不仅有助于正确描述数据,也与假设检验密切相关。
在决定使用平均数还是中位数时,一个关键问题是:对于给定数据集,我们的统计量有多稳定。自助法(bootstrapping)是一种可行方法,可以通过对原始数据反复有放回抽样,经验性地估计平均数与中位数的抽样分布。
您可以用实证方式突出平均数与中位数稳定性的差异:向数据集中引入少量离群值,然后重新运行自助法流程,就能直观展示平均数的分布比中位数的分布变化更剧烈。自助法还可使置信区间在真实情境中的大小更加具体可见。阅读我们的自助法教程了解更多。
换个但同样正确的角度来定义:平均数是使“与数据偏差的平方和”最小的值,而中位数是使“与数据偏差的绝对值之和”最小的值。
看看这条公式:
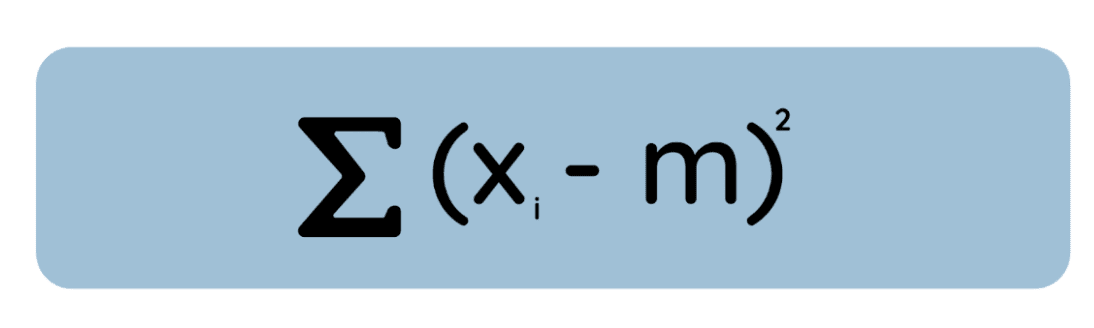
若对该式关于求导、令其为零并求解,可得最小化值正是算术平均。这一点之所以重要,是因为在许多统计方法(如最小二乘回归)中,我们为了数学上的便利以及符合误差正态分布的假设,往往最小化平方误差。
再看另一种思路:不再对偏差求平方,而是度量绝对误差,即m与每个数据点之间的绝对差:
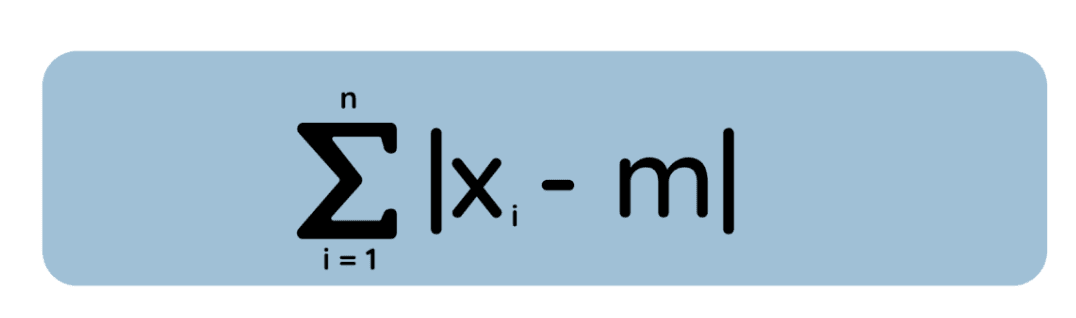
此时我们要找到使该绝对偏差总和最小的m。结果(可通过分析绝对损失的导数或几何论证得到)表明,解就是数据集的中位数。(当观测数为偶数时,位于两个中间点之间的任意值都能最小化绝对偏差总和——因此极小值不一定唯一。)
直观地说,如果位于中位数左侧,右侧的数据点更多,会“拉动”它右移。只有在中位数处,来自左右两边的拉力才达到平衡,从而使绝对距离之和最小。
最后要说的是,平均数在大规模场景下计算更为简便。也就是说,它可以在数据流入时增量计算,而无需排序。
实践中,中位数常通过排序计算,在大规模下成本较高。但中位数并不必然要求完全排序(存在选择算法);对于超大规模或流式数据,常用近似分位数素描算法高效估计中位数。我们的计算机科学概念课程是学习这些内容的绝佳资源。
如您所见,平均数是数据集的算术平均,因而对极端值敏感;中位数是在有序数据中的中间值。选择得当至关重要。不过在实际分析中,通常最好同时报告平均数与中位数,并辅以众数、标准差和百分位数等统计量,以提供更全面的图景。
如果您希望更深入地探索统计概念,有几个方向值得关注。先阅读一些平均数的进阶变体,如截尾均值、几何平均数与加权平均数,它们各有用途。我也推荐我们与技术无关的统计学入门课程。
接着,要真正成为专家,您需要选择并掌握一款工具。若您想使用 R(数据科学与统计常用语言),我们的R 语言统计学入门课程和R 统计学家职业学习路径都是不错的起点。若您偏好用表格软件与 Python 编程,我们的Google 表格统计学入门课程和Python 统计学入门课程,提供基于公式与强大库的动手统计分析体验。
与 DataCamp 一起学习
课程
课程
课程